DeepSeek-Preise 2026 umfassen vier Stufen: ein kostenloser Web-Chat unter chat.deepseek.com, die Flagship-API DeepSeek V4.1 Flash für $0.15/$0.60 pro Million Token in der Nebenzeit, DeepSeek V4 Pro für $0.66/$1.98 pro Million Token in der Nebenzeit und ein kostenloses API-Kontingent von 5 Millionen Token für jeden neuen Entwickler-Account. Alle V4-Modelle bringen ein natives Kontextfenster von 1 Million Token ohne Aufpreis mit, was V4.1 Flash 27- bis 33-mal günstiger beim Input und 33- bis 42-mal günstiger beim Output macht als ein Top-Modell wie GPT-5.6 Sol oder Claude Opus 5. Im Vergleich zu den günstigen Tarifen ist der Abstand deutlich kleiner, und gegen OpenAIs günstigste Stufe ist es beim Input nur noch 1,3-fach.
Dieser Leitfaden deckt jeden Aspekt der DeepSeek-Preise 2026 ab: die neuen V4 Flash- und V4 Pro-API-Tarife, die Legacy-Preise für V3-Chat und R1-Reasoner, den kostenlosen Tarif und die angekündigte, aber noch nicht datierte Spitzenzeitpreisänderung. Außerdem behandeln wir OpenRouter- und AWS Bedrock-Preise sowie den Vergleich von DeepSeek mit ChatGPT, Claude und Gemini. Wer ein einzelnes Abonnement sucht, das DeepSeek mit den anderen Top-Modellen bündelt, findet am Ende auch dazu Infos. Unser vollständiger Vergleich DeepSeek gegen Claude stellt beide gegenüber.
Die wichtigsten Punkte
- DeepSeek V4.1 Flash kostet $0.15/M Input in der Nebenzeit und $0.30/M zur Spitzenzeit (Cache-Miss), Output $0.60 bzw. $1.20, bei einem Kontextfenster von 1M Token.
- Die Preise stiegen am 16. August 2026. V4 Pro kostet jetzt $0.66/M Input in der Nebenzeit und $1.32/M zur Spitzenzeit, Output $1.98 bzw. $3.96. Die dauerhafte Senkung um 75 % ist weg.
- Der Web-Chat von DeepSeek ist kostenlos für Einzelnutzer, ohne Plus- oder Pro-Plan.
- Die DeepSeek API gibt jedem neuen Account 5 Millionen kostenlose Token.
- Cache-Treffer kosten nur einen Bruchteil eines Cache-Misses, sodass Prompt-Caching die Kosten um 80 % oder mehr senken kann.
- Der alte Nebenzeiten-Rabatt von 50 bis 75 % entfällt. DeepSeek hat ihn am 16. August 2026 durch 2-fache Spitzenpreise ersetzt.
Was sind DeepSeek-Preise?
DeepSeek-Preise funktionieren nach dem Pay-per-Token-Prinzip: Du zahlst pro Million Token Text, die das Modell liest (Input) und schreibt (Output). Es gibt keine monatlichen Abonnements für die API und keine Sitzplatzgebühren. Seit 16:00 UTC am 16. August 2026 hängt der Tarif zusätzlich davon ab, wann du das Modell aufrufst. Spitzenzeiten sind 01:00 bis 04:00 und 06:00 bis 10:00 UTC, Montag bis Freitag, jede andere Stunde ist Nebenzeit zum exakt halben Preis. Die aktuellen Tarife beginnen bei $0.15 pro Million Input-Token in der Nebenzeit für DeepSeek V4.1 Flash.
DeepSeek unterbietet bewusst jeden westlichen Anbieter. Der nächste Konkurrent beim Preis ist Alibabas Qwen, aufgeschlüsselt in unserem Qwen-Preisleitfaden. Wie wir in unserem DeepSeek V4 Launch-Überblick beschrieben haben, ist das erklärte Ziel des Unternehmens, mit Huawei Ascend- und Cambricon-Chips Minimalpreise zu erzielen. Das hält die DeepSeek-Preise weit unter den Flaggschiff-Tarifen von OpenAI und Anthropic, obwohl die günstigen Tiers dieser Anbieter beim Input-Token den Großteil des Abstands aufgeholt haben.
DeepSeek-Preise 2026 (kostenloser Chat, V4 Flash und V4 Pro zu Spitzen- und Nebenzeittarifen)
DeepSeek-Preise 2026 umfassen vier Stufen: einen kostenlosen Web-Chat, zwei API-Modelle (V4 Flash und V4 Pro) und ein kostenloses Kontingent von 5 Millionen Token für neue Entwickler-Accounts. Alle Zahlen unten stammen von der offiziellen DeepSeek-Preisseite und sind in USD pro 1.000.000 Token angegeben. Unser Leitfaden dazu, ob DeepSeek kostenlos ist, erklärt, warum es überhaupt keinen kostenpflichtigen Consumer-Tarif gibt.
| Plan | Preis | Modelle | Kontext / Limits | Am besten für |
|---|---|---|---|---|
| Kostenloser Web-Chat | $0 | V4 Flash (ohne und mit Thinking) | Fair-Use-Drosselung in Stoßzeiten | Einzelnutzer, die unter chat.deepseek.com oder in der mobilen App chatten |
| V4 Flash API | $0.15 / $0.30 Input / $0.60 / $1.20 Output pro M Token, Nebenzeit / Spitzenzeit | deepseek-flash (0731 Build) | 1M Kontext, 384K max. Output | Günstiger Allzweck-API-Arbeitspferd |
| V4 Pro API | $0.66 / $1.32 Input / $1.98 / $3.96 Output pro M Token, Nebenzeit / Spitzenzeit | deepseek-v4-pro | 1M Kontext, 384K max. Output | Frontier-Reasoning zu einem Bruchteil der Konkurrenzkosten |
| Kostenloses API-Kontingent | $0 für 5M Token / 30 Tage | Alle DeepSeek-Modelle | Standard-Rate-Limits, keine Kreditkarte | Neue Entwickler-Accounts zur API-Evaluierung |
DeepSeek-Web-Chat für $0 (kostenlos für Einzelnutzer)
Der DeepSeek-Web-Chat unter chat.deepseek.com und die offizielle mobile App sind für Einzelnutzer vollständig kostenlos. Es gibt keinen Plus-Plan, keinen Pro-Tarif und keine Bezahlschranke für Datei-Uploads oder lange Gespräche. Der einzige Nachteil ist die Fair-Use-Drosselung: In Stoßzeiten können „Server Busy"-Meldungen auftreten. Kostenlose Chat-Sitzungen laufen standardmäßig auf V4 Flash und erlauben das Umschalten auf DeepThink, um in den V4 Flash Thinking-Modus zu wechseln.
DeepSeek V4.1 Flash Preise
DeepSeek V4.1 Flash ist das günstige Standardmodell der API. Es kostet $0.15 pro Million Input-Token in der Nebenzeit bei einem Cache-Miss und $0.30 zur Spitzenzeit, der Output $0.60 bzw. $1.20. Cache-Treffer fallen auf $0.003 und $0.006 pro Million. Es unterstützt unter der ID deepseek-flash sowohl einen Modus ohne als auch mit Reasoning und bietet ein Kontextfenster von 1 Million Token sowie bis zu 384K Token Output. Das ist das Modell für alles, was keine tiefe Reasoning-Leistung braucht.
Die Modell-ID hat sich 2026 zweimal geändert. Seit dem 31. Juli 2026 bediente die ID deepseek-v4-flash den Build DeepSeek-V4-Flash-0731, der die April-Vorschau ablöste, und Artificial Analysis hat V4 Flash von 40 auf 50 angehoben, in der Intelligence-Index-Version, die damals lief. Am 10. September 2026 wurde diese ID abgekündigt: Sie wird weiterhin akzeptiert, aber DeepSeek bedient solche Anfragen jetzt mit DeepSeek-V4.1-Flash unter dem Namen deepseek-flash und rechnet sie zum Flash-Tarif ab. Der Preis hat sich mitbewegt. Der pauschale Tarif von $0.14 / $0.28, mit dem das Modell startete, wurde am 16. August 2026 abgeschafft, und der Tarif, der ihn ersetzte, wurde am 10. September 2026 selbst gesenkt. Jede vor diesem Datum berechnete Kostenangabe pro Aufgabe gilt daher nicht mehr.
DeepSeek V4 Pro Preise
DeepSeek V4 Pro ist das Flagship-Reasoning-Modell. Es kostet $0.66 pro Million Input-Token in der Nebenzeit bei einem Cache-Miss und $1.32 zur Spitzenzeit, Cache-Treffer $0.022 und $0.044, Output $1.98 und $3.96. V4 Pro teilt sich das 1M-Kontextfenster und die 384K maximale Ausgabe mit V4 Flash, die Modell-ID lautet deepseek-v4-pro. Es ist weiterhin deutlich günstiger als jedes westliche Flaggschiff, aber die Senkung um 75 %, die DeepSeek einmal dauerhaft nannte, endete im August 2026.
Kostenloses DeepSeek API-Kontingent ($0, 5 Millionen Token für 30 Tage)
Jeder neue DeepSeek-Entwickler-Account startet mit einem Kontingent von 5 Millionen Token, das 30 Tage gültig ist und keine Kreditkarte erfordert. Das reicht für etwa 2.500 bis 5.000 Testaufrufe, je nach Prompt-Länge, was zum aktuellen V4 Flash-Tarif etwa $8.40 wert ist. Nach dem Verbrauch des Kontingents wechselt die Abrechnung auf die oben genannten Standard-Pay-per-Token-Tarife, und du kannst dein Guthaben mit einer kleinen Einzahlung aufstocken.
DeepSeek-Preise im Detail pro Million Token (Cache-Miss vs. Cache-Treffer)
| Modell | Input (Cache-Miss), Nebenzeit / Spitzenzeit | Input (Cache-Treffer), Nebenzeit / Spitzenzeit | Output, Nebenzeit / Spitzenzeit | Kontext | Hinweise |
|---|---|---|---|---|---|
| deepseek-flash | $0.15 / $0.30 | $0.003 / $0.006 | $0.60 / $1.20 | 1M | Standard-Günstigmodell, bedient den 0731 Build |
| deepseek-v4-pro | $0.66 / $1.32 | $0.022 / $0.044 | $1.98 / $3.96 | 1M | Flagship-Reasoning-Modell |
V3-Einführungspreis (deepseek-chat) | $0.27 | $0.07 | $1.10 | 64K | Historisch. ID eingestellt am 24. Juli 2026 |
R1-Einführungspreis (deepseek-reasoner) | $0.55 | $0.14 | $2.19 | 64K | Historisch. ID eingestellt am 24. Juli 2026 |
Die alten Modell-IDs deepseek-chat und deepseek-reasoner sind abgekündigt. Sie wurden nach dem 24. Juli 2026, 15:59 UTC eingestellt, und DeepSeeks Dokumentation listet jetzt genau zwei Modell-IDs: deepseek-flash und deepseek-v4-pro. Wer diese alten Strings noch in einer Konfigurationsdatei hat, wird Fehler erhalten. Die V3- und R1-Preise unten werden nur aus historischen Gründen aufgeführt.
V4 Flash vs. V4 Pro Preise
DeepSeek V4 Flash ist das günstige, schnelle Arbeitspferd. V4 Pro ist das Deep-Thinking-Modell mit einer deutlich höheren Anzahl aktiver Parameter. V4 Pro kostet beim Input ungefähr viermal so viel und beim Output gut dreimal so viel pro Token wie Flash. Standardmäßig also Flash verwenden und nur dann auf Pro umsteigen, wenn ein Task echtes Reasoning-Tiefe benötigt. Selbst dann ist V4 Pro das günstigste Frontier-Reasoning-Modell auf dem Markt.
Wie funktionieren DeepSeek-Preise?
DeepSeek-Preise haben drei Ebenen, auf jeder lässt sich sparen.
- Token. Jede Anfrage wird in Input-Token (was du sendest) und Output-Token (was das Modell generiert) gemessen. Eine Million Token entspricht ungefähr 750.000 englischen Wörtern.
- Cache-Treffer. Wenn ein Teil deines Prompts kürzlich bereits verarbeitet wurde, liefert DeepSeek ihn aus dem Cache mit einem deutlichen Rabatt (bei V4 Flash etwa 98 % günstiger als beim Cache-Miss). System-Prompts und gemeinsamer Kontext profitieren am meisten.
- Spitzenzeitaufschlag, aktiv. Der Nebenzeiten-Rabatt für V3 und R1 entfiel mit diesen Endpunkten. DeepSeek hat ihn am 16. August 2026 durch Spitzen- und Nebenzeiten-Preise ersetzt, bei denen Stoßzeiten das 2-fache des Nebenzeittarifs kosten, auf alle Abrechnungsposten. Stoßzeiten sind als 9:00 bis 12:00 und 14:00 bis 18:00 Pekinger Zeit definiert, also 01:00 bis 04:00 und 06:00 bis 10:00 UTC, Montag bis Freitag. Für alles, was in diesen Fenstern läuft, mit dem Spitzentarif kalkulieren.
Du zahlst nur, was du verbrauchst. Es gibt kein Mindestbudget, keine Monatsgebühr und keinen Aufpreis für die Länge des Kontextfensters selbst.
Ist DeepSeek kostenlos? Kostenloser Tarif und Web-Chat
Ja, DeepSeek hat kostenlose Angebote. Das Consumer-Chat-Erlebnis unter chat.deepseek.com und in der offiziellen mobilen App ist für Einzelnutzer vollständig kostenlos. Es gibt keinen Plus-Plan, keinen Pro-Tarif und keine Bezahlschranke für Datei-Uploads oder lange Gespräche. Der einzige Nachteil ist die Fair-Use-Drosselung: In Stoßzeiten können „Server Busy"-Meldungen auftreten.
Für Entwickler enthält die API ein Kontingent von 5 Millionen Token für neue Anmeldungen, gültig für 30 Tage. Das reicht für 2.500 bis 5.000 Testaufrufe, je nach Prompt-Länge, und ist zum aktuellen V4 Flash-Tarif ungefähr $8.40 wert. Eine Kreditkarte ist nicht erforderlich, und nach dem Verbrauch wechselt die Abrechnung auf die oben genannten Standard-Pay-per-Token-Tarife.
DeepSeek-Preise bei OpenRouter, AWS Bedrock und Azure
Wer DeepSeeks eigene API nicht nutzen möchte, kann auf mehrere Drittanbieter zurückgreifen, die dieselben Modelle hosten. Die Preise variieren, da jede Plattform ihre eigene Marge, Infrastrukturkosten und Routing einbringt.
| Anbieter | Modell | Input/M | Output/M | Hinweise |
|---|---|---|---|---|
| OpenRouter | DeepSeek V4 Pro | variiert | variiert | Drittanbieter-Route, unabhängig von DeepSeeks Spitzen- und Nebenzeittarifen bepreist |
| OpenRouter | DeepSeek V4 Flash | variiert | variiert | Drittanbieter-Route, unabhängig von DeepSeeks Spitzen- und Nebenzeittarifen bepreist |
| OpenRouter | DeepSeek V3.2 | $0.252 | $0.378 | Legacy-Option im mittleren Segment |
| OpenRouter | DeepSeek R1 (Reasoning) | $0.70 | $2.50 | Ursprüngliches R1-Chain-of-Thought-Modell |
| AWS Bedrock | DeepSeek V3.2 | $0.62 | $1.85 | Teurer als direkt, aber unternehmensfreundlich |
| Azure AI Foundry | DeepSeek (verschiedene) | variiert | variiert | Preis je nach Region und SKU |
OpenRouter bietet zudem mehrere kostenlose destillierte DeepSeek-Modelle, darunter kleinere R1-Destillate und DeepSeek V3 Base, mit Rate-Limits aber ohne Token-Gebühren. Ideal zum Prototypen.
DeepSeek R1 vs. V3 Preise
Das ist eine der meistgestellten Fragen zu DeepSeek-Preisen. Die kurze Antwort: R1 reasont besser, kostet aber ungefähr fünfmal mehr pro Anfrage. Sobald es soweit ist, werden wir die DeepSeek R2-Preise aufschlüsseln, sobald die offiziellen Tarife bekannt sind.
| Modell | Input/M, Nebenzeit / Spitzenzeit | Output/M, Nebenzeit / Spitzenzeit | Am besten für |
|---|---|---|---|
DeepSeek V3 (Legacy deepseek-chat) | $0.27 | $1.10 | Allgemeiner Chat, Zusammenfassungen, Texte |
DeepSeek R1 (Legacy deepseek-reasoner) | $0.55 | $2.19 | Mathematik, Logik, mehrstufiges Reasoning |
| DeepSeek V4 Flash | $0.15 / $0.30 | $0.60 / $1.20 | Ersetzt V3, günstiger mit größerem Kontext |
| DeepSeek V4 Pro | $0.66 / $1.32 | $1.98 / $3.96 | Ersetzt R1, Frontier-Reasoning |
R1 generiert pro Anfrage deutlich mehr Output-Token, da es vor der eigentlichen Antwort eine Chain-of-Thought produziert. Das vergrößert den Preisunterschied in der Praxis. Mit V4 unterstützen sowohl Flash als auch Pro Thinking- und Non-Thinking-Modi, sodass du die Reasoning-Tiefe pro Aufruf wählen kannst. Mehr zum ursprünglichen Reasoner findest du in unserem ausführlichen Überblick zu DeepSeek-R1 und wie es OpenAI schlug.
Wie DeepSeek-Preise im Vergleich zu GPT-5.6, Claude und Gemini abschneiden
| Modell | Input/M, Nebenzeit / Spitzenzeit | Output/M, Nebenzeit / Spitzenzeit | DeepSeek V4.1 Flash Multiplikator (Nebenzeit) |
|---|---|---|---|
| DeepSeek V4 Flash | $0.15 / $0.30 | $0.60 / $1.20 | 1x |
| DeepSeek V4 Pro | $0.66 / $1.32 | $1.98 / $3.96 | 4,4x / 3,3x |
| GPT-5.6 Luna | $0.20 | $1.20 | 1,3x / 2x |
| GPT-5.6 Terra | $2.00 | $12.00 | 13,3x / 20x |
| Gemini 3.1 Pro | $2.00 (unter 200K Kontext) | $12.00 | 13,3x / 20x |
| Claude Sonnet 5 | $2.00* | $10.00* | 13,3x / 16,7x |
| GPT-5.6 Sol | $4.00 | $20.00 | 26,7x / 33,3x |
| Claude Opus 5 | $5.00 | $25.00 | 33,3x / 41,7x |
* Claude Sonnet 5 kostet $2/$10 zum Einführungspreis. Er sollte am 1. September 2026 auf $3/$15 steigen, doch Anthropic hat die Erhöhung am 10. August 2026 gestrichen. Auffällig: Das Ranking hängt stark vom Tier ab. Die Flaggschiff-Modelle sind beim Input noch 36-mal teurer, aber OpenAIs Preissenkung im Juli 2026 hat Luna auf $0.20 gesenkt, sodass der reine Token-Preis nicht mehr das alleinige Argument ist.
DeepSeek ist nicht immer das cleverste Modell im Benchmark, aber beim Preis pro nützlichem Token kommt nichts heran. Für hochvolumige Workloads wie Content-Pipelines, Zusammenfassungen, Klassifikation und RAG über große Datenmengen ist DeepSeek oft das einzige Modell, das die Stückkosten wirtschaftlich macht. Den vollständigen Vergleich einschließlich monatlicher Abonnement-Tiers findest du in unserem vollständigen KI-Preisvergleich. Und für einen direkten Vergleich zu Fähigkeiten, Genauigkeit und Stärken der einzelnen Modelle lies unseren DeepSeek vs. ChatGPT Vergleich.
DeepSeek API-Kosten optimieren
Ein paar schnelle Maßnahmen können eine DeepSeek-Rechnung um 50 bis 90 % senken.
- System-Prompt fixieren. Cache-Treffer sind bei V4 Flash 98 % günstiger. Denselben Eröffnungskontext für alle Anfragen verwenden.
- Standardmäßig V4 Flash wählen. Nur dann auf V4 Pro wechseln, wenn der Task wirklich Reasoning-Tiefe braucht.
- Output begrenzen. Du zahlst pro Output-Token, also
max_tokensauf den kleinsten noch sinnvollen Wert setzen. - Batch-Jobs außerhalb der Pekinger Bürozeiten planen. Die teuren Zeitfenster sind 9:00 bis 12:00 und 14:00 bis 18:00 Pekinger Zeit (UTC+8), also 01:00 bis 04:00 und 06:00 bis 10:00 UTC, Montag bis Freitag. Schwere Jobs außerhalb dieser Fenster einzuplanen halbiert die Rechnung, und zwar seit dem 16. August 2026.
- Das 1M-Kontextfenster von V4 sinnvoll nutzen. Ein großes Kontextfenster kostet in DeepSeeks Preismodell keinen Aufpreis, also lieber mehr Retrieval-Ergebnisse hineinpacken, statt für wiederholte Runden zu bezahlen.
- Zuerst kostenlose OpenRouter-Destillate ausprobieren. Auf den kostenlosen R1-Destillaten prototypen, dann die Modell-ID beim Go-Live wechseln.
DeepSeek ohne API-Keys nutzen? Fello AI ausprobieren
Die meisten Leser wollen keinen Code gegen eine API schreiben. Sie wollen mit dem besten Modell für den jeweiligen Task chatten, ohne fünf Abonnements, fünf Browser-Tabs und fünf verschiedene Kontexte zu jonglieren.
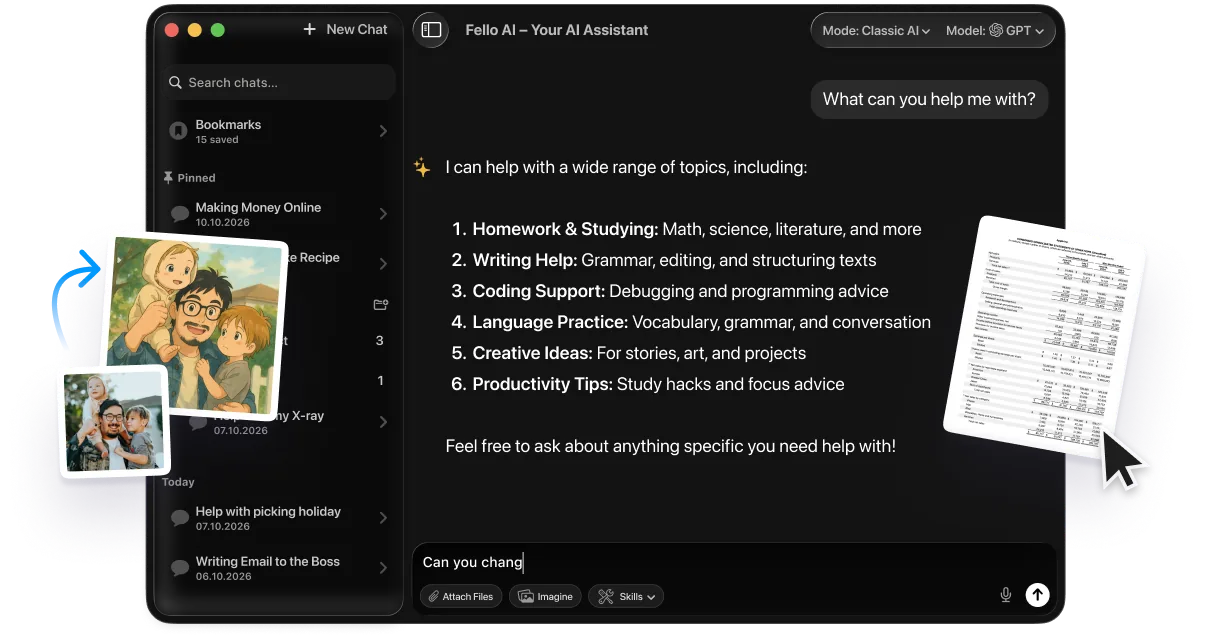
Fello AI ist der einfachste Weg genau dafür. Ein Abonnement gibt dir DeepSeek, ChatGPT, Claude, Gemini, Grok, Perplexity und weitere Top-Modelle in einer einzigen App für Mac, iPhone und iPad für $9.99 pro Monat. Keine Token-Abrechnung zum Nachverfolgen, kein Nutzungslimit zum Einplanen, kein separater Account pro Anbieter. Alles in einem Chat-Fenster und einer Verlaufsansicht.
Warum Fello AI für DeepSeek-Nutzer so gut passt
DeepSeek ist weiterhin eines der günstigsten seriösen Modelle in der API, aber der offizielle Web-Chat ist gedrosselt und das Desktop-Erlebnis spartanisch. Fello AI löst beides. Du bekommst DeepSeek in einer echten Mac-nativen App mit Prompt-Verlauf, Datei-Uploads, Bildanalyse, Spracheingabe und der Möglichkeit, Modelle mitten im Gespräch zu wechseln, wenn DeepSeek für die nächste Nachricht nicht das richtige Werkzeug ist. Wenn dein Prompt besser von Claudes Schreibfähigkeit oder GPTs Reasoning beantwortet würde, Modell wechseln ohne Kontextverlust.
Was sparst du wirklich?
Die Standard-Abonnementkosten der wichtigsten Modelle addieren sich: ChatGPT Plus für $20/Monat, Claude Pro für $20/Monat, Gemini Advanced für $20/Monat, Perplexity Pro für $20/Monat und Grok für $30/Monat. Das sind rund $110 pro Monat für Einzelzugänge. Fello AI fasst dasselbe Angebot für $9.99 pro Monat zusammen, DeepSeek inklusive. Mit 25.000+ Fünf-Sterne-Bewertungen im App Store und Mac App Store ist es die beliebteste KI-Bundle-App im Apple-Ökosystem.
Wer DeepSeek lieber getrennt von den anderen nutzen möchte, findet bei uns auch einen Leitfaden zu einem dedizierten DeepSeek Desktop-Client für Mac.
Fazit
DeepSeek-Preise sind 2026 weiterhin mit die günstigsten an der Frontier, aber es ist kein Pauschaltarif mehr. V4.1 Flash für $0.15/$0.60 in der Nebenzeit, beziehungsweise $0.30/$1.20 zur Spitzenzeit, schlägt weiterhin jeden westlichen Anbieter bei den Kosten, und V4 Pro für $0.66/$1.98 in der Nebenzeit hält ein Spitzen-Reasoning-Modell unter zwei Dollar pro Million Output-Token. Was sich am 16. August 2026 geändert hat: Deine Rechnung hängt jetzt von der Uhrzeit ab, und am 10. September 2026 ist der Flash-Tarif erneut gesunken. Der Web-Chat bleibt kostenlos, die API vergibt 5 Millionen Gratis-Token, und Prompt-Caching senkt die Kosten für wiederholten Input zusätzlich um rund 98 %.
Wer Software entwickelt, besucht direkt die offizielle DeepSeek-Preisseite und startet mit V4 Flash. Wer DeepSeek neben ChatGPT, Claude und Gemini an einem Ort nutzen möchte, wählt Fello AI als einfachsten Weg.
FAQ
Ist DeepSeek kostenlos?
Ja, für Einzelnutzer. Der Web-Chat unter chat.deepseek.com und die offizielle mobile App sind kostenlos ohne Plus- oder Pro-Tarif. Die API gibt jedem neuen Account außerdem ein Guthaben von 5 Millionen Token, bevor die Abrechnung beginnt.
Wie viel kostet die DeepSeek API pro Million Token?
DeepSeek V4.1 Flash kostet $0.15 pro Million Input-Token in der Nebenzeit und $0.30 zur Spitzenzeit bei einem Cache-Miss, der Output $0.60 und $1.20. V4 Pro liegt bei $0.66 bis $1.32 im Input und $1.98 bis $3.96 im Output. Spitzenzeiten sind 01:00 bis 04:00 und 06:00 bis 10:00 UTC, Montag bis Freitag.
Was ist der Unterschied zwischen V4 Flash und V4 Pro in der Preisgestaltung?
V4.1 Flash ist das günstige Arbeitspferd für $0.15/$0.60 pro Million Token in der Nebenzeit. V4 Pro ist das Flagship-Reasoning-Modell und kostet beim Input rund viermal und beim Output gut dreimal so viel, nämlich $0.66/$1.98 in der Nebenzeit. Zur Spitzenzeit verdoppeln sich beide.
Ist DeepSeek günstiger als ChatGPT oder Claude?
Das hängt davon ab, welche Stufe du vergleichst und wann du aufrufst. Gegen Flaggschiffe wie GPT-5.6 Sol ($4/$20) oder Claude Opus 5 ($5/$25) ist V4.1 Flash in der Nebenzeit 27x bis 33x günstiger im Input, zur Spitzenzeit halb so viel. Gegen OpenAIs günstigste Stufe, GPT-5.6 Luna für $0.20/$1.20, ist der Abstand klein: V4.1 Flash ist etwa 1,3x günstiger im Input und 2x günstiger im Output. DeepSeek bleibt deutlich günstiger als die großen Modelle, aber nicht mehr um Größenordnungen.
Was kosten DeepSeek-Modelle bei OpenRouter?
OpenRouter spiegelt DeepSeeks direkte Tarife für V4 Flash und V4 Pro und bietet zusätzlich mehrere kostenlose destillierte Modelle zum Prototypen mit Rate-Limits, aber ohne Token-Gebühren.
Berechnet DeepSeek extra für das 1-Million-Token-Kontextfenster?
Nein. Der volle 1M-Kontext ist im Standard-Token-Tarif von V4 Flash und V4 Pro enthalten.