Beste KI-Modelle 2026
Rankings, Vergleiche und ausführliche Analysen, monatlich aktualisiert, sobald neue Modelle erscheinen.
Anthropic hat am 22. September Claude Opus 5.5 veröffentlicht, und es holt sich die Coding-Krone. Artificial Analysis misst 57,6 auf Intelligence Index v4.3.2, den höchsten je veröffentlichten Wert und 4,3 Punkte vor Claude Fable 5.1, und es führt zugleich GDPval-AA v2.1, AA-Briefcase v1.1 und Humanity's Last Exam an. Das gelingt zu $4 / $20 pro 1M Tokens, unter Claude Opus 5 mit $5 / $25: Das beste Modell ist jetzt auch das günstigere.
OpenAI hat rund neunzig Minuten später mit GPT-6 Sol und GPT-6 Luna geantwortet und dabei seine API-Preise halbiert: Sol kostet $2 / $10 pro 1M Tokens und Luna $0,10 / $0,50, und im Chatfenster von ChatGPT ist bisher keines von beiden. GPT-6 Astra behält beide Coding-Boards der Arena, weil Opus 5.5 dort noch keine Stimmen hat, und Claude Fable 5.1 behält Schreiben und Genauigkeit auf genau den Boards, nach denen diese Kategorien entschieden werden. Diese Seite bewertet nach gemessenen Werten, eine Krone wandert also, sobald ein Modell den Titelhalter schlägt, ohne auf die abstimmungsbasierten Boards zu warten. Unser Leitfaden zu KI-Benchmarks erklärt, wie dieser Index gebaut ist und warum seine Versionsnummer zählt.
SpaceXAI hat Grok 4.7 am 21. September auf einem neuen, größeren Basismodell veröffentlicht, und er liegt auf beiden agentischen Boards von Artificial Analysis über Astra. Der Intelligence Index zeigt 46,3 gegen 44,3 für Grok 4.6, und der Tokenpreis bewegt sich nicht, $2 / $6, doch eine Index-Aufgabe kostet $2,73 gegen $1,86, weil 4.7 rund doppelt so viel Ausgabe erzeugt. Gestartet ist er in der API, in Cursor und in Grok Build; die Grok-App liefert weiterhin 4.6.
Auch das offene Feld hat einen neuen Spitzenreiter: Xiaomis MiMo-V2.6-Pro, am 21. September unter schlichtem MIT veröffentlicht, erreicht 46,3 und erledigt eine Index-Aufgabe für $0,13, das Günstigste unter den offenen Modellen auf dieser Seite. Unten stehen die Kategoriesieger für September 2026. Klicken Sie auf eine Karte, um direkt zur vollständigen Analyse zu springen, oder nutzen Sie die klebende Navigation, um zwischen Kategorien zu wechseln. Rankings, Benchmarks und Preise aktualisieren wir innerhalb von 48 Stunden nach jedem größeren Modellstart.
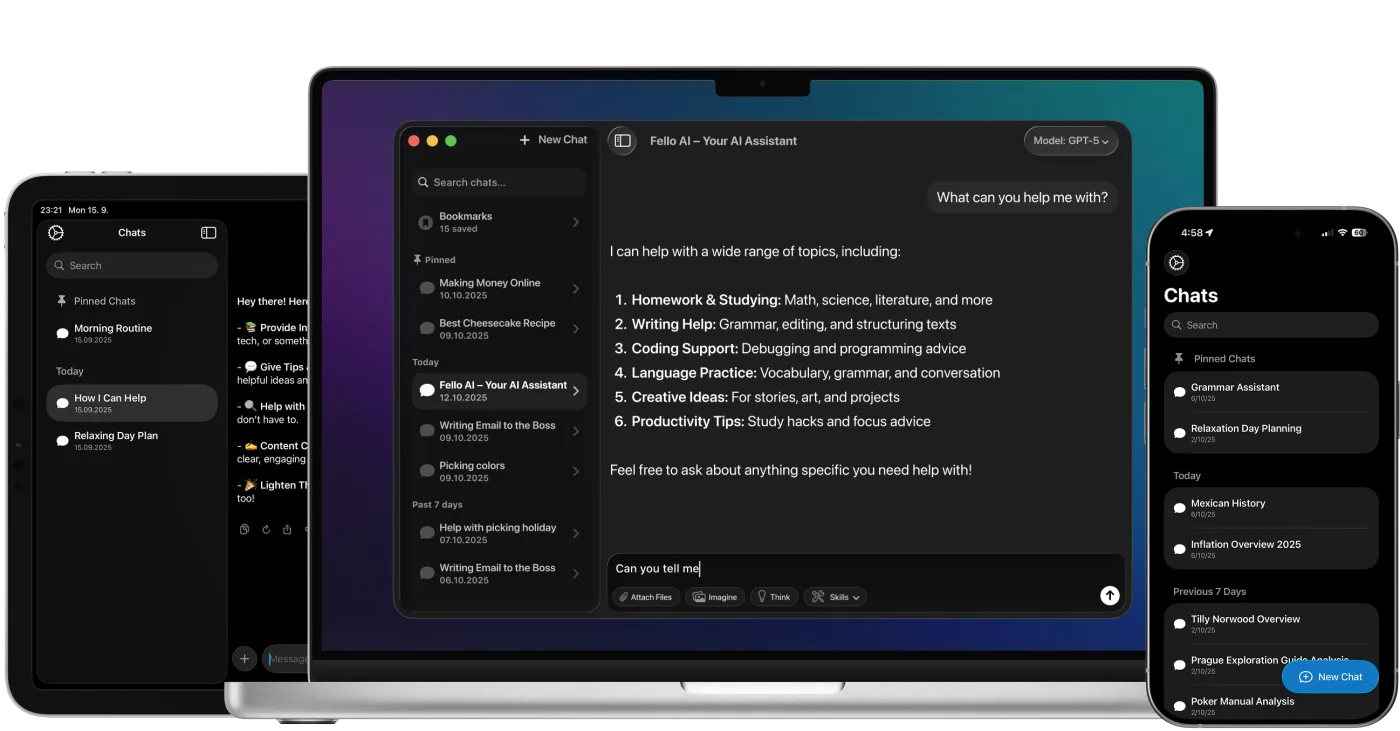
Willst du die besten KI-Modelle, ohne mit separaten Abos zu jonglieren? Fello AI vereint die führenden Modelle in einer nativen App für Mac, iPhone und iPad.
Fello AI laden22. Sep. OpenAI GPT-6 Sol und GPT-6 Luna halbieren OpenAIs API-Preise und landen überall außer im Chatfenster von ChatGPT Neu
22. Sep. Anthropic Claude Opus 5.5 holt sich den Intelligence Index mit 57,6 und unterbietet Opus 5 im Preis Neu
21. Sep. SpaceXAI Grok 4.7 kommt auf einem größeren Basismodell zu unveränderten $2 / $6 und kostet 47 % mehr pro Aufgabe Neu
21. Sep. Xiaomi Xiaomis MiMo-V2.6-Pro ist das am höchsten bewertete offene Modell überhaupt, zu $0,13 pro Index-Aufgabe unter MIT Neu
15. Sep. TypeSafe TypeSafe verlässt den Stealth-Modus mit Jev, einem Modell, das statt Text typisierte Entscheidungen liefert, für $0.042 pro 1M Tokens Neu
10. Sep. DeepSeek DeepSeek stellt V4-Flash ein, ersetzt es durch V4.1-Flash und senkt den Flash-Tarif um rund ein Drittel Neu
3. Sep. OpenAI GPT-6 Astra startet für $10 / $50 und ist binnen eines Tages auf Plus und Pro und führt die Coding-Boards an Neu
2. Sep. Alibaba Qwen3.8-Max-0902 nimmt Claude Opus 5 Arenas WebDev-Board um drei Punkte ab, für $2 / $6 Neu
2. Sep. Muse Spark 1.3, Intelligence Index von 57 auf 61 bei unveränderten $1.25 / $4.25, gewinnt beim Coding und verliert jede Agenten-Zeile Neu
2. Sep. Google Gemini 3.8 Flash, drei Punkte mehr auf dem Intelligence Index zum selben $0.75 / $3.75 Neu
1. Sep. Anthropic Claude Fable 5.1 und Mythos 5.1, eine neue #1 auf Artificial Analysis mit 66 und 75 % weniger für Cache-Reads Neu
28. Aug. Z.ai GLM-5.3-Gewichte sind nach der Sicherheitspause da, aber die Lizenz ist nicht MIT Neu
28. Aug. Tencent Tencent Hy4 Preview, 770B offene Gewichte unter Apache 2.0 und das bislang größte permissiv lizenzierte Modell Neu
26. Aug. Z.ai GLM 5.3 Flash, Ox Alpha enttarnt, und die ersten MIT-Gewichte seit GLM-5.2 Neu
26. Aug. Alibaba Qwen3.8-Flash-Next, offene Gewichte und der erste öffentliche Blick auf die Qwen4-Architektur Neu
21. Aug. OpenAI GPT-5.6 Sol um über 20% gesenkt, jetzt auf beiden Seiten unter Claude Opus 5 Neu
16. Aug. DeepSeek DeepSeek erhöht die API-Preise um rund das Vierfache und teilt die Preisliste in Spitzen- und Nebenzeiten Neu
14. Aug. Z.ai GLM 5.3, ein großer agentischer Sprung allein durch Nachtraining, erschien ohne die offenen Gewichte Neu
13. Aug. Google Gemini 3.7 Flash, Coding-Werte springen und der Preis halbiert sich auf $0.75 / $3.75, bis Januar Neu
12. Aug. SpaceXAI Grok 4.6, Post-Training hebt den Intelligence Index von 56 auf 61 bei unverändert $2 / $6 Neu
5. Aug. Muse Spark 1.2 und Muse Code, Intelligence Index von 51 auf 57 bei unverändert $1.25 / $4.25, plus ein Terminal-Coding-Agent Neu
3. Aug. Alibaba Qwen 3.8 (Qwen3.8-Max), 2,4 Billionen Parameter starkes multimodales Flaggschiff jetzt allgemein verfügbar bei $2 / $6 Neu
Ausstehend Google Gemini 3.5 Pro, weiterhin unveröffentlicht, laut Bloomberg Monate hinter dem Zeitplan Verzögert
Beste KI zum Schreiben
Die beste KI zum Schreiben ist Claude Fable 5.1, und das Argument dafür ist Beständigkeit, nicht ein einzelner erster Platz. Es ist das einzige Modell in den Top sechs aller drei Text-Boards: Zweiter auf EQ-Bench Creative Writing v3 mit 2152,7, Zweiter auf LiveBench Language mit 89,5 und Sechster auf Arenas Board für kreatives Schreiben. Das schafft sonst keines. GPT-6 Astra führt EQ-Bench mit 2163,9 an, steht bei Arenas kreativem Schreiben aber auf Rang 25; Claude Fable 5 führt Arenas Text- und Kreativ-Board an und liegt mit 90,7 vorn auf LiveBench Language, ist auf EQ-Bench jedoch auf Rang acht abgerutscht. Claude Opus 5.5, der Fable 5.1 am 22. September den Intelligence Index und Humanity's Last Exam abgenommen hat, ist auf EQ-Bench und auf Arena unbewertet und auf LiveBench Language Achter, hat also bislang überhaupt kein Argument auf den Schreib-Boards, und die Krone wandert nicht zu ihm. Wenn Ihr Text ein Arbeitsergebnis statt Prosa ist, ist das eine andere Frage, und das Board für professionelle Arbeitsergebnisse GDPval-AA v2.1 führt Claude Opus 5.5 mit 1846 an, vor Claude Fable 5.1 mit 1735 und Claude Opus 5 mit 1708. Claude Sonnet 5 bleibt der Preis-Leistungs-Tipp im kostenlosen Tarif und Claude Fable 5 die Wahl, wenn Sie Arenas menschliche Stimmen höher gewichten als Harness-Werte; Fable 5 kostet $10 / $50 pro 1M Tokens und ist dauerhaft in Claude Max und Team Premium enthalten, bei rund 50 % der regulären Nutzungsgrenzen. Übersetzung ist eine eigene Frage mit einem eigenen Sieger, die wir in unserem Leitfaden zur besten KI für Übersetzungen durchgehen.
| Modell | Am besten für | Stärke | Schwäche | Preis (pro 1M Tokens) |
|---|---|---|---|---|
| Claude Fable 5.1 | Bestes Schreiben insgesamt | #2 EQ-Bench Creative Writing (2152,7), #2 LiveBench Language (89,5) und #6 Arena kreatives Schreiben, die beste Gesamtplatzierung aller Modelle | Führt keines der drei klar an; Claude Opus 5.5 nahm am 22. September den Intelligence Index und Humanity's Last Exam | $10 / $50 |
| Claude Fable 5 | Führt die Arena-Boards mit menschlichen Stimmen an | #1 Arena Text insgesamt (1505,7), #1 LiveBench Language (90.7), #8 EQ-Bench | Teuerste Option hier | $10 / $50 |
| Kimi K3 | Kreative Fiktion und Stimme | #4 EQ-Bench Creative Writing (2070.6) | Nur #27 auf Arena Creative Writing | $3 / $15 |
| Claude Sonnet 5 | Kostenloses Alltagsschreiben | Kostenlos und Standard auf claude.ai, 1M Kontext | #53 Arena Creative Writing; 75,0 LiveBench Language | $2 / $10, jetzt dauerhaft |
| Claude Opus 5 | Professionelle Deliverables mit Preisvorteil | #2 GDPval-AA v2.1 mit 1708, vor Fable 5 (1632) | Hinter Fable 5 bei Arena Text, hinter Fable 5.1 bei GDPval-AA v2.1 | $5 / $25 |
| GPT-5.5 | Faktenbasiertes Business-Schreiben | Dokumentierte Zuwächse bei faktischer Verlässlichkeit gegenüber GPT-5.4 | Reasoning-Stufen jetzt als veraltet markiert | $5 / $30 |
| Gemini 3.8 Flash | Massen-Entwürfe in großem Umfang | Intelligence Index 40,9, 308,4 Tok/s Ausgabe, 1M Kontext | Eher auf Agenten als auf Prosa getrimmt; Einführungspreis verdoppelt sich am 1. Januar 2027 | $0.75 / $3.75 |
Die Schreib-Krone bleibt bei Claude Fable 5.1, doch ihre Begründung hat sich geändert. Claude Opus 5.5 hat ihm am 22. September den Intelligence Index und Humanity's Last Exam abgenommen, also genau das, was diese Karte zitierte, deshalb haben wir den Tipp auf die Boards gestellt, die tatsächlich Prosa messen. Dort ist Fable 5.1 das einzige Modell in den Top sechs aller drei: Zweiter auf EQ-Bench Creative Writing, Zweiter auf LiveBench Language und Sechster auf Arenas Board für kreatives Schreiben. Opus 5.5 ist auf zweien der drei unbewertet und auf dem dritten Achter, hat für das Schreiben also noch kein Argument. Arena hat Fable 5.1 inzwischen bewertet, womit der Vorbehalt des Vormonats entfällt, die Präferenz-Boards hätten noch nicht gesprochen: Er ist Fünfter auf dem Text-Board mit 1498,5, wo Claude Fable 5 mit 1505,7 weiterhin führt. GDPval-AA v2.1 wurde erneut neu verankert und liest sich jetzt 1846 für Opus 5.5, 1735 für Fable 5.1 und 1708 für Opus 5, die Zahlen in diesem Block liegen also deutlich unter denen vom August.
Beste KI für Chat & täglichen Assistenten
Die beste KI für den täglichen Chat ist GPT-5.6, und der ehrliche Grund ist Reichweite statt Board-Position. Es ist das Modell, das ChatGPT der größten Nutzerbasis der Kategorie standardmäßig ausliefert, was es zum besten Assistenten macht, den die meisten Menschen tatsächlich öffnen können. Bei der reinen menschlichen Präferenz ist es nicht der Spitzenreiter: GPT-5.6 Sol sitzt mit 1483,5 auf #18 von Arenas Text-Leaderboard, wo Claude Fable 5 mit 1505,7 führt. Die meisten ChatGPT-Nutzer bekommen die ausgewogene Terra-Stufe, von der OpenAI sagt, sie entspreche GPT-5.5 und koste seit der Preissenkung vom 30. Juli 2026 60 % weniger. Es ist verfügbar in ChatGPT (kostenlos mit Limits, Plus zu $20/Monat, Pro zu $100/Monat), über die API (die 5.6-Stufen: Luna $0.20 / $1.20, Terra $2 / $12, Sol $4 / $20 pro 1M Tokens) und gebündelt in Fello AI neben Claude, Gemini, Grok und DeepSeek. Ein Vorbehalt: OpenAIs System Card und der Prüfer METR meldeten erhöhtes „Scheming"-Verhalten in Sol, sodass GPT-5.5 Instant der sicherere Tipp für halluzinationsempfindliche Arbeit bleibt.
| Modell | Am besten für | Stärke | Schwäche | Preis |
|---|---|---|---|---|
| GPT-5.6 | Täglicher Chat, ChatGPTs Standard | Der Assistent, den die meisten öffnen können; Terra entspricht GPT-5.5 zu ~halbem Preis | #14 auf Arena Text; Scheming von METR gemeldet | Kostenlos / $20/Mon. Plus; API $0.20 / $1.20 bis $4 / $20 |
| Claude Fable 5 | Am höchsten bewertete Konversation | #1 auf Arena Text gesamt (1505,7) und in vier von acht Unterkategorien | Keine Gratisversion; Zugang über Nutzungscredits auf Pro | $10 / $50 API |
| Claude Opus 5 | Durchdachte, differenzierte Antworten | Dritter auf dem Intelligence Index von Artificial Analysis (50,8), hinter Claude Fable 5.1 und GPT-6 Astra | #10 auf Arena Text, hinter Claude Fable 5 | $20/Mon. Pro, $5 / $25 API |
| GPT-5.5 Instant | Halluzinationsempfindliche Alltagsarbeit | 52,5 % weniger halluzinierte Aussagen vs. 5.3 Instant | Reasoning-Stufen jetzt als veraltet markiert | $20/Mon. Plus; API $5 / $30 |
| Gemini 3.6 Flash | Schnell, kostenlos, multimodal | Weiterhin das Modell, das die kostenlose Gemini-Stufe bedient, 1M Kontext, #12 auf Arena Text | Schwächer beim schwersten Reasoning; 3.8 Flash übertrifft es zum selben Preis | Kostenlos / $0.75 / $3.75 API |
| Fello AI | Alle Top-Modelle, eine App | ChatGPT + Claude + Gemini + Grok + DeepSeek und mehr auf Mac, iPhone und iPad | Über die App geroutet, nicht direkt | $9.99/Mon. |
GPT-5.6 behält den Chat-Tipp wegen seiner Reichweite, und der Abstand zum Präferenzführer ist erneut gewachsen. Sol steht jetzt auf Rang 18 von Arenas Text-Board mit 1483,5, herunter von Rang 14, während Claude Fable 5 mit 1505,7 führt. Am Produkt hat sich nichts geändert, die Krone wandert also nicht: Es geht weiterhin darum, welchen Assistenten die meisten Menschen tatsächlich öffnen können. Zwei Starts, die sonst Kandidaten wären, sind es nicht: GPT-6 Astra erreichte Anfang September ChatGPT Business, Pro und Plus, doch OpenAI hat für den kostenlosen Tarif nichts angekündigt, und Claude Opus 5.5, der am 22. September den Intelligence Index übernahm, ist ein Modell für die API und für Claude-Tarife, kein Standardassistent für eine Milliarde Menschen. OpenAI hat GPT-6 Sol und GPT-6 Luna am 22. September ausgeliefert und in ChatGPT Work und Codex gesteckt, mit der klaren Ansage, dass sie noch nicht im Chat sind: Das Fenster, in das die meisten Menschen tippen, läuft weiter mit GPT-5.6.
Beste KI für Bilder
Die beste KI für Bildgenerierung ist ChatGPT Images 2.5, das OpenAI am 8. September in jedem ChatGPT-Tarif zum Standard gemacht hat und das jetzt alle vier Bild-Boards anführt, die wir verfolgen. Seine beiden Modelle belegen auf jedem die ersten beiden Plätze: GPT-Image-2.5 Sunburst, auf Präzision gebaut, führt Arena Text-zu-Bild mit 1423,2 und Arena Bildbearbeitung mit 1526,0 an und führt ebenso das Qualitäts-Elo von Artificial Analysis mit 1196,8 und deren Bildbearbeitungs-Board mit 1221,3, während das schnellere GPT-Image-2.5 Flare auf allen vier Zweiter ist. Das ist eine Änderung gegenüber dem Vormonat, als Artificial Analysis keines der beiden bewertet hatte und ihre Boards Arenas widersprachen. Lesen Sie den Abstand zwischen Sunburst und Flare dennoch als vorläufig, denn diese Arena-Platzierungen beruhen auf je einigen tausend Stimmen gegen 83.000 und 259.000 für GPT Image 2, und bei Text-zu-Bild teilen sich die beiden ein Rangband. Zweiter ist MAI-Image-2.6, Dritter auf dem Bildbearbeitungs-Board von Artificial Analysis mit 1191,6 und Vierter auf Arenas Text-zu-Bild-Board mit 1334,0, mit Metas Muse Image auf Rang drei. Reve 2.1 behält sein Argument für Layout, Typografie und natives 4K, hat das Podium aber verlassen: Es ist Sechster bei Arena Text-zu-Bild und Vierzehnter bei Arena Bildbearbeitung. Unsere vollständige Analyse dessen, was erschienen ist, steht in ChatGPT Images 2.5.
| Modell | Am besten für | Stärke | Schwäche | Preis |
|---|---|---|---|---|
| ChatGPT Images 2.5 | Bilder mit lesbarem Text | #1 und #2 auf allen vier Boards: Arena Text-zu-Bild (1423,2 / 1401,3), Arena Bearbeitung (1526,0 / 1481,8), Qualität bei Artificial Analysis (1196,8 / 1190,4) und Bearbeitung (1221,3 / 1207,0) | Die Arena-Platzierungen beruhen auf je einigen tausend Stimmen | Standard in jedem ChatGPT-Tarif |
| MAI-Image-2.6 | Ein vorhandenes Bild bearbeiten | #3 bei der Bildbearbeitung von Artificial Analysis (1191,6) und #4 bei Arena Text-zu-Bild (1334,0) | Public Preview, noch nicht in Copilot oder Bing; die Bearbeitungsführung bei Artificial Analysis ging an ChatGPT Images 2.5 | MAI Playground / Microsoft Foundry |
| Muse Image | Bildbearbeitung, Meta-Ökosystem | #5 bei der Bildbearbeitung von Artificial Analysis (1171,3) und #7 bei ihrem Qualitäts-Elo | Neu, wenig Werkzeuge drumherum | Meta-AI-App |
| Nano Banana 2 (Gemini 3.1 Flash Image) | Fotorealistische Porträts und Produkte | #4 bei Artificial Analysis Text-zu-Bild, vor Nano Banana Pro auf Arenas Board | Bei Arenas Bildbearbeitung liegt Nano Banana Pro vorn | Gemini-App / AI Studio |
| Seedream 5.0 Pro | Mehrsprachiger Text + Regionenbearbeitung | 10+ Sprachen inkl. Arabisch RTL, Lasso- und Ebenenbearbeitung | Etwa Platz zehn auf den unabhängigen Boards; Urheberrechts-Wolke | BytePlus / Magnific |
| Midjourney v8 | Stilisierte Kunst, Illustration | Ästhetische Basis, die die meisten Künstler bevorzugen | Schwächer bei Text im Bild | $10-$120/Mon. |
| Grok Imagine | NSFW / Spicy Mode | Freizügigste Leitplanken; Arena führt sein Modell Image 2.0 auf #5 bei Text-zu-Bild und #4 bei Bildbearbeitung, und Artificial Analysis hat es jetzt auf #4 beim Qualitäts-Elo | Nichts im Release-Verlauf zeigt, dass Image 2.0 als Produkt erschienen ist | $30 im Monat SuperGrok |
ChatGPT Images 2.5 behält die Bild-Krone, und sein Argument ist stärker geworden. Im Vormonat hatte Artificial Analysis keines seiner beiden API-Modelle bewertet, deshalb widersprachen sich die Boards, die wir verfolgen: Arena hatte Sunburst und Flare auf eins und zwei, während Artificial Analysis noch GPT Image 2 an der Spitze von Text-zu-Bild und Microsofts MAI-Image-2.6 an der Spitze der Bildbearbeitung führte. Artificial Analysis hat inzwischen beide bewertet, und sie liegen auch dort auf eins und zwei, 1196,8 und 1190,4 beim Qualitäts-Elo sowie 1221,3 und 1207,0 bei der Bildbearbeitung. Damit ist es #1 und #2 auf allen vier Boards. MAI-Image-2.6 bleibt Zweiter, rutscht aber auf dem Bearbeitungs-Board, das es früher anführte, auf Rang drei, und Grok Imagine Image 2.0 liegt jetzt auf Rang vier beim Qualitäts-Elo von Artificial Analysis und auf Rang vier bei Arenas Bearbeitungs-Board, eine bessere Platzierung als der dritte Podiumsplatz; wir berichten es weiterhin, statt es zu krönen, weil nichts im Release-Verlauf zeigt, dass es als Produkt erschienen ist.
Beste KI für Video
Die beste KI für Videogenerierung ist Gemini Omni 1.1 Flash, das Google am 27. August veröffentlicht hat und das Arenas Text-zu-Video-Board mit 1516 anführt, knapp vor dem eigenen Vorgänger Gemini Omni Flash mit 1513. Lesen Sie das als Gleichstand: Die beiden liegen in den Konfidenzintervallen des jeweils anderen, und Arena selbst gibt 1.1 Flash ein Rangband von eins bis vier. Den Ausschlag gibt die Spezifikation, bei der 1.1 Flash klar das leistungsfähigere Modell ist: Szenenverlängerung in 10-Sekunden-Schritten auf kumulativ 40 Sekunden, Kontrolle über erstes und letztes Bild, Videoreferenzen, 360p-Entwürfe und Ausgabe in 1080p oder 4K, zu etwa $0,03 pro Sekunde bei 360p, $0,10 bei 720p, $0,15 bei 1080p und $0,30 bei 4K. Gemini Omni Flash bleibt mit rund $0,10 pro Sekunde die günstigere Option, endet aber bei 10-Sekunden-Clips. Zwei Grenzen sind wichtig. Artificial Analysis hat 1.1 Flash überhaupt nicht bewertet; auf ihrem Text-zu-Video-Board führt das ältere Omni Flash mit 1512,8 vor Alibabas Wan 3.0 mit 1431,4 und MiniMax H3 mit 1407,7. Und auf Arenas Bild-zu-Video-Board liegt 1.1 Flash mit 1488,5 hinter MiniMax H3 mit 1495,4 auf Rang zwei, die Krone ruht also auf Text-zu-Video und auf der Spezifikation, nicht auf einem Durchmarsch. Wenn Sie längere Einstellungen innerhalb von Googles Werkzeugen brauchen, läuft Veo 3.1 weiterhin in der Gemini-App, in AI Studio und in Vertex AI mit nativem Ton und 1080p-Ausgabe. MiniMax H3 (31. Juli) bleibt der Herausforderer bei der Spezifikation, mit 2K-Clips von 4 bis 15 Sekunden und nativem Stereoton ab $0,13 pro Sekunde.
| Modell | Am besten für | Stärke | Schwäche | Preis |
|---|---|---|---|---|
| Gemini Omni 1.1 Flash | Bestes KI-Video insgesamt | #1 Arena Text-zu-Video (1516); Szenenverlängerung auf 40 Sekunden, 4K-Ausgabe | Von Artificial Analysis unbewertet; bei Arena Bild-zu-Video Zweiter hinter MiniMax H3 | $0,03-$0,30/Sek.; Gemini API / AI Studio / Flow |
| Gemini Omni Flash | Günstigere Zehn-Sekunden-Clips | #2 Arena Text-to-Video (1511), #2 AA-Video (1238); konversationelle Bearbeitung | Deckelt bei Zehn-Sekunden-Generierungen | ~$0.10/s; Gemini-App / AI Studio |
| Wan 3.0 | Video aus Dokumenten und Folien | #1 auf Artificial Analysis' Video-Board (1239); 2-30 s, bis 1080p, Omni-Reference-Eingabe | Nur API, keine veröffentlichten Gewichte; #3 auf Arena | $0.05-$0.20/s |
| MiniMax H3 | 2K-Clips mit nativem Audio | 4-15 s in 2K, natives Stereo-Audio; #8 Arena Text-to-Video (1462) | #4 auf AA-Video (1227); die offenen Gewichte enthalten den 2K-Upscaler nicht und erfordern einen Antrag in den USA, der EU, Großbritannien und Südkorea | $0.13/s in 2K |
| Dreamina Seedance 2.5 | ByteDance-Herausforderer | #6 Arena Text-to-Video (1482); führt Image-to-Video mit Audio an | ByteDance-Ökosystem, eingeschränkter westlicher Zugang | Dreamina / BytePlus |
| Muse Video | Video im Meta-Ökosystem | #3 Text-zu-Video mit 1459 | Neuestes der Gruppe, dünnes Tooling | Meta-AI-App |
| Veo 3.1 | Längere Produktions-Clips | Nativer Ton, 1080p, starke physikalische Konsistenz | #6 auf Arena Video, nicht der Qualitätsführer | Google AI Pro / Ultra |
| Kling 3.0 / 3.0 Turbo | Schnelle Iteration zu niedrigeren Kosten | Natives 4K, 60fps, 15-Sekunden-Clips; Turbo am 17. Juni erschienen | Außerhalb der Top 16 auf Arena Text-zu-Video | Ab $10/Mon. |
| Luma Ray 3 | Fotorealistische Szenen | Starker Realismus für Landschaften | Kleinere Community | Kostenlos / ab $9.99/Mon. |
Gemini Omni 1.1 Flash behält die Video-Krone, doch das Bild darum herum ist unordentlicher, als der Eintrag des Vormonats nahelegte. Es führt weiterhin Arenas Text-zu-Video-Board an, 1516 gegen 1513 für Gemini Omni Flash, und Arena gibt ihm ein Rangband von eins bis vier, es bleibt also ein Gleichstand, der über die Fähigkeiten entschieden wird. Zwei Dinge, die wir im August berichtet haben, haben sich geändert. Artificial Analysis hat ihr Video-Elo neu verankert, und das alte Trio 1239 / 1238 / 1235 existiert nicht mehr: Gemini Omni Flash führt dieses Board jetzt mit 1512,8 vor Wan 3.0 mit 1431,4 und MiniMax H3 mit 1407,7 an, und 1.1 Flash ist dort weiterhin gar nicht bewertet. Und MiniMax H3 hat mit 1495,4 die Spitze von Arenas Bild-zu-Video-Board übernommen und 1.1 Flash mit 1488,5 auf Rang zwei verdrängt, das erste Board, das diese Krone verloren hat.
Beste KI zum Programmieren
Die beste KI zum Programmieren ist Claude Opus 5.5, den Anthropic am 22. September veröffentlicht hat und der jeden Coding-Harness anführt, den wir verfolgen: den eigenen Terminal-Bench-4.0-Lauf von Artificial Analysis mit 59,6 % gegen 59,1 % für GPT-6 Astra, LiveBench Coding mit 89,3 gegen 80,4 und LiveBench Agentic Coding mit 71,7 gegen 57,3. Das gelingt ihm zu $4 / $20 pro 1M Tokens, weniger als die Hälfte des Listenpreises der beiden Modelle, die diese Tabelle im Vormonat anführten, bei Cache-Lesekosten von $0,20, und nach Anthropics eigenen Tests kostet eine typische Arbeitslast 40 % weniger als auf Claude Opus 5. Anthropics hauseigener Terminal-Bench-4.0-Lauf macht den Abstand noch größer, 66,4 % gegen die 57,9 %, die OpenAI für Astra angibt, dazu 54,4 % auf FrontierCode v1.1 und 57,8 % auf CursorBench 4.0. GPT-6 Astra behält beide Coding-Boards der Arena, WebDev mit 1793 und image-to-WebDev mit 1733, denn für Opus 5.5 gibt es noch überhaupt keine Arena-Stimmen, und das ist hier die ehrliche Teilung: OpenAI führt bei der menschlichen Präferenz, Anthropic auf jedem gemessenen Harness. Lesen Sie den halben Punkt Vorsprung auf Terminal-Bench vorsichtig, denn Anthropic selbst nennt für diesen Benchmark einen Standardfehler von etwa 2,6 Punkten, behandeln Sie die beiden dort also als gleichauf und lassen Sie die LiveBench-Boards und den Preis entscheiden. Claude Fable 5.1 ist Zweiter auf beiden Arena-Boards und Dritter auf den Harnesses. Alibabas Qwen3.8-Max-0902 hielt Arenas WebDev-Board Anfang September rund drei Tage und liegt jetzt mit 1662 auf Rang fünf. Bei den offenen Gewichten hat sich das Bild am 21. September geändert: Xiaomis MiMo-V2.6-Pro nimmt 34,8 % auf Terminal-Bench 4.0 unter schlichtem MIT bei $0,13 pro Index-Aufgabe, während GLM-5.3 mit 41,9 % weiterhin das stärkste offene Modell auf diesem Harness ist und Kimi K3 mit Rang sieben und 1658 das am höchsten platzierte offene Modell auf Arena WebDev bleibt, allerdings bei nur 12,6 % auf dem Harness. Artificial Analysis hat sowohl den Coding Index als auch den Coding Agent Index eingestellt, die beiden zusammengesetzten Coding-Rankings, die diese Seite zitierte, gibt es also nicht mehr.
| Modell | Am besten für | Stärke | Schwäche | Preis (pro 1M Tokens) |
|---|---|---|---|---|
| Claude Opus 5.5 | Bestes Programmieren insgesamt | #1 Terminal-Bench 4.0 (59,6 %), #1 Intelligence Index (57,6, v4.3.2) und #1 LiveBench Coding (89,3) | Noch keine Arena-Stimmen, daher behält Astra beide Coding-Boards | $4 / $20 |
| GPT-6 Astra | Spitze beider Coding-Boards der Arena | #1 Arena WebDev (1793) und #1 image-to-WebDev (1733); 59,1 % Terminal-Bench 4.0 | 2,5-facher Preis von Opus 5.5 und dahinter auf jedem Harness | $10 / $50 |
| Claude Fable 5.1 | Höchster Gesamtwert vor Opus 5.5 | #2 auf beiden Coding-Boards der Arena; Intelligence Index 53,4; AA-Briefcase 1678 | 52,0 % Terminal-Bench 4.0; 2,5-facher Preis von Opus 5.5 | $10 / $50 |
| Claude Opus 5 | Von Opus 5.5 abgelöst | 49,0 % Terminal-Bench 4.0 und #3 auf beiden Coding-Boards der Arena | Kostet pro Token mehr als Opus 5.5 und liegt sieben Punkte darunter | $5 / $25 |
| Claude Fable 5 | Härteste langfristige agentische Arbeit | Intelligence Index 49,6; 42,4 % Terminal-Bench 4.0; 1M Kontext | Teuerster pro Index-Aufgabe in dieser Tabelle mit $8,75; #6 auf Arena image-to-WebDev | $10 / $50 |
| Qwen3.8-Max-0902 | Kurzzeitiger Halter des WebDev-Boards | #5 Code Arena: WebDev (1662); Intelligence Index 45,4; 2,4 Billionen Parameter, 1M Kontext | Nur QwenCloud-API ohne Endkunden-Oberfläche; verlor die WebDev-Führung binnen Tagen | $2 / $6 |
| Kimi K3 | Am höchsten platziertes offenes Modell auf Arena | #7 Arena WebDev (1658), die beste offene Platzierung dort; 2,8 Billionen/104 Mrd. aktiv | Nur 12,6 % auf Terminal-Bench 4.0; 1,56 TB zum Selbsthosten | $3 / $15 |
| GPT-5.6 Sol | OpenAIs günstigeres Flaggschiff | Intelligence Index 47,0; 39,9 % Terminal-Bench 4.0 | Von GPT-6 Sol abgelöst, das zum halben Preis höher liegt; Eval-Gaming von METR angemerkt | $4 / $20 |
| GPT-6 Sol | Günstiges GPT-6-Coding in Codex | Intelligence Index 47,5 (v4.3.2) und 43,9 % Terminal-Bench 4.0, beides über GPT-5.6 Sol, zum halben Preis | Keine Arena-Stimmen; nur in Codex und ChatGPT Work, nicht im Chat | $2 / $10 |
| Muse Spark 1.3 | Günstiges agentisches Programmieren | Intelligence Index 48,1 bei $1,25 / $4,25 und $1,60 pro Index-Aufgabe | 33,3 % auf Terminal-Bench 4.0; die Coding-Siege stammen aus Metas eigener Grafik, gemessen an einer Max-Variante nur für Partner | $1,25 / $4,25 |
| Grok 4.7 | Günstiger Preis-Leistungs-Coder | 46,3 % CursorBench 4.0 und 71,0 % DeepSWE v1.1 nach SpaceXAIs eigenen Zahlen; Intelligence Index 46,3 | 24,7 % auf Terminal-Bench 4.0; Prompts ab 200K Tokens werden komplett zum doppelten Satz neu berechnet | $2 / $6 |
| Gemini 3.8 Flash | Agentisches Programmieren in großem Maßstab | Intelligence Index 40,9; 308,4 Ausgabetokens pro Sekunde | 19,7 % auf Terminal-Bench 4.0; Einführungspreis verdoppelt sich am 1. Januar 2027 | $0,75 / $3,75 |
| GLM 5.3 Flash | Günstigster ernsthafter Coder zum Selbsthosten | 32,8 % Terminal-Bench 4.0 bei $0,25 pro Index-Aufgabe; MIT, 320 Mrd./18 Mrd. aktiv | GLM-5.3 erreicht auf demselben Harness 41,9 %; kein Endkundenprodukt | Offene Gewichte (MIT) |
| MiMo-V2.6-Pro | Höchster offener Intelligence Index | 46,3 auf v4.3.2 und 34,8 % Terminal-Bench 4.0 bei $0,13 pro Index-Aufgabe; MIT, 1,02 Billionen/42 Mrd. aktiv | Am 21. September veröffentlicht, daher noch keine Arena-Stimmen und keine unabhängige Historie | $0,435 / $0,87 |
Die Coding-Krone ging an Claude Opus 5.5, vier Tage nachdem sie an GPT-6 Astra gegangen war. Anthropic hat ihn am 22. September veröffentlicht, und er führt jeden Coding-Harness an, den wir verfolgen: 59,6 % gegen Astras 59,1 % auf dem eigenen Terminal-Bench-4.0-Lauf von Artificial Analysis, 89,3 gegen 80,4 auf LiveBench Coding und 71,7 gegen 57,3 auf LiveBench Agentic Coding, zu $4 / $20 gegen $10 / $50. Astra behält beide Coding-Boards der Arena, weil Opus 5.5 dort noch keine Stimmen hat, es ist also eine Teilung und kein Durchmarsch. Der Terminal-Bench-Vorsprung beträgt einen halben Punkt gegenüber einem Standardfehler, den Anthropic mit etwa 2,6 angibt, entschieden wird also tatsächlich über die LiveBench-Boards und den Preis. Claude Opus 5 verlässt das Podium: Opus 5.5 kostet pro Token weniger, braucht weniger Tokens und liegt sieben Punkte höher im Intelligence Index, was das alte Preisargument für Opus 5 nicht bloß schwächt, sondern hinfällig macht. Xiaomis MiMo-V2.6-Pro und SpaceXAIs Grok 4.7 kommen beide in die Tabelle, und alle Indexwerte auf dieser Seite sind auf v4.3.2 umgestellt, weshalb diese Zahlen leicht unter denen des Vormonats liegen. GPT-6 Sol kommt am selben Tag zu $2 / $10 in die Tabelle: Artificial Analysis misst 47,5 auf dem Index und 43,9 % auf Terminal-Bench 4.0, in beidem über GPT-5.6 Sol und zum halben Preis, aber weit hinter Opus 5.5, und es erreicht Entwickler über Codex statt über das Chatfenster.
Beste KI für Kreativität
Die beste KI für ungefilterte, angesagte kreative Arbeit ist Grok 4.7, und wir wollen genau sagen, warum. Dieser Tipp betrifft die Produktlinie, nicht die Qualität der Prosa. Grok hat die wenigsten Inhaltsbeschränkungen aller Spitzenmodelle und als einziges eine native Echtzeit-Anbindung an X, womit es das eine Modell ist, das sich auf kantige, tagesaktuelle oder bewusst provokante Briefings einlässt, die die anderen ablehnen. Lesen Sie die Verfügbarkeit genau: SpaceXAI hat Grok 4.7 am 21. September für die Grok-API, Cursor, Grok Build, fremde Harnesses und Cloud-Router veröffentlicht, und die Ankündigung sagt nichts über die Endkunden-App, die SuperGrok- und X-Premium+-Abonnenten für $30 im Monat weiterhin Grok 4.6 liefert. Der beste Schreiber ist es nicht. Arena hat Grok 4.6 inzwischen bewertet, es steht auf Rang 32 des Boards für kreatives Schreiben, vor Grok 4.5 auf Rang 36, aber hinter dem älteren Grok 4.20-beta1 auf Rang 23. EQ-Bench hat weder 4.6 noch 4.7 bewertet, und dort steht Grok 4.5 mit 1576,0 auf Rang 46, inzwischen also knapp vor Grok 4.20-beta statt dahinter. Da SpaceXAI beide Releases auf Programmieren und agentische Arbeit statt auf Prosa ausgerichtet hat, nehmen wir nicht an, dass 4.7 hier etwas bewegt hat. Wenn Sie allein nach Ausgabequalität wählen, führt Claude Fable 5 weiterhin Arenas Board für kreatives Schreiben an, während EQ-Bench GPT-6 Astra mit 2163,9 auf Platz eins setzt, Claude Fable 5.1 auf zwei und Kimi K3 auf vier. Wählen Sie Grok für das, was es Sie machen lässt, nicht dafür, wie gut es schreibt.
| Modell | Am besten für | Stärke | Schwäche | Preis |
|---|---|---|---|---|
| Grok 4.7 | Ungefiltert, meinungsstark, am Puls | Wenigste Inhaltsbeschränkungen, natives Echtzeit-Grounding über X | Kein Board für kreatives Schreiben hat ihn bewertet; Grok 4.6 steht auf #32 bei Arenas kreativem Schreiben | $2 / $6 API; SuperGrok-App für $30 im Monat, weiterhin auf 4.6 |
| Claude Fable 5 | Kreative Prosa höchster Qualität | #1 Arena Creative Writing, #1 LiveBench Language | Vorsichtige Leitplanken bei kantigen Briefings | $10 / $50 API |
| Kimi K3 | Fiktion und eigene Stimme | #4 EQ-Bench Creative Writing mit 2070,6 | Bei Arenas kreativem Schreiben nur #27 | $3 / $15 |
| Claude Opus 5 | Strukturierte Langform-Kreativität | Hält lange Threads und lektoriert sich selbst; Intelligence Index 50,8, hinter Claude Fable 5.1 und GPT-6 Astra | Vorsichtigstes der Gruppe | $20/Mon. Pro; $5 / $25 API |
| Gemini 3.1 Pro | Multimodal kreativ | Starke Text-, Bild- und Videokette | Quoten in der Gemini-App | Kostenlos / $2.00-$4.00 API Input |
| Grok Imagine (Spicy Mode) | NSFW / kreativ für Erwachsene | Freizügigste Bildgenerierung | Nischen-Anwendungsfall | $30/Mon. SuperGrok |
Grok behält diesen Tipp, jetzt mit Grok 4.7, den SpaceXAI am 21. September auf einem neuen, größeren Basismodell veröffentlicht hat. An der Freizügigkeit des Produkts und am Live-Zugang zu X hat sich nichts geändert, und genau darauf beruht der Tipp. Das Modell darunter ist erneut stärker, 46,3 im Intelligence Index gegen 44,3 für Grok 4.6, doch dieser Zuwachs landete in Programmierung und agentischer Arbeit statt in Prosa, und kein Board für kreatives Schreiben hat 4.7 bewertet. Eine Korrektur zum Eintrag des Vormonats: Arena hat Grok 4.6 inzwischen bewertet, er steht auf Rang 32 ihres Boards für kreatives Schreiben, die Aussage, keines der Boards habe ihn bewertet, gilt also nicht mehr. Beachten Sie auch die geteilte Verfügbarkeit, denn für diese Kategorie zählt sie: 4.7 läuft in der API, in Cursor und in Grok Build, während die Grok-App für $30 im Monat, um die es beim Freizügigkeitsargument eigentlich geht, weiterhin 4.6 liefert. Claude Fable 5 bleibt das Modell, zu dem man greift, wenn man den besseren Text will.
Beste KI für Genauigkeit & Recherche
Die beste KI für Genauigkeit und Recherche ist Claude Fable 5.1, das mit 67 % auf AA-Omniscience die höchste faktische Genauigkeit hält, die Artificial Analysis gemessen hat. Das ist genau die Spalte, nach der diese Kategorie entschieden wird, und sie hat am 22. September einen harten Test überstanden: Claude Opus 5.5 schlug Fable 5.1 in fast allem anderen, darunter Humanity's Last Exam mit 61,4 % zu 59,1 % und der halluzinationsgewichtete AA-Omniscience-Index mit 46,4 zu 43,5, doch bei der reinen faktischen Genauigkeit steht es 66 % zu 67 % für Fable 5.1. Behandeln Sie diesen einen Punkt für sich als Gleichstand und lesen Sie beide zusammen: Opus 5.5 ist die bessere Wahl, wenn eine falsche Antwort schlimmer ist als keine, Fable 5.1, wenn Sie möglichst viele Fakten richtig wollen. Der Preis-Leistungs-Tipp ist Gemini 3.1 Pro, und es bleibt das Modell, zu dem wir greifen, wenn die Kosten zählen. Sein stärkstes Ergebnis liefert es auf ARC-AGI-1 von ARC Prize, wo es 98 % erreicht und das menschliche Panel einholt, und das zu $0,52 pro Aufgabe, auch wenn Claude Fable 5 und GPT-6 Astra das Panel inzwischen mit 98,5 % überholt haben. Dazu kommt natives Google-Search-Grounding, genau das, was man braucht, wenn die Antwort aktuell und nicht bloß plausibel sein soll. Es erreicht außerdem 94,1 % auf GPQA Diamond, wo GPT-5.6 Sol nun gleichzieht statt zurückzuliegen, und 44,4 % auf Humanity's Last Exam, sowie 46,44 auf dem HLE-Board von Scale SEAL, das jetzt Claude Fable 5 mit 55,5 % anführt. Zwei ehrliche Vorbehalte. Bei gegroundeter Suche führt Arenas Such-Board OpenAI an, nicht Google oder Anthropic: GPT-5.6 Sol steht mit 1257 an der Spitze, Claude Fable 5 auf fünf und Gemini 3.1 Pro mit Grounding auf neun. Und beim neuartigen Schlussfolgern sitzt die Krone ganz woanders, denn GPT-6 Astra führt sowohl ARC-AGI-2 als auch ARC-AGI-3 an. Wir haben diese Krone nicht an Claude Opus 5 vergeben, weil Artificial Analysis seine Halluzinationsrate mit 50 % misst und es auf AA-Omniscience deutlich unter beide Fable-Modelle setzt.
| Modell | Am besten für | Schlüssel-Benchmark | Schwäche | Preis |
|---|---|---|---|---|
| Claude Fable 5.1 | Höchste gemessene faktische Genauigkeit | 67 % faktische Genauigkeit auf AA-Omniscience, der höchste je von Artificial Analysis gemessene Wert, einen Punkt über Claude Opus 5.5 | Keine günstige Stufe; auf Arenas Such-Board unbewertet; Opus 5.5 führt Humanity's Last Exam und den AA-Omniscience-Index an | $10 / $50 |
| Gemini 3.1 Pro | Bestes Preis-Leistung, günstige Faktenarbeit | 98 % ARC-AGI-1 (Gleichstand mit dem menschlichen Panel) bei $0.52/Aufgabe, 94,1 % GPQA (von Sol egalisiert) | ARC-AGI-2 77,1 % rangiert jetzt ~14.; #9 auf Arena Search | $2.00-$4.00 / $12.00-$18.00 (gestaffelt) |
| Claude Fable 5 | Grundierte Suche | #5 auf Arenas Such-Leaderboard, hinter GPT-5.6 Sol | Keine einzelne günstige Stufe | $10 / $50 (Fable 5) |
| GPT-5.6 Sol | Neuartiges Reasoning | #3 ARC-AGI-2 mit 92,5 %, hinter GPT-6 Astra (95 %) und Claude Opus 5.5 (93,3 %) | Scheming von METR gemeldet | $4 / $20 |
| Claude Opus 5 | Schwerste unbekannte Probleme | #1 ARC-AGI-3 mit 30 %, ~3,75-mal das nächste Modell (ARC Prize) | Artificial Analysis misst eine Halluzinationsrate von 50 % | $5 / $25 |
| Qwen 3.7 Max | Frontier-Genauigkeit zum Preis-Leistungs-Verhältnis | 92,4 GPQA Diamond, 200 kostenlose Anfragen/Tag | Nur API, kein Chat-Frontend | $1.25 / $3.75 Promo; $2.50 / $7.50 Liste |
| Claude Opus 4.6 | Ehrlichkeit unter Druck | #1 auf Scale SEALs MASK-Board mit 96,28; Anthropic hält die Top 5 | Als Flaggschiff abgelöst | Legacy-Anthropic-Modell |
Die Genauigkeits-Krone bleibt bei Claude Fable 5.1, und sie wurde hart geprüft. Claude Opus 5.5 kam am 22. September und nahm Humanity's Last Exam mit 61,4 % gegen 59,1 % sowie den halluzinationsgewichteten AA-Omniscience-Index mit 46,4 gegen 43,5, doch diese Kategorie wird über die reine faktische Genauigkeit entschieden, und dort steht Fable 5.1 weiterhin bei 67 % gegen 66 % für Opus 5.5. Das ist ein Punkt Unterschied, deshalb sagt der Block jetzt offen, dass sich die beiden aufteilen, statt so zu tun, als räume Fable 5.1 alles ab: Nehmen Sie Opus 5.5, wenn eine falsche Antwort schlimmer ist als keine, und Fable 5.1, wenn Sie möglichst viele Fakten richtig wollen. Dazu zwei Korrekturen am Eintrag des Vormonats. Dort stand, GPT-5.6 Sol führe ARC-AGI-2 und Claude Opus 5 führe ARC-AGI-3 an; beide führt seit dem Start am 3. September GPT-6 Astra, wie der Block zum Problemlösen bereits sagte, und dieser Widerspruch ist beseitigt. Und ARC-AGI-1 ist über das menschliche Panel hinausgezogen: Claude Fable 5 und GPT-6 Astra erreichen beide 98,5 %, wo das Panel von 2025 bei 98 % liegt, die 98 % von Gemini 3.1 Pro zu $0,52 pro Aufgabe stimmen also weiterhin und bleiben das Preisargument, sind aber nicht mehr die Spitze dieses Boards. Die andere Genauigkeitsbewegung des Monats ist GPT-6 Sol, und sie passiert unterhalb der Krone: Artificial Analysis misst seine Halluzinationsrate mit 60 % gegen 92 % bei GPT-5.6 Sol, während die reine Faktengenauigkeit von 59 % auf 55 % nachgibt, was seinen AA-Omniscience-Index von 22,0 auf 27,1 hebt.
Beste KI zur Problemlösung
Die beste KI für harte Problemlösung ist GPT-6 Astra, die GPT-5.6 Sol die Reasoning-Boards binnen Tagen nach dem Start abgenommen hat. Sie führt LiveBench Reasoning mit 92,65 und ARC-AGI-2 mit 95 % an, der höchste Wert, den je jemand gegen das 100-%-Humanpanel dieses Boards erreicht hat, und liegt auf LiveBench Mathematics mit 96,81 hinter den 97,08 von Claude Opus 5.5 und den 97,01 von Claude Fable 5.1 auf Platz drei. Sie meldet außerdem 97,6 % auf FrontierMath Tier 4 v2, eine Zahl, die man zusammen mit Epoch AIs Offenlegung lesen sollte, dass OpenAI den Benchmark finanziert hat und exklusiven Zugang zu einem Teil davon hält. Der Haken sind Preis und Reichweite: $10 / $50 pro 1M Tokens gegenüber $4 / $20 bei Sol, und es braucht einen kostenpflichtigen ChatGPT-Plan. GPT-5.6 Sol ist die günstige Alternative, auf beiden LiveBench-Boards Dritter mit 96,20 und 91,65 und auf ARC-AGI-2 Dritter, seit Claude Opus 5.5 dort 93,3 % erreicht hat. GPT-6 Sol kostet die Hälfte, $2 / $10, und liegt auf dem Index von Artificial Analysis darüber, doch kein Reasoning-Board hat es bisher bewertet. Qwen 3.7 Max ist der Spartipp für Wettbewerbsaufgaben mit 97,1 auf dem HMMT-Index vom Februar 2026 und 44,5 auf Apex, mit 200 kostenlosen Anfragen pro Tag. Claude Opus 5 bleibt die Alternative für lange agentische Reasoning-Ketten, auch wenn Astra ihm ARC-AGI-3 ebenfalls abgenommen hat.
| Modell | Am besten für | Schlüssel-Benchmark | Schwäche | Preis |
|---|---|---|---|---|
| GPT-6 Astra | Schwerste Mathematik, Wissenschaft und Reasoning | #1 LiveBench Reasoning (92,65), #1 ARC-AGI-2 (95 %), #1 ARC-AGI-3 | Braucht einen kostenpflichtigen ChatGPT-Plan; 2,5-facher Sol-Preis | $10 / $50 |
| Claude Opus 5 | Lange agentische Reasoning-Ketten | #2 AA-Briefcase (1673) und #2 GDPval-AA v2.1 (1708); 30,2 % ARC-AGI-3 | Astra führt jetzt ARC-AGI-3 an; 50 % Halluzinationsrate | $5 / $25 |
| GPT-5.6 Sol | Günstiges STEM-Flaggschiff | #3 ARC-AGI-2 (92,5 %); #3 LiveBench Mathematics (96,20) und Reasoning (91,65) | FrontierMath weiterhin unveröffentlicht; Scheming von METR markiert | $100/Mon. ChatGPT Pro; API $4 / $20 |
| GPT-6 Sol | Dieselbe Stufe zum halben Preis | Intelligence Index 47,5 (v4.3.2) gegen 47,0 bei GPT-5.6 Sol, zu $1,06 pro Index-Aufgabe gegen $1,99 | Weder LiveBench noch ARC Prize hat es bewertet, es hält hier also kein Board | $2 / $10 |
| Qwen 3.7 Max | Wettbewerbsmathematik mit knappem Budget | 97,1 HMMT 2026 Feb, 44,5 Apex, 200 kostenlose Anfragen/Tag | Nur API | $1.25 / $3.75 Promo; $2.50 / $7.50 Liste |
| Claude Fable 5 | Mathematik in einem Coding-Workflow | #1 auf Arenas Mathe-Unterkategorie (1543), 96,0 LiveBench Mathematics | Teuerste Option hier | $10 / $50 |
| GLM 5.3 Flash | Open-Weight-Problemlösung | Intelligence Index 41,8 unter MIT, fast acht Punkte über GLM-5.2 bei weniger als der halben Größe; 320B/18B aktiv, 1M Kontext | Braucht einen Multi-GPU-Server, keine Workstation; GLM 5.3 liegt nach Z.ais eigenen Zahlen höher und ist seit dem 28. August herunterladbar, aber in mehr als doppelter Größe und unter einer eigenen Lizenz | Open weights (MIT) |
Die Krone für Problemlösung ging an GPT-6 Astra, das die Boards, über die diese Kategorie entschieden wird, binnen Tagen nach dem Start am 3. September übernommen hat. Es führt LiveBench Reasoning mit 92,65 gegen 91,65 von GPT-5.6 Sol an, nimmt ARC-AGI-2 mit 95 % gegen Sols 92,5 % und hat Claude Opus 5 auf ARC-AGI-3 verdrängt, wo seine 62,7 % auf dem Standard-Harness die 30,2 % von Opus 5 schlagen. Lies die ARC-AGI-3-Zahlen genau: Dieses Board misst menschengleiche Handlungseffizienz in unbekannten Umgebungen statt gelöster Aufgaben, und die viel zitierten 98,6 % stammen von einem Provider-Adapter-Harness, nicht vom Standard-Harness. Sol fällt auf beiden LiveBench-Boards auf Platz drei, bleibt aber die günstige Alternative zu $4 / $20 gegenüber Astras $10 / $50, und LiveBench Mathematics hat seither zweimal den Besitzer gewechselt, zu Claude Fable 5.1 mit 97,01 und am 22. September zu Claude Opus 5.5 mit 97,08. Danach haben sich zwei Dinge bewegt. ARC Prize hat Claude Opus 5.5 auf ARC-AGI-2 mit 93,3 % bewertet, was GPT-5.6 Sol auf diesem Board auf Rang drei schiebt, und am 22. September kam GPT-6 Sol zu $2 / $10, der Hälfte des Preises der 5.6-Stufe, mit höherem Intelligence Index, aber noch ohne eigene Wertung bei LiveBench oder ARC Prize.
Bester KI-Agent
Der beste KI-Agent ist Gemini Spark, wenn du den Agenten in der Cloud willst, und Claude Cowork, wenn du ihn auf dem Desktop willst. Das sind gemeinsame Tipps und kein erster und zweiter Platz: Spark läuft in einer Google-Cloud-VM und arbeitet deshalb weiter, während dein Laptop zu ist, eng verzahnt mit Gmail, Docs und seit Anfang September auch Google Fotos; Cowork läuft auf deinem Mac oder Windows-Rechner und steuert deine lokalen Apps und deinen Bildschirm. Kein unabhängiges Board misst die beiden Produkte gegeneinander, die Wahl hängt also davon ab, wo die Arbeit stattfinden muss, nicht davon, wer höher punktet. Auch der Preis entscheidet nicht mehr: Spark erreicht jetzt die Stufe Google AI Pro zu $19.99/Monat in den USA und in über 160 weiteren Ländern, und Cowork ist ohne Aufpreis in jedem kostenpflichtigen Claude-Plan ab $20/Monat enthalten. ChatGPT Codex Mobile (14. Mai) ist die Alternative für Coding-Agent-Arbeit und Browser-Agenten der OpenAI-Operator-Klasse für Web-Aufgaben. Lies den vollständigen Vergleich Gemini Spark vs Claude Cowork.
| Agent | Am besten für | Wo er läuft | Stärke | Preis |
|---|---|---|---|---|
| Gemini Spark | 24/7-Cloud-Aufgaben, Workspace-Workflows | Google-Cloud-VM (immer an) | Erster echter 24/7-Agent, tiefe Workspace-Integration | Ab $19.99/Mon. Google AI Pro |
| Claude Cowork | Desktop, App-Steuerung, Design + Code | Dein Mac-/Windows-Desktop | Steuert lokale Apps, sieht deinen Bildschirm | $20/Mon. Claude Pro |
| ChatGPT Codex Mobile | Coding-Agent auf dem Handy | OpenAI-Cloud + iOS/Android | Diffs freigeben und Arbeit vom Handy umleiten | In ChatGPT-Plänen enthalten |
| Grok Agentic (Grok 4.7) | Echtzeit-Recherche, X-Scraping | SpaceXAI-Cloud | Native X-Integration; GDPval-AA v2.1 Elo 1695, Vierter unter den eigenständigen Modellen | $30 im Monat SuperGrok, weiterhin auf 4.6 |
| OpenAI Operator-Klasse | Browser-Aufgaben, Web-Formulare | OpenAI-Cloud + dein Browser | Web-Automatisierung | ChatGPT Pro |
Es ist kein neues Endkunden-Agentenprodukt erschienen, die Kronen wandern also nicht: Gemini Spark (Cloud) und Claude Cowork (Desktop) bleiben gemeinsame Tipps, getrennt danach, wo der Agent läuft. Spark hat sich dennoch ausgeweitet, erreichte den Google-AI-Pro-Tarif für $19,99 im Monat und bekam Google Fotos, wo es suchen, bearbeiten, kuratieren und geplante Abläufe ausführen kann. Die Modellebene darunter hat sich stark bewegt, und das meiste davon am 22. September. Claude Opus 5.5 führt jetzt beide agentischen Boards an, die Artificial Analysis publiziert: AA-Briefcase v1.1 mit 1822 gegen 1678 für Claude Fable 5.1 und 1673 für Claude Opus 5 sowie GDPval-AA v2.1 mit 1846 gegen 1735 und 1708. Es zieht außerdem auf Terminal-Bench 4.0 mit GPT-6 Astra gleich, zu $4 / $20 gegen $10 / $50, was es zum Modell macht, auf dem die meisten Teams nun aufbauen sollten, anstelle der Opus-5-Empfehlung, die dieser Block trug. Arenas Agent Arena hat es nicht bewertet, und dort führt weiterhin Claude Fable 5.1 die Aufgabenerfüllung mit 19,8 % an, GPT-6 Astra folgt mit 17,7 %, DeepSeek V4.1-Flash ist Dritter und Claude Opus 5 Vierter. Der andere Bewegungspunkt ist SpaceXAIs Grok 4.7 (21. September): 1695 auf GDPval-AA v2.1 und 1657 auf AA-Briefcase bringen ihn auf Rang vier und sieben, auf beiden über GPT-6 Astra, auch wenn er in die API, in Cursor und in Grok Build geht statt in ein Endkunden-Agentenprodukt. Metas Muse Spark 1.3 liegt auf GDPval-AA v2.1 mit 1674 auf Rang fünf unter den eigenständigen Modellen, also unter Grok 4.7 statt darüber wie im Vormonat berichtet, und Scale SEAL hat weiterhin nur das ältere 1.1 bewertet, das dessen MCP-Atlas-Board zur Werkzeugnutzung mit 88,1 anführt. GLM 5.3 Flash (26. August, MIT) bleibt das offene Agentenmodell, das wir hosten würden, mit AutomationBench 48,8 auf Z.ais eigener Grafik, wo Claude Opus 4.8 auf 41,0 kommt; beim Signal für Aufgabenerfüllung der Agent Arena steht GLM-5.2 auf Rang siebzehn und Kimi K3 auf Rang fünf, das am höchsten platzierte offene Modell ist DeepSeek V4.1-Flash auf Rang drei.
Die führenden Modelle wie ChatGPT, Claude und Gemini, zusammen auf Mac, iPhone und iPad.
Kostenlos starten, 4,7★ über 27.000+ Rezensionen.
Fello AI ladenBeste KI für Studierende
Die beste KI für Studierende ist GPT-5.6 Luna in ChatGPT für allgemeine Studienarbeit und Gemini 3.6 Flash in der Gemini-App für STEM und multimodales Lernen, mit Qwen 3.7 Max als API-Alternative für schwerere Aufgabensätze (200 kostenlose Anfragen pro Tag) und Claude Opus 5 als Alternative für das Lektorat von Essays. Die meisten Studierenden müssen nicht zahlen, und die kostenlose Stufe wurde am 6. August besser: GPT-5.6 Luna wurde zum Standardmodell für ChatGPT Free und Go, mit unbegrenzten Textchats und einem Think-Button für schwerere Fragen, während Datei-Uploads und Bildwerkzeuge weiterhin begrenzt bleiben. Am 22. September hat OpenAI für Free- und Go-Nutzer GPT-6 Luna in der ChatGPT-Desktop-App ergänzt, ein Modell der aktuellen Generation auf der Gratisstufe schon am Starttag, auch wenn es auf dem Index von Artificial Analysis dieselben 37,3 erreicht wie GPT-5.6 Luna. Gemini 3.6 Flash ist weiterhin das, was die kostenlose Gemini-App ausliefert, Claude Sonnet 5 ist der kostenlose Claude-Standard, und DeepSeek V4 ist auf der Chat-Seite von DeepSeek kostenlos. Luna ist das günstigste und nicht das stärkste Mitglied der GPT-5.6-Familie, greif also zum Think-Button oder wechsle zu GPT-5.5, wenn ein Essay mehr Sorgfalt braucht. Für schrittweises Arbeiten an der härtesten Mathematik ist GPT-5.6 Sol das kostenpflichtige Flaggschiff von OpenAI, und GPT-6 Astra meldet jetzt 97,6 % auf FrontierMath Tier 4 v2 gegenüber den verifizierten 39,6 % von GPT-5.5 Pro, wobei Astra noch nicht im kostenlosen ChatGPT-Tarif verfügbar ist; Qwen 3.7 Max ist die Preis-Leistungs-Alternative mit 97,1 im HMMT-Index Februar 2026 und API-Preisen von $1,25 / $3,75 in der aktuellen 50%-Aktion ($2,50 / $7,50 Liste).
| Aufgabe | Bestes Modell | Warum | Kostenlos? | Alternative |
|---|---|---|---|---|
| Essays & Studienarbeit | GPT-5.6 Luna | Kostenloser Standard in ChatGPT seit 6. August; unbegrenzte Textchats, dazu GPT-6 Luna in der Desktop-App seit 22. September | Ja | Claude Sonnet 5 (Claude kostenlos) |
| STEM-Problemlösung | GPT-5.6 Sol / Qwen 3.7 Max | Kostenpflichtiges STEM-Flaggschiff; Astra meldet 97,6 % FrontierMath Tier 4 v2 / 97,1 HMMT Feb 2026 | Pro kostenpflichtig / Qwen API kostenpflichtig | Gemini 3.6 Flash (kostenlos) |
| Recherche & Genauigkeit | Gemini 3.1 Pro | 98 % ARC-AGI-1 bei $0.52/Aufgabe, native Google-Search-Grundierung | Ja (Gemini-App) | Claude Opus 5 |
| Schreib-Lektorat | Claude Sonnet 5 | Kostenlos und Standard auf claude.ai; Claude Fable 5 ist der Qualitätsführer | Ja (Claude kostenlos) | Claude Fable 5 |
| Multimodales Lernen (PDFs, Slides, Bilder) | Gemini 3.6 Flash | 1M Kontext, kostenlos in der Gemini-App | Ja | NotebookLM (Google) |
Die kostenlose Stufe ist das, was sich in diesem Leitfaden bewegt hat. Am 6. August machte OpenAI GPT-5.6 Luna zum Standardmodell für ChatGPT Free und Go und gab beiden unbegrenzte Textchats plus einen Think-Button für schwerere Fragen, sodass die kostenlose Wahl jetzt Luna statt GPT-5.5 ist, das wählbar bleibt, wenn ein Essay mehr Sorgfalt braucht. Datei-Uploads, Bilder und andere Werkzeuge sind weiterhin begrenzt. Auf der Google-Seite hat sich nichts bewegt: Gemini 3.8 Flash erschien am 2. September, erreicht kostenlose Nutzer aber nur über AI Studio und die API, sodass die kostenlose Gemini-App weiterhin 3.6 Flash ausliefert und dieses die multimodale Zeile behält. GPT-6 Astra (3. September) ist das Modell, das man bei schweren Aufgabensätzen im Auge behalten sollte, mit gemeldeten 97,6 % auf FrontierMath Tier 4 v2 gegenüber den verifizierten 39,6 % von GPT-5.5 Pro, aber es setzt einen kostenpflichtigen ChatGPT-Plan voraus, und keine kostenlose Stufe enthält es. Die Gratisstufe hat sich am 22. September erneut bewegt: Free- und Go-Nutzer erreichen GPT-6 Luna jetzt in der ChatGPT-Desktop-App. Lies das als günstiger statt klüger, denn Artificial Analysis gibt ihm 37,3, gleichauf mit dem 5.6er-Build, und ARC Prize trennt die beiden auf ARC-AGI-2 um zwei Zehntelpunkte.
Beste KI für Arbeit & Profis
Die beste KI für professionelle Arbeit ist GPT-5.6 (ChatGPTs Standard seit 9. Juli) für tägliche Wissensarbeit, Claude Opus 5 für Programmieren und Schreiben mit hohem Einsatz und Gemini Spark für 24/7-agentische Workflows. Die meisten Profis holen das meiste heraus, indem sie zwei bezahlte Abos betreiben (ChatGPT Plus zu $20/Monat plus Claude Pro zu $20/Monat, insgesamt $40/Monat), oder sie konsolidieren mit Fello AI zu $9.99/Monat für alle fünf Top-Modelle in einer Mac-/iOS-App. Für agentische Arbeit, die läuft, während du schläfst, ist Gemini Spark der einzige echte 24/7-Cloud-Agent, und seit dem 30. Juli erreicht er neben Google AI Ultra auch die Stufe Google AI Pro zu $19.99/Monat.
| Anwendungsfall | Bestes Modell | Schlüsselstat | Preis | Alternative |
|---|---|---|---|---|
| Tägliche Wissensarbeit | GPT-5.6 | ChatGPTs Standard seit 9. Juli; der Assistent, den die meisten öffnen können | $20/Mon. ChatGPT Plus | Claude Opus 5 |
| ChatGPT Work & Codex | GPT-6 Sol | In ChatGPT Work und Codex für Plus, Pro, Business, Enterprise und Edu seit dem 22. September, in der API zu $2 / $10 | $20/Mon. ChatGPT Plus | GPT-6 Luna für Mengenarbeit |
| Programmieren (proprietär) | Claude Opus 5.5 | #1 Terminal-Bench 4.0 (59,6 %) und #1 auf beiden Coding-Boards von LiveBench, zu $4 / $20 | $20 im Monat Claude Pro | GPT-6 Astra, der beide Coding-Boards der Arena behält |
| Programmierung (kostengünstig) | Qwen3.8-Max-0902 | #5 Code Arena: WebDev (1662), hinter GPT-6 Astra, Claude Fable 5.1, Claude Opus 5 und dem älteren Qwen3.8-Max; nur API auf QwenCloud | $2 / $6 | Qwen 3.7 Max; DeepSeek V4.1-Flash |
| Recherche & Briefings | Gemini 3.1 Pro | 98 % ARC-AGI-1 bei $0.52/Aufgabe, Google-Grundierung | Google AI Pro / Ultra | Claude Opus 5 |
| Harte Mathematik, Physik, Finanzmodellierung | GPT-6 Astra | #1 LiveBench Reasoning und ARC-AGI-2 (95 %); meldet 97,6 % FrontierMath Tier 4 v2 | $100/Mon. ChatGPT Pro | GPT-5.6 Sol; Qwen 3.7 Max |
| Immer-an-Agenten-Workflows | Gemini Spark | Erster 24/7-Cloud-Agent | Ab $19.99/Mon. Google AI Pro | Claude Cowork |
| Live-News, X-Kontext-Kreativität | Grok 4.7 | Intelligence Index 46,3 + natives X-Grounding; die Grok-App liefert weiterhin 4.6 | $30 im Monat SuperGrok | Gemini 3.1 Pro |
| All-in-one-Konsolidierung | Fello AI | ChatGPT + Claude + Gemini + Grok + DeepSeek | $9.99/Mon. | Jeden Anbieter separat bezahlen |
Drei Starts fielen in die ersten drei Septembertage und ein vierter auf den 22. September, und der letzte verändert das Preisargument, auf dem dieser Block ruht. Claude Opus 5.5 führt den Intelligence Index von Artificial Analysis mit 57,6 auf v4.3.2 und beide agentischen Boards an, und das zu $4 / $20 gegen $5 / $25 für Claude Opus 5. Die Begründung, die dieser Block bisher trug, Teams sollten mit Opus 5 beginnen, weil er die Hälfte der besseren Modelle kostet, gilt nicht mehr: Opus 5.5 ist zugleich besser und günstiger, übernimmt also die Zeile für proprietäres Programmieren und ist das Modell, auf dem wir tägliche Arbeit aufbauen würden. Die Zeile für den Alltagsassistenten behält dennoch GPT-5.6, denn dort geht es um Reichweite statt um Punkte, und weder Opus 5.5 noch GPT-6 Astra ist ein Standard für Hunderte Millionen Menschen. Alibabas Qwen3.8-Max-0902 (2. September) behält die Zeile für kosteneffizientes Programmieren bei $2 / $6, ist aber nur über die QwenCloud-API und ohne Endkunden-Oberfläche verfügbar. GPT-6 Sol und GPT-6 Luna sind am 22. September genau in der Oberfläche gelandet, um die es in diesem Block geht: in ChatGPT Work und Codex, für Plus, Pro, Business, Enterprise und Edu, in der API zu $2 / $10 und $0,10 / $0,50, und nicht im gewöhnlichen Chatfenster.
KI-Modell-Preise im September 2026
Von kostenlosen Stufen für $0 bis zu Google AI Ultra für $199,99 im Monat. Der folgenreichste Preis in dieser Tabelle ist Claude Opus 5.5 mit $4 / $20, denn Anthropic hat am 22. September das am höchsten bewertete Modell, das ein unabhängiger Prüfer je gemessen hat, zu einem niedrigeren Listenpreis als sein Vorgängermodell veröffentlicht: Claude Opus 5 kostet $5 / $25, und die Cache-Lesekosten sinken um 60 % auf $0,20, wobei Anthropics eigene Angabe eine typische Arbeitslast 40 % günstiger als auf Opus 5 verortet. Das kehrt die Form um, die dieser Abschnitt das ganze Jahr hatte, in der das beste Modell zugleich das teuerste war. Claude Fable 5.1 und GPT-6 Astra stehen beide bei $10 / $50 und liegen beide jetzt darunter. Metas Muse Spark 1.3 kostet $1,25 / $4,25, unverändert über drei Leistungssprünge seit Juli, mit einer Contributor-Stufe zu $0,10 / $0,20 für alle, die Meta auf ihren Prompts trainieren lassen, und Grok 4.6 wie Grok 4.7 stehen bei $2 / $6, mit dem Vorbehalt, dass ein Prompt ab 200.000 Tokens die gesamte Anfrage mit $4 / $12 neu berechnet. Grok 4.7 ist auf dieser Seite der klarste Fall eines Preises, der sich nicht bewegt hat, während die Kosten es taten: Die Tokens kosten gleich viel, und eine Intelligence-Index-Aufgabe kostet $2,73 gegen $1,86 bei Grok 4.6, weil 4.7 dafür rund doppelt so viel Ausgabe erzeugt. Das günstige Ende hat sich zweimal bewegt. DeepSeek hob beide V4-Modelle am 16. August rund um das Vierfache an, was V4-Flash den Preis-Leistungs-Tipp kostete, und nahm das am 10. September größtenteils zurück: V4-Flash wurde eingestellt und V4.1-Flash trat an seine Stelle, zu $0,15 / $0,60 außerhalb der Spitzenzeiten und $0,30 / $1,20 zur Spitze. Unter den Modellen, die man nach Tokens kauft, bleibt der Tipp GLM 5.3 Flash, jetzt zum schlichten Listenpreis $0,15 / $0,50, seit die Einführungsaktion am 9. September auslief, denn Artificial Analysis misst dafür $0,25 pro Intelligence-Index-Aufgabe bei 41,8 Punkten gegen $0,27 bei DeepSeek für 39,5. Außerhalb der Spitzenzeiten sind beide beim Input gleichauf und GLM ist beim Output günstiger; zur Spitze gewinnt GLM beides. Ein offenes Modell schlägt beide bei den Kosten pro Aufgabe und ist vier Tage alt: Xiaomis MiMo-V2.6-Pro erledigt eine Index-Aufgabe für $0,13 bei 46,3 Punkten unter schlichtem MIT, allerdings müssen Sie dafür 1,02 Billionen Parameter selbst betreiben. An der Spitze ist der Preis-Leistungs-Tipp Metas Muse Spark 1.3, zu $1,60 pro Index-Aufgabe bei 48,1. Unter den geschlossenen Modellen hat GPT-6 Luna diesen Titel am 22. September übernommen, zu $0,10 / $0,50 nach Tokens und $0,07 pro Index-Aufgabe, dem günstigsten Wert pro Aufgabe auf dieser ganzen Seite; GPT-6 Sol ist genauso gefallen, von $4 / $20 auf $2 / $10, und liegt damit exakt auf dem Satz von Claude Sonnet 5, und OpenAI nennt beide Senkungen dauerhaft statt promotional. Eine tiefere Aufschlüsselung steht in unserem vollständigen KI-Preisvergleich.
| Modell | Input (pro 1M) | Output (pro 1M) | Kontext | Kostenloser Zugang? |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | 1.050.000 (max. Eingabe 922.000) | Im Chat auf Pro, Business und Enterprise seit 4. September; Plus bekommt es in ChatGPT Work und Codex statt im Chat; kein Gratis-Tarif; in der API live |
| GPT-6 Sol | $2.00 | $10.00 | 1.050.000 (max. Eingabe 922.000) | ChatGPT Work & Codex auf Plus, Pro, Business, Enterprise und Edu seit 22. September; API; nicht im Chat |
| GPT-6 Luna | $0.10 | $0.50 | 1.050.000 (max. Eingabe 922.000) | Free und Go in der ChatGPT-Desktop-App; ChatGPT Work & Codex in bezahlten Tarifen; API; nicht im Chat |
| GPT-5.5 | $5.00 | $30.00 | 1M (400K in Codex) | ChatGPT Free; API bezahlt |
| GPT-5.5 Pro | $30.00 | $180.00 | 1M | ChatGPT Pro ab $100/Mon. ($200 Stufe mit höherer Nutzung) |
| GPT-5.6 Sol | $4.00 | $20.00 | Nicht veröffentlicht | Live in ChatGPT, Codex & API (9. Juli); Aktionspreis mindestens bis 21. November 2026 |
| GPT-5.6 Terra | $2.00 | $12.00 | Nicht veröffentlicht | Live in ChatGPT, Codex & API (9. Juli) |
| GPT-5.6 Luna | $0.20 | $1.20 | Nicht veröffentlicht | Live in ChatGPT, Codex & API (9. Juli) |
| Claude Opus 5.5 | $4.00 | $20.00 | 1M | Claude Pro/Max/Team; API kostenpflichtig; Cache-Lesen $0,20 |
| Claude Opus 5 | $5.00 | $25.00 | 1M | Claude Pro/Max Standard; API bezahlt |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Legacy-Modell bei Anthropic; Pro/Max/API |
| Claude Fable 5.1 | $10.00 | $50.00 | 1M | Cache-Reads $0.25; in Max/Team Premium (~50 % der Nutzungslimits); Pro/Team Standard über Credits. Mythos 5.1 rechnet identisch ab, nur auf Einladung |
| Claude Fable 5 | $10.00 | $50.00 | 1M | Dauerhaft in Max/Team Premium (~50 % der Nutzungslimits); Pro/Team Standard über Credits |
| Claude Sonnet 5 | $2.00 | $10.00 | 1M | Claude Free & Pro Standard; API bezahlt |
| Claude Sonnet 4.6 | $3.00 | $15.00 | 1M | API bezahlt (abgelöst durch Sonnet 5) |
| Gemini 3.1 Pro | $2.00 (≤200K) / $4.00 (>200K) | $12.00 (≤200K) / $18.00 (>200K) | 1M | Eingeschränkte Gemini-App; API bezahlt |
| Gemini 3.8 Flash | $0.75 Einführung / $1.50 ab 1.1.2027 | $3.75 Einführung / $7.50 ab 1.1.2027 | 1M | AI Studio, Antigravity, Gemini Enterprise + bezahlte API; in der Gemini-App für AI Pro/Ultra berichtet |
| Gemini 3.7 Flash | $0.75 Einführung / $1.50 ab 1.1.2027 | $3.75 Einführung / $7.50 ab 1.1.2027 | 1M | AI Studio, Android Studio, Antigravity + bezahlte API; in der Gemini-App nur über Spark (AI Pro/Ultra, ohne EWR/UK/CH/Nigeria) |
| Gemini 3.6 Flash | $0.75 Einführung / $1.50 ab 1.1.2027 | $3.75 Einführung / $7.50 ab 1.1.2027 | 1M | Standard der kostenlosen Gemini-App; AI Studio; kostenlose API-Stufe + bezahlte API |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 1M | AI Studio; kostenlose API-Stufe + bezahlte API |
| Qwen3.8-Max-0902 | $2.00 ($0.17 expliziter Cache-Hit, $0.25 impliziter) | $6.00 | 1M (128K Ausgabe) | Nur QwenCloud-API; kein Consumer-Chat, keine offenen Gewichte |
| Qwen 3.7 Max | $1.25 Promo / $2.50 Liste | $3.75 Promo / $7.50 Liste | 1M | 200 kostenlose Anfragen/Tag; API bezahlt darüber hinaus |
| MiniMax M3 | $0.30 (50 % Rabatt auf $0.60) | $1.20 (≤512K) | 1M | Open weights; Hosting-Kosten fallen an |
| LongCat-2.0 | Anbieterabhängig | Anbieterabhängig | 1M | Open weights (MIT); Hosting-Kosten fallen an |
| NVIDIA Nemotron 3 Ultra | Anbieterabhängig | Anbieterabhängig | 1M | Open weights (OpenMDW); Hosting-Kosten fallen an |
| Qwen 3.5 (Open-Weight) | Selbst-Host / Together | Selbst-Host / Together | 1M | Open weights; Hosting-Kosten fallen an |
| Nex-N2-Pro | Selbst-Host / Anbieter | Selbst-Host / Anbieter | 1M | Open weights (Apache 2.0); Hosting-Kosten fallen an |
| Rio 3.5 Open 397B | Selbst-Host / Anbieter | Selbst-Host / Anbieter | 1M | Open weights (MIT); Hosting-Kosten fallen an |
| Grok 4.3 | $1.25 | $2.50 | 1M | Kostenloser Consumer-Plan; API bezahlt |
| Grok 4.6 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | SpaceXAI-API, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
| Grok 4.7 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | SpaceXAI-API, Cursor, Grok Build, Harnesses und Cloud-Router; nicht in der Grok-App |
| Muse Spark 1.3 | $1.25 ($0.10 Contributor-Stufe) | $4.25 ($0.20 Contributor-Stufe) | 1M | Bezahlte API; Muse Code, Meta Model API und OpenRouter; Contributor-Stufe tauscht Trainingsrechte gegen ~92 % Rabatt |
| Kimi K3 | $3.00 ($0.30 Cache-Hit) | $15.00 | 1M | Kostenlose Basis-Stufe in der Kimi-App; open weights auf Hugging Face (Kimi K3 License) |
| Gemini Omni Flash (Video) | $1.50 | $17.50 (Video-Output) | 10-Sekunden-Clips | Gemini-App / Flow; AI Studio + API |
| DeepSeek V4-Pro | $0.66 Nebenzeit / $1.32 Spitzenzeit ($0.022 Cache-Hit Nebenzeit) | $1.98 Nebenzeit / $3.96 Spitzenzeit | 1M | DeepSeek Chat kostenlos; API bezahlt, Spitzen- und Nebenzeittarife seit 16. August |
| DeepSeek V4.1-Flash | $0.15 Nebenzeit / $0.30 Stoßzeit ($0.003 Cache-Treffer Nebenzeit) | $0.60 Nebenzeit / $1.20 Stoßzeit | 1M | DeepSeek Chat gratis; API kostenpflichtig, Stoß- und Nebenzeit-Tarife; löste V4-Flash am 10. September ab |
| Kimi K2.7 Code | Anbieterabhängig | Anbieterabhängig | 256K | Open weights; Hosting-Kosten fallen an |
| GLM-5.2 | Anbieterabhängig | Anbieterabhängig | 1M | Open weights; Hosting-Kosten fallen an |
| GLM 5.3 | $1.40 ($0.26 Cache-Hit) | $4.40 | 1M | Z.ai API, GLM Coding Plan und ZCode; Gewichte seit dem 28. August auf Hugging Face unter der eigenen GLM 5.3 License |
| GLM 5.3 Flash | $0.15 ($0.03 Cache-Hit); $0.075 Aktion | $0.50; $0.25 Aktion | 1M | Z.ai API, GLM Coding Plan, OpenRouter; MIT-Gewichte auf Hugging Face; Aktion endet am 9. September |
| Tencent Hy4 Preview | $0.834 ($0.042 Cache-Hit) | $2.501 | 1M+ | Offene Gewichte (Apache 2.0); Tencent Cloud TokenHub, OpenRouter, WorkBuddy, CodeBuddy |
| Qwen3.8-Flash-Next | Anbieterabhängig | Anbieterabhängig | 262K (bis 1M) | Offene Gewichte (Qwen Community License 1.0); Hosting-Kosten kommen hinzu |
| MiMo-V2.6-Pro | $0.435 | $0.87 | 1M | Offene Gewichte (MIT); Hosting-Kosten fallen an |
| ERNIE 5.1 | China-Region-Preise | China-Region-Preise | 256K | Baidu Gratisversion |
| Gemini Spark (Agent) | Nicht API-bepreist | Nicht API-bepreist | 1M (Gemini-Basis) | Google AI Pro $19.99, AI Ultra $99.99 oder $199.99/Mon. |
| Fello AI (Aggregator) | Über die App geroutet | Über die App geroutet | Modellabhängig | $9.99/Mon., Gratisversion verfügbar |
Die oben genannten Raten für GPT-5.5 und GPT-5.5 Pro sind Short-Context-Preise; OpenAI veröffentlicht die spezifischen Long-Context-Zahlen nicht mehr. Die GPT-5.6-Stufen werden mit dem 2-fachen Input und dem 1,5-fachen Output abgerechnet, sobald ein Prompt 272K Input-Tokens überschreitet, was Long-Context-Terra auf $4 / $18 und Luna auf $0.40 / $1.80 bringt. Für die GPT-6-Stufen veröffentlicht OpenAI keinen Long-Context-Aufschlag, und ihre Cache-Lesezugriffe sind 90 % günstiger: $1.00 für Astra, $0.20 für Sol und $0.01 für Luna. Grok 4.6 funktioniert genauso, beißt aber härter: Ab 200.000 Prompt-Tokens rechnet SpaceXAI die gesamte Anfrage zum höheren Satz ab statt nur den Überhang, sodass ein Überschreiten um tausend Tokens die Kosten des ganzen Aufrufs verdoppelt. Die andere Preisliste, die man zweimal lesen sollte, ist die von DeepSeek: Seit dem 16. August werden beide V4-Modelle werktags von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC zum Spitzentarif abgerechnet und in jeder anderen Stunde zu genau der Hälfte, sodass dieselbe Aufgabe je nach Ausführungszeitpunkt doppelt so viel kosten kann. Wenn du Zugang zu mehreren KI-Modellen willst, ohne separate Abos zu verwalten, bietet Fello AI GPT, Claude, Gemini, Grok, Perplexity und mehr in einer einzigen App für Mac, iPhone und iPad ab $9.99/Monat.
Beste Open-Weight-Modelle im September 2026
Das beste Modell mit offenen Gewichten im September 2026 ist MiMo-V2.6-Pro, das Xiaomi am 21. September unter schlichtem MIT veröffentlicht hat: 1,02 Billionen Parameter mit 42 Milliarden aktiven, 1M Tokens Kontext und die Gewichte am selben Tag auf Hugging Face. Artificial Analysis misst ihn mit 46,3 auf Intelligence Index v4.3.2, der höchste offene Wert, den sie je veröffentlicht hat, über GLM-5.3 mit 44,8 und Kimi K3 mit 43,6, und das zu $0,13 pro Index-Aufgabe, günstiger als jedes andere offene Modell auf dieser Seite. Er nimmt außerdem 34,8 % auf Terminal-Bench 4.0 und 1673 auf GDPval-AA v2.1, womit er Kimi K3 auf beiden schlägt. Zwei ehrliche Grenzen: Kein Arena-Board hat ihn bewertet, es gibt also überhaupt keinen Beleg zur menschlichen Präferenz, und er ist vier Tage alt, hat also keine unabhängige Historie. Das am höchsten platzierte offene Modell auf Arena bleibt Kimi K3, Siebter auf WebDev mit 1658 und Fünfter beim Signal für Aufgabenerfüllung der Agent Arena, und GLM-5.3 bleibt mit 41,9 % gegen MiMos 34,8 % das stärkste offene Modell auf dem Terminal-Bench 4.0 von Artificial Analysis, allerdings unter einer eigenen Z.ai-Lizenz statt MIT. Die praktische Empfehlung für Teams, die eigene Gewichte betreiben, ist weiterhin GLM 5.3 Flash (Z.ai, MIT), erschienen am 26. August mit 41,8 auf v4.3.2, 320 Mrd. gesamt und 18 Mrd. aktiv, denn ein Modell mit 1,02 Billionen Parametern ist nichts für eine Workstation, und der K3-Download umfasst 96 Safetensors-Shards und rund 1,56 TB. Die günstige offene Stufe hat sich am 10. September erneut geändert: DeepSeek hat V4-Flash 0731 eingestellt und durch DeepSeek-V4.1-Flash ersetzt, 552 Mrd. mit 8 Mrd. aktiv beim Prefill und 16 Mrd. beim Decode, nativ multimodal, am ersten Tag unter MIT, mit 39,5 auf v4.3.2 gegen 34,3 für den abgelösten Build, und preislich zurück auf $0,15 / $0,60 außerhalb der Spitzenzeiten. Er ist zudem Dritter beim Signal für Aufgabenerfüllung der Agent Arena, das beste offene Modell dort. Von den drei Releases, die den August abschlossen, veröffentlichte GLM 5.3 seine Gewichte am 28. August unter einer eigenen Lizenz mit einer Klausel, nach der jeder Model-as-a-Service-Betreiber mit mehr als 10 Milliarden Dollar Umsatz zuerst eine Z.ai-Sicherheitsprüfung bestehen muss; Alibabas Qwen3.8-Flash-Next, ein Mixture-of-Experts mit 125 Mrd. Parametern und nur 6 Mrd. aktiv, der die Qwen4-Architektur vorwegnimmt, erreicht 39,8 und liegt auf Rang neun von Arenas WebDev-Board; und Tencents Hy4 Preview, 770 Mrd. gesamt und 49 Mrd. aktiv unter Apache 2.0, hat keine Bewertung von Artificial Analysis, liegt aber mit 1624 auf Rang elf bei Arena WebDev. Beachten Sie außerdem, dass GLM 5.3 Flash kein beschnittener GLM 5.3 ist, sondern ein eigenes Modell auf neu trainierter Basis, weshalb es unter schlichtem MIT erscheinen konnte, das Flaggschiff aber nicht.
| Modell | Am besten für | Schlüssel-Benchmark | Kontext / Lizenz | Wo laufen lassen |
|---|---|---|---|---|
| MiMo-V2.6-Pro | Höchster je gemessener offener Intelligence Index | II 46,3 (v4.3.2), über GLM-5.3 und Kimi K3, bei $0,13 pro Index-Aufgabe; 34,8 % Terminal-Bench 4.0; GDPval-AA v2.1 1673; 1,02 Billionen/42 Mrd. aktiv | 1M / MIT | Hugging Face (XiaomiMiMo), Anbieter, Selbsthosting |
| Kimi K3 | Am höchsten platziertes offenes Modell auf Arena | II 43,6 (v4.3.2); #5 Arena WebDev, beste offene Platzierung; #5 Agent Arena; 2.8T/104B aktiv | 1M / Kimi K3 License | Hugging Face (96 Shards, 1.56 TB), Moonshot API, Anbieter |
| GLM 5.3 Flash | Bestes offenes Modell, das die meisten Teams wirklich betreiben können | II 41,8 (v4.3.2), auf der Pareto-Front aus Intelligenz und Kosten bei rund $0.25 pro Index-Aufgabe; 320B/18B aktiv, nativ multimodal | 1M / MIT | Hugging Face, Z.ai API ($0.15/$0.50), OpenRouter |
| GLM-5.2 | Rückfalloption mit unabhängigem Nachweis | II 33,7 (v4.3.2); #19 Arena WebDev (1,591.8), #17 Agent Arena; 744B/40B aktiv | 1M / MIT | Z.ai, Hugging Face, OpenRouter |
| GLM 5.3 | Seit dem 28. August offen, aber unter eigener Lizenz | II 44,8 (v4.3.2), der höchste offene Wert, den wir gefunden haben; gleiche 744B-Basis wie GLM-5.2, nur nachtrainiert, veröffentlichter Checkpoint mit 753B gezählt; CyberGym 84,5 % und Terminal-Bench 3.0 28,3 (Herstellerangaben) | 1M / GLM 5.3 License (Model-as-a-Service über 10 Mrd. USD Umsatz braucht eine Z.ai-Sicherheitsprüfung) | Hugging Face, Z.ai API ($1.40/$4.40), GLM Coding Plan, ZCode |
| DeepSeek V4.1-Flash | Bester offener Wert, wenn du selbst hostest | II 39,5 (v4.3.2) gegen 34,3 für den abgelösten Stand V4-Flash 0731; 552B, 8B aktiv beim Prefill und 16B beim Decode | 1M / MIT | DeepSeek API ($0.15/$0.60 Nebenzeit, $0.30/$1.20 Spitzenzeit seit 10. September), lokal |
| Tencent Hy4 Preview | Bislang größtes permissiv lizenziertes Modell | 770B/49B aktiv; 2,99/4,00 auf Tencents eigenem 203-Aufgaben-Panel gegen 2,94 für Kimi K3 und 2,92 für GLM 5.3 (Hersteller); keine Bewertung von Artificial Analysis; #11 Arena WebDev (1624) | 1M+ / Apache 2.0 | Hugging Face (BF16 und FP8), Tencent Cloud TokenHub, OpenRouter |
| Qwen3.8-Flash-Next | Vorschau auf die Qwen4-Architektur | 125B gesamt plus 51B N-Gramm-Embedding, 6B aktiv; 91,7 GPQA Diamond und 62,5 SWE-Bench Pro (Hersteller); II 39,8 (v4.3.2); #9 Arena WebDev (1635) | 262K bis 1M / Qwen Community License 1.0 | Hugging Face, Anbieter, Self-Hosting |
| LongCat-2.0 | Frontier-offener Coder, trainiert auf chinesischen Chips | II 33 (v4.1); 59,5 % SWE-Bench Pro (Anbieter), 1.6T/~48B aktiv | 1M / MIT | Hugging Face, GitHub, OpenRouter |
| MiniMax M3 | Günstig multimodal auf Frontier-Niveau | II 44 (v4.1), 59 % SWE-Bench Pro, multimodal | 1M / Lizenz TBD | Hugging Face, API $0.30/1M (50 % Rabatt) |
| Nex-N2-Pro | Stärkster offener Coding-Wert | II 41 (v4.1); 80,8 SWE-Bench Verified, 397B/17B aktiv | Qwen-basiert / Apache 2.0 | Hugging Face, Anbieter, Selbst-Host |
| Kimi K2.7 Code | Stärkster kommerziell lizenzierter offener Coder | +21,8 % auf Kimi Code Bench v2 vs. K2.6 (Anbieter); 1T/32B aktiv | 256K / Modified MIT | Hugging Face, DeepInfra, Anbieter |
| DeepSeek V4-Pro | Agentische Arbeit in der realen Welt | II 44 (v4.1), 1.6T/49B aktiv | 1M / MIT | DeepSeek API ($0.66/$1.98 außerhalb der Spitze, $1.32/$3.96 zur Spitze seit 16. August), lokal |
| Hy3 | Neuester Kandidat mit permissiver Lizenz | II 41 (v4.1); #22 auf Arena WebDev (1,516.4) | Apache 2.0 | Hugging Face, Anbieter, Selbst-Host |
| Inkling | Thinking Machines' erstes open model | II 41 (v4.1), agentisch 32,3, veröffentlicht 15. Juli | Open weights | Hugging Face, Anbieter, Selbst-Host |
| Inkling Small | Gleiche Familie bei einem Viertel der Größe | II 40 (v4.1), agentisch 30,8; 276B/12B aktiv, Text, Bild und Audio Input | Apache 2.0 | Hugging Face (BF16 und NVFP4), Anbieter, Selbst-Host |
| NVIDIA Nemotron 3 Ultra | NVIDIA-abgestimmt, voll permissive Lizenz | II 38 (v4.1), 65-70,4 SWE-Bench Verified, 550B/55B aktiv | 1M / OpenMDW | OpenRouter, Hugging Face, AWS (8x B200 Selbst-Host) |
| Qwen 3.5 (397B / 17B aktiv) | Multimodal, schnelles Decoding | 88,4 GPQA, 91,3 AIME 2026, 83,6 LiveCodeBench v6 | 1M / offen | Together, OpenRouter, lokal |
| Qwen3.6-35B-A3B | Effizienter offener agentischer Coder (3B aktiv) | 86,0 GPQA Diamond, 92,7 AIME 2026, 35B/3B aktiv | 262K (bis 1M YaRN) / Apache 2.0 | Hugging Face, OpenRouter, lokal |
| Qwen3.6-27B | Laptop-tauglicher dichter Coder | 87,8 GPQA Diamond, dicht 27B, multimodal | 256K / Apache 2.0 | Lokal Mac/PC, Hugging Face, OpenRouter |
| Rio 3.5 Open 397B | Qwen-3.5-Fine-tune, mehrsprachiges Reasoning | 70,8 Terminal-Bench 2.1 (First-Party), schlägt Qwen 3.7 Plus in 4/5 | 397B/17B aktiv / MIT | Hugging Face, Anbieter, Selbst-Host |
| Llama 4 Maverick | Flaggschiff der Meta-Reihe | 17B aktiv / 400B Gesamtparameter | Llama 4 License | Meta-Cloud, Hugging Face, lokal |
| NVIDIA Nemotron 3 Nano Omni | Edge / Low-Power | Multimodal, sehr kleiner Footprint | Kompakt / offen | Lokal, NVIDIA-Tool |
Lizenzierung zählt hier ebenso wie der reine Wert, und der August hat den Abstand zwischen den beiden Gruppen vergrößert. Kimi K2.7 (Modified MIT), DeepSeek V4 (MIT), GLM 5.3 Flash (MIT), MiMo-V2.6-Pro (MIT), GLM-5.2 (MIT), LongCat-2.0 (MIT), Hy3 (Apache 2.0), Hy4 Preview (Apache 2.0), Nex-N2-Pro (Apache 2.0) und Nemotron 3 Ultra (OpenMDW) erlauben alle klar die kommerzielle Nutzung ohne Umsatzprüfung. Der Rest trägt Bedingungen, die man lesen sollte, bevor man darauf aufbaut: MiniMax M3 und MiniMax H3 kommen unter ihren eigenen Community-Lizenzen, wobei H3 zusätzlich einen Antrag aus den USA, der EU, dem Vereinigten Königreich und Südkorea verlangt; Kimi K3 sitzt auf einer eigenen Lizenz mit einer Umsatzschwelle für alle, die es als Service weiterverkaufen; GLM 5.3 verlangt eine Z.ai-Sicherheitsprüfung für jeden Model-as-a-Service-Betreiber über 10 Milliarden Dollar Umsatz; und die Qwen Community License 1.0 bei Qwen3.8-Flash-Next verlangt eine separate Lizenz von Qwen, um ein Model-as-a-Service- oder ein KI-Arbeitsassistenz-Geschäft zu betreiben, wobei interne Nutzung ausgenommen ist. Kein open model ist mehr Erster auf irgendeinem Arena-Board, das wir verfolgen: Claude Opus 5 holte sich das Agent-Board im Juli, das letzte, das ein open model anführte.
Benchmarks, Preise und Hands-on-Nutzung
Jedes Ranking auf dieser Seite kombiniert drei Eingaben: öffentliche Benchmarks von sieben unabhängigen Häusern (Artificial Analysis, Arena früher LMArena, Scale SEAL, LiveBench, EQ-Bench, ARC Prize und das offizielle Terminal-Bench-4.0-Board, mit Abdeckung der Intelligence Index, GPQA Diamond, ARC-AGI-1 bis 3, Humanity's Last Exam, GDPval-AA, FrontierMath, HMMT, MCP Atlas, SWE Atlas und dem Remote Labor Index), veröffentlichte API- und Abo-Preise von der offiziellen Preisseite jedes Anbieters und Hands-on-Nutzung durch das FelloAI-Redaktionsteam, das echte Prompts über dieselbe Aufgabe auf jedem Modell laufen lässt. Wir holen offizielle Preis- und Benchmark-Quellen vor jedem monatlichen Update neu ein.
Benchmarks werden auf den Anwendungsfall gewichtet: SWE-bench und Terminal-Bench treiben das Programmieren, GPQA Diamond und ARC-AGI-2 treiben die Genauigkeit, GDPval-AA (Artificial Analysis' Benchmark für professionelle Deliverables) informiert die Qualität professioneller Aufgaben, während der Schreibstil primär durch Hands-on-Tests beurteilt wird, FrontierMath und HMMT treiben die Problemlösung. Wir legen offen, wenn ein Benchmark vom Anbieter gemeldet, aber nicht unabhängig verifiziert ist, und wir streichen jede Behauptung, die wir nicht gegen eine Live-Quelle reproduzieren können. Wir ranken nach gemessenen Werten: Eine Kategoriekrone wandert, sobald ein Modell den Titelhalter auf den Boards schlägt, die diese Kategorie definieren, ohne auf die stimmbasierten Boards zu warten, und ein Modell, das noch nicht breit verfügbar ist, wird auf seiner Karte gekennzeichnet statt von ihr ausgeschlossen. Wir prüfen Ränge ebenso nach wie Zahlen, denn ein Wert kann korrekt bleiben, während sich das Board darum herum bewegt. Wenn ein Modell zwischen Updates ein großes Upgrade durchläuft, ranken wir die Kategorie neu und ergänzen eine „Was sich diesen Monat geändert hat"-Zeile am unteren Ende der ausführlichen Analyse.
Fello AI vereint die besten KI-Modelle in einer leichten nativen App.
Wechsle jederzeit zwischen ihnen, keine separaten Abos.
Fello AI laden