Google hat Gemini 3.6 Flash am 21. Juli 2026 veröffentlicht, und die Schlagzeile ist keine Benchmark-Zahl. Es ist der Preis. Output-Tokens kosten jetzt $7.50 pro Million, runter von $9.00 bei Gemini 3.5 Flash, während der Input-Preis bei $1.50 pro Million blieb. Obendrein verbraucht das Modell 17 % weniger Output-Tokens, um dieselbe Arbeit zu erledigen, sodass die tatsächliche Ersparnis deutlich unter dem liegt, was der reine Listenpreis vermuten lässt.
Diese Einführungspreise gelten nicht mehr. Als Gemini 3.7 Flash am 13. August 2026 erschien, hat Google Gemini 3.6 Flash auf denselben Einführungstarif von $0.75 pro Million Input-Tokens und $3.75 pro Million Output umgestellt. Beide Modelle kehren zu $1.50 / $7.50 am 1. Januar 2027 zurück. Alles Folgende beschreibt den Launch, wie er tatsächlich ablief, mit dem aktuellen Preis dort markiert, wo es wichtig ist.
Der Launch war größer als ein einzelnes Modell. Google brachte am selben Tag Gemini 3.5 Flash-Lite und ein sicherheitsoptimiertes Gemini 3.5 Flash Cyber heraus. Außerdem bestätigte Google, dass Gemini 3.5 Pro weiterhin im Partnertest feststeckt, und enthüllte nebenbei, dass das Pre-Training für Gemini 4 bereits begonnen hat. Dieser Artikel deckt das komplette Datenblatt ab, jeden veröffentlichten Benchmark, was die Kritiker bereits sagen, wo du das Modell heute tatsächlich nutzen kannst, und ob sich ein Wechsel lohnt.
Die wichtigsten Punkte
- Gemini 3.6 Flash erschien am 21. Juli 2026 zu $1.50 Input / $7.50 Output pro Million Tokens, wobei der Input-Preis unverändert blieb und der Output von $9.00 sank. Google senkte ihn am 13. August 2026 erneut auf $0.75 / $3.75, um mit Gemini 3.7 Flash gleichzuziehen, und beide Preise verdoppeln sich am 1. Januar 2027.
- Es verbraucht 17 % weniger Output-Tokens als Gemini 3.5 Flash, bei DeepSWE sogar bis zu 65 % weniger, und generiert sie mit 304 pro Sekunde. Nur das neue Flash-Lite ist mit 350 schneller.
- Der Wissensstand springt von Januar 2025 auf März 2026, ein Sprung von 14 Monaten, der wohl das größte praktische Upgrade ist.
- Es schlägt 3.5 Flash bei jedem veröffentlichten Benchmark, darunter 58,7 % gegenüber 55,1 % bei SWE-Bench Pro. Es übertrifft außerdem Googles eigenes Gemini 3.1 Pro im Artificial Analysis Intelligence Index, 50 zu 46.
- Der Haken: Unabhängige Tests bewerten es mit 50 im Artificial Analysis Intelligence Index, exakt genauso wie Gemini 3.5 Flash. Es ist schneller und günstiger, nicht klüger.
Was ist Gemini 3.6 Flash?
Gemini 3.6 Flash ist Googles schnelles, günstiges Einstiegsmodell, positioniert für agentisches Coding, Computer Use und Reasoning über lange Dokumente statt für rohe Frontier-Intelligenz. Es steht in Googles Hierarchie unter der Pro-Linie, bietet aber dasselbe 1-Millionen-Token-Kontextfenster, die Spezifikation, auf die es den meisten in der Praxis ankommt. Inzwischen wurde es von Gemini 3.7 Flash abgelöst, das dieselben Specs erreicht und es bei jedem veröffentlichten Benchmark zum selben Einführungspreis schlägt.
Googles Darstellung in der offiziellen Launch-Ankündigung setzt stark auf das Zeitalter der Agenten, und die Auswahl der Benchmarks spiegelt das wider. Das Modell wurde auf mehrstufige Orchestrierung, Full-Stack-Refactoring und IDE-Agentenarbeit abgestimmt, nicht darauf, akademische Reasoning-Tests zu gewinnen.
Das komplette Datenblatt
| Spezifikation | Gemini 3.6 Flash |
|---|---|
| Modell-ID | gemini-3.6-flash |
| Input-Kontextfenster | 1.048.576 Tokens (1M) |
| Output-Limit | 65.536 Tokens (64k) |
| Wissensstand | März 2026 |
| Input-Modalitäten | Text, Bild, Video, Audio, PDF |
| Output-Modalitäten | Text |
| Thinking-Modus | Unterstützt |
| Function Calling | Unterstützt |
| Grounding | Google Search und Google Maps |
| Structured Output | Unterstützt |
| Context Caching | Unterstützt |
| Batch-Verarbeitung | Unterstützt |
| Veröffentlicht | 21. Juli 2026 |
Die genauen Zahlen stammen aus der Gemini API-Modelldokumentation, der maßgeblichen Quelle, wenn du das in Produktionscode einbaust. Wie sich 3.6 Flash mit jedem anderen Gemini-Modell vergleicht, zeigt unser vollständiger Gemini-Modellvergleich.
Der Sprung beim Wissensstand, über den niemand spricht
Gemini 3.5 Flash hatte einen Wissensstand von Januar 2025. Gemini 3.6 Flash verschiebt das auf März 2026. Das ist ein Sprung von 14 Monaten, und für Alltagsnutzer zählt das mehr als jeder Prozentpunkt bei einem Coding-Benchmark.
Ein Modell mit Wissensstand Januar 2025 wusste nichts von der Existenz von GPT-5.6, Grok 4.5 oder Claude Sonnet 5. Es kannte weder die aktuellen Preise der Tools, die du nutzt, noch neue Framework-Releases oder irgendetwas aus den Nachrichten des letzten Jahres. Die 3.6-Flash-Version weiß das alles, was selbstbewusst falsche Antworten zu aktuellen Themen deutlich reduziert.
Gemini 3.6 Flash: Preise
Die Preisgeschichte ist konkreter, als die meiste Berichterstattung vermuten lässt. Beim Launch bewegte sich der Input-Preis nicht. Nur der Output-Preis wurde gesenkt, und zwar um genau $1.50 pro Million Tokens. Drei Wochen später senkte Google beide: Seit 13. August 2026 kostet Gemini 3.6 Flash $0.75 Input und $3.75 Output pro Million, derselbe Einführungstarif wie bei Gemini 3.7 Flash, und beide kehren zu $1.50 / $7.50 am 1. Januar 2027 zurück.
| Modell | Input pro 1 Mio. Tokens | Output pro 1 Mio. Tokens | Am besten für |
|---|---|---|---|
| Gemini 3.6 Flash (aktuell) | $0.75 | $3.75 | Agentisches Coding, Computer Use, langer Kontext; verdoppelt sich am 1. Januar 2027 |
| Gemini 3.6 Flash (beim Launch) | $1.50 | $7.50 | Der Preis vom 21. Juli, ersetzt am 13. August |
| Gemini 3.5 Flash (vorheriges Modell) | $1.50 | $9.00 | Von 3.6 Flash abgelöst |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | Hochvolumige, latenzsensitive Aufgaben |
| Gemini 3.5 Flash Cyber | Nicht veröffentlicht | Nicht veröffentlicht | Schwachstellenerkennung (zugangsbeschränktes Pilotprogramm) |
Die Ersparnis summiert sich auf eine Weise, die die Tabelle nicht zeigen kann. Weil das Modell für dieselben Aufgaben auch 17 % weniger Output-Tokens generiert, zahlst du einen niedrigeren Preis für eine kleinere Anzahl an Tokens. Eine unabhängige Messung von Artificial Analysis beziffert die durchschnittlichen Kosten auf $1.16 pro Million Tokens gegenüber $1.31 bei Gemini 3.5 Flash, beide gemessen anhand der Einführungspreise und nicht der Augustsenkung.
Bei agentischen Workloads wird der Abstand noch größer. Google berichtet von bis zu 65 % weniger Output-Tokens beim DeepSWE-Benchmark, weil das Modell pro Aufgabe weniger Reasoning-Schritte und weniger Tool-Aufrufe braucht. Wenn deine Rechnung von langen Agenten-Läufen dominiert wird, ist genau dort das Geld zu holen. Unser Gemini-Preisleitfaden für 2026 zeigt, wie die API-Preise im Verhältnis zu den Consumer-Abos stehen.
Gemini 3.6 Flash: Benchmarks
Google veröffentlichte ein breites Set an Benchmarks, und Gemini 3.6 Flash gewinnt gegen seinen Vorgänger in jeder einzelnen Zeile. Die Abstände reichen von moderat bis deutlich, je nachdem, was gemessen wird.
Im Vergleich zu Gemini 3.5 Flash
| Benchmark | Was gemessen wird | Gemini 3.6 Flash | Gemini 3.5 Flash |
|---|---|---|---|
| SWE-Bench Pro | Praxisnahe Softwareentwicklung | 58,7 % | 55,1 % |
| DeepSWE v1.1 | Agentisches Coding | 49 % | 37 % |
| Terminal-Bench 2.1 | Aufgaben in der Kommandozeile | 78,0 % | 76,2 % |
| MLE-Bench | Machine-Learning-Engineering | 63,9 % | 49,7 % |
| GDPval-AA v2 | Wirtschaftlich relevante Wissensarbeit | 1421 | 1349 |
| OSWorld-Verified | Computer Use | 83,0 % | 78,4 % |
| GDM-MRCR v2 (128k) | Long-Context-Retrieval | 91,8 % | 77,3 % |
| GDM-MRCR v2 (1M) | Long-Context-Retrieval bei 1M | 54,0 % | 26,6 % |
| CharXiv (ohne Tools) | Diagramm- und Grafik-Reasoning | 85,2 % | 84,2 % |
| CharXiv (mit Tools) | Diagramm-Reasoning mit Tool-Zugriff | 89,4 % | 84,9 % |
Am deutlichsten fallen MLE-Bench auf, wo der Sprung mehr als 14 Punkte beträgt, und Long-Context-Retrieval beim vollen 1M-Fenster, wo sich der Wert verdoppelt. Das 1M-Token-Ergebnis solltest du aber genau lesen. Ein Wert von 54,0 % bedeutet, dass das Modell bei maximaler Kontextlänge immer noch etwa die Hälfte dessen verpasst, was es abrufen sollte, also behandle 1M-Token-Prompts als Fähigkeit, nicht als Garantie.
Im Vergleich zu GPT-5.6, Grok 4.5 und Claude Sonnet 5
Hier wird das Bild ehrlich. Gegen aktuelle Frontier-Modelle räumt Gemini 3.6 Flash nicht überall ab.
| Benchmark | Gemini 3.6 Flash | GPT-5.6 Luna | Grok 4.5 | Claude Sonnet 5 |
|---|---|---|---|---|
| SWE-Bench Pro | 58,7 % | Nicht veröffentlicht | 64,7 % | Nicht veröffentlicht |
| DeepSWE v1.1 | 49 % | 67 % | Nicht veröffentlicht | Nicht veröffentlicht |
| Terminal-Bench 2.1 | 78,0 % | 84,7 % | Nicht veröffentlicht | Nicht veröffentlicht |
| MLE-Bench | 63,9 % | Nicht veröffentlicht | Nicht veröffentlicht | 66,9 % |
| GDPval-AA v2 | 1421 | Nicht veröffentlicht | Nicht veröffentlicht | 1607 |
| OSWorld-Verified | 83,0 % | Nicht veröffentlicht | Nicht veröffentlicht | Nicht veröffentlicht |
Gemini 3.6 Flash liegt vorn bei OSWorld-Verified Computer Use, bei beiden CharXiv-Reasoning-Varianten und bei beiden Long-Context-Retrieval-Tests. Es verliert bei SWE-Bench Pro gegen Grok 4.5, bei DeepSWE und Terminal-Bench gegen GPT-5.6 Luna sowie bei MLE-Bench und GDPval-AA v2 gegen Claude Sonnet 5.
Das ist ein vernünftiges Ergebnis für ein günstiges Einstiegsmodell gegen Flaggschiffe, und der Preisunterschied ist groß genug, dass der Vergleich ohnehin hinkt. Die komplette Rangliste findest du in unserer Liste der besten KI-Modelle. Die Spitze dieses Feldes verschob sich am 3. September 2026 erneut, als OpenAI GPT-6 Astra zu $10.00 / $50.00 pro Million Tokens veröffentlichte; es wird nach einer späteren Revision des Intelligence Index bewertet als die v4.1-Werte unten, sodass die beiden Datensätze nicht direkt vergleichbar sind.
Unabhängige Tests: Wo Gemini 3.6 Flash tatsächlich steht
Googles eigene Benchmark-Tabelle vergleicht das Modell nur mit seinen Vorgängern. Die unabhängige Messung von Artificial Analysis stellt es dem gesamten Feld gegenüber, und das Bild ist interessanter.
Artificial Analysis Intelligence Index

Der Intelligence Index v4.1 setzt sich aus neun einzelnen Auswertungen zusammen, darunter GDPval-AA v2, Terminal-Bench v2.1, SciCode, Humanity’s Last Exam, GPQA Diamond, CritPt und AA-LCR. Gemini 3.6 Flash erreicht 50 Punkte und landet damit auf Platz 11 unter den 26 führenden Modellen, die Artificial Analysis am Launch-Tag erfasst hat.
| Platz | Modell | Intelligence Index |
|---|---|---|
| 1 | Claude Fable 5 (with fallback) | 60 |
| 2 | GPT-5.6 Sol (max) | 59 |
| 3 | Kimi K3 | 57 |
| 4 | Claude Opus 4.8 (max) | 56 |
| 5 | GPT-5.6 Terra (max) | 55 |
| 6 | Grok 4.5 (high) | 54 |
| 7 | Claude Sonnet 5 (max) | 53 |
| 8= | GPT-5.6 Luna (max) | 51 |
| 8= | GLM-5.2 (max) | 51 |
| 8= | Muse Spark 1.1 (xhigh) | 51 |
| 11 | Gemini 3.6 Flash | 50 |
| 12 | Gemini 3.1 Pro Preview | 46 |
| 12= | Qwen3.7 Max | 46 |
| 14 | MiniMax-M3 | 44 |
| 14= | DeepSeek V4 Pro (max) | 44 |
| 16 | MiMo-V2.5-Pro | 42 |
| 20 | Gemini 3.5 Flash-Lite | 36 |
| 22 | Claude 4.5 Haiku | 30 |
Das Detail, das Google in keiner Pressemitteilung erwähnt hat, steht in Zeile 12. Gemini 3.6 Flash erreicht 50 gegenüber 46 für Gemini 3.1 Pro Preview. Googles günstiges Flash-Modell übertrifft jetzt sein eigenes Pro-Modell im zusammengesetzten Index, was ebenso viel darüber aussagt, wie lange die Pro-Linie schon stillsteht, wie über Flash selbst.
Der Abstand zu den tatsächlichen Spitzenreitern ist real, aber klein. Vier Punkte trennen Gemini 3.6 Flash von Claude Sonnet 5 und zehn von Claude Fable 5, und diese Modelle kosten pro Token deutlich mehr.
Ausgabegeschwindigkeit
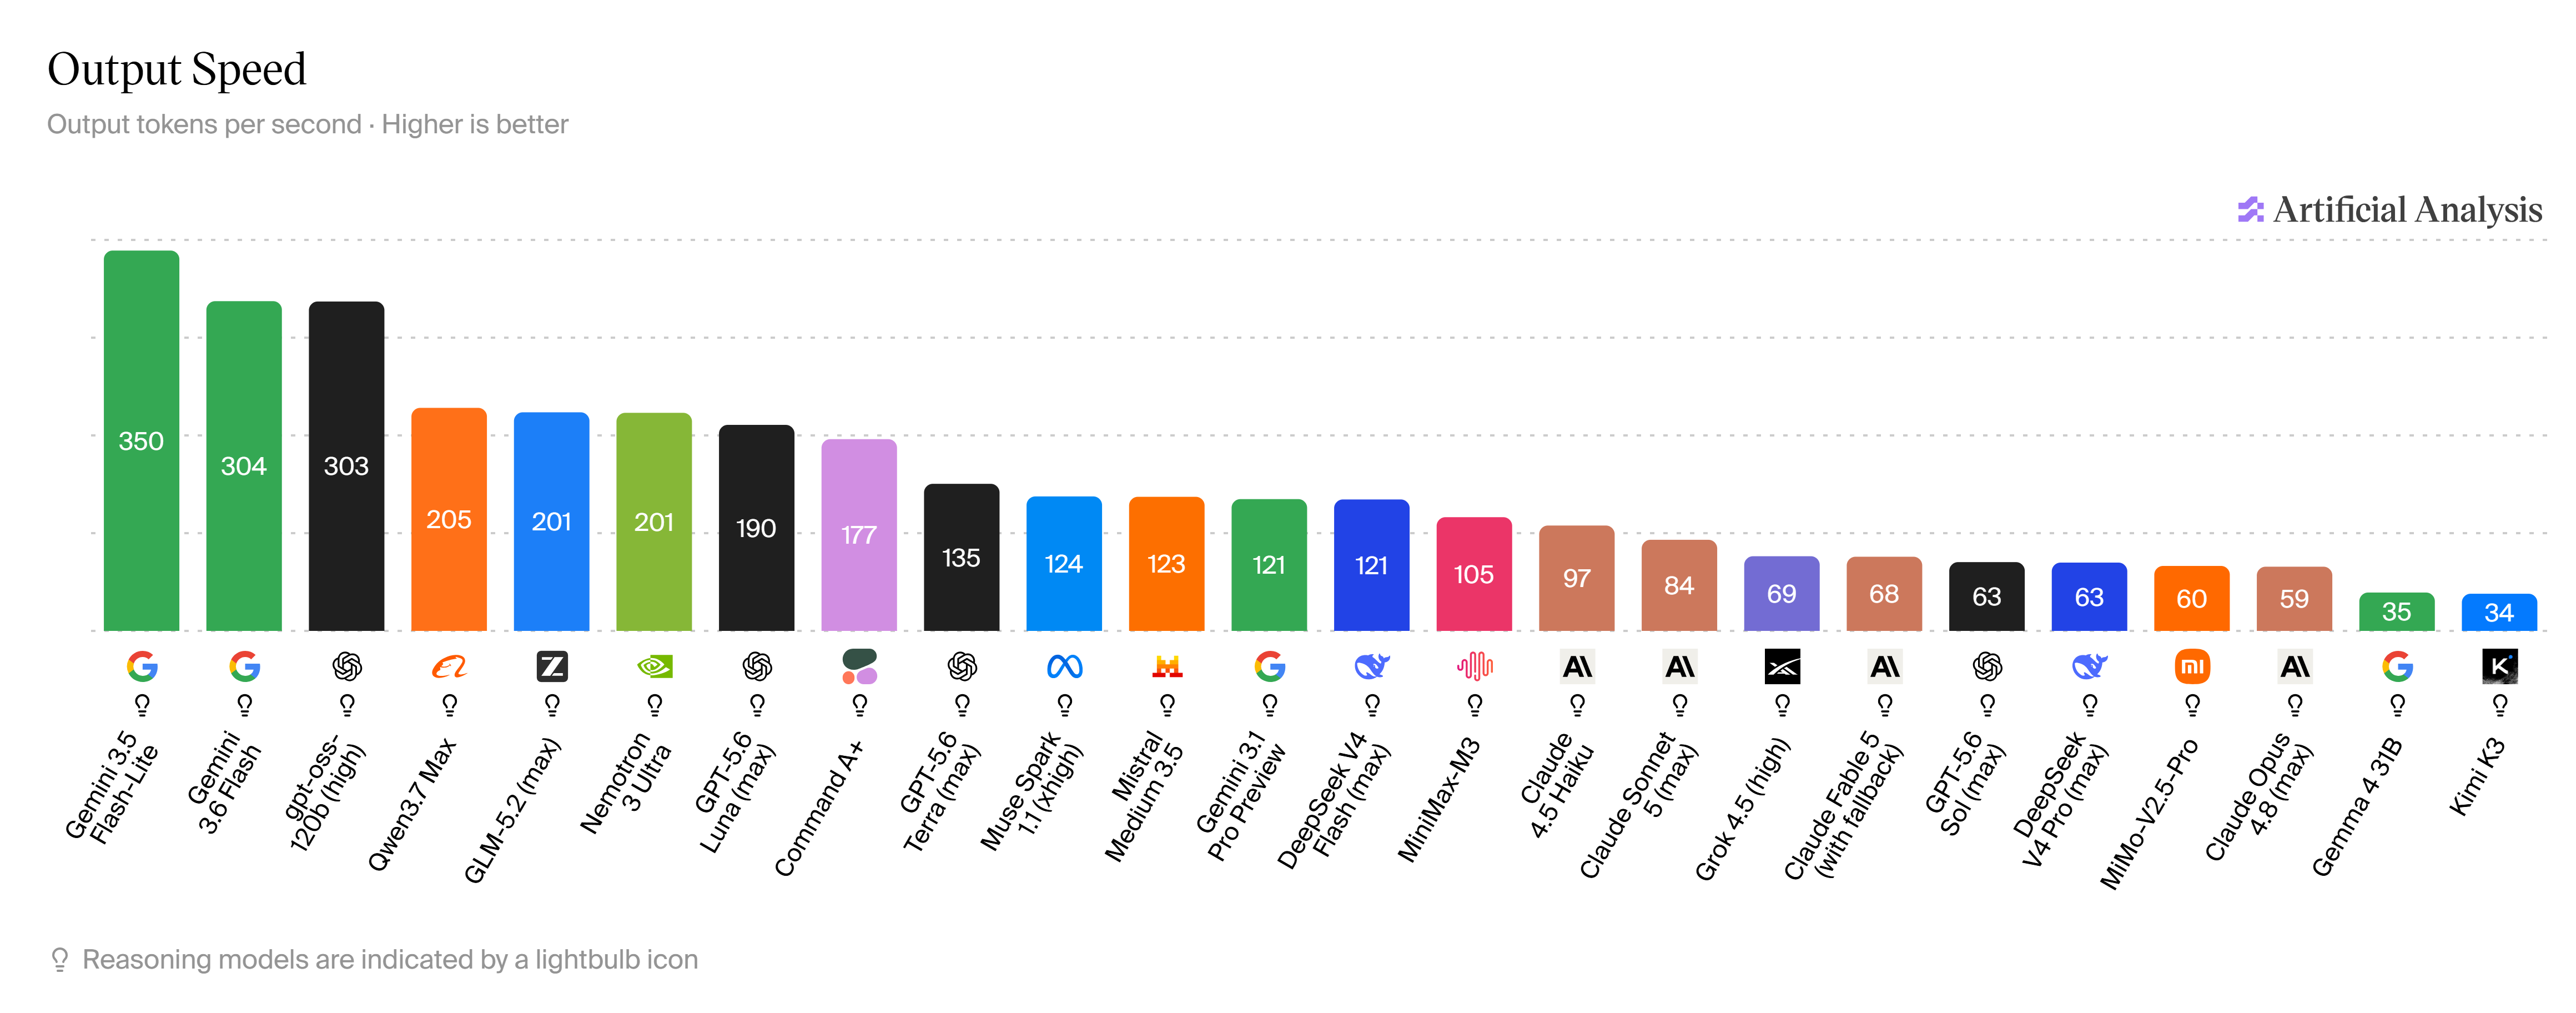
Bei der reinen Generierungsgeschwindigkeit dominiert die Flash-Familie die Tabellenspitze. Gemini 3.5 Flash-Lite ist mit 350 Output-Tokens pro Sekunde das schnellste Modell, das Artificial Analysis gemessen hat, gefolgt von Gemini 3.6 Flash mit 304.
| Modell | Output-Tokens pro Sekunde |
|---|---|
| Gemini 3.5 Flash-Lite | 350 |
| Gemini 3.6 Flash | 304 |
| gpt-oss-120b (high) | 303 |
| Qwen3.7 Max | 205 |
| GLM-5.2 (max) | 201 |
| GPT-5.6 Luna (max) | 190 |
| GPT-5.6 Terra (max) | 135 |
| Gemini 3.1 Pro Preview | 121 |
| Claude 4.5 Haiku | 97 |
| Claude Sonnet 5 (max) | 84 |
| Grok 4.5 (high) | 69 |
| GPT-5.6 Sol (max) | 63 |
| Claude Opus 4.8 (max) | 59 |
| Kimi K3 | 34 |
Google belegt jetzt die zwei schnellsten Plätze der Branche, und der Abstand ist deutlich. Gemini 3.6 Flash generiert Tokens rund 3,6-mal schneller als Claude Sonnet 5 und etwa fünfmal schneller als Claude Opus 4.8. Bei allem, was Output an Nutzer streamt oder Tausende Agentenschritte durchläuft, summiert sich dieser Unterschied zu echter gesparter Zeit.
Was die Kritiker zu Gemini 3.6 Flash sagen
Die Aufnahme war nicht durchweg wohlwollend, und die Kritik ist ernst zu nehmen, weil sie auf unabhängigen Messungen beruht und nicht auf einem Bauchgefühl.
Artificial Analysis bewertet Gemini 3.6 Flash mit 50 im Intelligence Index, Platz 21 von insgesamt 187 getesteten Modellen. Das Problem: Gemini 3.5 Flash erreicht ebenfalls 50. Bei diesem zusammengesetzten Maß ist das neue Modell nicht klüger als das, das es ersetzt. Medien wie WCCFTech haben diesen Befund aufgegriffen und den Launch als enttäuschend eingeordnet.
Die Rangliste stützt diesen Einwand. Muse Spark 1.1, GLM-5.2 und GPT-5.6 Luna erreichen alle 51, Claude Sonnet 5 kommt auf 53, Grok 4.5 auf 54 und GPT-5.6 Terra auf 55. Mehrere davon sind schon seit Wochen oder Monaten verfügbar. Gemini 3.6 Flash kam als neues Modell heraus und landete hinter allen von ihnen.
Gemini 3.6 Flash generiert Tokens sehr schnell, mit 303,6 Tokens pro Sekunde gegenüber 165,4 bei 3.5 Flash. Doch seine Time to First Token liegt bei 11,54 Sekunden, deutlich über dem Median von rund 2,8 Sekunden für Reasoning-Modelle in seiner Preisklasse. Es denkt eine Weile nach, bevor es zu antworten beginnt, wodurch es sich im interaktiven Chat langsamer anfühlt, als der Durchsatzwert vermuten lässt.
Frühe Tests aus der Community berichten außerdem von schwachen Ergebnissen bei Frontend-Generierung und räumlichen Reasoning-Prompts, wobei die Tester selbst darauf hinwiesen, dass das eher an einem niedrigeren Standard-Thinking-Budget liegen könnte als an der tatsächlichen Obergrenze des Modells. Behandle diese Berichte bis zu systematischeren Auswertungen als anekdotisch.
Fair zusammengefasst hat Google in diesem Zyklus auf Kosten, Geschwindigkeit und Token-Effizienz optimiert statt auf rohe Fähigkeiten. Das ist ein legitimes technisches Ziel und für hochvolumige Produktions-Workloads wohl sogar das nützlichere. Es ist nur nicht dasselbe wie ein klügeres Modell, und das Marketing verwischt diese Grenze.
Wo du Gemini 3.6 Flash nutzen kannst
Googles eigene Plattformen
Gemini 3.6 Flash war sofort in der Gemini-App, Google AI Studio, der Gemini API, Android Studio, Google Antigravity und der Gemini Enterprise Agent Platform verfügbar. Google sagt, die neuen Modelle erscheinen für alle in der Gemini-App, hat aber keine Aufschlüsselung der Limits nach Tarif veröffentlicht, daher gelten die Kontingente im Gratis-Tarif vorerst als unbestätigt. Unser Ratgeber dazu, ob Gemini kostenlos ist, erklärt, wie die Tarifstruktur heute aussieht.
GitHub Copilot
Das Modell landete am Launch-Tag in GitHub Copilot für Abonnenten von Copilot Pro, Pro+, Max, Business und Enterprise. Du kannst es in Visual Studio Code, Visual Studio, der Copilot CLI, dem GitHub-Copilot-Cloud-Agent, der Copilot-App, JetBrains-IDEs, Xcode und Eclipse auswählen.
Ein praktischer Haken für Teams: Administratoren von Copilot Business und Enterprise müssen erst die Richtlinie „Gemini 3.6 Flash Preview“ in den Copilot-Einstellungen aktivieren, bevor irgendjemand in der Organisation das Modell auswählen kann. Falls es in deiner Modellliste fehlt, ist diese Einstellung der erste Anlaufpunkt. Die Nutzung wird beim nutzungsbasierten Billing zu den Listenpreisen des Anbieters abgerechnet.
Die anderen zwei Modelle, die Google veröffentlicht hat
Gemini 3.5 Flash-Lite
Flash-Lite setzt auf Volumen, zum Preis von $0.30 Input und $2.50 Output pro Million Tokens. Mit 350 Output-Tokens pro Sekunde ist es das schnellste Modell, das Artificial Analysis derzeit misst, mit deutlichem Abstand vor jedem Flaggschiff am Markt. Auch die Fortschritte zur Vorgängergeneration sind erheblich. Es erreicht 54 % bei Terminal-Bench 2.1 gegenüber 31 % beim vorherigen Flash-Lite und 1140 bei GDPval-AA v2 gegenüber 642. Long-Context-Retrieval steigt von 60,1 % auf 72,2 %. Google rollt es außerdem in die Google-Suche aus.
Der Kompromiss zeigt sich im Intelligence Index, wo Flash-Lite 36 gegenüber 50 für Gemini 3.6 Flash erreicht. Du kaufst dir Geschwindigkeit und Volumen, keine Reasoning-Tiefe.
Gemini 3.5 Flash Cyber
Flash Cyber ist ein Spezialmodell, feinabgestimmt darauf, Software-Schwachstellen zu finden, zu validieren und zu patchen, und läuft innerhalb von Googles CodeMender-Agent mit mehreren parallel arbeitenden Instanzen. In Googles veröffentlichten Ergebnissen gegen die V8-JavaScript-Engine fand es 55 einzigartige bestätigte Probleme, gegenüber 47 bei Gemini 3.5 Flash und 36 bei Claude Opus 4.6.
Du wirst es mit ziemlicher Sicherheit nicht selbst nutzen können. Google sagt, das Modell werde exklusiv über CodeMender für Regierungen und vertrauenswürdige Partner verfügbar sein, im Rahmen eines bald startenden Pilotprogramms mit beschränktem Zugang. Für ein Modell, das gezielt zum Aufspüren ausnutzbarer Bugs gebaut wurde, ist das eine nachvollziehbare Entscheidung.
Gemini 3.5 Pro ist verspätet, und das Training für Gemini 4 hat begonnen
Der interessanteste Teil dieses Launches ist das, was fehlte. Google versprach Gemini 3.5 Pro bei der I/O im Mai 2026 für einen Release im Juni. Erschienen ist es nicht. Google sagt inzwischen nur noch, dass das Modell weiterhin mit Partnern getestet wird und bald breit ausgerollt werden soll, ohne festes Datum.
Das setzt die gesamte Ankündigung in ein neues Licht. Statt an der Spitze des Marktes zu konkurrieren, hat Google diesen Zyklus damit verbracht, in der Flash-Klasse über Preis und Geschwindigkeit zu konkurrieren, während sich sein Flaggschiff verzögerte. Drei Flash-Modelle an einem Tag lesen sich anders, sobald man weiß, dass eigentlich das Pro-Modell die Schlagzeile hätte sein sollen.
In derselben Ankündigung versteckt war die eigentliche Schlagzeile für alle, die das große Ganze im Blick haben. Google DeepMind erklärte, es habe seinen bisher ambitioniertesten Pre-Training-Lauf für Gemini 4 gestartet und sei von den Fortschritten begeistert. Kein Zeitplan, keine Specs, nur die Bestätigung, dass die nächste Generation unterwegs ist. Wir verfolgen jedes glaubwürdige Signal in allem, was wir über Gemini 4 wissen.
Solltest du zu Gemini 3.6 Flash wechseln?
Wenn du Gemini 3.5 Flash bereits über die API nutzt, wechsle. Es gibt kein überzeugendes Argument, dabei zu bleiben. Du bekommst identisch gemessene Intelligenz, bessere Werte bei jedem veröffentlichten Benchmark, fast doppelte Ausgabegeschwindigkeit, einen um 14 Monate aktuelleren Wissensstand und eine niedrigere Rechnung, sowohl beim Preis pro Token als auch bei der Tokenzahl. Die einzige nötige Änderung ist die Modell-ID.
Wenn du zwischen Anbietern wählst, ist die Entscheidung knapper. Gemini 3.6 Flash ist nicht das leistungsfähigste verfügbare Modell, und GPT-5.6, Grok 4.5 und Claude Sonnet 5 schlagen es jeweils bei bestimmten Benchmarks. Es gewinnt bei Computer Use, langem Kontext und Kosten pro Arbeitseinheit. Für hochvolumige agentische Pipelines, bei denen du täglich für Millionen von Tokens zahlst, ist diese Kombination schwer zu schlagen. Für ein einzelnes schwieriges Reasoning-Problem greifst du besser zu einem Flaggschiff.
Die größere Lehre daraus: Kein einzelnes Modell gewinnt bei allem, und die günstige Klasse bewegt sich inzwischen so schnell, dass die heutige Antwort in wenigen Wochen veraltet ist. Genau deshalb ist es praktischer, mehrere Modelle parallel zu nutzen, als sich auf eines festzulegen. Fello AI für Mac verfolgt genau diesen Ansatz und bündelt mehrere Frontier-Modelle hinter einem einzigen Abo für $9.99/Monat, sodass du je nach Aufgabe wechseln kannst, statt separate Rechnungen zu zahlen. Unser Überblick dazu, wann du welches KI-Modell nutzt, ist ein guter Ausgangspunkt, um dir diese Gewohnheit anzueignen.
Die genauere Geschichte, wie sich diese Klasse entwickelt hat, findest du in unserem Gemini 3.5 Flash Review, das sich mit dem Modell befasst, das 3.6 Flash gerade abgelöst hat.
FAQ
Was ist Gemini 3.6 Flash?
Gemini 3.6 Flash ist Googles schnelles, günstiges KI-Modell, veröffentlicht am 21. Juli 2026. Es startete zu $1.50 pro Million Input-Tokens und $7.50 pro Million Output-Tokens und kostet jetzt $0.75 / $3.75, bietet ein 1-Millionen-Token-Kontextfenster und ist für agentisches Coding, Computer Use und Reasoning über lange Dokumente gebaut.
Ist Gemini 3.6 Flash besser als Gemini 3.5 Flash?
Es schlägt Gemini 3.5 Flash bei jedem von Google veröffentlichten Benchmark, darunter 58,7 % gegenüber 55,1 % bei SWE-Bench Pro und 83,0 % gegenüber 78,4 % bei OSWorld-Verified. Es ist außerdem schneller und günstiger. Artificial Analysis bewertet allerdings beide Modelle im Intelligence Index mit 50, sodass beide bei diesem zusammengesetzten Maß gleich leistungsfähig sind.
Wie viel kostet Gemini 3.6 Flash?
Der API-Preis liegt bei $0.75 pro Million Input-Tokens und $3.75 pro Million Output-Tokens, nachdem Google den Preis am 13. August 2026 gesenkt hat, um mit Gemini 3.7 Flash gleichzuziehen. Gestartet ist es bei $1.50 / $7.50, mit einem Output-Preis, der von $9.00 bei Gemini 3.5 Flash sank. Beide aktuellen Preise verdoppeln sich am 1. Januar 2027. Google hat inzwischen zwei Nachfolger zu demselben Preis veröffentlicht, zuletzt Gemini 3.8 Flash. Gemini 3.5 Flash-Lite kostet $0.30 Input und $2.50 Output.
Was ist der Wissensstand von Gemini 3.6 Flash?
März 2026, ein Sprung von Januar 2025 bei Gemini 3.5 Flash. Dieser 14-monatige Sprung bedeutet, dass das Modell Ereignisse, Software-Releases und Preisänderungen kennt, von denen die vorherige Flash-Generation nichts wusste.
Wann erscheint Gemini 4?
Google hat kein Erscheinungsdatum genannt. In der Ankündigung zu Gemini 3.6 Flash bestätigte Google DeepMind, den bisher ambitioniertesten Pre-Training-Lauf für Gemini 4 gestartet zu haben, nannte aber weder Zeitplan noch Specs.