Metas LLaMA-Reihe wird immer besser, vor allem mit LLaMA 3.1, der neuesten Version seines großen Sprachmodells.
LLaMA 3.1 (Large Language Model Meta AI 3.1) bringt verbesserte, fast magische Fähigkeiten mit und beeindruckt mit 405 Milliarden Parametern. Außerdem schneidet es besser bei der Verarbeitung natürlicher Sprache und bei multimodalen Aufgaben ab.
Der Markt für künstliche Intelligenz wächst immer schneller: Der Wert der Branche soll sich in den nächsten sechs Jahren um mehr als das 13-Fache steigern. Wer diese Werkzeuge jetzt nicht nutzt oder sich nicht damit vertraut macht, bleibt zurück.
Dieser umfassende Leitfaden geht auf die Funktionen, die Geschichte, die Anwendungen und die Zukunftsaussichten von LLaMA 3.1 ein und vergleicht es mit anderen führenden KI-Modellen auf dem Markt. Lehn dich zurück, denn am Ende dieses Artikels hast du das nötige Grundwissen über dieses Modell, weißt, was es bedeutet, und wie es dir als nützliches Werkzeug dienen kann.
Überblick über LLaMA 3.1
LLaMA 3.1 ist ein hochmodernes, generatives Open-Source-KI-Modell von Meta. Es ist darauf ausgelegt, bei einer Vielzahl von Aufgaben zu glänzen, darunter Texterstellung, Bilderkennung und Unterstützung beim Programmieren.
Das Modell ist multimodal aufgebaut, das heißt, es kann Inhalte nahtlos in verschiedenen Formaten verarbeiten und erzeugen, darunter Text, Bilder, Audio und Video.
Das Modell verfügt über ein großes Kontextfenster und einen Wissensstand bis Dezember 2023. Dadurch liefert es präzise und relevante Antworten und ist damit ein leistungsstarkes Werkzeug für viele Anwendungsfälle.
Wichtige Spezifikationen
- Modellgröße: LLaMA 3.1 hat über 405 Milliarden Parameter und zählt damit zu den größten verfügbaren Sprachmodellen. Diese enorme Größe ermöglicht es, komplexe Sprachmuster zu erfassen und nuancierten Text deutlich leichter zu erzeugen als andere Modelle.
- Kontextfenster: Das Modell unterstützt ein Kontextfenster von 128.000 Token, wodurch es auch bei langen Interaktionen konsistent bleibt und umfangreiche Unterhaltungen effektiv verwaltet. Das ist besonders nützlich für Anwendungen, die detaillierte, fortlaufende Dialoge erfordern, etwa spezialisierte Agenten und Chats.
- Wissensstand: Der Wissensstand von LLaMA 3.1 reicht bis Dezember 2023. Dadurch bezieht es die aktuellsten Informationen ein und liefert sehr nah am Thema liegende Antworten, was es besonders hilfreich für Nutzer macht, die aktuelle Daten suchen.
- Multimodale Fähigkeiten: Das Modell kann Inhalte in mehreren Formaten verarbeiten und erzeugen, darunter Text, Bilder und Audio.
- Nutzer können erzeugen:
- Text: Artikel, Berichte und Marketingtexte, die sich für Blogs, Newsletter und soziale Medien nutzen lassen.
- Bilder: Visuelle Inhalte auf Basis beschreibender Texte.
- Audio: Voiceovers und Klanglandschaften für Multimedia-Präsentationen, etwa Videos und interaktive Inhalte.
- Video: Kurze Videoclips oder Animationen, die Text und Bild fürs Storytelling kombinieren.
- Nutzer können erzeugen:
Unternehmenshintergrund
Meta, die Muttergesellschaft von Facebook, zählt seit Jahren zu den Vorreitern der KI-Forschung und -Entwicklung. Das Unternehmen startete 2004 und konzentrierte sich später auf Machine-Learning-Verfahren, um seine Social-Media-Plattformen zu verbessern.
Eines der frühesten Beispiele dafür war die Einführung des News-Feed-Algorithmus im Jahr 2006, der mithilfe von Machine Learning Inhalte anhand der Interaktionen der Nutzer personalisierte.
Im Laufe der Jahre hat Meta kontinuierlich weiterentwickelt und mehrere KI-gestützte Funktionen auf seinen Plattformen eingeführt, darunter die Gesichtserkennungstechnologie im Jahr 2010 und die automatische Übersetzungsfunktion im Jahr 2015, die mit neuronaler maschineller Übersetzung die Kommunikation über Sprachgrenzen hinweg verbesserte.
2018 machte Meta mit der Einführung von PyTorch große Fortschritte, einer Open-Source-Bibliothek für maschinelles Lernen, die heute ein Eckpfeiler der KI-Forschung und -Entwicklung ist.
Diese Bibliothek erleichterte die Entwicklung zahlreicher KI-Modelle und Anwendungen, darunter solche für Computer Vision und die Verarbeitung natürlicher Sprache.
Bis 2020 hatte sich Meta als wichtiger Akteur im KI-Bereich etabliert und sich auf die Entwicklung verantwortungsvoller KI-Systeme konzentriert. Die Einführung der LLaMA-Reihe überrascht daher nicht: Sie ist Teil einer umfassenderen Strategie, mit anderen Akteuren an der Spitze fortschrittlicher KI-Technologien zu bleiben.
LLaMA ist bemerkenswerterweise ein Open-Source-Modell, und Meta möchte damit die Zusammenarbeit zwischen Entwicklern und Forschern fördern. Da alle Zugang zu den Ressourcen haben, begünstigt das Innovation und schnellen Fortschritt in der KI.
Diese Initiative passt zur Vision von CEO Mark Zuckerberg, ein offeneres und inklusiveres KI-Ökosystem zu schaffen, ähnlich dem Einfluss von Linux auf Betriebssysteme.
Fähigkeiten von LLaMA 3.1
LLaMA 3.1 verschiebt die Grenzen des Möglichen in der Verarbeitung und Erzeugung natürlicher Sprache. Seine fortschrittlichen Fähigkeiten machen es zu einem vielseitigen Werkzeug für ein breites Anwendungsspektrum:
- Unerreichtes Sprachverständnis: LLaMA 3.1 versteht komplexe und mehrdeutige Sprache besonders gut, dank des umfangreichen Trainings auf einem vielfältigen Textkorpus. Das Modell erfasst schnell nuancierte Bedeutungen, erkennt den Kontext und kommt mit Redewendungen und Umgangssprache zurecht, was natürlichere, menschenähnlichere Gespräche ermöglicht.
- Mehrsprachigkeit: LLaMA 3.1 unterstützt acht Sprachen, darunter Englisch, Deutsch, Französisch, Italienisch, Portugiesisch, Hindi, Spanisch und Thailändisch, sowie weitere, die noch nicht offiziell angekündigt wurden. Dank dieser Mehrsprachigkeit können Nutzer mit unterschiedlichem sprachlichen Hintergrund problemlos mit dem Modell interagieren.
- Schlussfolgern und logisches Denken: LLaMA 3.1 geht über oberflächliches Verständnis hinaus und ist auf tiefergehendes Reasoning ausgelegt. Das Modell kann Schlussfolgerungen ziehen, logische Zusammenhänge herstellen und gut begründete Antworten auf komplexe Fragen liefern. Das ist besonders wertvoll für Anwendungen, die analytisches Denken erfordern, etwa Forschung, Entscheidungsfindung und Problemlösung.
- Multimodale Integration: Während sich viele Sprachmodelle ausschließlich auf Text konzentrieren, ist LLaMA 3.1 für multimodale Eingaben wie Bilder und Audio ausgelegt. Das Modell kann Inhalte in diesen Formaten verarbeiten und erzeugen und versteht und beantwortet multimediale Informationen zuverlässig.
- Anpassungsfähigkeit und Individualisierung: Eine der größten Stärken von LLaMA 3.1 ist seine Flexibilität und Anpassungsfähigkeit. Das Modell lässt sich auf bestimmte Datensätze oder Aufgaben feinabstimmen und kann sich so auf Bereiche wie Gesundheitswesen, Finanzen oder Bildung spezialisieren. Dank dieser Anpassbarkeit können Entwickler LLaMA 3.1 auf ihre individuellen Bedürfnisse zuschneiden und hochspezialisierte KI-Anwendungen entwickeln.
- Ethische und verantwortungsvolle KI: Meta hat großen Wert darauf gelegt, LLaMA 3.1 als ethisches und verantwortungsvolles KI-Modell zu entwickeln. Das Modell enthält Sicherheitsmaßnahmen, die schädliche oder verzerrte Inhalte verhindern, und ist darauf ausgelegt, die Privatsphäre und Datensicherheit der Nutzer zu respektieren. Organisationen und Einzelpersonen, denen ethisches Handeln wichtig ist, finden das sehr hilfreich, um ihren eigenen Grundsätzen treu zu bleiben.
- Skalierbarkeit und Leistung: LLaMA 3.1 ist für große Anwendungen und die Verarbeitung großer Datenmengen ausgelegt. Die effiziente Architektur und der optimierte Trainingsprozess des Modells ermöglichen schnelle und präzise Antworten, selbst bei riesigen Informationsmengen.
- Offener Zugang als Open Source: Mit der Veröffentlichung von LLaMA 3.1 als Open-Source-Modell will Meta den Zugang zu fortschrittlicher KI-Technologie demokratisieren. So können Entwickler und Forscher weltweit mit LLaMA 3.1 experimentieren, es verbessern und darauf aufbauend innovative Anwendungen entwickeln. Dieser Open-Source-Ansatz macht LLaMA 3.1 für ein breites Publikum zugänglich.
Geschichte der LLaMA-Modellfamilie
LLaMA 3.1 ist Teil einer Modellreihe, die mit LLaMA 1.0 begann. Jede Version brachte Verbesserungen bei Leistung, Sicherheit und Benutzerfreundlichkeit:
- LLaMA 1.0: Das erste Modell erschien am 24. Februar 2023 und legte den Schwerpunkt auf eine solide Grundlage für die Verarbeitung und das Verständnis natürlicher Sprache, die den Weg für künftige Weiterentwicklungen bereitete.
- LLaMA 2.0: Diese Version erschien am 18. Juli 2023. Sie brachte verbesserte Texterstellung und ein besseres Sprachverständnis, erzielte höhere Genauigkeit in mehreren Benchmarks und unterstützte mehr Sprachen.
- LLaMA 3.0: Dieses Modell erschien Anfang 2024. Es markierte einen deutlichen Leistungssprung, besonders bei Reasoning-Aufgaben und beim Programmieren. Es verarbeitete Kontext besser und wurde mit einem vielfältigeren Datensatz trainiert.
- LLaMA 3.1: Die neueste Version, LLaMA 3.1, baut auf ihren Vorgängern auf und bietet bessere Leistung, mehr unterstützte Sprachen und verbesserte Sicherheitsmaßnahmen. Sie wurde an verschiedenen Benchmarks getestet, darunter dem Massive Multitask Language Understanding (MMLU)-Test, bei dem sie in allgemeinem Wissen über mehrere Fachgebiete hinweg Werte von über 85 % erreichte.
Anwendungsfälle für LLaMA 3.1
LLaMA 3.1 ist ein vielseitiges KI-Modell, das sich in verschiedenen Bereichen einsetzen lässt und seine Anpassungsfähigkeit und Leistungsstärke in der Praxis unter Beweis stellt. Im Folgenden einige zentrale Anwendungsfälle, die die Fähigkeiten des Modells zeigen:
- Content-Erstellung: LLaMA 3.1 erzeugt hochwertige Texte und ist damit ein unschätzbares Werkzeug für Autoren, Marketer und Content-Ersteller. Es kann Artikel, Berichte, Blogbeiträge und Marketingtexte verfassen und senkt so den Zeit- und Arbeitsaufwand für die Inhaltserstellung deutlich. Damit können Nutzer leicht einen einheitlichen Ton und Stil über alle Materialien hinweg beibehalten.
- Kreative Anwendungen: Mit der Bildgenerierung des Modells können Nutzer überzeugende Visuals auf Basis von Textbeschreibungen erstellen. Das ist besonders nützlich für Grafikdesigner, Werbetreibende und Künstler, die einzigartige Visuals für Kampagnen, soziale Medien oder andere kreative Projekte brauchen. Nutzer können damit auch ihr Storytelling mit reichhaltigen, ansprechenden Bildern aufwerten, die ihre Texte ergänzen.
- Bildung: LLaMA 3.1 lässt sich im Bildungsbereich einsetzen, um interaktive Lernmaterialien, Quizze und Präsentationen zu entwickeln. Lehrkräfte können personalisierte Lernerfahrungen schaffen, indem sie maßgeschneiderte Inhalte erzeugen, die auf die spezifischen Bedürfnisse ihrer Schüler eingehen.
- Kundensupport: Unternehmen können LLaMA 3.1 in ihre Kundenservice-Plattformen einbinden, um effizienten, personalisierten Support zu bieten. Dank seines Sprachverständnisses kann das Modell verschiedene Kundenanfragen bearbeiten, präzise Antworten liefern und Probleme schnell lösen. Unternehmen können Antworten auf häufige Fragen automatisieren, um die Kundenzufriedenheit zu steigern und menschlichen Mitarbeitern mehr Zeit für komplexere Aufgaben zu geben.
- Softwareentwicklung: LLaMA 3.1 ist, genau wie Claude, eine wertvolle Unterstützung für Entwickler, die ihre Arbeitsabläufe optimieren wollen. Das Modell hilft beim Schreiben, Debuggen und Optimieren von Code und erleichtert es Programmierern, Coding-Herausforderungen zu meistern. Es reduziert den Zeitaufwand für repetitive Aufgaben, sodass sich Entwickler auf strategischere Aspekte ihrer Projekte konzentrieren können.
- Globale Kommunikation: Durch seine mehrsprachigen Fähigkeiten erleichtert LLaMA 3.1 die Kommunikation über Kulturen und Sprachen hinweg. Das ist besonders wertvoll für international tätige Unternehmen, die mit Kunden und Partnern aus unterschiedlichen sprachlichen Hintergründen in Kontakt stehen.
- Mentale Gesundheit und Wohlbefinden: LLaMA 3.1 lässt sich in Anwendungen für mentale Gesundheit einsetzen. Es kann über Chatbots oder virtuelle Therapeuten Unterstützung bieten. Dabei kann es einfühlsame Antworten geben und Strategien zur Bewältigung von Stress, Angst oder anderen psychischen Herausforderungen vorschlagen.
- Forschung und Datenanalyse: Forscher können mit LLaMA 3.1 große Datensätze analysieren und daraus Erkenntnisse gewinnen. Das Modell hilft dabei, Forschungsergebnisse zusammenzufassen, Berichte zu entwerfen und sogar Hypothesen auf Basis vorhandener Literatur zu formulieren. Es ist ein wertvolles Werkzeug für Wissenschaftler und Fachleute aus verschiedenen Bereichen. Dabei gilt es zu beachten, dass das Modell derzeit nicht im Internet nach einer sofortigen Antwort suchen kann, sondern sich auf seine Trainingsdaten stützt.
Technische Daten
LLaMA 3.1 basiert auf einer leistungsstarken neuronalen Netzwerkarchitektur, die eine effiziente Verarbeitung und Erzeugung von Text ermöglicht. Zu den technischen Daten des Modells gehören:
Modellarchitektur: LLaMA 3.1 nutzt eine reine Decoder-Transformer-Architektur, die für den Umgang mit weitreichenden Abhängigkeiten und paralleler Verarbeitung bekannt ist. Diese Architektur erlaubt es dem Modell, Eingabedaten effizient zu verarbeiten und kohärente Ausgaben zu erzeugen.
- Transformer-Blöcke: Das Modell besteht aus mehreren Transformer-Blöcken, die jeweils Folgendes enthalten:
- Multi-Head-Attention-Mechanismus: Dadurch kann sich das Modell gleichzeitig auf verschiedene Teile des Eingabetexts konzentrieren und ein breites Spektrum an Kontextinformationen erfassen, die für das Verständnis komplexer Satzstrukturen und nuancierter Bedeutungen entscheidend sind.
- Feedforward-Netzwerk: Jeder Block enthält ein Feedforward-Netzwerk, das die Ausgabe des Attention-Mechanismus weiterverarbeitet. Das sorgt für Nichtlinearität und verbessert die Fähigkeit des Modells, komplexe Muster in den Daten zu erfassen.
- Positional Encoding: Um die Reihenfolge der Wörter in einer Sequenz zu erhalten, nutzt LLaMA 3.1 Positional Encoding, das jedem Token-Embedding je nach Position einen eigenen Vektor hinzufügt. Dadurch versteht das Modell die relative Position der Wörter, was für das Sprachverständnis entscheidend ist.
Anzahl der Parameter: LLaMA 3.1 verfügt über beeindruckende 405 Milliarden Parameter, die ein hochentwickeltes Sprachverständnis und entsprechende Textgenerierung ermöglichen.
Kontextfenster: Das Modell unterstützt ein Kontextfenster von 128.000 Token und bleibt dadurch auch bei langen Interaktionen konsistent.
Verarbeitungsgeschwindigkeit: LLaMA 3.1 ist auf hohe Verarbeitungsgeschwindigkeit optimiert und liefert auch bei komplexen Aufgaben zeitnahe, reaktionsschnelle Ausgaben. Die Architektur des Modells ist auf maximale Rechenleistung ausgelegt, sodass es schnell antwortet, was für Echtzeitanwendungen hilfreich ist.
Sicherheitsmaßnahmen: LLaMA 3.1 verwendet fortschrittliche Sicherheitsprotokolle, um die Erzeugung schädlicher oder verzerrter Inhalte zu verhindern. Zu den wichtigsten Sicherheitsfunktionen gehören:
- Content-Filterung: Das Modell nutzt ausgefeilte Filtertechniken, um unangemessene oder schädliche Inhalte während der Erzeugung zu erkennen und auszuschließen.
- Verzerrungen reduzieren: LLaMA 3.1 wurde trainiert, um Verzerrungen in den Trainingsdaten zu verringern und so faire, repräsentative Ausgaben zu gewährleisten.
Trainingsinfrastruktur: LLaMA-Modelle werden auf einem verteilten System aus Nvidia H100 GPUs trainiert, speziellen KI-Beschleunigern für die effiziente Bewältigung umfangreicher Machine-Learning-Aufgaben. Der Trainingsprozess umfasst:
- Pretraining und Fine-Tuning: LLaMA 3.1 durchläuft einen zweistufigen Trainingsprozess. Beim Pretraining wird das Modell mit einem riesigen Textkorpus trainiert und lernt dabei, das nächste Wort in einem Satz vorherzusagen. Beim Fine-Tuning wird das vortrainierte Modell mit kleineren, aufgabenspezifischen Datensätzen an bestimmte Aufgaben angepasst.
- Effiziente Trainingstechniken: Um die Trainingseffizienz zu steigern, nutzt LLaMA 3.1 Techniken wie Mixed-Precision-Training und Gradient-Checkpointing. Mixed-Precision-Training verwendet Arithmetik mit geringerer Genauigkeit, um Berechnungen zu beschleunigen und den Speicherbedarf zu senken, ohne die Genauigkeit zu beeinträchtigen. Gradient-Checkpointing spart Speicher, indem beim Forward-Pass nur bestimmte Aktivierungen gespeichert und beim Backward-Pass bei Bedarf neu berechnet werden.
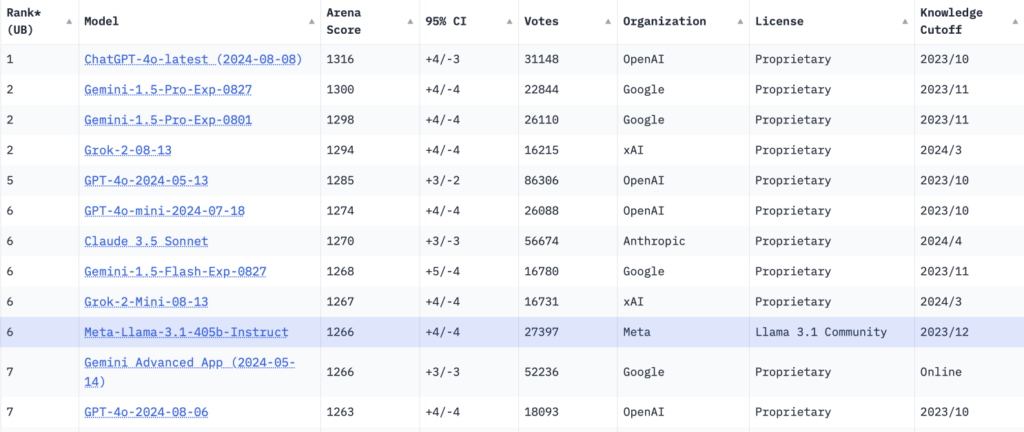
Leistungsbewertung: Die Leistung von LLaMA 3.1 wird mit verschiedenen Benchmarks für Sprachverständnis und -generierung gründlich geprüft. Das Modell übertrifft frühere und aktuelle Spitzenmodelle durchweg bei maschineller Übersetzung, Zusammenfassung und Frage-Antwort-Aufgaben. Umfangreiche menschliche Bewertungen zeigen, dass LLaMA 3.1 mit führenden Modellen wie GPT-4 und Claude 3.5 Sonnet konkurrieren kann und in vielen praktischen Szenarien Spitzenleistungen erbringt.
Vergleichende Analyse
Hier ist eine vergleichende Analyse von LLaMA gegenüber ChatGPT, Claude und Gemini.
LLaMA 3.1 vs. ChatGPT
- Modellgröße: LLaMA 3.1 hat 405 Milliarden Parameter, während ChatGPT (genauer GPT-4) rund 175 Milliarden Parameter hat. Trotz der geringeren Größe ist ChatGPT stark auf Konversation optimiert und liefert oft ausgefeiltere Dialoge.
- Leistung in Benchmarks: LLaMA 3.1 zeigt in verschiedenen Benchmarks beachtliche Leistungen und übertrifft ChatGPT oft bei bestimmten Aufgaben wie mathematischem Reasoning und Codegenerierung. ChatGPT glänzt dagegen bei flüssiger Konversation und dem Beibehalten von Kontext, besonders in informellen Situationen.
- Anpassbarkeit und Zugänglichkeit: LLaMA 3.1 ist Open Source, sodass Entwickler das Modell für bestimmte Anwendungen und Bereiche feinabstimmen können. ChatGPT ist dagegen proprietär, was die Anpassungsmöglichkeiten einschränkt, dafür aber eine benutzerfreundliche Oberfläche über Plattformen wie die API von OpenAI bietet.
- Offline-Nutzung: LLaMA 3.1 lässt sich offline betreiben und eignet sich daher für Anwendungen mit eingeschränkter Internetverbindung oder bei Bedenken zum Datenschutz. ChatGPT benötigt dagegen eine Internetverbindung, um auf die Server von OpenAI zuzugreifen.
LLaMA 3.1 vs. Claude AI
- Anzahl der Parameter: Die 405 Milliarden Parameter von LLaMA 3.1 übertreffen die 175 Milliarden Parameter von Claude 3.5 Sonnet deutlich. Durch diese größere Größe kann LLaMA komplexere Anfragen verarbeiten und inhaltsreichere Texte erzeugen.
- Kontextfenster: Beide Modelle unterstützen große Kontextfenster, LLaMA 3.1 bietet 128.000 Token. Claude 3.5 Sonnet kommt auf ein ähnliches Kontextfenster, ist aber besonders darauf optimiert, den Gesprächskontext über lange Interaktionen zu erhalten, was es für dialogintensive Anwendungen effektiver macht.
- Multimodale Fähigkeiten: Beide Modelle unterstützen multimodale Interaktionen, doch Claude AI verfügt über fortschrittliches visuelles Reasoning und kann Bilder effektiver interpretieren und erzeugen als LLaMA 3.1.
- Leistung bei Coding-Aufgaben: Bei der Unterstützung beim Programmieren erzeugt LLaMA 3.1 nachweislich präzise, funktionierende Code-Snippets. Claude 3.5 Sonnet gilt jedoch als überlegen bei komplexen Coding-Herausforderungen und Debugging-Aufgaben, weshalb es bei Softwareentwicklern oft die erste Wahl ist.
LLaMA 3.1 vs. Gemini 1.5 Pro
- Modellgröße: Mit 405 Milliarden Parametern gehört LLaMA 3.1 zu den größten Sprachmodellen, verglichen mit Gemini 1.5 Pro, das über 200 Milliarden Parameter hat. Dieser Größenvorteil erlaubt es LLaMA, komplexere Sprachaufgaben zu bewältigen.
- Kontextfenster: Beide Modelle bieten ein Kontextfenster von 128.000 Token und bleiben dadurch auch bei langen Interaktionen konsistent. Diese Gemeinsamkeit ermöglicht den effektiven Umgang mit langen Unterhaltungen und komplexen Anfragen.
- Multimodale Interaktion: Gemini 1.5 Pro glänzt bei multimodalen Fähigkeiten, besonders bei der Bildgenerierung aus Textbeschreibungen. LLaMA 3.1 kann zwar ebenfalls Bilder erzeugen, aber in begrenzterem Umfang als die fortschrittlichen Funktionen von Gemini.
- Praktische Anwendungen: Gemini 1.5 Pro wurde in verschiedene Google-Produkte integriert und erweitert deren Funktionen mit KI-gestützten Features. LLaMA 3.1 erlaubt dagegen durch seine Open-Source-Natur mehr Experimentierfreude und Anpassung durch Entwickler und fördert so Innovation in vielfältigen Anwendungen.
Zusammenfassung der Vergleiche
Zusammenfassend lässt sich sagen: LLaMA 3.1 überzeugt durch seine große Parameterzahl und die offene Zugänglichkeit als Open Source, steht aber in mehreren Bereichen in Konkurrenz zu ChatGPT, Claude AI und Gemini 1.5 Pro:
- ChatGPT glänzt bei flüssiger Konversation und Benutzerfreundlichkeit, bietet aber nicht die Anpassungsmöglichkeiten von LLaMA.
- Claude AI bietet fortschrittliches visuelles Reasoning und Unterstützung beim Programmieren, arbeitet aber in einem proprietären Rahmen.
- Gemini 1.5 Pro bietet starke multimodale Fähigkeiten und Integration mit Google-Diensten, während das Open-Source-Modell von LLaMA 3.1 Innovation durch die Community fördert.
Letztlich hängt die Wahl zwischen diesen Modellen von den konkreten Anwendungsfällen, den gewünschten Funktionen und dem Grad der Anpassung ab, den Entwickler, Nutzer und Organisationen brauchen.
Zukunftsaussichten
Die Zukunft von LLaMA AI sieht vielversprechend aus, mit laufenden Weiterentwicklungen, die seine Fähigkeiten weiter verbessern sollen. Künftige Versionen wie LLaMA 4.0 sollen noch fortschrittlichere Funktionen mitbringen, etwa verbessertes multimodales Reasoning, erweiterte Speicherfähigkeiten und mehr unterstützte Sprachen.
FAQ
Was kann LLaMA AI? LLaMA 3.1 kann Text, Bilder, Audio und Video erzeugen. Es ist ein vielseitiges Werkzeug für verschiedene Anwendungen, etwa Content-Erstellung, Unterstützung beim Programmieren und Kundensupport.
Wer steckt hinter Meta AI LLaMA 3.1? / Wem gehört LLaMA 3.1? LLaMA 3.1 wird von Meta entwickelt und gehört Meta, der Muttergesellschaft von Facebook.
Wann erscheint LLaMA 4.0? Meta hat noch kein konkretes Erscheinungsdatum für LLaMA 4.0 genannt, es wird aber noch in diesem Jahr oder Anfang nächsten Jahres erwartet. Es soll auf dem Erfolg von LLaMA 3.1 aufbauen und noch fortschrittlichere Funktionen und Fähigkeiten mitbringen.
Wie lädt man LLaMA AI herunter? LLaMA 3.1 steht zum direkten Download bereit, und Nutzer können auch über das Web darauf zugreifen, das eine Oberfläche zur Interaktion mit dem Modell bietet.
Wo lässt sich LLaMA AI nutzen? Nutzer können LLaMA 3.1 auf Plattformen wie Fello AI verwenden, die einfachen Zugang zu den Fähigkeiten des Modells bieten, ganz ohne aufwendige Einrichtung oder technisches Wissen.