La série LLaMA de Meta continue de s'améliorer, notamment avec LLaMA 3.1, la dernière version de son grand modèle de langage.
LLaMA 3.1 (Large Language Model Meta AI 3.1) apporte des capacités améliorées et quasi magiques, avec un nombre impressionnant de 405 milliards de paramètres. Il offre aussi de meilleures performances en traitement du langage naturel et dans les tâches multimodales.
Le marché de l'intelligence artificielle croît de plus en plus vite, et la valeur du secteur devrait être multipliée par plus de 13 au cours des six prochaines années. Les personnes qui n'adoptent pas ces outils ou ne les apprennent pas dès maintenant risquent de se retrouver à la traîne.
Ce guide complet explore les fonctionnalités, l'histoire, les applications et les perspectives d'avenir de LLaMA 3.1, et le compare aux autres modèles d'IA de référence sur le marché. Profitez du trajet, car à la fin de cet article, vous aurez toutes les connaissances de base sur ce modèle, ce qu'il représente, et comment il peut vous être utile.
Présentation de LLaMA 3.1
LLaMA 3.1 est un modèle d'IA générative open source de pointe développé par Meta. Il est conçu pour exceller dans un large éventail de tâches, notamment la génération de texte, la reconnaissance d'images et l'assistance au code.
Ce modèle est conçu pour être multimodal, ce qui signifie qu'il peut traiter et générer du contenu de façon fluide dans différents formats, notamment le texte, les images, l'audio et la vidéo.
Le modèle dispose d'une large fenêtre de contexte et d'une date de connaissances fixée à décembre 2023. Il peut ainsi fournir des réponses précises et pertinentes, ce qui en fait un outil puissant pour de nombreux cas d'usage.
Spécifications clés
- Taille du modèle : LLaMA 3.1 affiche un nombre de paramètres considérable, plus de 405 milliards, ce qui en fait l'un des plus grands modèles de langage disponibles. Cette taille importante lui permet de capter des structures linguistiques complexes et de générer un texte nuancé bien plus facilement que d'autres modèles.
- Fenêtre de contexte : le modèle prend en charge une fenêtre de contexte de 128 000 tokens, ce qui lui permet de rester cohérent sur des échanges longs et de gérer efficacement des conversations étendues. C'est particulièrement utile pour les applications qui demandent un dialogue détaillé et continu, comme les agents spécialisés et les chats.
- Date de connaissances : la date de connaissances de LLaMA 3.1 est décembre 2023. Cela garantit qu'il intègre les informations les plus récentes et fournit des réponses très pertinentes, ce qui le rend particulièrement utile pour les utilisateurs en quête de données actuelles.
- Fonctionnalités multimodales : le modèle peut traiter et générer du contenu dans plusieurs formats, notamment le texte, les images et l'audio.
- Les utilisateurs peuvent générer :
- Texte : des articles, des rapports et des textes marketing utilisables dans des blogs, des newsletters et sur les réseaux sociaux.
- Images : du contenu visuel à partir d'une description textuelle.
- Audio : des voix off et des ambiances sonores pour des présentations multimédias, comme des vidéos et du contenu interactif.
- Vidéo : de courts clips vidéo ou des animations qui combinent texte et visuels pour raconter une histoire.
- Les utilisateurs peuvent générer :
Historique de l'entreprise
Meta, la société mère de Facebook, est à l'avant-garde de la recherche et du développement en IA depuis des années. L'entreprise a démarré son parcours avec son lancement en 2004, puis s'est tournée vers les techniques d'apprentissage automatique pour améliorer ses plateformes sociales.
L'un des premiers exemples en est l'introduction de l'algorithme du fil d'actualité en 2006, qui s'appuyait sur l'apprentissage automatique pour personnaliser le contenu affiché aux utilisateurs selon leurs interactions.
Au fil des années, Meta a continué d'innover en lançant plusieurs fonctionnalités basées sur l'IA sur ses plateformes, notamment la technologie de reconnaissance faciale en 2010 et la fonctionnalité de traduction automatique en 2015, qui s'appuyait sur la traduction automatique neuronale pour améliorer la communication entre les langues.
En 2018, Meta a fait des progrès notables avec l'introduction de PyTorch, une bibliothèque d'apprentissage automatique open source devenue aujourd'hui un pilier de la recherche et du développement en IA.
Cette bibliothèque a facilité le développement de nombreux modèles et applications d'IA, y compris ceux utilisés en vision par ordinateur et en traitement du langage naturel.
En 2020, Meta s'est imposée comme un acteur clé de l'IA, en se concentrant sur la création de systèmes d'IA responsables. L'introduction de la série LLaMA n'a rien de surprenant ; elle s'inscrit dans une stratégie plus large visant à rester à la pointe face aux autres acteurs des technologies d'IA avancées.
LLaMA est en particulier un modèle open source, et Meta cherche à favoriser la collaboration entre développeurs et chercheurs. Comme chacun a accès aux ressources, cela encouragera l'innovation et des avancées rapides en IA.
Cette initiative s'inscrit dans la vision du PDG Mark Zuckerberg : créer un écosystème d'IA plus ouvert et plus inclusif, à l'image de l'impact de Linux sur les systèmes d'exploitation.
Capacités de LLaMA 3.1
LLaMA 3.1 repousse les limites du possible en traitement et génération du langage naturel. Ses capacités avancées en font un outil polyvalent pour un large éventail d'applications :
- Compréhension linguistique inégalée : LLaMA 3.1 excelle dans la compréhension d'un langage complexe et ambigu, grâce à son entraînement poussé sur un corpus varié de données textuelles. Le modèle saisit rapidement les nuances de sens, détecte le contexte et gère les idiomes et les expressions familières, ce qui lui permet d'engager des conversations plus naturelles et proches de celles d'un humain.
- Maîtrise multilingue : LLaMA 3.1 prend en charge huit langues, dont l'anglais, l'allemand, le français, l'italien, le portugais, l'hindi, l'espagnol et le thaï, et probablement d'autres encore non officiellement annoncées. Cette capacité multilingue permet à des utilisateurs d'horizons linguistiques variés d'interagir avec le modèle sans difficulté.
- Raisonnement et inférence : LLaMA 3.1 est conçu pour aller au-delà d'une compréhension superficielle et pour raisonner en profondeur. Le modèle peut tirer des inférences, établir des liens logiques et fournir des réponses bien argumentées à des questions complexes. Cette capacité est précieuse pour les applications qui demandent une réflexion analytique, comme la recherche, la prise de décision et la résolution de problèmes.
- Intégration multimodale : alors que de nombreux modèles de langage se limitent au texte, LLaMA 3.1 est conçu pour traiter des entrées multimodales, y compris des images et de l'audio. Le modèle peut traiter et générer du contenu dans ces formats, et comprendre et répondre efficacement à des informations multimédias.
- Adaptabilité et personnalisation : l'un des grands atouts de LLaMA 3.1 est sa flexibilité et sa capacité d'adaptation. Le modèle peut être affiné sur des jeux de données ou des tâches spécifiques, ce qui lui permet de se spécialiser dans des domaines comme la santé, la finance ou l'éducation. Cette personnalisation permet aux développeurs d'adapter LLaMA 3.1 à leurs besoins propres et de créer des applications d'IA hautement spécialisées.
- IA éthique et responsable : Meta a particulièrement insisté sur le développement de LLaMA 3.1 comme modèle d'IA éthique et responsable. Le modèle intègre des mesures de sécurité pour empêcher la génération de contenu nuisible ou biaisé, et il est conçu pour respecter la vie privée des utilisateurs et la sécurité des données. Les organisations et les personnes qui privilégient des pratiques éthiques trouvent cela précieux pour rester fidèles à leurs valeurs.
- Évolutivité et performance : LLaMA 3.1 est conçu pour gérer des applications à grande échelle et des volumes importants de données. L'architecture efficace du modèle et son processus d'entraînement optimisé lui permettent de fournir des réponses rapides et précises, même face à d'énormes quantités d'informations.
- Accessibilité open source : en publiant LLaMA 3.1 comme modèle open source, Meta cherche à démocratiser l'accès aux technologies d'IA avancées. Cela permet aux développeurs et aux chercheurs du monde entier d'expérimenter avec LLaMA 3.1, de l'améliorer et de créer des applications innovantes à partir de lui. Cette approche open source garantit que LLaMA 3.1 reste accessible à un large public.
Histoire de la famille de modèles LLaMA
LLaMA 3.1 s'inscrit dans une lignée de modèles qui a débuté avec LLaMA 1.0. Chaque itération a apporté des améliorations en matière de performance, de sécurité et de facilité d'utilisation :
- LLaMA 1.0 : le modèle initial, lancé le 24 février 2023, visait à établir une base solide pour le traitement et la compréhension du langage naturel, ouvrant la voie aux avancées futures.
- LLaMA 2.0 : cette version est sortie le 18 juillet 2023. Elle a introduit des capacités améliorées de génération de texte et de compréhension du langage, obtenu une précision plus élevée sur divers benchmarks, et étendu l'éventail des langues prises en charge.
- LLaMA 3.0 : cette version est sortie début 2024. Elle a marqué un bond important en performance, en particulier pour les tâches de raisonnement et les capacités de programmation. Elle offrait une meilleure gestion du contexte et avait été entraînée sur un jeu de données plus varié.
- LLaMA 3.1 : la dernière itération, LLaMA 3.1, s'appuie sur ses prédécesseurs en offrant de meilleures performances, un support linguistique étendu et des mesures de sécurité renforcées. Il a été testé sur divers benchmarks, dont le test Massive Multitask Language Understanding (MMLU), où il a obtenu des scores dépassant 85 % en culture générale sur plusieurs sujets.
Cas d'usage de LLaMA 3.1
LLaMA 3.1 est un modèle d'IA polyvalent qui s'applique à de nombreux domaines, démontrant son adaptabilité et sa puissance dans des usages réels. Voici quelques cas d'usage clés qui illustrent les capacités du modèle :
- Création de contenu : LLaMA 3.1 génère du contenu écrit de haute qualité, ce qui en fait un atout précieux pour les rédacteurs, les marketeurs et les créateurs de contenu. Il peut produire des articles, des rapports, des billets de blog et des textes marketing, réduisant nettement le temps et les efforts nécessaires à la production de contenu. Il permet aussi de conserver facilement une voix et un style cohérents sur l'ensemble des supports.
- Applications créatives : les capacités de génération d'images du modèle permettent de créer des visuels percutants à partir de descriptions textuelles. Cette fonctionnalité est particulièrement utile pour les graphistes, les publicitaires et les artistes qui doivent produire des visuels originaux pour des campagnes, les réseaux sociaux ou d'autres projets créatifs. Elle permet aussi d'enrichir une narration grâce à des images riches et captivantes qui complètent le contenu écrit.
- Éducation : LLaMA 3.1 peut être utilisé en contexte pédagogique pour créer du matériel d'apprentissage interactif, des quiz et des présentations. Les enseignants peuvent proposer des expériences d'apprentissage personnalisées en générant du contenu adapté aux besoins spécifiques de leurs élèves.
- Support client : les entreprises peuvent intégrer LLaMA 3.1 à leurs plateformes de service client pour offrir une assistance efficace et personnalisée. Les capacités de compréhension du langage naturel du modèle lui permettent de traiter diverses demandes clients, de fournir des réponses précises et de résoudre les problèmes rapidement. Les entreprises peuvent automatiser les réponses aux questions fréquentes pour améliorer la satisfaction client et libérer les agents humains pour des tâches plus complexes.
- Développement logiciel : LLaMA 3.1 est une ressource précieuse pour les développeurs qui veulent simplifier leurs workflows, tout comme Claude. Le modèle peut aider à écrire, déboguer et optimiser du code, ce qui facilite la résolution des défis de programmation. Il permet de réduire le temps passé sur les tâches répétitives, afin que les développeurs se concentrent sur les aspects les plus stratégiques de leurs projets.
- Communication internationale : grâce à ses capacités de traitement multilingue, LLaMA 3.1 facilite la communication entre cultures et langues différentes. Cette fonctionnalité est particulièrement utile pour les entreprises internationales qui doivent échanger avec des clients et des partenaires d'horizons linguistiques variés.
- Santé mentale et bien-être : LLaMA 3.1 peut être utilisé dans des applications liées à la santé mentale. Il peut apporter un soutien via des chatbots ou des thérapeutes virtuels. Il peut générer des réponses empathiques et proposer des stratégies pour aider les utilisateurs à gérer le stress, l'anxiété ou d'autres difficultés psychologiques.
- Recherche et analyse de données : les chercheurs peuvent s'appuyer sur LLaMA 3.1 pour analyser de grands jeux de données et en tirer des enseignements. Le modèle peut aider à résumer des résultats de recherche, à rédiger des rapports, et même à formuler des hypothèses à partir de la littérature existante. C'est un outil précieux pour les universitaires et les professionnels de nombreux domaines. Il faut toutefois noter que le modèle ne peut pas, pour l'instant, parcourir Internet pour obtenir une réponse instantanée, et qu'il s'appuie plutôt sur ses données d'entraînement.
Spécifications techniques
LLaMA 3.1 repose sur une puissante architecture de réseau de neurones qui lui permet de traiter et de générer du texte efficacement. Voici ses principales spécifications techniques :
Architecture du modèle : LLaMA 3.1 utilise une architecture de transformeur à décodeur uniquement (decoder-only), reconnue pour sa capacité à gérer les dépendances à longue portée et le traitement parallèle. Cette architecture permet au modèle de traiter les données d'entrée et de générer des sorties cohérentes de façon efficace.
- Blocs de transformeur : le modèle se compose de plusieurs blocs de transformeur, chacun contenant :
- Mécanisme d'attention multi-têtes : cela permet au modèle de se concentrer simultanément sur différentes parties du texte d'entrée, en captant un large éventail d'informations contextuelles essentielles pour comprendre des structures de phrases complexes et des nuances de sens.
- Réseau de neurones à propagation avant : chaque bloc comprend un réseau à propagation avant qui transforme la sortie du mécanisme d'attention. Cela introduit de la non-linéarité et renforce la capacité du modèle à capter des structures complexes dans les données.
- Encodage positionnel : pour conserver l'ordre des mots dans une séquence, LLaMA 3.1 utilise un encodage positionnel, qui ajoute des vecteurs uniques à l'embedding de chaque token selon sa position. Cela permet au modèle de comprendre la position relative des mots, un élément essentiel pour la compréhension du langage.
Nombre de paramètres : LLaMA 3.1 affiche un impressionnant total de 405 milliards de paramètres, ce qui lui permet d'atteindre un niveau sophistiqué de compréhension et de génération du langage.
Fenêtre de contexte : le modèle prend en charge une fenêtre de contexte de 128 000 tokens, ce qui lui permet de rester cohérent sur des échanges longs.
Vitesse de traitement : LLaMA 3.1 est optimisé pour un traitement rapide, garantissant des réponses ponctuelles et réactives même pour des tâches complexes. Son architecture est conçue pour maximiser l'efficacité de calcul, ce qui lui permet de générer des réponses rapidement, un atout pour les applications en temps réel.
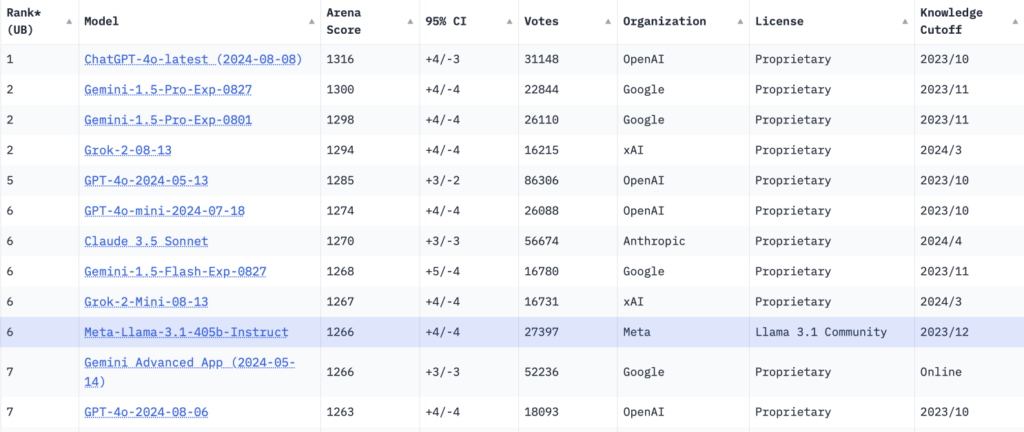
Mesures de sécurité : LLaMA 3.1 intègre des protocoles de sécurité avancés pour éviter de générer du contenu nuisible ou biaisé. Voici les principales fonctionnalités de sécurité :
- Filtrage de contenu : le modèle utilise des techniques de filtrage sophistiquées pour détecter et exclure le contenu inapproprié ou nuisible pendant la génération.
- Techniques de réduction des biais : LLaMA 3.1 a été entraîné pour réduire les biais présents dans les données d'entraînement, afin de garantir des résultats justes et représentatifs.
Infrastructure d'entraînement : les modèles LLaMA sont entraînés sur un système distribué de GPU Nvidia H100, des accélérateurs d'IA spécialisés conçus pour traiter efficacement des tâches d'apprentissage automatique intensives. Le processus d'entraînement comprend :
- Pré-entraînement et affinage : LLaMA 3.1 suit un processus d'entraînement en deux étapes. Pendant le pré-entraînement, le modèle est exposé à un corpus massif de données textuelles et apprend à prédire le mot suivant dans une phrase. L'affinage consiste à adapter le modèle pré-entraîné à des tâches spécifiques à l'aide de jeux de données plus restreints et ciblés.
- Techniques d'entraînement efficaces : pour optimiser l'efficacité de l'entraînement, LLaMA 3.1 utilise des techniques comme l'entraînement en précision mixte et le gradient checkpointing. L'entraînement en précision mixte utilise une arithmétique de précision réduite pour accélérer les calculs et réduire l'utilisation de la mémoire sans sacrifier la précision des résultats. Le gradient checkpointing économise de la mémoire en ne conservant que certaines activations pendant la passe avant, puis en les recalculant pendant la passe arrière si besoin.
Évaluation des performances : les performances de LLaMA 3.1 sont rigoureusement évaluées à l'aide de divers benchmarks qui testent ses capacités de compréhension et de génération du langage. Le modèle surpasse régulièrement les versions précédentes et les modèles de pointe sur les tâches de traduction automatique, de synthèse et de réponse aux questions. De vastes évaluations humaines montrent que LLaMA 3.1 rivalise avec des modèles de référence comme GPT-4 et Claude 3.5 Sonnet, démontrant ses capacités de pointe dans de nombreux scénarios concrets.
Analyse comparative
Voici une analyse comparative de LLaMA face à ChatGPT, Claude et Gemini.
LLaMA 3.1 vs ChatGPT
- Taille du modèle : LLaMA 3.1 affiche 405 milliards de paramètres, contre environ 175 milliards pour ChatGPT (plus précisément GPT-4). Malgré sa taille plus modeste, ChatGPT est très optimisé pour les tâches conversationnelles et propose souvent un dialogue plus sophistiqué.
- Performances sur les benchmarks : LLaMA 3.1 affiche des performances remarquables sur divers benchmarks, surpassant souvent ChatGPT sur des tâches spécifiques comme le raisonnement mathématique et la génération de code. ChatGPT, en revanche, excelle en fluidité conversationnelle et en rétention du contexte, en particulier dans des contextes informels.
- Personnalisation et accessibilité : LLaMA 3.1 est open source, ce qui permet aux développeurs d'affiner le modèle pour des applications et des domaines spécifiques. ChatGPT, à l'inverse, est propriétaire, ce qui limite les options de personnalisation mais offre une interface simple d'utilisation via des plateformes comme l'API d'OpenAI.
- Utilisation hors ligne : LLaMA 3.1 peut être déployé hors ligne, ce qui le rend adapté aux applications avec une connectivité internet limitée ou des préoccupations de confidentialité des données. ChatGPT, en revanche, nécessite une connexion internet pour accéder aux serveurs d'OpenAI.
LLaMA 3.1 vs Claude AI
- Nombre de paramètres : les 405 milliards de paramètres de LLaMA 3.1 dépassent largement les 175 milliards de Claude 3.5 Sonnet. Cette taille plus importante permet à LLaMA de traiter des requêtes plus complexes et de générer un contenu plus riche.
- Fenêtre de contexte : les deux modèles prennent en charge de larges fenêtres de contexte, LLaMA 3.1 allant jusqu'à 128 000 tokens. Claude 3.5 Sonnet gère une fenêtre de contexte similaire, mais il est particulièrement optimisé pour conserver le contexte conversationnel sur des échanges longs, ce qui le rend plus efficace pour les applications riches en dialogue.
- Capacités multimodales : les deux modèles prennent en charge des interactions multimodales, mais Claude AI dispose de capacités avancées de raisonnement visuel qui lui permettent d'interpréter et de générer des images plus efficacement que LLaMA 3.1.
- Performances en programmation : en matière d'assistance au code, LLaMA 3.1 a démontré une grande précision dans la génération d'extraits de code fonctionnels. Claude 3.5 Sonnet, cependant, se distingue par ses meilleures performances sur des défis de programmation complexes et des tâches de débogage, ce qui en fait un choix privilégié pour les ingénieurs logiciels.
LLaMA 3.1 vs Gemini 1.5 Pro
- Taille du modèle : avec ses 405 milliards de paramètres, LLaMA 3.1 est l'un des plus grands modèles de langage, comparé à Gemini 1.5 Pro, qui en compte plus de 200 milliards. Cet avantage de taille permet à LLaMA de traiter des tâches linguistiques plus complexes.
- Fenêtre de contexte : les deux modèles disposent d'une fenêtre de contexte de 128 000 tokens, ce qui leur permet de rester cohérents sur des échanges longs. Cette similarité permet de gérer efficacement des conversations étendues et des requêtes complexes.
- Interaction multimodale : Gemini 1.5 Pro excelle en capacités multimodales, en particulier pour générer des images à partir de descriptions textuelles. LLaMA 3.1 dispose bien de quelques capacités de génération d'images, mais elles restent plus limitées que les fonctionnalités avancées de Gemini.
- Applications concrètes : Gemini 1.5 Pro a été intégré à divers produits Google, enrichissant leurs fonctionnalités grâce à l'IA. À l'inverse, la nature open source de LLaMA 3.1 permet aux développeurs d'expérimenter et de personnaliser plus largement le modèle, favorisant l'innovation dans des applications variées.
Résumé des comparaisons
En résumé, si LLaMA 3.1 se distingue par son grand nombre de paramètres et son accessibilité open source, il doit faire face à la concurrence de ChatGPT, Claude AI et Gemini 1.5 Pro sur plusieurs aspects :
- ChatGPT excelle en fluidité conversationnelle et en facilité d'utilisation, mais lui manquent les options de personnalisation offertes par LLaMA.
- Claude AI propose un raisonnement visuel avancé et une assistance au code, mais fonctionne dans un cadre propriétaire.
- Gemini 1.5 Pro offre de solides capacités multimodales et une bonne intégration aux services Google, tandis que le modèle open source de LLaMA 3.1 encourage une innovation portée par la communauté.
En définitive, le choix entre ces modèles dépend des cas d'usage spécifiques, des fonctionnalités recherchées et du niveau de personnalisation nécessaire pour les développeurs, les utilisateurs et les organisations.
Perspectives d'avenir
L'avenir de LLaMA AI semble prometteur, avec des développements en cours visant à encore renforcer ses capacités. Les prochaines versions, comme LLaMA 4.0, devraient introduire des fonctionnalités encore plus avancées, telles qu'un raisonnement multimodal amélioré, des capacités de mémoire renforcées et un support linguistique élargi.
FAQ
Que peut faire LLaMA AI ? LLaMA 3.1 peut générer du texte, des images, de l'audio et de la vidéo. C'est un outil polyvalent pour de nombreuses applications, notamment la création de contenu, l'assistance au code et le support client.
Qui est derrière Meta AI LLaMA 3.1 ? / À qui appartient LLaMA 3.1 ? LLaMA 3.1 est développé et détenu par Meta, la société mère de Facebook.
Quand LLaMA 4.0 sortira-t-il ? Meta n'a pas encore annoncé de date de sortie précise pour LLaMA 4.0, mais son lancement est attendu plus tard cette année ou au début de l'année suivante. Il s'appuiera sur le succès de LLaMA 3.1 pour proposer des fonctionnalités et des capacités encore plus avancées.
Comment télécharger LLaMA AI ? LLaMA 3.1 est disponible en téléchargement direct, et les utilisateurs peuvent aussi y accéder sur le web, qui propose une interface pour interagir avec le modèle.
Où utiliser LLaMA AI ? Les utilisateurs peuvent exploiter LLaMA 3.1 sur des plateformes comme Fello AI, qui permet d'accéder facilement aux capacités du modèle sans configuration poussée ni connaissances techniques particulières.