Moonshot AI veröffentlichte die vollständigen Kimi K3-Gewichte am 27. Juli 2026, elf Tage nachdem das Modell in der Kimi-App live ging. Das Hugging-Face-Repository enthält 96 Safetensors-Shards mit insgesamt rund 1,56 TB. Mit 2,8 Billionen Gesamt-Parametern und 104 Milliarden aktiven Parametern pro Token ist K3 das größte je veröffentlichte open-source-Modell. Moonshot nennt es das weltweit erste offene 3T-Klasse-Modell, und hinter dieser Behauptung steckt nun ein Download-Button.
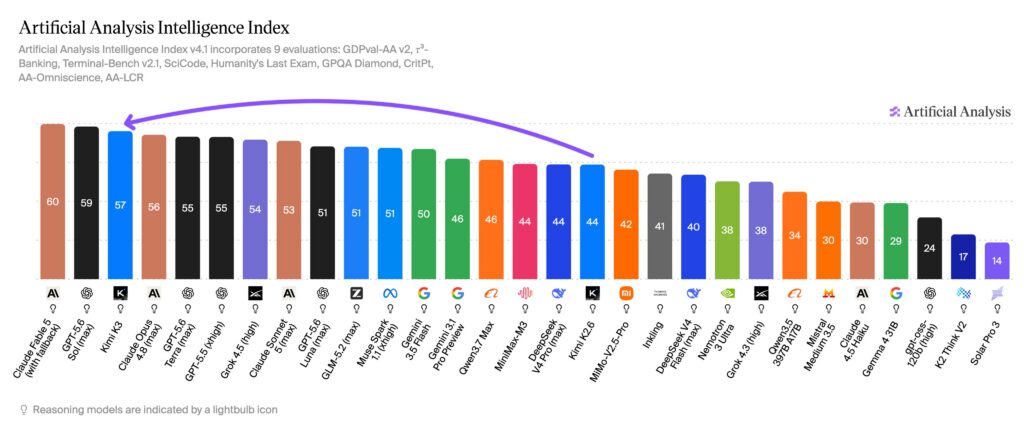
Das unabhängige Bild hat sich seit dem Launch deutlich verschoben, und nicht zugunsten von K3. Kimi K3 erzielt inzwischen 43,6 Punkte im Artificial-Analysis-Intelligence-Index v4.3.2, was es unter den open-weight-Modellen auf Platz drei statt auf Platz eins setzt, hinter Xiaomis MiMo-V2.6-Pro mit 46,3 und Z.ais GLM-5.3 mit 44,8. Die Boards, auf denen Menschen abstimmen, sagen das Gegenteil, und K3 führt dort das offene Feld weiterhin auf beiden an. Unten findest du die verifizierten Spezifikationen, was die Lizenz tatsächlich erlaubt, die offiziellen API-Preise und eine ehrliche Einschätzung, wie K3 im Vergleich zu Claude Opus 5.5 dasteht, das Opus 5 am 22. September 2026 als Anthropics Standardmodell abgelöst hat.
Das Wichtigste auf einen Blick
- Die offenen Gewichte erschienen am 27. Juli 2026, 96 Shards und rund 1,56 TB auf Hugging Face, unter einer eigenen Kimi-K3-Lizenz statt MIT.
- Ein Mixture-of-Experts-Design mit 2,8 Billionen Gesamt-Parametern, 104 Milliarden aktivierten pro Token und einem 1.048.576-Token-Kontextfenster.
- Akzeptiert Text-, Bild- und Video-Eingabe, schlussfolgert immer und bietet jetzt niedrige, hohe und maximale Reasoning-Intensität statt nur Maximum.
- Der offizielle API-Preis beträgt $3.00 pro Million Eingabe-Token und $15.00 Ausgabe, bei gecachter Eingabe fallend auf $0.30, wobei der Cache-Schreibvorgang selbst je nach Lebensdauer des Eintrags mit $3.00 oder $6.00 berechnet wird.
- Erzielt 43,6 Punkte im Artificial-Analysis-Intelligence-Index v4.3.2, Platz drei unter open-weight-Modellen hinter MiMo-V2.6-Pro mit 46,3 und GLM-5.3 mit 44,8, aber weiterhin das bestplatzierte offene Modell auf den Boards, auf denen Menschen abstimmen.
Was ist Kimi K3?
Kimi K3 ist Moonshot AIs Flaggschiff-Sprachmodell, gestartet am 16. Juli 2026 und als offene Gewichte am 27. Juli veröffentlicht. Es verwendet ein Mixture-of-Experts-Design mit 2,8 Billionen Gesamt-Parametern, von denen 104 Milliarden pro Token aktiviert werden, und liest ein 1-Million-Token-Kontextfenster. Moonshoots eigene Dokumentation bestätigt, dass es Text-, Bild- und Video-Eingabe akzeptiert.
Die Lücke zwischen Launch und Gewichten war geplant, und Moonshot hat das damals so gesagt. Der Launch-Post versprach die Dateien „bis zum 27. Juli 2026", während das Team „eng mit Inferenzpartnern und open-source-Betreuern zusammenarbeitet, um technische Details abzustimmen und ein zuverlässiges Rollout im gesamten Ökosystem sicherzustellen". Der technische Bericht erschien zusammen mit den Gewichten statt ihnen hinterher.
| Spezifikation | Kimi K3 |
|---|---|
| Entwickler | Moonshot AI |
| Veröffentlicht | 16. Juli 2026 (Gewichte 27. Juli 2026) |
| Architektur | Mixture-of-Experts (MoE) |
| Gesamt-Parameter | 2,8 Billionen |
| Aktivierte Parameter | 104 Milliarden pro Token |
| Schichten | 93 (69 Kimi Delta Attention, 24 Gated MLA) |
| Experten | 896 gesamt, 16 ausgewählt pro Token |
| Vision-Encoder | MoonViT-V2, 401M Parameter |
| Kontextfenster | 1.048.576 Token |
| Eingabetypen | Text, Bild, Video |
| Quantisierung | MXFP4-Gewichte, MXFP8-Aktivierungen |
| Reasoning-Kontrolle | reasoning_effort niedrig / hoch / max, Standard: max |
| Lizenz | Kimi K3 License (eigene Lizenz, kein MIT) |
Mit 2,8 Billionen Parametern ist Kimi K3 weiterhin das größte bislang veröffentlichte offene Modell, auch wenn der Abstand seit Juli geschrumpft ist: Alibabas Qwen3.8 2.4T A95B gibt 2,45 Billionen an, während der nächste Rivale früher DeepSeeks V4-Pro mit 1,6 Billionen war. Das Mixture-of-Experts-Design bedeutet, dass bei einem gegebenen Token nur ein kleiner Bruchteil dieser Parameter feuert, sodass die effektiven Rechenkosten weit unter dem bleiben, was die rohe Zahl nahelegt. 16 von 896 Experten zu aktivieren, ist ein ungewöhnlich hohes Sparsity-Verhältnis. Diese Entscheidung ist zentral dafür, wie Moonshot Frontier-Leistung aus der Architektur herausgeholt hat.
Kimi K3 offene Gewichte: Was tatsächlich erschienen ist
Das ist der Teil, der sich am 27. Juli änderte, und der Grund, warum K3 mehr bedeutet als sein Benchmark-Ergebnis. Jedes andere Modell auf diesem Fähigkeitsniveau ist eine API, die du mietest. K3 ist eine Datei, die du besitzen kannst.
Was im Repository steckt
Das Hugging-Face-Repo enthält 120 Dateien, davon 96 Safetensors-Shards, und der gesamte Download beläuft sich auf rund 1,56 TB. Moonshot liefert das Modell in nativen MXFP4-Gewichten mit MXFP8-Aktivierungen, die durch quantisierungsbewusstes Training ab der Supervised-Fine-Tuning-Phase angewendet wurden. Deshalb passt ein 2,8-Billionen-Parameter-Modell in 1,56 TB statt ein Vielfaches davon, und das bedeutet, du lädst keine verlustbehaftete Community-Quantisierung herunter, sondern das, was Moonshot trainiert hat.
Der Andrang kam sofort und hielt an. Einen Tag nach dem Hochladen zeigte das Repository rund 99.000 Downloads und mehr als 7.300 Likes, gezählt am 28. Juli 2026. Zum 24. September meldete Hugging Face 1,86 Millionen Downloads im zurückliegenden Monat und 11.500 Likes. Für einen Checkpoint, den fast niemand auf der eigenen Maschine hosten kann, ist das eine Menge Traffic, und ein Großteil davon dürfte auf Inferenz-Anbieter, Quantisierungsprojekte und Forschungslabore entfallen statt auf Einzelpersonen.
Moonshot nennt drei Inferenz-Engines als empfohlene Laufzeiten: vLLM, SGLang und TokenSpeed, jede mit eigenem veröffentlichten Rezept für K3. Der technische Bericht erschien zusammen mit den Gewichten, sodass die Architekturdetails ebenfalls öffentlich sind.
Die Kimi-K3-Lizenz ist kein MIT
Lies das, bevor du ein Produkt darauf aufbaust.
Die Lizenz gewährt die üblichen Rechte zur Nutzung, Kopierung, Modifikation, Verteilung, Unterlizenzierung, Feinabstimmung und zum Verkauf, was für die meisten Leser wie MIT klingt. Zwei Klauseln fügen dann Bedingungen hinzu, die MIT nicht hat. Tencent ging am 28. August 2026 den umgekehrten Weg und veröffentlichte die 770B-Gewichte von Hy4 Preview unter der schlichten Apache-2.0-Lizenz.
Die erste ist eine Umsatzschwelle beim Weiterverkauf. Wenn du ein Model-as-a-Service-Unternehmen betreibst und dein Umsatz in einem beliebigen Zeitraum von 12 aufeinanderfolgenden Monaten $20 Millionen überschreitet, musst du vor der kommerziellen Nutzung von K3 eine separate Vereinbarung mit Moonshot unterzeichnen. Die zweite ist eine Namensnennung. Jedes auf K3 aufgebaute Produkt mit mehr als 100 Millionen monatlich aktiven Nutzern oder mehr als $20 Millionen monatlichem Umsatz muss den Namen „Kimi K3" gut sichtbar in seiner Benutzeroberfläche anzeigen.
Beide Bedingungen entfallen bei rein interner Nutzung, also bei allem, was das Modell oder seine Ausgaben nie Dritten zugänglich macht. Für einen einzelnen Entwickler, ein Startup oder eine Forschungsgruppe ist der praktische Effekt gleich null. Für einen Hyperscaler, der Inferenz weiterverkauft, ist es eine Verhandlung. Dieser Tausch war früher das ganze Argument für K3, Spitzenleistung im Austausch gegen eine Lizenz, die man wirklich lesen muss. Heute ist das ein schwächeres Argument, denn im Artificial-Analysis-Index stehen zwei offene Modelle über K3, und eines davon, Xiaomis MiMo-V2.6-Pro, erscheint unter schlichtem MIT. Das andere ist Z.ais GLM-Reihe, wo das Flaggschiff GLM-5.3 eine eigene maßgeschneiderte Lizenz trägt und nur GLM 5.3 Flash MIT ist.
Was es braucht, um Kimi K3 selbst zu betreiben
Herunterladbar ist nicht dasselbe wie ausführbar. Ein 1,56-TB-Checkpoint braucht einen Multi-Node-GPU-Cluster, um bei vollem Kontext zu laufen, also ist „du kannst es selbst hosten" für Labs und ernsthafte Infrastruktur-Teams wahr, nicht für jemanden mit einer einzelnen Workstation. Wenn du ein open-source-Modell willst, das du wirklich auf deiner eigenen Hardware ausführen kannst, bleiben die kleineren Kimi-Modelle und GLM die realistischen Optionen. Unser Überblick der besten open-source-KI-Modelle ordnet sie nach Hardware-Anforderungen.
Die Architektur hinter dem Sprung
Moonshot berichtet eine rund 2,5-fache Verbesserung der allgemeinen Skalierungseffizienz gegenüber Kimi K2. Vereinfacht gesagt wandelt K3 rohe Rechenleistung deutlich effektiver in nutzbare Intelligenz um als die vorherige Generation. Drei Änderungen tragen den Großteil des Gewichts, und alle drei sind nun im öffentlichen technischen Bericht dokumentiert.
Kimi Delta Attention
Kimi Delta Attention (KDA) ist ein hybrides lineares Attention-Verfahren, und 69 der 93 Schichten des Modells verwenden es, während die verbleibenden 24 Gated MLA nutzen. Standard-Attention wird langsamer und speicherhungriger, je länger Sequenzen werden, genau das Problem bei einer Million Token. Moonshot berichtet, KDA ermöglicht bis zu 6,3-fach schnelleres Decoding in Millionen-Token-Kontexten, was bei agentischer Arbeit wichtig ist, bei der ein Modell wiederholt riesige Code- oder Dokument-Abschnitte liest und darüber nachdenkt.
Attention Residuals
Attention Residuals (AttnRes) adressieren, wie Informationen durch die Tiefe des Netzwerks statt über die Sequenzlänge fließen. Statt Repräsentationen gleichmäßig schicht für schicht anzuhäufen, ruft AttnRes selektiv Repräsentationen über die Tiefe ab. Moonshot sagt, das liefert rund 25 % höhere Trainingseffizienz bei weniger als 2 % zusätzlicher Rechenleistung, und hat die Technik Anfang 2026 als open source veröffentlicht, bevor es sie in K3 integrierte.
Stable LatentMoE und MXFP4-Training
Das dritte Element ist das Stable-LatentMoE-Framework, das die aggressive 16-von-896-Experten-Sparsity trainierbar macht, ohne die Instabilität, die normalerweise entsteht, wenn man MoE so weit treibt. Daneben steht die Entscheidung, ab der Feinabstimmungsphase in MXFP4 zu trainieren statt hinterher zu quantisieren, was dafür sorgt, dass die veröffentlichten Gewichte sowohl klein als auch treu zu dem Modell sind, das Moonshot ausgewertet hat.
Eine Demonstration, die Moonshot hervorhob, ist aufschlussreich. Das Team ließ K3 seinen eigenen AttnRes-Trainingskernel in Produktionsgröße optimieren: 96 Schichten, ein 8.192-dimensionales Modell und 8.192 Token. In 15 Stunden ununterbrochener Iteration entwarf K3 einen neuartigen Zwei-Phasen-Kernel-Algorithmus, fused Kernels unter Erhalt der Numerik und reduzierte die Forward-plus-Backward-Zeit von 283,6 ms auf 114,4 ms. Das ist die Art von langhorizontiger Engineering-Aufgabe, an der die meisten Modelle innerhalb von Minuten stagnieren.
Ein 1-Million-Token-Kontextfenster
Kimi K3 verarbeitet bis zu 1.048.576 Token in einem einzigen Kontext, ungefähr das Vierfache des 256K-Fensters von K2.6. Das reicht für eine ganze Codebasis, einen Stapel langer Dokumente oder einen langen mehrstufigen Agentenlauf, ohne den Faden zu verlieren. Es entspricht außerdem dem 1M-Fenster, das Anthropic für Claude Opus 5.5, Fable 5.1 und Sonnet 5.5 gleichermaßen dokumentiert, sodass der Long-Context-Vorsprung, den Kimi gegenüber den geschlossenen Flaggschiffen hatte, auf ein Unentschieden geschrumpft ist.
Multimodale Eingabe und immer aktives Reasoning
K3 nimmt Text, Bilder und Video entgegen, was es über die textorientierte K2-Reihe hinaus in echtes multimodales Terrain schiebt. Moonshots eigener K3-Schnellstart dokumentiert Videoeingabe über die Files-API, und die Modellkarte nennt 90,0 bei Video-MME mit Untertiteln. Das Reasoning ist immer an, und der Parameter reasoning_effort unterstützt jetzt low, high und max, mit max als Standard. Zum Launch war nur max verfügbar, die versprochenen Effort-Stufen sind seither also angekommen.
Wie Kimi K3 bei Benchmarks abschneidet
Hier leben zwei separate Fragen. Was sagen die unabhängigen Boards über Kimi K3, und was behauptet Moonshoots eigene Bewertungssuite? Das unabhängige Bild kam erst nach dem Launch, daher ist es der bessere Ausgangspunkt, und die Herstellerzahlen machen mehr Sinn, sobald man es gesehen hat.
Was die unabhängigen Boards sagen
Artificial Analysis bewertet Kimi K3 inzwischen mit 43,6 Punkten im Intelligence Index v4.3.2, abgelesen auf seiner Modellseite am 24. September 2026. Der größte Teil des Rückgangs von den 57 Punkten, die dieser Artikel zunächst nannte, ist eine Neuskalierung und keine Verschlechterung, denn der Index ging im September durch v4.2 und v4.3, und jeder Wert auf dem Board ging mit ihm nach unten. Wirklich geändert hat sich die Gesellschaft, in der K3 sich bewegt. Claude Opus 5.5 steht bei 57,6, Claude Fable 5.1 bei 53,4 und GPT-6 Astra bei 52,7, und unter den open-weight-Modellen ist K3 jetzt Dritter, hinter MiMo-V2.6-Pro mit 46,3 und GLM-5.3 mit 44,8.
Zwei der Zahlen, die dieser Artikel früher zitierte, gibt es nicht mehr. Artificial Analysis hat seinen Agentic Index in den Hauptindex eingeschmolzen und den Coding Index danach ganz eingestellt, sodass sich keiner der beiden Sammelwerte aktualisieren lässt. Was bleibt, sind Tempo und Kosten, und beide sprechen weiter gegen K3. Artificial Analysis misst es bei rund 37 Token pro Sekunde, gegenüber 54 für Claude Opus 5 und 116 für GPT-6 Sol, womit es das langsamste Modell der Frontier-Gruppe ist. Pro Intelligence-Index-Aufgabe berechnet es $2.00, gegenüber $5.98 für Opus 5.5 und $0.13 für MiMo-V2.6-Pro.
Im WebDev-Leaderboard von Arena, wo Menschen blind über generierte Front-Ends abstimmen, liegt K3 jetzt bei 1.659,6 Punkten aus 13.252 Stimmen, abgelesen am 24. September 2026. Das ist Platz neun insgesamt und Platz eins unter den open-weight-Modellen. Alle acht Einträge darüber sind geschlossen: Claude Opus 5.5 bei 1.818,4, GPT-6 Astra bei 1.792,2, Claude Fable 5.1 bei 1.754,7, zwei Effort-Stufen von Claude Opus 5, GPT-6 Sol bei 1.685,9 und zwei Qwen3.8-Max-Snapshots. K3 hatte beim Launch die Spitzenposition inne, das ist also ein Board, auf dem es überholt wurde, und keines, von dem es gefallen wäre.
Das Agent-Board von Arena, das bewertet, wie gut Modelle Werkzeuge bei echten Aufgaben orchestrieren, veröffentlicht jetzt auch eine Gesamtplatzierung und setzt Kimi K3 auf Platz acht mit +0,062, an die Spitze des offenen Feldes und vor Tencents Hy4 Preview, DeepSeek V4.1 Flash und beide GLM-Einträge. Die fünf zugrunde liegenden Signale lohnen eine getrennte Lektüre: K3 ist Fünfter bei der Aufgabenerledigung, dem Signal, das sagt, ob die Arbeit tatsächlich fertig wurde, aber Siebzehnter bei der Steuerbarkeit und Neunzehnter beim Erholen von einem fehlgeschlagenen Shell-Befehl. Im allgemeinen Text-Board liegt es auf Platz 17 von 125 mit 1.484,8 Punkten aus 20.987 Stimmen. MiMo-V2.6-Pro, das Modell, das es im Index jetzt übertrifft, hat überhaupt keine Arena-Stimmen.
Moonshoots eigene Coding-Benchmarks
Moonshot veröffentlichte diese Suite zum Launch im Juli 2026 und verglich darin Kimi K3 mit Claude Fable 5, GPT-5.6 Sol, Claude Opus 4.8, GPT-5.5 und GLM-5.2, alle mit maximalem Thinking-Effort. Lies sie als Juli-Momentaufnahme: Jedes geschlossene Modell darin wurde inzwischen abgelöst, und die Terminal-Bench-Zeile ist Version 2.1, die die Branche durch das deutlich härtere 4.0 ersetzt hat. Es sind zudem die eigenen Läufe des Anbieters, bei denen K3 in mehreren Zeilen auf dem Kimi-Code-Harness ausgewertet wurde, also behandle sie als Moonshots Behauptungen und nicht als unabhängige Ergebnisse.
| Benchmark | Kimi K3 | Fable 5 | GPT-5.6 Sol | Opus 4.8 | GPT-5.5 | GLM-5.2 |
|---|---|---|---|---|---|---|
| DeepSWE | 67,5 | 70,0 | 73,0 | 59,0 | 67,0 | 46,2 |
| ProgramBench | 77,8 | 76,8 | 77,6 | 71,9 | 70,8 | 63,7 |
| Terminal-Bench 2.1 | 88,3 | 88,0 | 88,8 | 84,6 | 83,4 | 82,7 |
| FrontierSWE | 81,2 | 86,6 | 71,3 | 66,7 | 64,9 | 67,3 |
| SWE-Marathon | 42,0 | 35,0 | 39,0 | 40,0 | 14,0 | 13,0 |
| Kimi Code Bench 2.0 | 72,9 | 76,9 | 64,8 | 71,7 | 69,0 | 64,2 |
Direktes Lesen ergibt: Kimi K3 gewinnt ProgramBench und SWE-Marathon klar und liegt beim Terminal-Bench 2.1 innerhalb eines halben Punktes vom Führenden. Bei FrontierSWE landet es auf Platz zwei hinter Fable 5, aber weit vor allem anderen. Moonshoots eigene Fußnoten fügen einen erwähnenswerten Vorbehalt hinzu: Claude Fable 5 traf bei 35 % der SWE-Marathon-Aufgaben in dieser Auswertung Sicherheits-Fallbacks, was sein Ergebnis nach unten gezogen haben könnte.
Agentische und Wissensarbeit-Benchmarks
| Benchmark | Kimi K3 | Fable 5 | GPT-5.6 Sol | Opus 4.8 | GLM-5.2 |
|---|---|---|---|---|---|
| BrowseComp | 91,2 | 88,0 | 90,4 | 84,3 | n/a |
| MCPMark-Verified | 94,5 | 87,4 | 92,9 | 76,4 | n/a |
| GDPval-AA v2 (Elo) | 1.686 | 1.747 | 1.736 | 1.593 | 1.510 |
| AA-Briefcase (Elo) | 1.548 | 1.583 | 1.495 | 1.354 | 1.260 |
| JobBench | 54,3 | 57,4 | 45,4 | 48,4 | 43,4 |
| SpreadsheetBench 2 | 34,8 | 34,7 | 32,4 | 31,6 | 28,1 |
| AutomationBench | 30,8 | 29,1 | 29,7 | 27,2 | 12,9 |
| OSWorld 2.0 | 58,3 | 66,1 | 62,6 | 55,7 | n/a |
Kimi K3 führt bei BrowseComp, MCPMark, SpreadsheetBench 2 und AutomationBench und belegt beim AA-Briefcase, dem Langzeithorizont-Agentik-Benchmark, Platz zwei, hinter Fable 5 und vor GPT-5.6 Sol. Ein Vorbehalt bei BrowseComp: die 91,2 nutzen eine Kontextkomprimierungsstrategie, die bei 300K Token ausgelöst wird. Mit dem vollen 1M-Fenster und ohne Kontext-Management erzielt K3 90,4, was immer noch die beste Zahl in dieser Spalte ist.
Bei Computer Use schlagen Fable 5 und GPT-5.6 Sol K3 beide bei OSWorld 2.0, das open-source-Modell liegt also nicht überall vorne. Es erzielte 93,5 % beim GPQA Diamond, auf Augenhöhe mit GPT-5.5 und vor GLM-5.2 mit 91,2, sowie 94,6 beim Harvey Lab-AA, dem besten Wert in dieser Zeile aus jedem Modell in der Tabelle.
Moonshots eigene Zusammenfassung ist zurückhaltender als die Berichterstattung war. Der Launch-Blog sagt, K3s Gesamtleistung „bleibt hinter den leistungsstärksten proprietären Modellen zurück, Claude Fable 5 und GPT 5.6 Sol“, zeige aber über die Suite hinweg Frontier-Niveau. Dieser Satz steht zwei Monate später immer noch auf der Seite, und beide dort genannten Modelle wurden seither ersetzt, durch Claude Fable 5.1 und GPT-6 Sol. Wenn ein Labor sein eigenes Modell untertreibt, ist das meist die Zahl, der man trauen kann.
Kimi K3 vs Claude Opus 5.5
Der Vergleich, den alle anstellen, ist Kimi K3 vs Claude, und die Claude-Seite hat sich seit K3s Launch zweimal bewegt. Anthropic brachte am 24. Juli Claude Opus 5, weshalb Moonshots Launch-Tabelle oben Opus 4.8 zugeordnet bleibt. Am 22. September folgte dann Claude Opus 5.5, und Opus 5 wanderte auf die Legacy-Liste. Für eine Entscheidung, die du heute triffst, steht Opus 5.5 auf der anderen Seite des Tisches, und es ist sowohl günstiger als auch stärker als das Opus 5, gegen das dieser Vergleich ursprünglich geschrieben wurde.
| Modell | Entwickler | Kontext | Offene Gewichte | API-Preis pro 1M |
|---|---|---|---|---|
| Kimi K3 | Moonshot AI | 1.048.576 | Ja, Kimi K3 License | $3 / $15 |
| Claude Opus 5.5 | Anthropic | 1M | Nein | $4 / $20 |
| Claude Opus 5 (Legacy) | Anthropic | 1M | Nein | $5 / $25 |
| Claude Fable 5.1 | Anthropic | 1M | Nein | $10 / $50 |
| MiMo-V2.6-Pro | Xiaomi | 1M | Ja, MIT | $0.435 / $0.87 |
| GLM-5.3 | Z.ai | 1M | Ja, GLM 5.3 License | $1.40 / $4.40 |
| Kimi K2.6 | Moonshot AI | 262.144 | Ja, modifiziertes MIT | $0.95 / $4 |
Beim Preis gewinnt K3 weiterhin, aber knapper als früher: $3 / $15 gegenüber $4 / $20 für Opus 5.5, also 25 % günstiger, wo es Opus 5 um 40 % unterbot, und gegenüber $10 / $50 für Fable 5.1. Bei der gemessenen Leistung lief die Lücke in die andere Richtung, von vier Punkten auf vierzehn im Artificial-Analysis-Intelligence-Index, und Opus 5.5 führt das WebDev-Board von Arena um 159 Punkte an. Anthropic veröffentlicht für keines der beiden Opus einen SWE-bench-Wert, wer dir also einen zitiert, zitiert nicht Anthropic.
Der eigentliche Unterschied ist nicht der Wert, sondern was du besitzen darfst. Opus 5.5 ist das stärkere Modell und die sicherere Standardwahl für produktives Coding, und Anthropics eigene Dokumentation rät Entwicklerinnen und Entwicklern inzwischen, für die meisten Workloads damit anzufangen. K3 ist das, was du herunterladen, prüfen, feinabstimmen und im eigenen Netzwerk betreiben kannst, was kein Claude-Modell zu irgendeinem Preis erlaubt. Wenn du für eine bestimmte Aufgabe zwischen Flaggschiffen wählst, schlüsselt unser Leitfaden wann welches KI-Modell zu nutzen ist die Entscheidung Aufgabe für Aufgabe auf.
Kimi K3: Preise
Moonshot hat inzwischen offizielle Preise veröffentlicht, womit die Schätzungen Dritter vom Launch hinfällig sind. Kimi-K3-Preise liegen bei $3.00 pro Million Eingabe-Token und $15.00 pro Million Ausgabe-Token, mit gecachter Eingabe zu $0.30, einem Rabatt von 90 %, der viel ausmacht, wenn du denselben langen Kontext immer wieder schickst. K3 berechnet außerdem den Cache-Schreibvorgang selbst, $3.00 für einen Fünf-Minuten-Eintrag oder $6.00 für einen Ein-Stunden-Eintrag, was die K2-Modelle nicht tun.
| Modell | Eingabe (Cache Miss) | Eingabe (Cache Hit) | Ausgabe | Kontext |
|---|---|---|---|---|
| kimi-k3 | $3.00 | $0.30 | $15.00 | 1.048.576 |
| kimi-k2.7-code | $0.95 | $0.19 | $4.00 | 262.144 |
| kimi-k2.7-code-highspeed | $1.90 | $0.38 | $8.00 | 262.144 |
| kimi-k2.6 | $0.95 | $0.16 | $4.00 | 262.144 |
Diese Preise entsprechen nicht mehr Claude Sonnet 5.5, das $2 Eingabe und $10 Ausgabe kostet, sodass K3 auf beiden Hälften der Rechnung 50 % teurer ist, und seit dem Start von Sonnet 5.5 am 28. September liegt Sonnet auch im Artificial-Analysis-Intelligence-Index vorn, mit 56,0 gegenüber 43,6. Gegen die zwei weiteren Claude-Modelle, die es übertreffen, ist K3 weiterhin 25 % günstiger als Opus 5.5 und 70 % günstiger als Fable 5.1. Auch die Websuche hat ihre Form geändert. Moonshot hat sie im September auf eigenständige REST-Endpunkte verlegt und berechnet nur erfolgreiche Aufrufe, mit $0.002 für Web Search Basic, $0.003 für Web Search Pro und $0.002 für URL Fetch.
K3 ist gegenüber der K2-Reihe ein klarer Kostensprung, was seinen größeren Fußabdruck und das durchgehende Reasoning widerspiegelt. Wenn dein Workload keine Frontier-Größenordnung braucht, bleiben K2.6 oder K2.7 Code deutlich günstiger, und kimi-k2.5 steht nicht mehr zur Wahl: Moonshot hat es zusammen mit der gesamten moonshot-v1-Reihe am 31. August 2026 eingestellt, Aufrufe darauf liefern jetzt einen 404. Auf der API-Plattform wird K3 verfügbar, sobald du eine erfolgreiche Aufladung von mindestens $1 gemacht hast, kumulierte $5 bringen einen Gutschein über $5, und deine kumulierte Aufladung bestimmt deine Rate Limits. Unsere vollständige Kimi-Preisübersicht vergleicht jeden Plan und API-Preis nebeneinander.
Die Nachfrage überholte Moonshots Hardware fast sofort. Am 19. Juli 2026, drei Tage nach dem Launch, pausierte das Unternehmen neue Kimi-Abos und erklärte, die Nachfrage der vorangegangenen 48 Stunden sei „nah an die Grenzen unserer aktuellen Kapazität gestoßen“ und man werde „neue Abo-Plätze in Chargen wieder öffnen“, während man Hardware ergänze, in einer Stellungnahme, die die South China Morning Post wiedergab. Bestehende Abonnenten behielten ihren Zugang, und derselbe Beitrag versprach die Aufteilung der Mitgliedschaft in Kimi Membership für Web, App und Work sowie Kimi Code Membership fürs Coden. Der Launch-Aufladerabatt, den Moonshot aus demselben Grund vorzeitig beendete, ist aus der Preisdokumentation verschwunden. Was die Dokumentation stattdessen festhält, datiert auf September 2026, ist eine Abrechnungsänderung: Verbrauch wird jetzt pauschal zu 50 % von Guthaben und zu 50 % von Gutscheinen abgezogen.
So nutzt du Kimi K3
Es gibt jetzt, da die Gewichte öffentlich sind, vier Wege zu Kimi K3, und welcher passt, hängt davon ab, ob du ein Chat-Fenster, einen Terminal-Agenten, eine API oder die rohen Dateien willst. Hier ist die praktische Reihenfolge.
- Kimi-App und Playground. Der schnellste Weg ist die Kimi-App oder der web-basierte Playground, wo K3 für eingeloggte Nutzer auswählbar ist. Das ist die No-Code-Option zum Testen des Modells mit eigenen Prompts.
- Kimi Code CLI. Moonshot sagt, K3 funktioniert am besten in seinem eigenen Terminal-Agenten, wo du das Modell mit dem
/model-Befehl auswählst. K3 integriert sich auch in Codex CLI, Claude Code, OpenCode und Hermes Agent über Moonshoots dokumentierte Integrationen. - Die API. Entwickler rufen
kimi-k3über die Kimi-API-Plattform auf, die OpenAI-kompatible und Anthropic-kompatible Endpunkte bietet. Sie unterstützt Tool-Aufrufe, JSON-Schema-strukturierte Ausgabe, Kontext-Caching und die Reasoning-Effort-Kontrolle, und K3 ist auch auf Aggregatoren wie OpenRouter gelistet. - Offene Gewichte. Der vollständige Checkpoint ist auf Hugging Face unter der Kimi-K3-Lizenz, und Moonshot empfiehlt vLLM, SGLang oder TokenSpeed zum Betrieb. Plane für den 1,56-TB-Download und die Multi-Node-Hardware, die er braucht.
Möchtest du nicht für jedes neue Modell ein separates Abo jonglieren? Apps wie Fello vereinen leistungsstarke aktuelle KI-Modelle an einem Ort, was hilft, während sich ein Launch wie dieser setzt. Für einen breiteren Blick auf das open-source-Feld ordnet unser Überblick der derzeit besten open-source-KI-Modelle K3s Abstammung ein. Wenn du speziell chinesische open-source-Modelle abwägst, ist unser Explainer darüber, was GLM ist und wie es konkurriert, ein nützliches Begleitstück.
Das Unternehmen hinter Moonshot AI
Kimi K3 kommt in einem entscheidenden Moment für Moonshot AI, das 2023 von Yang Zhilin gegründete Pekinger Startup. Im Juli hieß es, das Unternehmen nehme zwischen 1 und 2 Milliarden Dollar bei einer Bewertung von bis zu 31,5 Milliarden Dollar auf, rund 50 % über den 20 Milliarden vom Mai und etwa das Siebenfache dessen, was es im Dezember 2025 wert war. Diese Zahl ist bereits überholt. Reuters berichtete am 3. September 2026, Moonshot habe vertraulich einen Börsengang in Hongkong eingereicht, mit dem Ziel, 3 Milliarden Dollar bei einer Bewertung von 50 Milliarden Dollar in einer laufenden Runde aufzunehmen, gemeinsam mit Goldman Sachs, CICC und der Deutschen Bank. Es ist genau der Börsengang, den TechNode im Juli als binnen sechs Monaten möglich bezeichnet hatte, und Moonshot wollte die Einreichung nicht kommentieren.
Die open-source-Strategie ist zentral für den Schwung. Als Moonshot Kimi K2.6 im April 2026 als open source veröffentlichte, stieg es bis Mitte 2026 zum zweitmeistgenutzten großen Sprachmodell auf OpenRouter auf. Damit stand ein drei Jahre altes Lab vor den meisten westlichen Frontier-Labs auf unabhängigen Nutzungs-Bestenlisten. Die Veröffentlichung der K3-Gewichte erweitert dieses Spielbuch auf ein Frontier-Modell.
Das Timing war kein Zufall. Kimi K3 erschien kurz vor der World Artificial Intelligence Conference 2026 in Shanghai, auf der der chinesische Präsident Xi Jinping voraussichtlich Pekings KI-Prioritäten umreißen würde. Tage später auf derselben Konferenz präsentierte Alibaba eine Vorschau auf Qwen 3.8, sein eigenes 2,4-Billionen-Parameter-Konkurrenzmodell. Die Reaktion im Westen war eine Mischung aus Staunen und Alarm, wobei Beobachter feststellten, dass China dabei zu sein scheint, einen einst komfortablen amerikanischen Vorsprung zu schließen.
Warum Kimi K3 wichtig ist
Kimi K3 ist nicht nur ein weiterer Modell-Drop. Mit den öffentlichen Gewichten ist es das größte je veröffentlichte open-weight-Modell und gibt Entwicklern Frontier-Skalierung, die sie herunterladen, prüfen und selbst betreiben können. Das ist eine direkte Herausforderung an die geschlossenen, hochpreisigen Flaggschiffe, die die Spitze des Marktes bisher definiert haben.
Die Lücke, die es schließt, ist enger als die Schlagzeile andeutet und breiter als es aussieht.
Vierzehn Punkte im Artificial-Analysis-Intelligence-Index trennen K3 inzwischen von Claude Opus 5.5, und 2,7 Punkte trennen K3 von dem offenen Modell, das es im September überholt hat. Vor zwei Monaten betrug die erste Lücke vier Punkte, und die zweite lief in die andere Richtung. Das geschlossene Feld hat sich über den Sommer weiter bewegt als das offene, und das offene Feld hat obendrein seinen eigenen Spitzenreiter gewechselt.
Der geschäftliche Kontext macht den Anspruch deutlich. Moonshots Kimi-Familie überschritt Berichten zufolge bis Mitte Juni 300 Millionen Dollar an jährlich wiederkehrendem Umsatz, und laut TechCrunchs Launch-Bericht nahm das Unternehmen damals frisches Kapital bei einer kolportierten Bewertung von 31,5 Milliarden Dollar auf. Zwei Monate später wird dieselbe Runde mit 50 Milliarden Dollar und einem eingereichten Börsengang beziffert. Ein gut finanziertes Labor, das ein riesiges offenes Modell zu aggressiven Preisen ausliefert, ist genau der Druck, der umformt, was alle anderen verlangen. Wie schnell sich die geschlossene Seite bewegt, zeigt unser Leitfaden zu GPT-6 Sol und Luna als nützlicher Kontrapunkt.
Fazit
Kimi K3 hat geliefert, was es versprach. Die Gewichte sind öffentlich, die Lizenz ist für fast jeden brauchbar, der sie tatsächlich nutzen wird, und die Preise sind offiziell und niedrig. Was nicht gehalten hat, ist die Krone. Artificial Analysis nennt K3 nicht mehr das stärkste offene Modell überhaupt und stellt Xiaomis MiMo-V2.6-Pro und Z.ais GLM-5.3 darüber, während Arenas menschliche Abstimmende K3 auf beiden Boards, die es gesehen haben, weiterhin als erstes offenes Modell führen. Das beste Modell überhaupt war es nie, und Moonshot sagt das selbst.
Unsere Empfehlung: Nimm K3, wenn offene Gewichte, Kosten oder ein Millionen-Token-Kontext das sind, was du brauchst, und wenn du ein offenes Modell mit echter Historie willst statt eines Benchmark-Werts, der ein paar Tage alt ist. Halte Claude Opus 5.5 für das härteste produktive Coding bereit, wo es jedes unabhängige Board anführt, das beide bewertet hat. Wenn du die praktische Fassung dieses Abwägens willst, beschreibt unser Claude-Opus-5.5-Review, was die geschlossene Seite heute für $4 pro Million Eingabe-Token bietet.
Kimi K3 gehört in einen direkten Vergleich. Mit Fello AI kannst du Kimi neben Claude, GPT-6, Gemini, DeepSeek und Perplexity in einer nativen App für Mac, iPhone und iPad laufen lassen. Schick dieselbe Coding- oder Recherche-Aufgabe an jedes Frontier-Modell auf einmal und sieh, welches bei deiner Arbeit tatsächlich gewinnt, ohne mit getrennten Konten zu jonglieren. Wenn ein so leistungsfähiges offenes Modell erscheint, ist der schnellste Weg, es zu beurteilen, ein Test nebeneinander. Auf dem Mac ist es ein nativer Kimi-Desktop-Client, K3 öffnet sich also wie jede andere App. Wie K3 gegen die Modelle in den einzelnen ChatGPT-Tarifen abschneidet, zeigt unser Vergleich Kimi vs ChatGPT.
FAQ
Sind die offenen Gewichte von Kimi K3 verfügbar?
Ja. Moonshot veröffentlichte die vollständigen Kimi-K3-Gewichte am 27. Juli 2026 auf Hugging Face, elf Tage nach dem Launch. Das Repository enthält 96 Safetensors-Shards, insgesamt rund 1,56 TB, veröffentlicht unter der eigenen Kimi-K3-Lizenz.
Ist Kimi K3 open source?
Es ist eher open weight als open source im engeren Sinne. Die Kimi-K3-Lizenz erlaubt Nutzung, Modifikation, Verteilung und kommerziellen Verkauf. Ein Model-as-a-Service-Unternehmen mit mehr als $20 Millionen Umsatz in 12 Monaten braucht eine separate Vereinbarung, und Produkte mit über 100 Millionen monatlichen Nutzern müssen Kimi K3 im Interface nennen.
Wie viele Parameter hat Kimi K3?
Kimi K3 hat 2,8 Billionen Gesamt-Parameter in einem Mixture-of-Experts-Design, von denen 104 Milliarden pro Token aktiviert werden. Moonshot nennt es das weltweit erste offene 3T-Klasse-Modell, und die Modellkarte bestätigt beide Zahlen.
Ist Kimi K3 besser als Claude Opus 5?
Bei gemessener Leistung nicht, und im September ist die Lücke gewachsen. Im Artificial-Analysis-Intelligence-Index v4.3.2 erreicht Claude Opus 5 50,8 und sein Nachfolger Claude Opus 5.5 57,6, gegenüber 43,6 für Kimi K3, und beide stehen im WebDev-Board von Arena über K3. K3 gewinnt beim Preis, mit $3 und $15 pro Million Token gegenüber $5 und $25 für Opus 5 und $4 und $20 für Opus 5.5, und es ist das einzige der drei, das du herunterladen und selbst betreiben kannst.
Was kostet Kimi K3?
Der offizielle API-Preis beträgt $3.00 pro Million Eingabe-Token und $15.00 pro Million Ausgabe-Token, bei gecachter Eingabe fallend auf $0.30 pro Million, wobei der Cache-Schreibvorgang je nach Lebensdauer des Eintrags mit $3.00 oder $6.00 berechnet wird. Die Websuche ist im September 2026 auf eigenständige Endpunkte umgezogen und berechnet erfolgreiche Aufrufe mit $0.002 bis $0.003, und das Modell wird auf der API-Plattform nach einer Aufladung von mindestens $1 verfügbar.