A Moonshot AI publicou os pesos completos do Kimi K3 a 27 de julho de 2026, onze dias depois de o modelo ter entrado em funcionamento na aplicação Kimi. O repositório na Hugging Face contém 96 fragmentos safetensors que totalizam cerca de 1,56 TB. Com 2,8 biliões de parâmetros totais, com 104 mil milhões ativos por token, o K3 é o maior modelo aberto que alguém já lançou. A Moonshot chama-lhe o primeiro modelo aberto de classe 3B do mundo, e essa afirmação tem agora um botão de descarregar por trás.
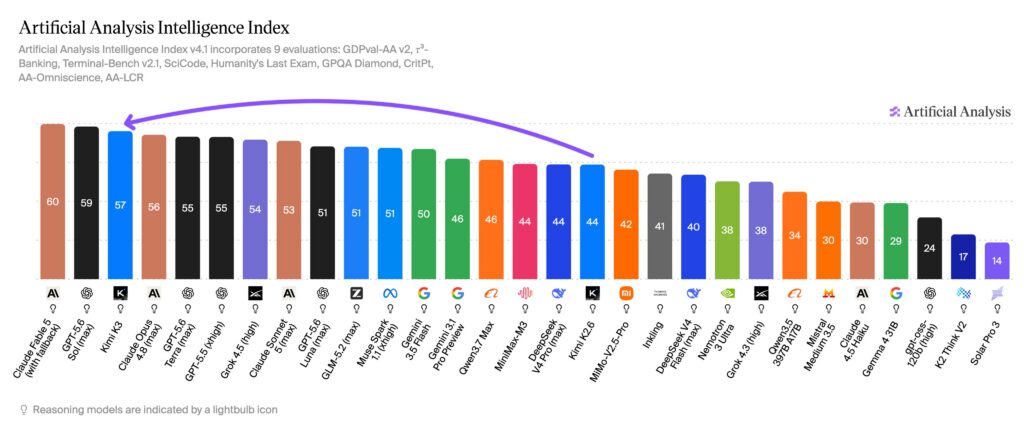
O retrato independente mudou muito desde o lançamento, e não a favor do K3. O Kimi K3 pontua agora 43,6 no Intelligence Index v4.3.2 da Artificial Analysis, o que o deixa em terceiro entre os modelos de open weights em vez de primeiro, atrás do MiMo-V2.6-Pro da Xiaomi com 46,3 e do GLM-5.3 da Z.ai com 44,8. Os quadros onde votam pessoas dizem o contrário, e o K3 continua a liderar o campo aberto nos dois. Abaixo tem as especificações verificadas, o que a licença de facto permite, as tarifas oficiais da API e uma leitura honesta de como o K3 se compara com o Claude Opus 5.5, que a 22 de setembro de 2026 substituiu o Opus 5 como modelo por omissão da Anthropic.
Principais conclusões
- Os open weights saíram a 27 de julho de 2026, 96 fragmentos e cerca de 1,56 TB na Hugging Face, sob uma Kimi K3 License personalizada em vez da MIT.
- Um design Mixture-of-Experts com 2,8 biliões de parâmetros totais, 104 mil milhões ativados por token e uma janela de contexto de 1 048 576 tokens.
- Aceita entrada de texto, imagem e vídeo, raciocina sempre e expõe agora um esforço de raciocínio baixo, alto e máximo em vez de apenas máximo.
- O preço oficial da API é de $3.00 por milhão de tokens de entrada e $15.00 de saída, descendo para $0.30 na entrada em cache, com a própria escrita em cache faturada a $3.00 ou $6.00 conforme o tempo de vida da entrada.
- Pontua 43,6 no Artificial Analysis Intelligence Index v4.3.2, terceiro entre os open weights atrás do MiMo-V2.6-Pro com 46,3 e do GLM-5.3 com 44,8, mas ainda o modelo aberto mais bem colocado nos quadros onde votam pessoas.
O que é o Kimi K3?
O Kimi K3 é o grande modelo de linguagem de topo da Moonshot AI, lançado a 16 de julho de 2026 e disponibilizado como open weights a 27 de julho. Usa um design Mixture-of-Experts com 2,8 biliões de parâmetros totais, dos quais 104 mil milhões ativam em cada token, e lê uma janela de contexto de 1 milhão de tokens. A própria documentação da Moonshot confirma que aceita entrada de texto, imagem e vídeo.
O intervalo entre o lançamento e os pesos foi planeado, e a Moonshot disse-o na altura. A sua publicação de lançamento prometia os ficheiros “até 27 de julho de 2026”, enquanto a equipa trabalhava “de perto com parceiros de inferência e mantenedores de open source para alinhar detalhes técnicos e garantir uma implementação fiável em todo o ecossistema”. O relatório técnico saiu com os pesos, em vez de vir a reboque.
| Especificação | Kimi K3 |
|---|---|
| Programador | Moonshot AI |
| Lançado | 16 de julho de 2026 (pesos a 27 de julho de 2026) |
| Arquitetura | Mixture-of-Experts (MoE) |
| Parâmetros totais | 2,8 biliões |
| Parâmetros ativados | 104 mil milhões por token |
| Camadas | 93 (69 Kimi Delta Attention, 24 Gated MLA) |
| Experts | 896 no total, 16 selecionados por token |
| Codificador de visão | MoonViT-V2, 401M de parâmetros |
| Janela de contexto | 1 048 576 tokens |
| Tipos de entrada | Texto, imagem, vídeo |
| Quantização | Pesos MXFP4, ativações MXFP8 |
| Controlo de raciocínio | reasoning_effort baixo / alto / máximo, predefinição máximo |
| Licença | Kimi K3 License (personalizada, não MIT) |
Com 2,8 biliões de parâmetros, o Kimi K3 continua a ser o maior modelo aberto lançado até hoje, ainda que a margem tenha encolhido desde julho: o Qwen3.8 2.4T A95B da Alibaba declara 2,45 biliões, quando o rival mais próximo costumava ser o V4-Pro da DeepSeek com 1,6 biliões. O desenho Mixture-of-Experts significa que só uma pequena fração desses parâmetros dispara em cada token, por isso o custo de computação efetivo fica muito abaixo do que o número bruto sugere. Ativar 16 de 896 especialistas é um rácio de esparsidade invulgarmente alto. Essa escolha é central para perceber como a Moonshot espremeu desempenho de fronteira da arquitetura.
Open weights do Kimi K3: o que saiu de facto
É esta a parte que mudou a 27 de julho, e é a razão pela qual o K3 importa mais do que a sua linha de benchmark. Todos os outros modelos deste nível de capacidade são uma API que aluga. O K3 é um ficheiro que pode ter na mão.
O que está no repositório
O repositório na Hugging Face contém 120 ficheiros, dos quais 96 são fragmentos safetensors, e o descarregamento completo dá cerca de 1,56 TB. A Moonshot disponibiliza o modelo em pesos MXFP4 nativos com ativações MXFP8, aplicados através de treino consciente da quantização a partir da fase de fine-tuning supervisionado. É por isso que um modelo de 2,8 biliões de parâmetros cabe em 1,56 TB em vez de várias vezes esse valor, e significa que não está a descarregar uma quantização com perdas feita pela comunidade, está a descarregar o que a Moonshot treinou.
A procura foi imediata e não abrandou. Um dia depois de os ficheiros serem publicados, o repositório mostrava cerca de 99 000 descarregamentos e mais de 7300 likes, contados a 28 de julho de 2026. A 24 de setembro, o Hugging Face indicava 1,86 milhões de descarregamentos no mês anterior e 11 500 likes. Para um checkpoint que quase ninguém consegue alojar na própria máquina, é muito tráfego, e grande parte serão fornecedores de inferência, projetos de quantização e laboratórios de investigação em vez de particulares.
A Moonshot nomeia três motores de inferência como runtimes recomendados, o vLLM, o SGLang e o TokenSpeed, cada um com a sua própria receita publicada para o K3. O relatório técnico saiu com os pesos, em vez de vir a reboque, por isso os detalhes da arquitetura também são públicos.
A Kimi K3 License não é MIT
Leia isto antes de planear um produto à volta dela.
A licença concede os direitos habituais de usar, copiar, modificar, distribuir, sublicenciar, fazer fine-tuning e vender, o que se lê como MIT para a maioria dos leitores. Duas cláusulas anexam depois condições que a MIT não tem. A Tencent seguiu o caminho oposto a 28 de agosto de 2026 e publicou os pesos de 770B do Hy4 Preview sob a licença Apache 2.0 simples.
A primeira é um limiar de receita para a revenda. Se gere um negócio de model-as-a-service e a sua receita ultrapassar os 20 milhões de dólares em quaisquer 12 meses consecutivos, tem de assinar um acordo separado com a Moonshot antes de usar o K3 comercialmente. A segunda é uma regra de atribuição. Qualquer produto construído sobre o K3 com mais de 100 milhões de utilizadores ativos mensais, ou mais de 20 milhões de dólares de receita mensal, tem de exibir o nome “Kimi K3” de forma bem visível na sua interface.
Ambas as condições caem no uso puramente interno, ou seja, em tudo o que nunca expõe o modelo nem as suas saídas a terceiros. Para um programador individual, uma startup ou um grupo de investigação, o efeito prático é nulo. Para um hiperescalador que revende inferência, é uma negociação. Essa troca costumava ser todo o argumento a favor do K3: capacidade de topo em troca de uma licença que é preciso ler com atenção. Hoje é um argumento mais fraco, porque há dois modelos abertos acima do K3 no índice da Artificial Analysis, e um deles, o MiMo-V2.6-Pro da Xiaomi, sai sob MIT sem condições. O outro é a linha GLM da Z.ai, onde o topo de gama GLM-5.3 traz a sua própria licença à medida e só o GLM 5.3 Flash é MIT.
O que é preciso para correr o Kimi K3 por conta própria
Descarregável não é o mesmo que executável. Um checkpoint de 1,56 TB precisa de um cluster de GPU multinó para servir em contexto completo, por isso “pode alojá-lo internamente” é verdade para laboratórios e equipas de infraestrutura sérias, não para alguém com uma única estação de trabalho. Se quer um modelo aberto que consiga mesmo correr no seu próprio hardware, os modelos Kimi mais pequenos e o GLM continuam a ser as opções realistas. A nossa síntese dos melhores modelos de IA open source ordena-os pelo que o hardware exige.
A arquitetura por trás do salto
A Moonshot reporta cerca de 2,5x de melhoria na eficiência global de escalabilidade face ao Kimi K2. Em termos simples, o K3 converte computação bruta em inteligência utilizável de forma muito mais eficaz do que a geração anterior. Três mudanças carregam a maior parte do peso, e as três estão agora documentadas no relatório técnico público.
Kimi Delta Attention
A Kimi Delta Attention (KDA) é um mecanismo de atenção linear híbrida, e 69 das 93 camadas do modelo usam-na, correndo as restantes 24 em Gated MLA. A atenção padrão fica mais lenta e mais gulosa de memória à medida que as sequências crescem, que é exatamente o problema com um milhão de tokens. A Moonshot reporta que a KDA permite uma descodificação até 6,3x mais rápida em contextos de um milhão de tokens, o que importa para trabalho agentivo, onde um modelo lê e raciocina repetidamente sobre enormes extensões de código ou documentos.
Attention Residuals
Os Attention Residuals (AttnRes) tratam de como a informação se move ao longo da profundidade da rede, e não ao longo do comprimento da sequência. Em vez de acumular representações de forma uniforme camada a camada, os AttnRes recuperam representações de forma seletiva ao longo da profundidade. A Moonshot diz que isto proporciona cerca de 25% mais eficiência de treino acrescentando menos de 2% de computação extra, e abriu o código da técnica ainda em 2026 antes de a integrar no K3.
Stable LatentMoE e treino em MXFP4
A terceira peça é a framework Stable LatentMoE, que torna treinável a esparsidade agressiva de 16 em 896 experts sem a instabilidade que costuma vir de levar o MoE tão longe. Ao lado dela está a decisão de treinar em MXFP4 a partir da fase de fine-tuning em vez de quantizar depois, que é o que mantém os pesos lançados tanto pequenos como fiéis ao modelo que a Moonshot avaliou.
Uma demonstração que a Moonshot destacou é reveladora. A equipa apontou o K3 a otimizar o seu próprio kernel de treino AttnRes à escala de produção, 96 camadas, um modelo de 8192 dimensões e 8192 tokens. Ao longo de 15 horas de iteração ininterrupta, o K3 concebeu um novo algoritmo de kernel em duas fases, fundiu kernels preservando a numérica e cortou o tempo de forward mais backward de 283,6 ms para 114,4 ms. É o tipo de tarefa de engenharia de longo horizonte em que a maioria dos modelos encalha ao fim de minutos.
Uma janela de contexto de 1 milhão de tokens
O Kimi K3 lida com até 1 048 576 tokens num único contexto, cerca de quatro vezes a janela de 256K do K2.6. Isso chega para conter uma base de código inteira, uma pilha de documentos longos ou uma execução de agente longa e de vários passos sem perder o fio. Também iguala a janela de 1M que a Anthropic documenta por igual para o Claude Opus 5.5, o Fable 5.1 e o Sonnet 5.5, por isso a vantagem de contexto longo que o Kimi costumava ter sobre os modelos de topo fechados estreitou-se para um empate.
Entrada multimodal e raciocínio sempre ativo
O K3 aceita texto, imagens e vídeo, o que o empurra para além da linha K2, centrada em texto, para território verdadeiramente multimodal. O próprio guia rápido do K3 da Moonshot documenta a entrada de vídeo através da API de ficheiros, e o cartão do modelo reporta 90,0 no Video-MME com legendas. O raciocínio está sempre ligado, e o parâmetro reasoning_effort suporta agora low, high e max, com max por omissão. No lançamento só existia max, por isso os níveis de esforço prometidos chegaram entretanto.
Como o Kimi K3 se sai nos benchmarks
Vivem aqui duas perguntas distintas. O que dizem os quadros independentes sobre o Kimi K3, e o que afirma a própria bateria de avaliação da Moonshot? O quadro independente só chegou depois do lançamento, por isso é o melhor ponto de partida, e os números do fornecedor fazem mais sentido depois de o ter visto.
O que dizem os quadros independentes
A Artificial Analysis pontua agora o Kimi K3 em 43,6 no Intelligence Index v4.3.2, lido na sua página de modelo a 24 de setembro de 2026. A maior parte da queda face aos 57 que este artigo deu inicialmente é um reescalonamento e não um retrocesso, porque o índice passou por v4.2 e v4.3 em setembro e todas as pontuações do quadro desceram com ele. O que mudou mesmo foi a companhia do K3. O Claude Opus 5.5 está em 57,6, o Claude Fable 5.1 em 53,4 e o GPT-6 Astra em 52,7, e entre os open weights o K3 é agora terceiro, atrás do MiMo-V2.6-Pro com 46,3 e do GLM-5.3 com 44,8.
Dois dos números que este artigo citava já não existem. A Artificial Analysis fundiu o seu Agentic Index no índice principal e depois retirou de vez o Coding Index, por isso nenhum dos dois compostos pode ser atualizado. O que sobra é velocidade e custo, e ambos continuam a jogar contra o K3. A Artificial Analysis regista-o em cerca de 37 tokens por segundo, contra 54 do Claude Opus 5 e 116 do GPT-6 Sol, o que faz dele o modelo mais lento do grupo de fronteira. Cobra $2.00 por tarefa do Intelligence Index, contra $5.98 do Opus 5.5 e $0.13 do MiMo-V2.6-Pro.
No quadro WebDev da Arena, onde humanos votam às cegas em front ends gerados, o K3 está agora em 1659,6 com 13 252 votos, lido a 24 de setembro de 2026. É o nono geral e o primeiro entre os modelos de open weights. As oito entradas acima dele são todas fechadas: o Claude Opus 5.5 com 1818,4, o GPT-6 Astra com 1792,2, o Claude Fable 5.1 com 1754,7, duas definições de esforço do Claude Opus 5, o GPT-6 Sol com 1685,9 e dois instantâneos do Qwen3.8 Max. O K3 detinha o primeiro lugar isolado no lançamento, por isso este é um quadro em que o ultrapassaram, não um de que tenha caído.
O quadro Agent da Arena, que classifica o quão bem os modelos orquestram ferramentas em tarefas reais, publica agora também uma posição global, e coloca o Kimi K3 em oitavo com +0,062, à cabeça do campo aberto e à frente do Hy4 Preview da Tencent, do DeepSeek V4.1 Flash e das duas entradas GLM. Os cinco sinais subjacentes merecem leitura separada: o K3 é quinto na conclusão de tarefas, o sinal que diz se o trabalho ficou mesmo feito, mas décimo sétimo na dirigibilidade e décimo nono na recuperação depois de um comando de shell falhado. No quadro geral de texto fica em 17.º de 125, com 1484,8 pontos em 20 987 votos. O MiMo-V2.6-Pro, o modelo que agora o supera no índice, não tem um único voto na Arena.
Os benchmarks de programação da própria Moonshot
A Moonshot publicou esta bateria no lançamento, em julho de 2026, comparando o Kimi K3 com o Claude Fable 5, o GPT-5.6 Sol, o Claude Opus 4.8, o GPT-5.5 e o GLM-5.2, todos com esforço máximo de raciocínio. Leia-a como um retrato de julho: todos os modelos fechados que lá estão foram entretanto substituídos, e a linha do Terminal-Bench é a versão 2.1, que o setor trocou pela bem mais dura 4.0. São além disso execuções do próprio fornecedor, com o K3 avaliado no harness do Kimi Code em várias linhas, por isso trate-as como afirmações da Moonshot e não como resultados independentes.
| Benchmark | Kimi K3 | Fable 5 | GPT-5.6 Sol | Opus 4.8 | GPT-5.5 | GLM-5.2 |
|---|---|---|---|---|---|---|
| DeepSWE | 67.5 | 70.0 | 73.0 | 59.0 | 67.0 | 46.2 |
| ProgramBench | 77.8 | 76.8 | 77.6 | 71.9 | 70.8 | 63.7 |
| Terminal-Bench 2.1 | 88.3 | 88.0 | 88.8 | 84.6 | 83.4 | 82.7 |
| FrontierSWE | 81.2 | 86.6 | 71.3 | 66.7 | 64.9 | 67.3 |
| SWE-Marathon | 42.0 | 35.0 | 39.0 | 40.0 | 14.0 | 13.0 |
| Kimi Code Bench 2.0 | 72.9 | 76.9 | 64.8 | 71.7 | 69.0 | 64.2 |
Lendo isto de forma direta, o Kimi K3 vence o ProgramBench e o SWE-Marathon de forma clara e fica a menos de meio ponto do líder no Terminal-Bench 2.1. No FrontierSWE fica em segundo atrás do Fable 5, mas bem à frente de tudo o resto. As próprias notas de rodapé da Moonshot acrescentam uma ressalva que vale a pena carregar: o Claude Fable 5 acionou salvaguardas de segurança em 35% das tarefas do SWE-Marathon nessa avaliação, o que pode ter puxado a sua pontuação para baixo.
Benchmarks de trabalho agentivo e de conhecimento
| Benchmark | Kimi K3 | Fable 5 | GPT-5.6 Sol | Opus 4.8 | GLM-5.2 |
|---|---|---|---|---|---|
| BrowseComp | 91.2 | 88.0 | 90.4 | 84.3 | n/d |
| MCPMark-Verified | 94.5 | 87.4 | 92.9 | 76.4 | n/d |
| GDPval-AA v2 (Elo) | 1,686 | 1,747 | 1,736 | 1,593 | 1,510 |
| AA-Briefcase (Elo) | 1,548 | 1,583 | 1,495 | 1,354 | 1,260 |
| JobBench | 54.3 | 57.4 | 45.4 | 48.4 | 43.4 |
| SpreadsheetBench 2 | 34.8 | 34.7 | 32.4 | 31.6 | 28.1 |
| AutomationBench | 30.8 | 29.1 | 29.7 | 27.2 | 12.9 |
| OSWorld 2.0 | 58.3 | 66.1 | 62.6 | 55.7 | n/d |
O Kimi K3 lidera o BrowseComp, o MCPMark, o SpreadsheetBench 2 e o AutomationBench, e fica em segundo no AA-Briefcase, o benchmark agentivo de longo horizonte, batendo o GPT-5.6 Sol e ficando apenas atrás do Fable 5. Uma nota de rodapé importa no BrowseComp, que os 91,2 usam uma estratégia de compactação de contexto acionada aos 300K tokens. Corrido com a janela completa de 1M e sem gestão de contexto, o K3 pontua 90,4, que continua a ser o melhor número da coluna.
Em uso de computador, tanto o Fable 5 como o GPT-5.6 Sol batem o K3 no OSWorld 2.0, por isso o modelo aberto não está à frente em toda a linha. Obteve 93,5% no GPQA Diamond, ao nível do GPT-5.5 e à frente dos 91,2 do GLM-5.2, e 94,6 no Harvey Lab-AA, a melhor pontuação dessa linha de qualquer modelo da tabela.
O próprio resumo da Moonshot é mais contido do que foi a cobertura. O seu blogue de lançamento diz que o desempenho geral do K3 “ainda fica atrás dos modelos proprietários mais poderosos, o Claude Fable 5 e o GPT 5.6 Sol”, embora demonstre desempenho de nível de fronteira em toda a bateria. Essa frase continua na página dois meses depois, e os dois modelos que nomeia foram substituídos entretanto, pelo Claude Fable 5.1 e pelo GPT-6 Sol. Quando um laboratório subvaloriza o seu próprio modelo, é normalmente esse o número em que confiar.
Kimi K3 vs Claude Opus 5.5
A comparação que toda a gente faz é Kimi K3 vs Claude, e o lado Claude mexeu-se duas vezes desde que o K3 saiu. A Anthropic lançou o Claude Opus 5 a 24 de julho, razão pela qual a tabela de lançamento da Moonshot acima continua atribuída ao Opus 4.8. Depois, a 22 de setembro, lançou o Claude Opus 5.5 e passou o Opus 5 para a sua lista Legacy. Para uma decisão que tome hoje, o Opus 5.5 é o modelo do outro lado da mesa, e é ao mesmo tempo mais barato e mais forte do que o Opus 5 contra o qual esta comparação foi escrita.
| Modelo | Programador | Contexto | Open weights | Preço API por 1M |
|---|---|---|---|---|
| Kimi K3 | Moonshot AI | 1 048 576 | Sim, Kimi K3 License | $3 / $15 |
| Claude Opus 5.5 | Anthropic | 1M | Não | $4 / $20 |
| Claude Opus 5 (Legacy) | Anthropic | 1M | Não | $5 / $25 |
| Claude Fable 5.1 | Anthropic | 1M | Não | $10 / $50 |
| MiMo-V2.6-Pro | Xiaomi | 1M | Sim, MIT | $0.435 / $0.87 |
| GLM-5.3 | Z.ai | 1M | Sim, GLM 5.3 License | $1.40 / $4.40 |
| Kimi K2.6 | Moonshot AI | 262 144 | Sim, MIT modificada | $0.95 / $4 |
No preço, o K3 continua a ganhar, mas por menos do que antes: $3 / $15 contra $4 / $20 do Opus 5.5, ou seja 25% mais barato onde ficava 40% abaixo do Opus 5, e contra $10 / $50 do Fable 5.1. Na capacidade medida, a diferença foi para o lado oposto, de quatro pontos para catorze no Artificial Analysis Intelligence Index, e o Opus 5.5 lidera o quadro WebDev da Arena por 159 pontos. A Anthropic não publica valor de SWE-bench para nenhum dos dois Opus, por isso quem lhe citar um não o está a citar da Anthropic.
A verdadeira diferença não é a pontuação, é o que pode ter como seu. O Opus 5.5 é o modelo mais forte e a escolha por omissão mais segura para programação em produção, e a própria documentação da Anthropic diz agora aos programadores para começarem por ele na maioria das cargas de trabalho. O K3 é o que pode descarregar, auditar, afinar e correr dentro da sua própria rede, coisa que nenhum modelo Claude permite a preço nenhum. Se está a escolher entre modelos de topo para um trabalho concreto, o nosso guia sobre quando usar cada modelo de IA destrincha a decisão tarefa a tarefa.
Preços do Kimi K3
A Moonshot já publicou tarifas oficiais, o que reforma as estimativas de terceiros que circularam no lançamento. O preço do Kimi K3 é de $3.00 por milhão de tokens de entrada e $15.00 por milhão de tokens de saída, com a entrada em cache a $0.30, um desconto de 90% que faz muita diferença se estiver sempre a reenviar o mesmo contexto longo. O K3 cobra também a própria escrita em cache, $3.00 por uma entrada de cinco minutos ou $6.00 por uma de uma hora, coisa que os modelos K2 não fazem.
| Modelo | Entrada (falha de cache) | Entrada (acerto de cache) | Saída | Contexto |
|---|---|---|---|---|
| kimi-k3 | $3.00 | $0.30 | $15.00 | 1 048 576 |
| kimi-k2.7-code | $0.95 | $0.19 | $4.00 | 262 144 |
| kimi-k2.7-code-highspeed | $1.90 | $0.38 | $8.00 | 262 144 |
| kimi-k2.6 | $0.95 | $0.16 | $4.00 | 262 144 |
Essas tarifas já não coincidem com o Claude Sonnet 5.5, que é de $2 na entrada e $10 na saída, por isso o K3 fica 50% mais caro nas duas metades da fatura, e desde o lançamento do Sonnet 5.5 a 28 de setembro o Sonnet também pontua acima dele no Artificial Analysis Intelligence Index, 56,0 contra 43,6. Face aos outros dois modelos Claude que o superam, o K3 continua 25% mais barato do que o Opus 5.5 e 70% mais barato do que o Fable 5.1. A pesquisa na web também mudou de forma. A Moonshot passou-a para endpoints REST autónomos em setembro e fatura só as chamadas bem-sucedidas, a $0.002 no Web Search Basic, $0.003 no Web Search Pro e $0.002 no URL Fetch.
O K3 é um salto claro de custo face à linha K2, o que reflete a sua pegada maior e o raciocínio sempre ligado. Se a sua carga de trabalho não precisa de escala de fronteira, o K2.6 ou o K2.7 Code continuam muito mais baratos, e o kimi-k2.5 já não é opção: a Moonshot descontinuou-o juntamente com toda a série moonshot-v1 a 31 de agosto de 2026, e as chamadas a esses modelos devolvem agora um 404. Na plataforma de API, o K3 fica disponível assim que fizer um carregamento bem-sucedido de pelo menos $1, $5 acumulados dão um vale de $5, e o seu carregamento acumulado define os seus limites de utilização. A nossa análise completa dos preços do Kimi compara cada plano e tarifa de API lado a lado.
A procura ultrapassou o hardware da Moonshot quase de imediato. A 19 de julho de 2026, três dias depois do lançamento, a empresa suspendeu novas subscrições do Kimi, dizendo que a procura nas 48 horas anteriores tinha “empurrado para perto dos limites da nossa capacidade atual” e que iria “reabrir novos lugares de subscrição por lotes” à medida que acrescentasse hardware, numa declaração publicada pelo South China Morning Post. Os subscritores existentes mantiveram o acesso, e essa mesma publicação prometia dividir a adesão em Kimi Membership para a web, a app e o Work, e Kimi Code Membership para programação. O desconto de carregamento de lançamento que a Moonshot encurtou pela mesma razão desapareceu da documentação de preços. O que a documentação regista em vez disso, com data de setembro de 2026, é uma mudança de faturação: o consumo passa a ser descontado em partes iguais, 50% de saldo e 50% de vales.
Como usar o Kimi K3
Há quatro formas de chegar ao Kimi K3 agora que os pesos são públicos, e qual delas encaixa depende de querer uma janela de conversa, um agente de terminal, uma API ou os ficheiros em bruto. Eis a ordem prática.
- Aplicação Kimi e Playground. O caminho mais rápido é a aplicação Kimi ou o Playground web, onde o K3 é selecionável para utilizadores com sessão iniciada. Esta é a opção sem código para testar o modelo com os seus próprios prompts.
- Kimi Code CLI. A Moonshot diz que o K3 funciona melhor dentro do seu próprio agente de terminal, onde escolhe o modelo com o comando
/model. O K3 também se integra no Codex CLI, no Claude Code, no OpenCode e no Hermes Agent através das integrações documentadas da Moonshot. - A API. Os programadores chamam o
kimi-k3através da plataforma da API do Kimi, que oferece endpoints compatíveis com a OpenAI e com a Anthropic. Suporta chamada de ferramentas, saída estruturada por JSON-schema, cache de contexto e o controlo reasoning_effort, e o K3 também está listado em agregadores como o OpenRouter. - Open weights. O checkpoint completo está na Hugging Face sob a Kimi K3 License, e a Moonshot recomenda o vLLM, o SGLang ou o TokenSpeed para o servir. Conte com o descarregamento de 1,56 TB e com o hardware multinó de que precisa.
Prefere não andar a fazer malabarismo com uma subscrição separada para cada novo modelo? Aplicações como o Fello põem os poderosos modelos de IA atuais num só lugar, o que ajuda enquanto um lançamento como este assenta. Para uma visão mais ampla do campo aberto, a nossa síntese dos melhores modelos de IA open source disponíveis agora coloca a linhagem do K3 em contexto. Se está a pesar especificamente os modelos abertos chineses, a nossa explicação sobre o que é o GLM e como compete é um bom complemento.
O negócio por trás da Moonshot AI
O Kimi K3 chega num momento decisivo para a Moonshot AI, a startup de Pequim fundada em 2023 por Yang Zhilin. Em julho noticiou-se que a empresa estava a angariar entre 1 e 2 mil milhões de dólares numa avaliação de até 31,5 mil milhões, cerca de 50% acima dos 20 mil milhões que atingiu em maio e perto de sete vezes o que valia em dezembro de 2025. Esse número já foi ultrapassado. A Reuters noticiou a 3 de setembro de 2026 que a Moonshot tinha apresentado de forma confidencial um pedido de entrada em bolsa em Hong Kong, com o objetivo de angariar 3 mil milhões de dólares numa avaliação de 50 mil milhões de dólares numa ronda a decorrer, com o Goldman Sachs, o CICC e o Deutsche Bank. É a entrada em bolsa que o TechNode tinha sinalizado em julho como possível dentro de seis meses, e a Moonshot recusou comentar o pedido.
A estratégia de open source é central para o ímpeto. Quando a Moonshot abriu o código do Kimi K2.6 em abril de 2026, subiu a segundo grande modelo de linguagem mais usado no OpenRouter em meados de 2026. Isso colocou um laboratório fundado três anos antes à frente da maioria dos laboratórios de fronteira ocidentais nas tabelas de utilização independentes. Lançar os pesos do K3 estende esse manual a um modelo de classe de fronteira.
O momento não foi acidental. O Kimi K3 chegou mesmo antes da Conferência Mundial de Inteligência Artificial de 2026 em Xangai, onde se esperava que o Presidente chinês Xi Jinping traçasse as prioridades de IA de Pequim. Dias depois, nessa mesma conferência, a Alibaba mostrou uma pré-visualização do Qwen 3.8, o seu próprio rival de 2,4 biliões de parâmetros. A reação no Ocidente foi uma mistura de espanto e alarme, com observadores a notar que a China parece estar a fechar aquilo que já foi uma confortável dianteira americana.
Porque é que o Kimi K3 importa
O Kimi K3 não é apenas mais um lançamento de modelo. Com os pesos públicos, é o maior modelo de open weights alguma vez lançado, entregando aos programadores capacidade à escala de fronteira que podem descarregar, inspecionar e correr eles próprios. Isso é um desafio direto aos modelos de topo fechados e de preço premium que definiram o topo do mercado.
A distância que fecha é mais estreita do que o título sugere e mais larga do que parece.
Catorze pontos no Artificial Analysis Intelligence Index separam agora o K3 do Claude Opus 5.5, e 2,7 pontos separam o K3 do modelo aberto que o ultrapassou em setembro. Há dois meses a primeira diferença era de quatro pontos e a segunda ia no sentido contrário. O campo fechado mexeu-se mais durante o verão do que o campo aberto, e o campo aberto ainda trocou de líder.
O contexto de negócio torna a ambição clara. A família Kimi da Moonshot terá passado os 300 milhões de dólares em receita recorrente anualizada em meados de junho e, segundo a reportagem de lançamento da TechCrunch, a empresa angariava então capital novo numa avaliação noticiada de 31,5 mil milhões de dólares. Dois meses depois, essa mesma ronda é noticiada em 50 mil milhões, com um pedido de entrada em bolsa atrás. Um laboratório bem financiado que lança um modelo aberto gigante a preços agressivos é exatamente o tipo de pressão que reconfigura o que todos os outros cobram. Para ver a que velocidade se move o lado fechado, o nosso guia sobre o GPT-6 Sol e o Luna é um contraponto útil.
Em resumo
O Kimi K3 cumpriu o que prometeu. Os pesos são públicos, a licença é viável para quase toda a gente que os vá mesmo usar, e o preço é oficial e baixo. O que não se aguentou foi a coroa. A Artificial Analysis já não lhe chama o modelo aberto mais forte que existe e coloca acima dele o MiMo-V2.6-Pro da Xiaomi e o GLM-5.3 da Z.ai, ao passo que os votantes humanos da Arena continuam a pôr o K3 em primeiro entre os modelos abertos nos dois quadros que o viram. O melhor modelo que existe nunca foi, e a própria Moonshot di-lo.
A nossa recomendação: use o K3 quando o que precisa são open weights, custo ou um contexto de um milhão de tokens, e quando quer um modelo aberto com um historial a sério por trás em vez de uma pontuação de benchmark com dias. Mantenha o Claude Opus 5.5 à mão para a programação de produção mais difícil, onde lidera todos os quadros independentes que avaliaram os dois. Se quer a versão prática desse compromisso, a nossa análise do Claude Opus 5.5 cobre o que o lado fechado oferece hoje por $4 por milhão de tokens de entrada.
O Kimi K3 merece uma comparação direta. Com o Fello AI, pode correr o Kimi ao lado do Claude, do GPT-6, do Gemini, do DeepSeek e do Perplexity numa só app nativa para Mac, iPhone e iPad. Envie a mesma tarefa de programação ou pesquisa a todos os modelos de fronteira ao mesmo tempo e veja qual ganha mesmo no seu trabalho, sem andar a fazer malabarismo com contas separadas. Quando chega um modelo aberto tão capaz, a forma mais rápida de o julgar é um teste lado a lado. No Mac é um cliente de secretária nativo do Kimi, por isso o K3 abre como qualquer outra app. Para ver como o K3 se compara com os modelos de cada plano do ChatGPT, consulte Kimi vs ChatGPT.
FAQ
Os open weights do Kimi K3 estão disponíveis?
Sim. A Moonshot publicou os pesos completos do Kimi K3 na Hugging Face a 27 de julho de 2026, onze dias após o lançamento. O repositório contém 96 fragmentos safetensors, cerca de 1,56 TB no total, disponibilizados sob a Kimi K3 License personalizada.
O Kimi K3 é open source?
É de open weights e não open source no sentido estrito. A Kimi K3 License permite uso, modificação, distribuição e venda comercial. Um negócio de model-as-a-service que ganhe mais de 20 milhões de dólares em quaisquer 12 meses precisa de um acordo separado, e os produtos com mais de 100 milhões de utilizadores mensais têm de creditar o Kimi K3 no ecrã.
Quantos parâmetros tem o Kimi K3?
O Kimi K3 tem 2,8 biliões de parâmetros totais num design Mixture-of-Experts, dos quais 104 mil milhões ativam por token. A Moonshot chama-lhe o primeiro modelo aberto de classe 3B do mundo, e o cartão do modelo confirma ambos os valores.
O Kimi K3 é melhor do que o Claude Opus 5?
Na capacidade medida não, e em setembro a diferença aumentou. No Artificial Analysis Intelligence Index v4.3.2, o Claude Opus 5 pontua 50,8 e o seu substituto Claude Opus 5.5 pontua 57,6, contra 43,6 do Kimi K3, e ambos ficam acima do K3 no quadro WebDev da Arena. O K3 ganha no preço, com $3 e $15 por milhão de tokens contra $5 e $25 do Opus 5 e $4 e $20 do Opus 5.5, e é o único dos três que pode descarregar e correr por si.
Quanto custa o Kimi K3?
O preço oficial da API é de $3.00 por milhão de tokens de entrada e $15.00 por milhão de tokens de saída, descendo para $0.30 por milhão na entrada em cache, com a escrita em cache faturada a $3.00 ou $6.00 conforme o tempo de vida da entrada. A pesquisa na web passou para endpoints autónomos em setembro de 2026 e fatura as chamadas bem-sucedidas entre $0.002 e $0.003, e o modelo fica disponível na plataforma de API depois de um carregamento de pelo menos $1.