Meilleure IA en 2026 : le classement des modèles d'IA
Classement et tableau comparatif des IA par usage, mis à jour chaque mois à mesure que de nouveaux modèles arrivent.
- Le plus intelligent et le meilleur pour coderClaude Opus 5.5
- Raisonnement le plus arduGPT-6 Astra
- ImagesChatGPT Images 2.5
- Meilleur choix gratuitClaude Sonnet 5.5
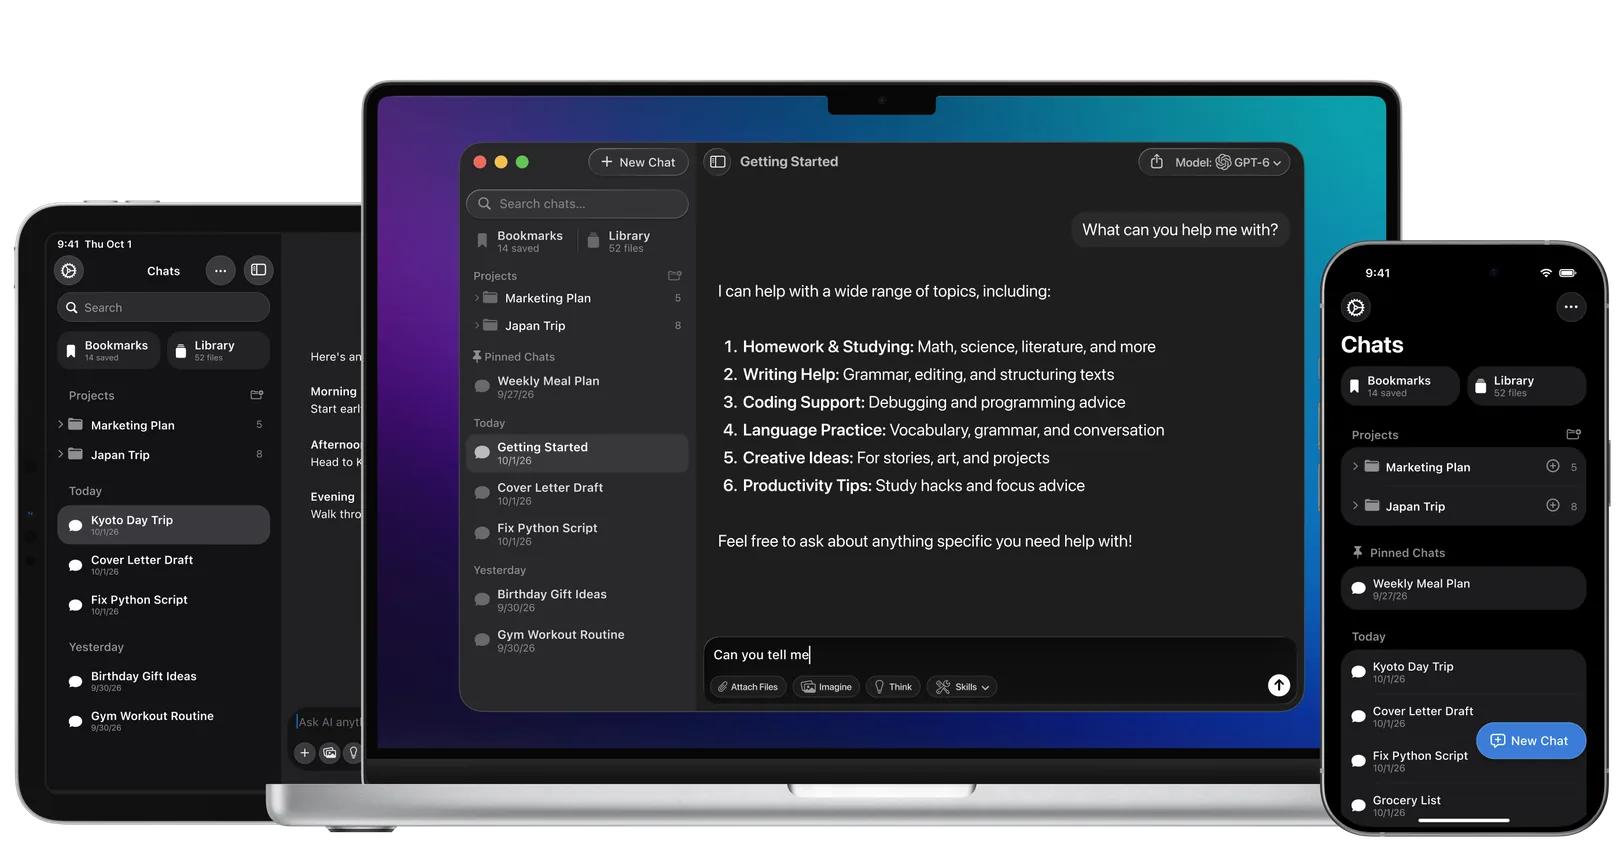
Arrêtez de jongler entre les apps d'IA
Chat, recherche, PDF et images dans une seule app pour Mac, iPhone et iPad.
Gratuit pour démarrer·4,7★ sur plus de 27 000 avis
Les classements montrent qui gagne en moyenne. Votre prompt, lui, n’est pas moyen. Posez la question à ChatGPT, Claude et Gemini dans une seule fenêtre et gardez la meilleure réponse.
Télécharger Fello AIAnthropic détient ce mois-ci la plupart des couronnes mesurées. Claude Opus 5.5 (22 septembre) est #1 de l'Intelligence Index à 57,6 et du classement WebDev d'Arena, Claude Sonnet 5.5 (28 septembre) est deuxième à 56,0 et gratuit sur claude.ai, et Claude Haiku 5.5 (7 octobre) complète la famille à 0,10 $ / 0,50 $. Notre guide des benchmarks d'IA explique comment cet indice est construit.
Gemini 4 Argon de Google (30 septembre) obtient 52,6, à égalité avec GPT-6 Astra, et arrive premier du classement texte d'Arena, et depuis le 13 octobre il est ouvert aux abonnés Google AI Pro et Ultra et dans l'API payante, ce qui le place deuxième sur le podium du chat, mais il ne remporte aucune catégorie : EQ-Bench, LiveBench et ARC Prize ne l'ont pas encore évalué. OpenAI mise sur le prix : GPT-6 Sol et Luna ont divisé ses tarifs d'API par deux, et GPT-6.1 Sol (29 septembre) obtient 51,8 à 2 $ / 10 $, le modèle le moins cher du peloton de tête par tâche de l'indice.
Le Muse Wonder de Meta (12 octobre) est le dernier venu de la frontière : Muse Wonder Full obtient 55,8, troisième derrière les deux modèles Claude, mais ne tourne que dans l'abonnement Muse Code de Meta, et Muse Wonder dans l'API obtient 52,4 au même prix qu'Opus 5.5, 4 $ / 20 $. Grok 4.7 (21 septembre) est arrivé dans l'API à 2 $ / 6 $ inchangés, et le MiMo-V2.6-Pro de Xiaomi reste le modèle ouvert le mieux noté, à 46,3. Le 6 octobre, Mistral a publié Mistral Large 4 et Google a lancé Nano Banana 2.1 ; aucun ne prend de couronne, mais la vidéo passe à MiniMax H3. Nous mettons les classements à jour dans les 48 heures suivant chaque grand lancement.
13 oct. Google Gemini 4 Argon s'ouvre à Google AI Pro, Ultra et à l'API payante, et prend la deuxième place du podium du chat Nouveau
12 oct. Muse Wonder Full arrive troisième sur l'Intelligence Index, mais uniquement dans l'abonnement Muse Code de Meta Nouveau
7 oct. Anthropic Claude Haiku 5.5 obtient 43,4 au prix de GPT-6 Luna, et toutes les offres Claude peuvent le choisir, y compris la gratuite Nouveau
6 oct. Mistral Mistral Large 4 est le modèle le plus puissant des États-Unis ou d'Europe à promettre des poids ouverts, mais il n'est pas encore téléchargeable Nouveau
6 oct. Google Nano Banana 2.1 remplace Nano Banana 2 pour moitié moins cher par image et arrive cinquième sur Arena texte-vers-image Nouveau
30 sept. Google Gemini 4 Argon prend la tête du classement texte d'Arena et égale GPT-6 Astra sur l'Intelligence Index, mais seuls des cyberdéfenseurs peuvent l'utiliser Nouveau
29 sept. OpenAI GPT-6.1 Sol se classe cinquième de l'Intelligence Index à 2 $ / 10 $, le moins cher par tâche du peloton de tête Nouveau
28 sept. Anthropic Claude Sonnet 5.5 se classe deuxième de l'Intelligence Index à 56,0, au prix Sonnet de 2 $ / 10 $ Nouveau
22 sept. OpenAI GPT-6 Sol et GPT-6 Luna divisent par deux les tarifs d'API d'OpenAI et arrivent partout sauf dans le chat de ChatGPT Nouveau
22 sept. Anthropic Claude Opus 5.5 prend l'Intelligence Index à 57,6 et passe sous le prix d'Opus 5 Nouveau
21 sept. SpaceXAI Grok 4.7 arrive sur un modèle de base plus grand à 2 $ / 6 $ inchangés et coûte 47 % de plus par tâche Nouveau
21 sept. Xiaomi Le MiMo-V2.6-Pro de Xiaomi est le modèle ouvert le mieux noté jamais mesuré, à 0,13 $ par tâche sous licence MIT Nouveau
20 sept. Alibaba Qwen-Image-2.1 est le meilleur modèle d'image téléchargeable, mais sa licence n'autorise que la recherche Nouveau
15 sept. TypeSafe TypeSafe sort de la furtivité avec Jev, un modèle qui renvoie des décisions typées au lieu de texte, à 0,042 $ par 1M de tokens Nouveau
En attente Google Gemini 3.5 Pro, toujours pas sorti, et Gemini 4 Argon l'a devancé Retardé
Meilleure IA pour l'écriture
La meilleure IA pour l'écriture est Claude Fable 5.1, et l'argument en sa faveur est la régularité plutôt qu'une première place unique.
Il figure dans les dix premiers des trois classements de prose : deuxième sur EQ-Bench Creative Writing v3 à 2162,0, troisième sur LiveBench Language à 89,5 et neuvième sur le classement d'écriture créative d'Arena. Aucun autre modèle ne se classe aussi bien sur les trois. Gemini 4 Argon mène désormais les classements écriture créative et texte d'Arena, à 1519,2 et 1525,4, et les abonnés Google AI Pro peuvent l'utiliser depuis le 13 octobre, mais ni EQ-Bench ni LiveBench ne l'ont encore évalué.
Claude Opus 5.5 est deuxième du classement d'écriture créative d'Arena à 1517, mais septième sur EQ-Bench et dixième sur LiveBench Language ; GPT-6 Astra mène EQ-Bench à 2173,3 mais n'est que 42e sur le classement d'écriture créative d'Arena ; Claude Fable 5 domine LiveBench Language à 90,7 et est troisième du classement d'écriture créative d'Arena, mais onzième sur EQ-Bench. Si votre écriture est un livrable professionnel plutôt que de la prose, le classement des livrables professionnels GDPval-AA v2.1 pose une autre question, et Claude Opus 5.5 le mène à 1866, devant le nouveau Muse Wonder Full de Meta à 1857, Claude Sonnet 5.5 à 1838 et Claude Fable 5.1 à 1756.
Claude Sonnet 5.5 est le choix rapport qualité-prix de l'offre gratuite, puisque tout le monde peut l'utiliser sur claude.ai, même s'il n'obtient que 83,4 sur LiveBench Language, n'est que 24e sur le classement d'écriture créative d'Arena et n'a pas encore de note EQ-Bench. Claude Fable 5 est le choix si vous accordez plus de poids aux votes humains d'Arena qu'aux scores des harnesses ; il coûte 10 $ / 50 $ par million de tokens et est inclus de façon permanente dans Claude Max et Team Premium à environ 50 % des limites d'usage habituelles. La traduction est une question distincte avec un gagnant distinct, que nous détaillons dans notre guide de la meilleure IA pour la traduction.
| Modèle | Idéal pour | Force | Faiblesse | Prix (par 1M de tokens) |
|---|---|---|---|---|
| Claude Fable 5.1 | Meilleure écriture globale | #2 EQ-Bench Creative Writing (2162,0), #3 LiveBench Language (89,5) et #9 écriture créative Arena, le meilleur classement combiné de tous | N'en domine aucun des trois ; Gemini 4 Argon mène désormais l'écriture créative d'Arena, devant Claude Opus 5.5 | 10 $ / 50 $ |
| Claude Fable 5 | Solide sur les classements de votes humains | #1 LiveBench Language (90,7), #3 écriture créative Arena (1501,5), #4 Arena texte (1503,7) | #11 EQ-Bench ; l'option la plus chère ici | 10 $ / 50 $ |
| Kimi K3 | Fiction créative et voix | #5 EQ-Bench Creative Writing (2082,3) | Seulement #28 sur Arena écriture créative | 3 $ / 15 $ |
| Claude Sonnet 5.5 | Écriture gratuite au quotidien | Gratuit sur claude.ai, contexte 1M ; #3 GDPval-AA v2.1 (1838), derrière Opus 5.5 et Muse Wonder Full | 83,4 LiveBench Language ; #24 écriture créative Arena ; pas encore évalué sur EQ-Bench | 2 $ / 10 $ |
| Claude Opus 5.5 | Le mieux classé en écriture créative sur Arena parmi les modèles disponibles | #2 écriture créative Arena (1517) et #2 Arena texte (1507) ; #1 GDPval-AA v2.1 (1866) | #7 EQ-Bench et #10 LiveBench Language | 4 $ / 20 $ |
| Gemini 4 Argon | La prose la mieux notée sur Arena | #1 écriture créative Arena (1519,2) et #1 Arena texte (1525,4) | Non évalué sur EQ-Bench ni LiveBench | 19,99 $/mois Google AI Pro ; 2 $ / 10 $ API au lancement jusqu’au 30/11 |
| GPT-5.5 | Écriture professionnelle ancrée dans les faits | Gains documentés de fiabilité factuelle sur GPT-5.4 | Les paliers de raisonnement sont désormais marqués obsolètes | 5 $ / 30 $ |
| Gemini 3.8 Flash | Brouillons en masse à grande échelle | Intelligence Index 40,9, 308,4 tok/s en sortie, contexte 1M | Réglé pour les agents plutôt que la prose ; le tarif introductif double le 1er janvier 2027 | 0,75 $ / 3,75 $ |
La couronne de l'écriture reste à Claude Fable 5.1, mais son avance sur Arena s'est réduite. Gemini 4 Argon de Google, annoncé le 30 septembre, a pris d'emblée la première place du classement d'écriture créative d'Arena à 1519,2, repoussant Claude Opus 5.5 à la deuxième place et Claude Fable 5 à la troisième, et Fable 5.1 a glissé de la septième à la dixième avant de remonter à la neuvième, si bien que cette carte revendique désormais le top dix des trois classements de prose plutôt que le top sept. Argon ne peut pas encore prendre la couronne : depuis le 13 octobre, les abonnés Google AI Pro et Ultra peuvent l'utiliser, mais EQ-Bench et LiveBench ne l'ont toujours pas évalué. En septembre, Claude Opus 5.5 et Claude Sonnet 5.5 sont arrivés, Sonnet 5.5 a remplacé Sonnet 5 comme choix gratuit, et GPT-6.1 Sol est entré deuxième sur LiveBench Language, repoussant Fable 5.1 à la troisième place.
Meilleure IA pour le chat & l'assistant du quotidien
La meilleure IA pour le chat du quotidien est GPT-6, et la raison honnête tient à la portée plutôt qu'à la position dans les classements. Depuis le 7 octobre, c'est avec lui que ChatGPT répond par défaut : GPT-6 Sol sur Plus, Pro, Business et Enterprise, et GPT-6 Luna sur Free et Go, en cours de déploiement depuis le 8 octobre. C'est donc l'assistant que la plupart des gens peuvent réellement ouvrir.
En pure préférence humaine, il est loin de la tête. GPT-6 Sol est #67 du classement texte d'Arena à 1455,9, sous son prédécesseur GPT-5.6 Sol, #20, tandis que Gemini 4 Argon mène à 1525,4 et que Claude Opus 5.5 est deuxième à 1507,1. Artificial Analysis donne à GPT-6 Sol 47,6 sur l'Intelligence Index v4.3.2 à effort maximal et à GPT-6 Luna 38,1. Dans l'API, Sol coûte 2 $ / 10 $ et Luna 0,10 $ / 0,50 $ par million de tokens.
| Modèle | Idéal pour | Force | Faiblesse | Prix |
|---|---|---|---|---|
| GPT-6 | Chat du quotidien, par défaut de ChatGPT | L'assistant que la plupart peuvent ouvrir : Sol sur les offres payantes, Luna sur Free et Go | GPT-6 Sol seulement #67 sur Arena texte | Gratuit / 20 $/mois Plus ; API 0,10 $ / 0,50 $ (Luna) à 2 $ / 10 $ (Sol) |
| Gemini 4 Argon | La conversation la mieux notée | #1 sur Arena texte (1525,4) ; taux d'hallucination de 15 %, le plus bas parmi les modèles de pointe | Note Arena encore provisoire ; Google AI Pro ou plus dans l'app Gemini | 19,99 $/mois Google AI Pro ; 2 $ / 10 $ API au lancement jusqu’au 30/11 |
| Claude Opus 5.5 | La conversation au meilleur score | #1 sur l'Intelligence Index (57,6) et #2 sur Arena texte (1507,1) | Absent de la formule Free ; limites d'usage sur Pro | 20 $/mois Pro, 4 $ / 20 $ API |
| Claude Sonnet 5.5 | Chat Claude gratuit | Gratuit sur claude.ai ; #2 sur l'Intelligence Index (56,0), derrière le seul Claude Opus 5.5 | Seulement #32 sur Arena texte ; tourne par défaut à l'effort Medium dans les applications | Gratuit / 20 $/mois Pro, 2 $ / 10 $ API |
| GPT-5.5 Instant | Travail quotidien sensible aux hallucinations | 52,5 % d'affirmations hallucinées en moins vs 5.3 Instant | Les paliers de raisonnement sont désormais marqués obsolètes | 20 $/mois Plus ; API 5 $ / 30 $ |
| Gemini 3.6 Flash | Rapide, bon marché, multimodal | Contexte 1M, #23 sur Arena texte | Exige Google AI Plus dans l'application Gemini depuis le 9 octobre ; 3.8 Flash le surclasse au même prix | AI Plus / 0,75 $ / 3,75 $ API |
| Fello AI | De nombreux modèles de pointe, une seule app | ChatGPT + Claude + Gemini + Grok + DeepSeek et plus sur Mac, iPhone et iPad | Acheminé via l'app, pas en direct | À partir de 11,99 $/mois |
Le choix pour le chat passe de GPT-5.6 à GPT-6, pour la même raison qui le lui avait valu : le 7 octobre, OpenAI a fait de GPT-6 le modèle par défaut de ChatGPT, Sol sur les offres payantes et Luna sur Free et Go à partir du 8 octobre. Les classements fondés sur les votes le placent sous son prédécesseur, GPT-6 Sol #67 sur Arena texte contre #20 pour GPT-5.6 Sol, et c'est pourquoi ce choix repose sur la portée. Depuis le 13 octobre, Gemini 4 Argon est dans l'application Gemini pour les abonnés Google AI Pro et Ultra, si bien que le premier du classement texte d'Arena, à 1525,4, prend la deuxième place du podium ; Claude Opus 5.5 passe troisième et Claude Sonnet 5.5 reste dans le tableau comme choix pour Claude gratuit.
Meilleure IA pour générer des images
La meilleure IA pour générer des images est ChatGPT Images 2.5, qu'OpenAI a rendu par défaut sur toutes les formules ChatGPT le 8 septembre et qui mène les quatre classements d'images que nous suivons.
Ses deux modèles finissent premier et deuxième sur chacun : GPT-Image-2.5 Sunburst, conçu pour la précision, mène Arena texte-vers-image à 1424,6 et l'édition d'images d'Arena à 1523,6, et chez Artificial Analysis AA-Image-T2I v2.0 à 1197 et AA-Image-Editing v2.0 à 1182, le plus rapide GPT-Image-2.5 Flare étant deuxième sur les quatre. Considérez l'écart entre Sunburst et Flare sur Arena texte-vers-image comme provisoire, car chacun repose sur environ 17 000 votes contre 93 000 pour GPT Image 2. MAI-Image-2.6 est deuxième, troisième sur le classement d'édition d'Artificial Analysis et cinquième sur Arena texte-vers-image à 1332,1, à égalité statistique avec Grok Imagine Image 2.0, juste devant.
Le troisième est Grok Imagine Image 2.0 de SpaceXAI, sorti en août et disponible dans Grok Imagine et via l'API xAI : il est quatrième sur le classement texte-vers-image d'Artificial Analysis, en édition d'images sur Arena et désormais aussi sur Arena texte-vers-image, devant Muse Image de Meta sur trois des quatre classements. Nano Banana 2.1 de Google, sorti le 6 octobre, est désormais le modèle Google le mieux classé : sixième sur Arena texte-vers-image à 1327,8, dans la même fourchette de rangs que MAI-Image-2.6 et Grok Imagine Image 2.0, et sixième en édition sur Arena, mais Artificial Analysis ne l'a pas encore évalué.
Le meilleur modèle d'image que vous pouvez télécharger est Qwen-Image-2.1 d'Alibaba, sorti le 20 septembre et désormais le modèle à poids ouverts le mieux classé sur les quatre classements, 18e en édition d'images sur Arena et sur les deux classements d'Artificial Analysis, et 19e sur Arena texte-vers-image. Sa licence n'autorise toutefois que la recherche et l'évaluation, ce n'est donc pas une option commerciale gratuite. Notre analyse complète de ce qui est sorti se trouve dans ChatGPT Images 2.5.
| Modèle | Idéal pour | Force | Faiblesse | Prix |
|---|---|---|---|---|
| ChatGPT Images 2.5 | Images avec texte lisible | #1 et #2 sur les quatre classements : Arena texte-vers-image (1424,6 / 1397,6), Arena édition (1523,6 / 1481,0), texte-vers-image Artificial Analysis (1197 / 1191) et édition (1182 / 1162) | Son avance sur Arena texte-vers-image repose sur environ 17 000 votes par modèle | Par défaut sur toutes les formules ChatGPT |
| MAI-Image-2.6 | Retoucher une image existante | #3 en édition d'images chez Artificial Analysis (1137) et #5 sur Arena texte-vers-image (1332,1) | Aperçu public, pas encore dans Copilot ni Bing ; a cédé la tête de l'édition chez Artificial Analysis à ChatGPT Images 2.5 | MAI Playground / Microsoft Foundry |
| Grok Imagine Image 2.0 | Le moins de restrictions, mode Spicy | #4 en texte-vers-image chez Artificial Analysis (1155) et #4 en édition d'images sur Arena (1439,1) ; #4 sur Arena texte-vers-image (1333,5) | Seulement #10 en édition d'images chez Artificial Analysis | 30 $ par mois SuperGrok ; API xAI |
| Nano Banana 2.1 | Le modèle d'image de Google pour tous les jours | #6 Arena texte-vers-image (1327,8) et #6 en édition d'images sur Arena (1428,1), le meilleur de tous les modèles Google ; dans l'API, la moitié du prix par image de Nano Banana 2 | Pas encore évalué par Artificial Analysis ; les tokens d'entrée coûtent trois fois plus que sur Nano Banana 2 | Application Gemini / AI Studio ; 0,0336 $ par image 1K |
| Seedream 5.0 Pro | Texte multilingue + édition par régions | 10+ langues dont l'arabe RTL, édition au lasso et par calques | Autour de la dixième place sur les classements indépendants ; incertitude sur les droits d'auteur | BytePlus / Magnific |
| Midjourney v8 | Art stylisé, illustration | Base esthétique que la plupart des artistes préfèrent | Plus faible sur le texte dans l'image | 10-120 $/mois |
| Qwen-Image-2.1 | Meilleur modèle d'image téléchargeable | Modèle à poids ouverts le mieux classé sur les quatre classements : #18 édition d'images Arena (1368,7), #19 Arena texte-vers-image (1222,9) et #18 sur les deux classements d'Artificial Analysis ; générateur de 7B, PNG transparents, jusqu'à 10 images de référence | Qwen Research License, recherche ou évaluation uniquement, pas d'usage commercial | Téléchargement gratuit (Hugging Face) |
| Qwen-Image-3.0-Pro | Mises en page denses et chargées de texte | #13 Arena texte-vers-image (1255,2) et #14 texte-vers-image chez Artificial Analysis (1090) ; prompts jusqu'à 4500 tokens, texte en 12 langues | Hébergé uniquement, sans poids ; non évalué en édition d'images sur Arena | Qwen Chat ; 0,04-0,075 $ par image dans l'API |
| Muse Image | Édition d'images, écosystème Meta | #6 en édition d'images chez Artificial Analysis (1118) et #7 sur son classement texte-vers-image | Hors du podium ; #9 sur Arena texte-vers-image et #8 en édition Arena | Application Meta AI |
ChatGPT Images 2.5 garde la couronne de l'image et occupe toujours les deux premières places des quatre classements que nous suivons. Depuis la dernière mise à jour, Google a sorti Nano Banana 2.1 le 6 octobre, et Arena l'a classé cinquième en texte-vers-image et sixième en édition, le meilleur de tous les modèles Google, dans la même fourchette de rangs que MAI-Image-2.6 et Grok Imagine Image 2.0. Il reprend la ligne de Nano Banana 2 dans le tableau plutôt qu'une place sur le podium : il est désormais derrière MAI-Image-2.6 et Grok Imagine Image 2.0 sur les deux classements d'Arena, et Artificial Analysis ne l'a pas encore évalué.
Grok Imagine Image 2.0 est depuis remonté à la quatrième place sur Arena texte-vers-image, 1,4 point devant MAI-Image-2.6, cinquième ; Nano Banana 2.1 est désormais sixième et Reve 2.1 septième. En début de mois, Grok Imagine Image 2.0 a pris la troisième place à Muse Image, et Artificial Analysis a fait passer ses deux classements d'images en v2.0. En septembre, Images 2.5 a remplacé GPT Image 2 en tête le 8 septembre.
Meilleure IA pour la vidéo
La meilleure IA pour générer de la vidéo est MiniMax H3, que MiniMax a sorti le 31 juillet avec des poids ouverts, et son atout est de rester près du sommet partout plutôt que de gagner un seul classement.
Il mène le classement image-vers-vidéo d'Arena à 1495,4, devant Gemini Omni 1.1 Flash à 1488,5 et le Wan 3.0 d'Alibaba à 1479,8 ; sur le classement image-vers-vidéo d'Artificial Analysis, il est deuxième à 1181, derrière le seul MiniMax H3 Max, un modèle que Fal a construit sur sa base ; et il est quatrième sur le classement texte-vers-vidéo d'Artificial Analysis à 1137. Son point faible est le classement texte-vers-vidéo d'Arena, où il est huitième à 1460,3.
Il produit des clips 2K de 4 à 15 secondes avec un son stéréo natif, à partir de 0,13 $ la seconde en 2K, et les poids sont sur Hugging Face sous la licence communautaire propre à MiniMax, sans l'upscaler 2K et sur demande aux États-Unis, dans l'UE, au Royaume-Uni et en Corée du Sud. Gemini Omni 1.1 Flash, notre choix jusqu'à cette mise à jour, mène toujours le classement texte-vers-vidéo d'Arena à 1516,2, à égalité statistique avec Gemini Omni Flash à 1512,9, et reste le choix pour les plans longs : extension de scène par paliers de 10 secondes jusqu'à 40 secondes, contrôle de la première et de la dernière image et sortie 4K, d'environ 0,03 $ la seconde en 360p à 0,30 $ en 4K.
Mais Artificial Analysis l'a désormais évalué, et il n'est que huitième en texte-vers-vidéo à 1113, sans aucune note en image-vers-vidéo. Wan 3.0 mène le classement texte-vers-vidéo d'Artificial Analysis à 1156 et est troisième sur le classement image-vers-vidéo d'Arena, mais seulement sixième sur son classement texte-vers-vidéo. Si vous avez besoin de plans plus longs dans les outils de Google, Veo 3.1 tourne toujours dans l'application Gemini, AI Studio et Vertex AI avec audio natif et sortie 1080p.
| Modèle | Idéal pour | Force | Faiblesse | Prix |
|---|---|---|---|---|
| MiniMax H3 | Meilleure vidéo IA globale | #1 Arena image-vers-vidéo (1495,4), #2 image-vers-vidéo chez Artificial Analysis (1181), #4 texte-vers-vidéo chez Artificial Analysis (1137) ; clips 2K de 4-15 s avec son stéréo natif | #8 sur Arena texte-vers-vidéo (1460) ; les poids ouverts excluent l'upscaler 2K et exigent une demande aux États-Unis, dans l'UE, au Royaume-Uni et en Corée du Sud | 0,13 $/s en 2K |
| Gemini Omni 1.1 Flash | Plans longs et 4K | #1 Arena texte-vers-vidéo (1516), #2 Arena image-vers-vidéo (1488,5) ; extension de scène à 40 secondes, sortie 4K | Seulement #8 en texte-vers-vidéo chez Artificial Analysis (1113) ; aucune note image-vers-vidéo chez Artificial Analysis | 0,03-0,30 $/s ; Gemini API / AI Studio / Flow |
| Gemini Omni Flash | Clips de dix secondes moins chers | #2 Arena texte-vers-vidéo (1513), #3 image-vers-vidéo chez Artificial Analysis (1178) ; édition conversationnelle | Plafonne à des générations de dix secondes | ~0,10 $/s ; app Gemini / AI Studio |
| Wan 3.0 | Vidéo à partir de documents et de diapositives | #1 texte-vers-vidéo chez Artificial Analysis (1156), #3 Arena image-vers-vidéo (1479,8) ; 2-30 s, jusqu'à 1080p, entrée Omni-Reference | API uniquement, aucun poids publié ; #6 sur Arena texte-vers-vidéo | 0,05-0,20 $/s |
| Dreamina Seedance 2.5 | Concurrent de ByteDance | #3 texte-vers-vidéo chez Artificial Analysis (1143), #4 Arena image-vers-vidéo (1477,4) | #7 Arena texte-vers-vidéo (1474) ; écosystème ByteDance, accès occidental limité | Dreamina / BytePlus |
| Muse Video | Vidéo dans l'écosystème Meta | #9 sur Arena texte-vers-vidéo à 1456 | Le plus récent du groupe, outillage limité | Application Meta AI |
| Veo 3.1 | Clips de production plus longs | Audio natif, 1080p, forte cohérence physique | #12 sur Arena vidéo, pas le leader en qualité | Google AI Pro / Ultra |
| Kling 3.0 / 3.0 Turbo | Itération rapide à moindre coût | 4K natif, 60fps, clips de 15 secondes ; Turbo sorti le 17 juin | Hors du top 16 sur Arena texte vers vidéo | À partir de 10 $/mois |
| Luma Ray 3 | Scènes photoréalistes | Fort réalisme pour les paysages | Communauté plus petite | Gratuit / à partir de 9,99 $/mois |
La couronne de la vidéo passe de Gemini Omni 1.1 Flash à MiniMax H3. Depuis la dernière mise à jour, Artificial Analysis a évalué Omni 1.1 Flash pour la première fois, et sur son classement texte-vers-vidéo, désormais en version 2.0, il n'est que huitième à 1113, derrière Wan 3.0 à 1156 et MiniMax H3 à 1137. Comme H3 reste premier sur le classement image-vers-vidéo d'Arena et deuxième sur celui d'Artificial Analysis, derrière le seul modèle construit sur sa base, H3 se classe désormais mieux sur l'ensemble des quatre classements que nous suivons.
Omni 1.1 Flash garde la première place du classement texte-vers-vidéo d'Arena, toujours à égalité statistique avec Gemini Omni Flash, et reste donc sur le podium comme choix pour le texte-vers-vidéo ; Wan 3.0 prend la troisième place à Dreamina Seedance 2.0. En début de mois, FLUX 3 Video et Grok Imagine Video 1.5 sont entrés troisième et quatrième sur le classement texte-vers-vidéo d'Arena. En septembre, Gemini Omni 1.1 Flash a tenu la première place du classement texte-vers-vidéo d'Arena et MiniMax H3 a pris la première place du classement image-vers-vidéo.
Meilleure IA pour coder
La meilleure IA pour programmer est Claude Opus 5.5, qu'Anthropic a lancé le 22 septembre, même s'il ne mène plus tous les classements, et le modèle qui lui en a pris deux est son propre petit frère moins cher.
Claude Sonnet 5.5, sorti le 28 septembre, mène l'exécution maison de Terminal-Bench 4.0 par Artificial Analysis à 63,6 % contre 59,6 % pour Opus 5.5, et LiveBench Coding à 91,4 contre 89,3. Opus 5.5 garde la couronne sur le reste des preuves. Il mène le classement WebDev d'Arena à 1813, devant GPT-6 Astra à 1786 et Claude Sonnet 5.5 à 1774. Il obtient 71,7 sur LiveBench Agentic Coding, juste derrière DeepSeek V4.1-Flash, là où Sonnet 5.5 plafonne à 56,3, et sur les harnesses d'Anthropic il bat Sonnet 5.5 sur FrontierCode v1.1, 54,4 % contre 52,1 %, et sur CursorBench 4.0, 57,8 % contre 55,5 %. Le prix joue désormais en faveur de Sonnet 5.5 à tous les niveaux d'effort.
Il coûte 2 $ / 10 $ par million de tokens contre 4 $ / 20 $ pour Opus 5.5, et Artificial Analysis chiffre désormais même une tâche de l'Intelligence Index à effort maximal à 5,46 $ contre 5,98 $ pour Opus 5.5 ; en xhigh il obtient 51,9 sur l'indice pour 2,01 $ la tâche et en high 46,7 pour 0,88 $. Opus 5.5 a aussi pris le classement image-vers-WebDev d'Arena à 1748,5, devant Sonnet 5.5 à 1740,0 et GPT-6 Astra à 1731,4 ; Astra égale les 59,6 % d'Opus 5.5 sur Terminal-Bench 4.0 en xhigh, à 10 $ / 50 $, et Claude Fable 5.1 est cinquième sur WebDev et quatrième sur image-vers-WebDev.
GPT-6.1 Sol est l'option bon marché d'OpenAI : quatrième sur WebDev et 56,1 % sur Terminal-Bench 4.0 pour 0,72 $ par tâche de l'indice, même si LiveBench le place loin du top 10 en Coding, à 80,7. Gemini 4 Argon mène le tableau DeepSWE v1.1 de Google lui-même à 77,9 %, mais Artificial Analysis mesure 57,1 % sur Terminal-Bench 4.0, Arena le classe neuvième sur WebDev, et depuis le 13 octobre il est dans l'API payante et dans Antigravity pour les abonnés Google AI Ultra.
Claude Haiku 5.5, sorti le 7 octobre à 0,10 $ / 0,50 $, est le Claude bon marché pour le travail de sous-agents à gros volume : 33 % sur l'exécution de Terminal-Bench 4.0 par Artificial Analysis, au niveau de GLM 5.3 Flash, et 57,2 sur LiveBench Agentic Coding, juste au-dessus de Sonnet 5.5, mais Arena ne le classe que 30e sur WebDev. Côté poids ouverts, le MiMo-V2.6-Pro de Xiaomi obtient 34,8 % sur Terminal-Bench 4.0 sous licence MIT simple à 0,13 $ par tâche de l'indice, GLM-5.3 reste le modèle ouvert le plus fort sur ce harness à 41,9 %, et Kimi K3 est le modèle ouvert le mieux classé sur Arena WebDev, quatorzième à 1654, avec seulement 12,6 % sur le harness.
Artificial Analysis a retiré à la fois son Coding Index et son Coding Agent Index, si bien que les deux classements composites de programmation que cette page citait n'existent plus.
| Modèle | Idéal pour | Force | Faiblesse | Prix (par 1M de tokens) |
|---|---|---|---|---|
| Claude Opus 5.5 | Meilleure programmation globale | #1 Arena WebDev (1813) et #1 Intelligence Index (57,6, v4.3.2) ; 71,7 sur LiveBench Agentic Coding, 15 points au-dessus de Sonnet 5.5 | Deuxième derrière Sonnet 5.5 sur Terminal-Bench 4.0 (59,6 % contre 63,6 %) et LiveBench Coding (89,3 contre 91,4) | 4 $ / 20 $ |
| Claude Sonnet 5.5 | Meilleur rapport qualité-prix en programmation | #1 Terminal-Bench 4.0 (63,6 %) et #1 LiveBench Coding (91,4), #3 Arena WebDev (1774) ; en xhigh 51,9 sur l'indice pour 2,01 $ la tâche | 56,3 sur LiveBench Agentic Coding, 15 points derrière Opus 5.5 | 2 $ / 10 $ |
| GPT-6 Astra | Deuxième sur WebDev d'Arena | #2 Arena WebDev (1786) et #3 image-vers-WebDev (1731,4) ; 59,6 % Terminal-Bench 4.0 en xhigh | 2,5 fois le prix d'Opus 5.5 ; derrière Sonnet 5.5 sur Terminal-Bench et loin derrière les deux modèles Claude sur LiveBench Coding | 10 $ / 50 $ |
| Claude Fable 5.1 | Meilleur score composite avant Opus 5.5 | #5 Arena WebDev et #4 image-vers-WebDev ; Intelligence Index 53,4 ; AA-Briefcase 1675 | 52,0 % Terminal-Bench 4.0 ; 2,5 fois le prix d'Opus 5.5 | 10 $ / 50 $ |
| Claude Opus 5 | Remplacé par Opus 5.5 | 49,0 % Terminal-Bench 4.0 et #7 Arena WebDev et #7 image-vers-WebDev | Coûte plus cher par token qu'Opus 5.5 et marque sept points de moins | 5 $ / 25 $ |
| Claude Fable 5 | Travail agentique le plus long et le plus dur | Intelligence Index 49,6 ; 42,4 % Terminal-Bench 4.0 ; contexte 1M | Le plus cher par tâche de ce tableau à 8,75 $ ; #10 sur Arena image-vers-WebDev | 10 $ / 50 $ |
| Qwen3.8-Max-0902 | Détenteur éphémère du classement WebDev | #10 Code Arena : WebDev (1674) ; Intelligence Index 45,4 ; 2,4 billions de paramètres, contexte 1M | API QwenCloud uniquement, sans interface grand public ; a perdu la tête de WebDev en quelques jours | 2 $ / 6 $ |
| Kimi K3 | Modèle ouvert le mieux classé sur Arena | #14 Arena WebDev (1654), la meilleure place ouverte sur ce classement ; 2,8 billions/104 Md actifs | Seulement 12,6 % sur Terminal-Bench 4.0 ; 1,56 To à héberger | 3 $ / 15 $ |
| GPT-5.6 Sol | Le vaisseau amiral bon marché d'OpenAI | Intelligence Index 47,0 ; 39,9 % Terminal-Bench 4.0 | Remplacé par GPT-6 Sol, qui fait mieux pour moitié moins cher ; manipulation des évaluations signalée par METR | 4 $ / 20 $ |
| GPT-6 Sol | Programmation GPT-6 bon marché dans Codex | Intelligence Index 47,6 (v4.3.2) et 43,9 % Terminal-Bench 4.0, tous deux au-dessus de GPT-5.6 Sol et pour moitié moins cher | #8 Arena WebDev (1688) | 2 $ / 10 $ |
| GPT-6.1 Sol | Le modèle de tête le moins cher par tâche | Intelligence Index 51,8 (v4.3.2), #4 Arena WebDev (1755) et 56,1 % Terminal-Bench 4.0 à 0,72 $ par tâche de l'indice, entrée en cache à 0,10 $ | 80,7 sur LiveBench Coding, loin du top 10 ; uniquement dans Codex et ChatGPT Work, pas dans Chat | 2 $ / 10 $ |
| Gemini 4 Argon | Longues tâches logicielles | 77,9 % sur DeepSWE v1.1 selon les chiffres de Google ; Intelligence Index 52,6 à 1,99 $ par tâche de l'indice | 57,1 % Terminal-Bench 4.0 et #9 Arena WebDev (1678) | 2 $ / 10 $ au lancement jusqu’au 30/11, 4 $ / 20 $ standard |
| Muse Spark 1.3 | Programmation agentique bon marché | Intelligence Index 48,1 à 1,25 $ / 4,25 $ et 1,60 $ par tâche | 33,3 % sur Terminal-Bench 4.0 ; les victoires en programmation viennent du graphique de Meta, mesuré sur une variante max réservée aux partenaires | 1,25 $ / 4,25 $ |
| Muse Wonder Full | Le modèle le plus puissant de Meta, dans Muse Code | Intelligence Index 55,8 (v4.3.2), troisième parmi les modèles distincts ; #2 GDPval-AA v2.1 (1857) ; 57,1 % Terminal-Bench 4.0 | Abonnement Muse Code uniquement (forfaits à 50 $ et 200 $), pas d'API ; pas encore évalué par Arena | Muse Code, dès 50 $/mois |
| Muse Wonder | Le modèle de pointe de Meta dans l'API | Intelligence Index 52,4 (v4.3.2) ; 52,0 % Terminal-Bench 4.0 ; contexte 1M | Même prix qu'Opus 5.5, 4 $ / 20 $, qui marque 5,2 points de plus ; 4,52 $ par tâche | 4 $ / 20 $ |
| Grok 4.7 | Codeur économique | 46,3 % CursorBench 4.0 et 71,0 % DeepSWE v1.1 selon les chiffres de SpaceXAI ; Intelligence Index 46,3 | 24,7 % sur Terminal-Bench 4.0 ; les prompts de 200K tokens et plus refacturent toute la requête au double | 2 $ / 6 $ |
| Gemini 3.8 Flash | Programmation agentique à grande échelle | Intelligence Index 40,9 ; 308,4 tokens de sortie par seconde | 19,7 % sur Terminal-Bench 4.0 ; le tarif de lancement double le 1er janvier 2027 | 0,75 $ / 3,75 $ |
| GLM 5.3 Flash | Le codeur sérieux le moins cher à héberger | 32,8 % Terminal-Bench 4.0 à 0,25 $ par tâche ; MIT, 320 Md/18 Md actifs | GLM-5.3 atteint 41,9 % sur le même harness ; aucun produit grand public | Poids ouverts (MIT) |
| Claude Haiku 5.5 | Le Claude le moins cher pour les sous-agents | Intelligence Index 43,4 (v4.3.2) à 0,21 $ par tâche de l'indice ; 33 % Terminal-Bench 4.0, au niveau de GLM 5.3 Flash ; 57,2 sur LiveBench Agentic Coding, au-dessus de Sonnet 5.5 | #30 Arena WebDev (1587) ; selon Anthropic, Sonnet 5.5 et Opus 5.5 restent meilleurs pour la programmation agentique complexe ; les prompts de plus de 100K tokens coûtent cinq fois plus | 0,10 $ / 0,50 $ |
| MiMo-V2.6-Pro | Le plus haut Intelligence Index ouvert | 46,3 sur v4.3.2 et 34,8 % Terminal-Bench 4.0 à 0,13 $ par tâche ; MIT, 1,02 billion/42 Md actifs | Seulement #19 sur Arena WebDev (1629), cinq places derrière Kimi K3 | 0,435 $ / 0,87 $ |
Claude Opus 5.5 garde la couronne de la programmation. Depuis la dernière mise à jour, Claude Haiku 5.5 est sorti le 7 octobre à 0,10 $ / 0,50 $ et obtient une ligne du tableau comme le Claude le moins cher pour le travail de sous-agents, même si Arena ne le classe que 30e sur WebDev. Artificial Analysis chiffre désormais une tâche de l'indice de Sonnet 5.5 à effort maximal à 5,46 $, sous les 5,98 $ d'Opus 5.5, si bien qu'Opus 5.5 garde la couronne grâce à WebDev et à LiveBench Agentic Coding, pas grâce au coût. Claude Sonnet 5.5 est entré troisième au classement WebDev d'Arena à 1774, derrière GPT-6 Astra à 1786, ce qui repousse GPT-6.1 Sol à la quatrième place et Claude Fable 5.1 à la cinquième, et Gemini 4 Argon, entré en début de mois, est désormais neuvième. Depuis, Opus 5.5 a aussi pris à GPT-6 Astra le classement image-vers-WebDev d'Arena, et le Muse Wonder de Meta est arrivé le 12 octobre avec deux lignes du tableau : Muse Wonder Full obtient 55,8 sur l'indice mais ne tourne que dans Muse Code, et Muse Wonder coûte les mêmes 4 $ / 20 $ qu'Opus 5.5 pour 52,4.
Argon mène le propre tableau DeepSWE v1.1 de Google à 77,9 %, mais obtient 57,1 % sur le Terminal-Bench 4.0 d'Artificial Analysis, derrière Sonnet 5.5, Opus 5.5 et GPT-6 Astra, et sa sortie publique du 13 octobre n'a pas changé ces scores. En septembre, la couronne a changé de mains deux fois, de Claude Fable 5.1 à GPT-6 Astra puis à Opus 5.5, et Claude Sonnet 5.5 a pris Terminal-Bench 4.0 et LiveBench Coding comme choix rapport qualité-prix.
Meilleure IA pour la créativité
La meilleure IA pour un travail créatif non filtré et dans l'air du temps est Grok 4.7, et nous voulons être précis sur les raisons. Ce choix porte sur la gamme de produits, pas sur la qualité de la prose.
Grok porte le moins de restrictions de contenu de tous les modèles de pointe et la seule intégration native de X en temps réel, ce qui en fait le seul modèle à accepter les briefs audacieux, d'actualité ou délibérément provocateurs que les autres refusent. SpaceXAI a publié Grok 4.7 le 21 septembre pour l'API Grok, Cursor et Grok Build, et depuis le 3 octobre il fait aussi tourner le mode Expert de grok.com, ainsi que le mode Fast pour les abonnés payants. Ce n'est pas le meilleur rédacteur, même si le tableau est plus nuancé qu'avant.
EQ-Bench a désormais évalué Grok 4.7 et le place huitième à 2006,7, dans son top dix et très au-dessus de Grok 4.5 en 52e, mais les votants humains d'Arena ne le classent que 74e en écriture créative, derrière Grok 4.6 en 54e et l'ancien Grok 4.20-beta1 en 23e. Si vous choisissez sur la seule qualité de sortie, Gemini 4 Argon mène désormais le classement d'écriture créative d'Arena, disponible dans Google AI Pro depuis le 13 octobre, devant Claude Opus 5.5 et Claude Fable 5, tandis qu'EQ-Bench place GPT-6 Astra premier à 2173,3, Claude Fable 5.1 deuxième et Kimi K3 cinquième. Choisissez Grok pour ce qu'il vous laissera faire, pas pour la qualité de son écriture.
| Modèle | Idéal pour | Force | Faiblesse | Prix |
|---|---|---|---|---|
| Grok 4.7 | Non filtré, tranché, dans l'air du temps | Le moins de restrictions de contenu, ancrage natif sur X en temps réel | #74 en écriture créative sur Arena, mais #8 sur EQ-Bench (2006,7) | 2 $ / 6 $ API ; application SuperGrok à 30 $ par mois |
| Claude Fable 5 | Prose créative de la plus haute qualité | #3 Arena écriture créative, #1 LiveBench Language | Garde-fous prudents sur les briefs audacieux | 10 $ / 50 $ API |
| Kimi K3 | Fiction et voix singulière | #5 EQ-Bench Creative Writing à 2082,3 | Seulement #28 en écriture créative sur Arena | 3 $ / 15 $ |
| Claude Opus 5 | Créativité structurée de format long | Tient de longs fils et s'auto-édite ; Intelligence Index 50,8, désormais derrière six modèles plus récents | Le plus prudent du groupe | 20 $/mois Pro ; 5 $ / 25 $ API |
| Gemini 3.1 Pro | Créatif multimodal | Chaîne texte, image et vidéo solide | Exige Google AI Pro dans l'application Gemini depuis le 9 octobre | AI Pro / 2,00-4,00 $ API entrée |
| Grok Imagine (Spicy Mode) | NSFW / créatif pour adultes | La génération d'images la plus permissive | Cas d'usage de niche | 30 $/mois SuperGrok |
Grok garde ce choix avec Grok 4.7, et rien n'a changé dans la permissivité du produit ni dans son accès en direct à X, sur lesquels repose ce choix. Le classement d'écriture créative d'Arena a bougé autour de lui : Gemini 4 Argon, annoncé le 30 septembre, est entré premier, Claude Opus 5.5 est désormais deuxième et Claude Fable 5 troisième, et Grok 4.7 a reculé à la 74e place. EQ-Bench n'a pas changé et place toujours 4.7 huitième. L'application dont parle vraiment l'argument de la permissivité a rattrapé son retard le 3 octobre, quand Grok 4.7 a pris le mode Expert de grok.com. En septembre, Grok 4.7 a remplacé Grok 4.6 comme modèle phare de SpaceXAI le 21 septembre, et les deux classements d'écriture créative l'ont évalué.
Meilleure IA pour la précision & la recherche
La meilleure IA pour la précision et la recherche est Claude Fable 5.1, qui détient la plus haute précision factuelle qu'Artificial Analysis ait mesurée, 67 % sur AA-Omniscience.
C'est précisément la colonne sur laquelle cette catégorie se décide. Claude Opus 5.5 a battu Fable 5.1 sur presque tout le reste à son arrivée le 22 septembre, dont Humanity's Last Exam à 61,4 % contre 59,1 % et l'indice AA-Omniscience pénalisant les hallucinations à 46,4 contre 43,5, mais en précision factuelle brute il affiche 66 % contre 67 % pour Fable 5.1. Traitez cet écart d'un point comme une égalité et lisez les deux ensemble : Opus 5.5 est le meilleur pari quand une mauvaise réponse est pire que pas de réponse, Fable 5.1 quand vous voulez avoir juste sur le plus de faits possible.
Le choix rapport qualité-prix est désormais GPT-6.1 Sol, qui répond correctement à 62 % des questions avec un indice AA-Omniscience de 41,5, à 2 $ / 10 $ par million de tokens et 0,72 $ par tâche de l'indice, et obtient 98,5 % sur l'ARC-AGI-1 d'ARC Prize pour 0,06 $ la tâche. Il bat ainsi Gemini 3.1 Pro, notre choix rapport qualité-prix jusqu'à cette mise à jour, sur toutes les mesures de précision qu'Artificial Analysis publie : celui-ci affiche 55 % de précision brute et un indice de 31,9.
Gemini 3.1 Pro garde son intérêt quand la réponse doit être à jour, car il ancre ses réponses dans la recherche Google et figure dans l'application Gemini (avec Google AI Pro ou plus depuis le 9 octobre), alors que GPT-6.1 Sol tourne dans ChatGPT Work, Codex et l'API plutôt que dans la fenêtre de chat de ChatGPT. Gemini 4 Argon est le modèle à surveiller : Artificial Analysis mesure un taux d'hallucination de 15 %, le plus bas parmi les modèles de pointe, parce qu'il préfère s'abstenir que deviner, mais il ne répond correctement qu'à 50 % des questions ; depuis le 13 octobre, il est dans l'application Gemini à partir de Google AI Pro.
Pour la recherche ancrée en particulier, c'est OpenAI qui mène le classement recherche d'Arena : GPT-5.6 Sol est en tête à 1257, Claude Fable 5 cinquième et Gemini 3.1 Pro avec ancrage neuvième. Pour le raisonnement inédit, la couronne est ailleurs, GPT-6 Astra menant ARC-AGI-2 et ARC-AGI-3. Claude Opus 5 ne détient aucune couronne de précision car Artificial Analysis mesure son taux d'hallucination à 61 %.
| Modèle | Idéal pour | Benchmark clé | Faiblesse | Prix |
|---|---|---|---|---|
| Claude Fable 5.1 | Meilleure précision factuelle mesurée | 67 % de précision factuelle sur AA-Omniscience, la meilleure mesurée par Artificial Analysis, un point devant Claude Opus 5.5 | Pas d'offre bon marché ; non évalué sur le classement recherche d'Arena ; Opus 5.5 mène Humanity's Last Exam et l'indice AA-Omniscience | 10 $ / 50 $ |
| Claude Opus 5.5 | Quand une mauvaise réponse est pire que pas de réponse | #1 indice AA-Omniscience (46,4) et #1 Humanity's Last Exam (61,4 %) ; 66 % de précision brute | Un point derrière Fable 5.1 en précision brute | 4 $ / 20 $ |
| GPT-6.1 Sol | Meilleur rapport | 62 % de précision brute et un indice AA-Omniscience de 41,5 à 0,72 $ par tâche de l'indice ; 98,5 % ARC-AGI-1 à 0,06 $ la tâche | Taux d'hallucination de 54 % ; dans ChatGPT Work et Codex, pas dans Chat | 2 $ / 10 $ |
| Gemini 4 Argon | Le moins d'hallucinations | Taux d'hallucination de 15 % sur AA-Omniscience, le plus bas parmi les modèles de pointe | Seulement 50 % de précision brute | 19,99 $/mois Google AI Pro ; 2 $ / 10 $ API au lancement |
| Gemini 3.1 Pro | Recherche ancrée ; app Gemini avec AI Pro dès le 9 oct. | Ancrage natif dans la recherche Google ; 98 % ARC-AGI-1 à 0,52 $/tâche | 55 % de précision brute sur AA-Omniscience, sous GPT-6.1 Sol ; #9 sur Arena recherche | 2,00-4,00 $ / 12,00-18,00 $ (échelonné) |
| Claude Fable 5 | Recherche ancrée | #5 sur le classement de recherche d'Arena, derrière GPT-5.6 Sol | Pas de palier bon marché unique | 10 $ / 50 $ (Fable 5) |
| GPT-5.6 Sol | Raisonnement inédit | #4 ARC-AGI-2 à 92,5 %, derrière GPT-6 Astra (95 %), GPT-6.1 Sol (94,2 %) et Claude Opus 5.5 (93,3 %) | Scheming signalé par METR | 4 $ / 20 $ |
| Claude Opus 5 | Les problèmes inédits les plus ardus | 30,2 % ARC-AGI-3 sur le harness standard, deuxième derrière GPT-6 Astra (ARC Prize) | Artificial Analysis mesure un taux d'hallucination de 61 % | 5 $ / 25 $ |
| Qwen 3.7 Max | Précision frontier à prix avantageux | 92,4 GPQA Diamond, 200 requêtes gratuites/jour | API uniquement, pas de front-end de chat | 1,25 $ / 3,75 $ promo ; 2,50 $ / 7,50 $ tarif liste |
| Claude Opus 4.6 | Honnêteté sous pression | #1 sur le classement MASK de Scale SEAL à 96,28 ; Anthropic occupe le top 5 | Remplacé comme modèle phare | Modèle legacy d'Anthropic |
La couronne de la précision reste à Claude Fable 5.1, à 67 % de précision factuelle brute contre 66 % pour Claude Opus 5.5, et le choix rapport qualité-prix a changé. GPT-6.1 Sol bat désormais Gemini 3.1 Pro sur toutes les mesures de précision qu'Artificial Analysis publie, 62 % de précision brute contre 55 % et un indice AA-Omniscience de 41,5 contre 31,9, et ARC Prize lui attribue 98,5 % sur ARC-AGI-1 pour 0,06 $ la tâche contre 98 % pour 0,52 $ pour Gemini 3.1 Pro, si bien qu'il prend la carte du rapport qualité-prix. Gemini 3.1 Pro reste dans le tableau pour la recherche ancrée et l'application Gemini, où il exige Google AI Pro depuis le 9 octobre.
Gemini 4 Argon, annoncé le 30 septembre, apporte le taux d'hallucination le plus bas qu'Artificial Analysis ait mesuré parmi les modèles de pointe, 15 %, mais il ne répond correctement qu'à la moitié des questions, si bien que sa sortie publique du 13 octobre ne change rien en tête. Deux lignes plus anciennes sont aussi corrigées : le taux d'hallucination de Claude Opus 5 est désormais de 61 % et non de 50 %, et il ne mène plus ARC-AGI-3. En septembre, Opus 5.5 a pris l'indice pénalisant les hallucinations et Humanity's Last Exam, c'est pourquoi ce bloc partage désormais entre les deux modèles Claude plutôt que d'en couronner un seul.
Meilleure IA pour la résolution de problèmes
La meilleure IA pour résoudre des problèmes difficiles est GPT-6 Astra, qui a pris les classements de raisonnement à GPT-5.6 Sol quelques jours après son lancement.
Il mène LiveBench Reasoning à 92,65 et ARC-AGI-2 à 95 %, le score le plus élevé jamais obtenu face au panel humain à 100 % de ce classement, et se classe quatrième sur LiveBench Mathematics à 96,81, derrière Claude Opus 5.5 à 97,08, Claude Fable 5.1 à 97,01 et GPT-6.1 Sol à 96,83. Il annonce aussi 97,6 % sur FrontierMath Tier 4 v2, un chiffre à lire avec la mention d'Epoch AI selon laquelle OpenAI a financé le benchmark et dispose d'un accès exclusif à une partie de celui-ci. Le hic, c'est le prix et la portée : 10 $ / 50 $ par million de tokens contre 2 $ / 10 $ pour GPT-6.1 Sol, et il faut une formule ChatGPT payante.
GPT-6.1 Sol, sorti le 29 septembre, est l'alternative rapport qualité-prix et presque un co-leader : 92,63 sur LiveBench Reasoning, à 0,02 d'Astra, et 94,2 % sur ARC-AGI-2, à 0,8 point, pour 0,25 $ la tâche contre 1,12 $ pour Astra. Astra garde la couronne parce qu'il mène toujours les deux classements ainsi qu'ARC-AGI-3, où il obtient 62,7 % sur le harness standard contre 52,7 % pour GPT-6.1 Sol. Gemini 4 Argon mène la catégorie mathématiques d'Arena, mais sur quelques centaines de votes seulement, et ni LiveBench ni ARC Prize ne l'ont évalué. GPT-5.6 Sol, l'ancien choix rapport qualité-prix, est désormais cinquième sur LiveBench Reasoning et quatrième sur ARC-AGI-2 à 92,5 %.
Qwen 3.7 Max est le choix économique pour les problèmes de compétition, à 97,1 sur l'indice HMMT de février 2026 et 44,5 sur Apex, avec 200 requêtes gratuites par jour. Claude Opus 5 reste l'alternative pour les longues chaînes de raisonnement agentique, même si Astra lui a aussi pris ARC-AGI-3.
| Modèle | Idéal pour | Benchmark clé | Faiblesse | Prix |
|---|---|---|---|---|
| GPT-6 Astra | Mathématiques, sciences et raisonnement les plus durs | #1 LiveBench Reasoning (92,65), #1 ARC-AGI-2 (95 %), #1 ARC-AGI-3 | Exige un forfait ChatGPT payant ; 5 fois le prix de GPT-6.1 Sol | 10 $ / 50 $ |
| Claude Opus 5 | Longues chaînes de raisonnement agentique | 1662 sur AA-Briefcase v1.1 et 1724 sur GDPval-AA v2.1, quatrième parmi les modèles distincts sur les deux ; 30,2 % ARC-AGI-3 | Astra mène désormais ARC-AGI-3 ; 61 % de taux d'hallucination ; désormais un modèle legacy | 5 $ / 25 $ |
| GPT-5.6 Sol | Vaisseau amiral STEM abordable | #4 ARC-AGI-2 (92,5 %) ; #5 LiveBench Reasoning (91,65), Mathematics 96,20 | FrontierMath toujours non publié ; comportement trompeur signalé par METR | 100 $/mois ChatGPT Pro ; API 4 $ / 20 $ |
| GPT-6.1 Sol | Meilleur rapport, raisonnement proche d'Astra | #2 LiveBench Reasoning (92,63), #2 ARC-AGI-2 (94,2 %), #3 LiveBench Mathematics (96,83) ; Intelligence Index 51,8 à 0,72 $ par tâche de l'indice | 52,7 % sur ARC-AGI-3 contre 62,7 % pour Astra ; dans ChatGPT Work et Codex, pas dans Chat | 2 $ / 10 $ |
| Qwen 3.7 Max | Mathématiques de compétition avec un budget serré | 97,1 HMMT 2026 févr., 44,5 Apex, 200 requêtes gratuites/jour | API uniquement | 1,25 $ / 3,75 $ promo ; 2,50 $ / 7,50 $ tarif liste |
| Claude Fable 5 | Mathématiques au sein d'un flux de programmation | #3 sur la sous-catégorie mathématiques d'Arena (1522), derrière Gemini 4 Argon et Claude Opus 5 ; 96,0 LiveBench Mathematics | L'option la plus chère ici | 10 $ / 50 $ |
| GLM 5.3 Flash | Résolution de problèmes open-weight | Intelligence Index 41,8 sous MIT, près de huit points au-dessus de GLM-5.2 pour moins de la moitié de la taille ; 320B/18B actifs, contexte 1M | Exige un serveur multi-GPU, pas une station de travail ; GLM 5.3 fait mieux selon les chiffres de Z.ai elle-même et est téléchargeable depuis le 28 août, mais pour plus du double de la taille et sous une licence maison | Open weights (MIT) |
GPT-6 Astra garde la couronne de la résolution de problèmes, avec moins d'un point d'avance. ARC Prize a désormais évalué GPT-6.1 Sol, qui obtient 94,2 % sur ARC-AGI-2, deuxième derrière les 95 % d'Astra et devant les 93,3 % de Claude Opus 5.5, pour moins d'un quart du coût par tâche d'Astra. Avec ses 92,63 sur LiveBench Reasoning, à 0,02 d'Astra, cela fait de GPT-6.1 Sol presque un co-leader, mais Astra mène toujours les deux classements ainsi qu'ARC-AGI-3, donc la couronne ne bouge pas. GPT-5.6 Sol recule à la quatrième place sur ARC-AGI-2. Gemini 4 Argon, annoncé le 30 septembre, mène la catégorie mathématiques d'Arena sur quelques centaines de votes mais n'a encore aucun score LiveBench ni ARC Prize, et Claude Fable 5, qui menait cette catégorie d'Arena, est désormais troisième. En septembre, Astra a pris cette couronne à GPT-5.6 Sol après son lancement du 3 septembre, et LiveBench Mathematics est passé à Claude Opus 5.5.
Meilleur agent d'IA
Le meilleur agent d'IA est Gemini Spark si vous voulez l'agent dans le cloud et Claude Cowork si vous le voulez sur votre bureau.
Ce sont des choix conjoints et non un premier et un deuxième : Spark tourne dans une VM Google Cloud et continue donc à travailler pendant que votre portable est fermé, relié à Gmail, Docs et, depuis début septembre, Google Photos ; Cowork tourne sur votre Mac ou votre PC Windows et pilote vos applications locales et votre écran. Spark n'est plus le seul agent qui continue de travailler dans le cloud.
Grok Bot de SpaceXAI (11 août) donne à chaque compte un ordinateur cloud persistant qui se connecte à vos applications, dès un forfait Cursor Pro à 20 $/mois ; Muse de Meta (8 septembre) fait vos démarches depuis sa propre VM cloud et reste gratuit jusqu'à 100 millions de tokens par semaine ; et OpenAI dots (29 septembre) tournent sur GPT-6 Astra avec leur propre ordinateur et navigateur cloud, dès le forfait Pro à 100 $/mois, qui ne les inclut pas dans l'EEE, au Royaume-Uni ni en Suisse. Aucun classement indépendant ne met ces produits face à face : le choix porte donc sur l'endroit où le travail doit se faire, pas sur celui qui marque le plus.
Le prix ne départage plus non plus : Spark atteint désormais le palier Google AI Pro à 19,99 $/mois aux États-Unis et dans plus de 160 autres pays, et Cowork est inclus sans supplément dans tous les forfaits Claude payants à partir de 20 $/mois. ChatGPT Codex Mobile (14 mai) est l'alternative pour le travail d'agent de programmation. Lisez la comparaison complète Gemini Spark contre Claude Cowork.
| Agent | Idéal pour | Où il tourne | Force | Prix |
|---|---|---|---|---|
| Gemini Spark | Tâches cloud 24/7, flux Workspace | VM Google Cloud (toujours active) | Toujours actif, intégration profonde à Workspace | À partir de 19,99 $/mois Google AI Pro |
| Claude Cowork | Bureau, pilotage d'apps, design + code | Votre bureau Mac/Windows | Pilote les apps locales, voit votre écran | 20 $/mois Claude Pro |
| ChatGPT Codex Mobile | Agent de programmation sur téléphone | Cloud OpenAI + iOS/Android | Approuver des diffs et réorienter le travail depuis le téléphone | Inclus dans les forfaits ChatGPT |
| Grok Bot | Tâches de navigateur dans vos applications connectées | Un ordinateur cloud SpaceXAI persistant, partagé par tous vos Bots | Se connecte aux applications avec vos propres identifiants et continue ordinateur portable fermé | Dès 20 $/mois Cursor Pro, ou un forfait SuperGrok associé |
| OpenAI dots | Responsabilités suivies, pas des tâches isolées | Ordinateur et navigateur cloud d'OpenAI | Tourne sur GPT-6 Astra ; continue de travailler ordinateur éteint ; joignable dans ChatGPT, Slack et par la voix | Dès 100 $/mois ChatGPT Pro (hors EEE/R.-U./CH) ; Business Premium |
| Meta Muse | Démarches personnelles gratuites | Une Muse Secure VM dans le cloud de Meta | Gratuit jusqu'à 100M de tokens par semaine ; un agent Sentinel distinct valide ce qu'il envoie | Gratuit ; Power 20 $/mois, Maximum 100 $/mois |
Gemini Spark (cloud) et Claude Cowork (bureau) restent des choix conjoints, car cette catégorie récompense des produits et aucun nouveau produit d'agent n'est sorti depuis la dernière mise à jour. C'est la couche des modèles qui a bougé. Claude Sonnet 5.5 est entré troisième sur l'Agent Arena, derrière Claude Fable 5.1, qui la mène toujours avec 17,6 % de réussite confirmée, et Claude Opus 5.5, et il a pris la tête d'AA-Briefcase v1.1 chez Artificial Analysis à 1823, Opus 5.5 étant deuxième à 1807. Opus 5.5 mène toujours GDPval-AA v2.1 à 1866, le nouveau Muse Wonder Full de Meta étant deuxième à 1857 et Sonnet 5.5 troisième à 1838. Gemini 4 Argon, annoncé le 30 septembre, mène l'AutomationBench d'Artificial Analysis à 77,5 % et affiche un taux de réussite confirmée de 15,4 % sur l'Agent Arena, au-dessus des 14,1 % d'Opus 5.5, mais n'y est que dixième au classement général et depuis le 13 octobre il est dans l'API payante et dans l'application Gemini avec Google AI Pro.
Parmi les modèles ouverts de l'Agent Arena, Kimi K3 est désormais le mieux classé, quatorzième, devant DeepSeek V4.1-Flash, dix-septième, et le Hy4 Preview de Tencent, dix-neuvième. En septembre, Grok Bot, Muse de Meta et OpenAI dots ont rejoint Gemini Spark comme agents cloud toujours actifs, et Spark est arrivé dans la formule Google AI Pro à 19,99 $ par mois.
Appuyez sur ⌥ Space sur votre Mac, posez votre question et continuez à travailler. Aussi sur iPhone et iPad.
Gratuit pour démarrer, 4,7★ sur plus de 27 000 avis.
Télécharger Fello AIMeilleure IA pour les étudiants
La meilleure IA pour les étudiants est GPT-6 Luna dans ChatGPT pour le travail de cours général et Gemini 3.6 Flash pour les STEM et l'étude multimodale, avec Qwen 3.7 Max comme alternative par API pour les séries d'exercices plus difficiles (200 requêtes gratuites par jour) et Claude Sonnet 5.5 comme alternative gratuite pour réviser les dissertations.
La plupart des étudiants n'ont pas besoin de payer. Depuis le 8 octobre, ChatGPT Free et Go passent de GPT-5.6 Luna à GPT-6 Luna, auquel Artificial Analysis donne 38,1 sur son indice contre 37,3 ; l'offre gratuite propose des discussions texte illimitées, mais l'envoi de fichiers et les outils d'image restent plafonnés. Claude Sonnet 5.5 est gratuit sur claude.ai, où les comptes gratuits peuvent aussi choisir Claude Haiku 5.5 (7 octobre), le modèle Claude qui consomme le moins votre limite d'utilisation.
Gemini a changé le 9 octobre : l'application Gemini gratuite fonctionne désormais en mode Auto, qui envoie la plupart des prompts à Flash-Lite, si bien que choisir vous-même Gemini 3.6 Flash exige Google AI Plus, même s'il reste gratuit dans Google AI Studio. Pour résoudre pas à pas les mathématiques les plus ardues, GPT-6 Astra annonce 97,6 % sur FrontierMath Tier 4 v2 mais n'est pas dans l'offre gratuite de ChatGPT ; Qwen 3.7 Max est l'alternative économique à 97,1 sur le HMMT de février 2026, avec un tarif d'API de 1,25 $ / 3,75 $ grâce à sa promotion actuelle de 50 % (2,50 $ / 7,50 $ au tarif normal).
| Tâche | Meilleur modèle | Pourquoi | Gratuit ? | Alternative |
|---|---|---|---|---|
| Dissertations & travail de cours | GPT-6 Luna | Le modèle de ChatGPT Free et Go, en déploiement depuis le 8 octobre ; discussions texte illimitées | Oui | Claude Sonnet 5.5 (Claude gratuit) |
| Résolution de problèmes STEM | GPT-6 Sol / Qwen 3.7 Max | Modèle payant par défaut de ChatGPT ; Astra annonce 97,6 % sur FrontierMath Tier 4 v2 / 97,1 HMMT févr. 2026 | Plus payant / Qwen API payant | Gemini 3.6 Flash (AI Plus depuis le 9 oct.) |
| Recherche & précision | Gemini 3.1 Pro | 98 % ARC-AGI-1 à 0,52 $/tâche, ancrage natif dans Google Search | AI Pro (application Gemini) depuis le 9 oct. | Claude Opus 5 |
| Révision d'écriture | Claude Sonnet 5.5 | Gratuit sur claude.ai depuis le 28 septembre et deuxième derrière le seul Opus 5.5 sur l'Intelligence Index ; Claude Fable 5.1 est le leader en qualité | Oui (Claude gratuit) | Claude Fable 5.1 |
| Étude multimodale (PDF, diapositives, images) | Gemini 3.6 Flash | Contexte 1M via AI Studio ; l'application Gemini exige AI Plus depuis le 9 oct. | Gratuit dans AI Studio | NotebookLM (Google) |
Deux changements pour les étudiants. Le modèle gratuit de ChatGPT passe de GPT-5.6 Luna à GPT-6 Luna, en déploiement sur Free et Go depuis le 8 octobre, si bien que GPT-6 Luna prend la ligne des dissertations. Et depuis le 9 octobre, l'application Gemini gratuite fonctionne en mode Auto, qui envoie la plupart des prompts à Flash-Lite, si bien que choisir Gemini 3.6 Flash dans l'application exige Google AI Plus.
Anthropic a aussi publié Claude Haiku 5.5 le 7 octobre, que les comptes Claude gratuits peuvent choisir, et Claude Sonnet 5.5 reste gratuit sur claude.ai. Gemini 4 Argon, public depuis le 13 octobre, est inclus dans Google AI Pro : les étudiants américains qui profitent de l'année gratuite d'AI Pro de Google y ont donc accès, mais pas le forfait gratuit ni l'offre étudiante Google AI Plus des autres pays. En septembre, Claude Sonnet 5.5 a remplacé Sonnet 5 comme choix gratuit pour l'écriture et la révision.
Meilleure IA pour le travail & les professionnels
La meilleure IA pour le travail professionnel est GPT-6 (modèle par défaut de ChatGPT depuis le 7 octobre, Sol sur les offres payantes) pour le travail de connaissance quotidien, Claude Opus 5.5 pour la programmation et l'écriture à fort enjeu, et Gemini Spark pour les workflows agentiques 24 h/24.
La plupart des professionnels en tirent le meilleur parti avec deux abonnements payants (ChatGPT Plus à 20 $/mois plus Claude Pro à 20 $/mois, soit 40 $/mois au total). Ou avec une seule facture : Fello AI couvre ChatGPT, Claude et Gemini pour le travail quotidien. Pour le travail agentique qui tourne pendant que vous dormez, Gemini Spark est l'agent cloud toujours actif intégré à Google Workspace, et depuis le 30 juillet il est accessible avec l'offre Google AI Pro à 19,99 $/mois ainsi qu'avec Google AI Ultra ; OpenAI dots, Grok Bot et Muse de Meta sont les alternatives, présentées dans la section sur les agents.
| Cas d'usage | Meilleur modèle | Stat clé | Prix | Alternative |
|---|---|---|---|---|
| Travail de connaissance quotidien | GPT-6 | Par défaut de ChatGPT depuis le 7 octobre ; GPT-6 Sol sur Plus | 20 $/mois ChatGPT Plus | Claude Opus 5.5 |
| Recherche juridique, financière et fiscale | Gemini 4 Argon | #1 Vals Index (68,9 %) et #1 AutomationBench-AA (77,5 %) | 19,99 $/mois Google AI Pro | Claude Opus 5.5 |
| ChatGPT Work et Codex | GPT-6.1 Sol | Dans ChatGPT Work et Codex pour Plus, Pro, Business, Enterprise et Edu depuis le 29 septembre, à 2 $ / 10 $ dans l'API | 20 $/mois ChatGPT Plus | GPT-6 Luna pour le travail en volume |
| Programmation (propriétaire) | Claude Opus 5.5 | #1 Arena WebDev (1813) et #1 Intelligence Index (57,6), à 4 $ / 20 $ | 20 $ par mois Claude Pro | Claude Sonnet 5.5, en tête de Terminal-Bench 4.0 pour la moitié du prix par token |
| Programmation (économique) | Claude Sonnet 5.5 | #1 Terminal-Bench 4.0 (63,6 %) et #1 LiveBench Coding (91,4) ; 0,88 $ par tâche de l'indice en effort high | 2 $ / 10 $ | Qwen3.8-Max-0902 ; DeepSeek V4.1-Flash |
| Recherche & briefings | Gemini 3.1 Pro | 98 % ARC-AGI-1 à 0,52 $/tâche, ancrage Google | Google AI Pro / Ultra | Claude Opus 5.5 |
| Mathématiques ardues, physique, modélisation financière | GPT-6 Astra | #1 LiveBench Reasoning et ARC-AGI-2 (95 %) ; annonce 97,6 % sur FrontierMath Tier 4 v2 | 100 $/mois ChatGPT Pro | GPT-6.1 Sol ; Qwen 3.7 Max |
| Flux d'agent toujours actifs | Gemini Spark | Agent cloud 24/7 dans Google Workspace | À partir de 19,99 $/mois Google AI Pro | Claude Cowork |
| Actualité en direct, créatif avec contexte X | Grok 4.7 | Intelligence Index 46,3 + ancrage natif sur X ; dans l'application Grok depuis le 3 octobre | 30 $ par mois SuperGrok | Gemini 3.1 Pro |
| Consolidation tout-en-un | Fello AI | ChatGPT + Claude + Gemini + Grok + DeepSeek | À partir de 11,99 $/mois | Payer chaque fournisseur séparément |
La ligne du travail de connaissance quotidien passe de GPT-5.6 à GPT-6, devenu le modèle par défaut de ChatGPT le 7 octobre. Gemini 4 Argon prend une nouvelle ligne pour le travail juridique, financier et fiscal : il mène le Vals Index de ce travail ainsi que l'AutomationBench d'Artificial Analysis, et depuis le 13 octobre il est dans l'application Gemini avec Google AI Pro à 19,99 $ par mois. En septembre, Claude Opus 5.5 a pris la ligne de la programmation propriétaire à un prix inférieur à celui d'Opus 5, Claude Sonnet 5.5 celle de la programmation économique, et GPT-6.1 Sol celle de ChatGPT Work et Codex le 29 septembre.
Prix des modèles d'IA en octobre 2026
Des offres gratuites à 0 $ jusqu'à Google AI Ultra à 199,99 $ par mois. Le prix qui compte le plus dans ce tableau est celui de Claude Opus 5.5, à 4 $ / 20 $. Depuis le 22 septembre, le modèle le mieux noté qu'un évaluateur indépendant ait jamais mesuré coûte moins cher que le Claude Opus 5 qu'il remplace (5 $ / 25 $), et les lectures de cache baissent de 60 % à 0,20 $. Claude Fable 5.1 et GPT-6 Astra sont tous deux à 10 $ / 50 $ et marquent tous deux en dessous.
Le tarif le plus fréquenté est désormais 2 $ / 10 $, partagé par Claude Sonnet 5.5, GPT-6 Sol et GPT-6.1 Sol. GPT-6.1 Sol est la voie la moins chère vers un score parmi les six premiers de l'Intelligence Index, à 0,72 $ par tâche de l'indice. Avec Sonnet 5.5, c'est le niveau d'effort qui fait la facture : en effort high, une tâche de l'indice coûte 0,88 $ et à effort maximal 5,46 $, désormais un peu moins que les 5,98 $ d'Opus 5.5, et Anthropic a divisé par deux ses lectures de cache, à 0,10 $, le 7 octobre. Gemini 4 Argon de Google sort lui aussi à un prix de lancement de 2 $ / 10 $ (4 $ / 20 $ au tarif standard), jusqu'au 30 novembre, et depuis le 13 octobre n'importe qui peut l'acheter dans l'API payante.
Le prix du token et le coût par tâche peuvent diverger. Grok 4.7 coûte 2 $ / 6 $, comme Grok 4.6, mais une tâche de l'indice coûte 2,73 $ contre 1,86 $, parce que la 4.7 émet environ deux fois plus de sortie. Mistral Large 4 (en préversion publique depuis le 6 octobre) affiche un tarif public de 1,36 $ / 4,18 $, même si la page du modèle chez Mistral indique la moitié, et il est si verbeux qu'une tâche de l'indice coûte 1,13 $ pour un score de 38,4. À la frontière, le choix économique est le Muse Spark 1.3 de Meta, à 1,25 $ / 4,25 $, soit 1,60 $ par tâche de l'indice pour 48,1.
Au bas de l'échelle, GPT-6 Luna est le modèle le moins cher par tâche de cette page : 0,10 $ / 0,50 $, soit 0,07 $ par tâche de l'indice. Claude Haiku 5.5 (7 octobre) s'aligne sur ce prix au token pour les prompts jusqu'à 100 000 tokens et obtient 43,4 contre 38,1 pour Luna, mais il écrit tellement plus qu'une tâche de l'indice coûte 0,21 $ à effort maximal, ou 0,12 $ pour 41,3 en xhigh ; au-delà de 100 000 tokens, le tarif passe à 0,50 $ / 2,50 $. Parmi les modèles ouverts vendus au token, le choix reste GLM 5.3 Flash à 0,15 $ / 0,50 $ (0,25 $ par tâche de l'indice pour 41,8), devant DeepSeek V4.1-Flash à 0,15 $ / 0,60 $ hors pointe et 0,30 $ / 1,20 $ en pointe (0,27 $ pour 39,5). Le MiMo-V2.6-Pro de Xiaomi est encore moins cher, 0,13 $ par tâche de l'indice pour 46,3, mais seulement si vous hébergez vous-même ses 1,02 billion de paramètres. Pour une analyse plus poussée, voyez notre guide complet de comparaison des prix de l'IA.
| Modèle | Entrée (par 1M) | Sortie (par 1M) | Contexte | Accès gratuit ? |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | 1 050 000 (entrée max. 922 000) | Dans Chat sur Pro, Business et Enterprise depuis le 4 septembre ; Plus y accède via ChatGPT Work et Codex, pas dans Chat ; pas d'offre gratuite ; actif dans l'API |
| GPT-6 Sol | $2.00 | $10.00 | 1 050 000 (entrée max. 922 000) | Chat ChatGPT sur Plus, Pro, Business et Enterprise depuis le 7 octobre ; Work et Codex ; API |
| GPT-6.1 Sol | $2.00 | $10.00 | 1 050 000 (entrée max. 922 000) | ChatGPT Work et Codex sur Plus, Pro, Business, Enterprise et Edu depuis le 29 septembre ; API ; pas dans Chat ; lectures de cache 0,10 $ |
| GPT-6 Luna | $0.10 | $0.50 | 1 050 000 (entrée max. 922 000) | Chat ChatGPT sur Free et Go, en déploiement depuis le 8 octobre ; Work et Codex sur les offres payantes ; API |
| GPT-5.5 | $5.00 | $30.00 | 1M (400K dans Codex) | ChatGPT Free ; API payante |
| GPT-5.5 Pro | $30.00 | $180.00 | 1M | ChatGPT Pro à partir de 100 $/mois (paliers usage supérieur à 200 $ et 500 $) |
| GPT-5.6 Sol | $4.00 | $20.00 | Non publié | En ligne sur ChatGPT, Codex & API (9 juillet) ; tarif promotionnel au moins jusqu'au 21 novembre 2026 |
| GPT-5.6 Terra | $2.00 | $12.00 | Non publié | En ligne sur ChatGPT, Codex & API (9 juillet) |
| GPT-5.6 Luna | $0.20 | $1.20 | Non publié | En ligne sur ChatGPT, Codex & API (9 juillet) |
| Claude Opus 5.5 | 4,00 $ | 20,00 $ | 1M | Claude Pro/Max/Team ; API payante ; lectures de cache 0,20 $ |
| Claude Opus 5 | $5.00 | $25.00 | 1M | Modèle legacy chez Anthropic ; Pro/Max/API |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Modèle legacy chez Anthropic ; Pro/Max/API |
| Claude Fable 5.1 | $10.00 | $50.00 | 1M | Lectures de cache 0,25 $ ; dans Max/Team Premium (~50 % des limites d'usage) ; Pro/Team Standard via crédits. Mythos 5.1 se facture à l'identique, sur invitation uniquement |
| Claude Fable 5 | $10.00 | $50.00 | 1M | Permanent dans Max/Team Premium (~50 % des limites d'usage) ; Pro/Team Standard via crédits |
| Claude Sonnet 5.5 | 2,00 $ | 10,00 $ | 1M | Gratuit sur claude.ai ; Pro/Max/Team ; API payante ; lectures de cache 0,10 $ depuis le 7 octobre |
| Claude Sonnet 5 | $2.00 | $10.00 | 1M | Modèle legacy depuis le 28 septembre ; repli pour les requêtes de cybersécurité signalées ; API payante |
| Claude Sonnet 4.6 | $3.00 | $15.00 | 1M | API payante (remplacé par Sonnet 5) |
| Claude Haiku 5.5 | 0,10 $ (≤100K) / 0,50 $ (>100K) | 0,50 $ (≤100K) / 2,50 $ (>100K) | 1M | Free, Pro, Max, Team et Enterprise sur Claude.ai (web, iOS, Android) ; API payante ; lectures de cache 0,01 $ |
| Gemini 3.1 Pro | $2.00 (≤200K) / $4.00 (>200K) | $12.00 (≤200K) / $18.00 (>200K) | 1M | Application Gemini avec Google AI Pro ou plus depuis le 9 oct. ; API payante |
| Gemini 4 Argon | $2.00 au lancement jusqu’au 30/11 / $4.00 standard ($0.10 en cache, lancement) | $10.00 au lancement / $20.00 standard | 1M, partagé entre entrée et sortie | API payante depuis le 13 octobre ; application Gemini dans Google AI Pro et Ultra |
| Gemini 3.8 Flash | $0.75 introductif / $1.50 au 1/1/2027 | $3.75 introductif / $7.50 au 1/1/2027 | 1M | AI Studio, Antigravity, Gemini Enterprise + API payante ; dans l'application Gemini rapporté pour AI Pro/Ultra |
| Gemini 3.7 Flash | $0.75 introductif / $1.50 au 1/1/2027 | $3.75 introductif / $7.50 au 1/1/2027 | 1M | AI Studio, Android Studio, Antigravity + API payante ; dans l'application Gemini via Spark uniquement (AI Pro/Ultra, hors EEE/RU/CH/Nigeria) |
| Gemini 3.6 Flash | $0.75 introductif / $1.50 au 1/1/2027 | $3.75 introductif / $7.50 au 1/1/2027 | 1M | Application Gemini avec AI Plus ou plus depuis le 9 oct. ; AI Studio ; palier API gratuit + API payante |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 1M | AI Studio ; palier API gratuit + API payante |
| Qwen3.8-Max-0902 | 2,00 $ (0,17 $ cache hit explicite, 0,25 $ implicite) | 6,00 $ | 1M (sortie 128K) | API QwenCloud uniquement ; pas de chat grand public ; poids ouverts uniquement pour la version texte Qwen3.8-2.4T-A95B sur laquelle il repose |
| Qwen 3.7 Max | $1.25 promo / $2.50 liste | $3.75 promo / $7.50 liste | 1M | 200 requêtes gratuites/jour ; API payante au-delà |
| MiniMax M3 | $0.30 (50 % de remise sur $0.60) | $1.20 (≤512K) | 1M | Open weights ; coûts d'hébergement applicables |
| LongCat-2.0 | Selon le fournisseur | Selon le fournisseur | 1M | Open weights (MIT) ; coûts d'hébergement applicables |
| NVIDIA Nemotron 3 Ultra | Selon le fournisseur | Selon le fournisseur | 1M | Open weights (OpenMDW) ; coûts d'hébergement applicables |
| Qwen 3.5 (open-weight) | Auto-hébergement / Together | Auto-hébergement / Together | 1M | Open weights ; coûts d'hébergement applicables |
| Nex-N2-Pro | Auto-hébergement / fournisseurs | Auto-hébergement / fournisseurs | 1M | Open weights (Apache 2.0) ; coûts d'hébergement applicables |
| Rio 3.5 Open 397B | Auto-hébergement / fournisseurs | Auto-hébergement / fournisseurs | 1M | Open weights (MIT) ; coûts d'hébergement applicables |
| Grok 4.3 | $1.25 | $2.50 | 1M | Forfait grand public gratuit ; API payante |
| Grok 4.6 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | API SpaceXAI, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
| Grok 4.7 | 2,00 $ (<200K) / 4,00 $ (≥200K) | 6,00 $ (<200K) / 12,00 $ (≥200K) | 500K | API SpaceXAI, Cursor, Grok Build, harnesses et routeurs cloud ; pas dans l'application Grok |
| Muse Spark 1.3 | $1.25 ($0.10 palier Contributor) | $4.25 ($0.20 palier Contributor) | 1M | API payante ; Muse Code, Meta Model API et OpenRouter ; le palier Contributor échange des droits d'entraînement contre une remise de ~92 % |
| Muse Wonder | $4.00 | $20.00 | 1M | API payante ; Meta Model API, Muse Code et OpenRouter ; Muse Wonder Full uniquement dans Muse Code, sur les forfaits à $50 et $200 |
| Kimi K3 | $3.00 ($0.30 cache-hit) | $15.00 | 1M | Palier de base gratuit dans l'application Kimi ; open weights sur Hugging Face (Kimi K3 License) |
| Mistral Large 4 | $1.36 ($0.68 sur la page du modèle chez Mistral) | $4.18 ($2.09) | 512K (1M selon Mistral) | API en préversion publique depuis le 6 octobre ; poids ouverts promis d'ici fin octobre, aucune licence annoncée pour l'instant |
| Gemini Omni Flash (vidéo) | $1.50 | $17.50 (sortie vidéo) | Clips de 10 secondes | Application Gemini / Flow ; AI Studio + API |
| DeepSeek V4-Pro | $0.66 hors pointe / $1.32 en pointe ($0.022 cache-hit hors pointe) | $1.98 hors pointe / $3.96 en pointe | 1M | DeepSeek Chat gratuit ; API payante, tarifs de pointe et hors pointe depuis le 16 août |
| DeepSeek V4.1-Flash | 0,15 $ hors pointe / 0,30 $ en pointe (0,003 $ succès de cache hors pointe) | 0,60 $ hors pointe / 1,20 $ en pointe | 1M | DeepSeek Chat gratuit ; API payante, tarifs heures pleines et creuses ; a remplacé V4-Flash le 10 septembre |
| Kimi K2.7 Code | Selon le fournisseur | Selon le fournisseur | 256K | Open weights ; coûts d'hébergement applicables |
| GLM-5.2 | Selon le fournisseur | Selon le fournisseur | 1M | Open weights ; coûts d'hébergement applicables |
| GLM 5.3 | $1.40 ($0.26 cache-hit) | $4.40 | 1M | API Z.ai, GLM Coding Plan et ZCode ; poids sur Hugging Face depuis le 28 août sous la licence maison GLM 5.3 License |
| GLM 5.3 Flash | $0.15 ($0.03 cache-hit) | $0.50 | 1M | API Z.ai, GLM Coding Plan, OpenRouter ; poids MIT sur Hugging Face ; la promo de lancement a pris fin le 9 septembre |
| Tencent Hy4 Preview | $0.834 ($0.042 cache-hit) | $2.501 | 1M+ | Poids ouverts (Apache 2.0) ; Tencent Cloud TokenHub, OpenRouter, WorkBuddy, CodeBuddy |
| Qwen3.8-Flash-Next | Selon le fournisseur | Selon le fournisseur | 262K (jusqu'à 1M) | Poids ouverts (Qwen Community License 1.0) ; coûts d'hébergement en sus |
| MiMo-V2.6-Pro | 0,435 $ | 0,87 $ | 1M | Poids ouverts (MIT) ; coûts d'hébergement à prévoir |
| ERNIE 5.1 | Tarif région Chine | Tarif région Chine | 256K | Palier gratuit de Baidu |
| Gemini Spark (agent) | Sans tarif API | Sans tarif API | 1M (base Gemini) | Google AI Pro 19,99 $, AI Ultra 99,99 $ ou 199,99 $/mois |
| Fello AI (agrégateur) | Acheminé via l'app | Acheminé via l'app | Selon le modèle | À partir de 11,99 $/mois, version gratuite disponible |
Les tarifs de GPT-5.5 et GPT-5.5 Pro ci-dessus sont des prix de contexte court ; OpenAI ne publie plus les chiffres spécifiques de contexte long. Les paliers GPT-5.6 sont facturés à 2x l'entrée et 1,5x la sortie une fois qu'un prompt dépasse 272K tokens d'entrée, ce qui place Terra en contexte long à 4 $ / 18 $ et Luna à 0,40 $ / 1,80 $. Les paliers GPT-6 portent le même supplément au-delà de 272K tokens d'entrée, appliqué à toute la requête, et leurs lectures en cache sont remisées de 90 % : 1,00 $ pour Astra, 0,20 $ pour GPT-6 Sol et 0,01 $ pour Luna, GPT-6.1 Sol étant remisé de 95 %, à 0,10 $.
Grok 4.6 fonctionne de la même façon, mais mord plus fort : à partir de 200 000 tokens de prompt, SpaceXAI refacture la requête entière au tarif supérieur plutôt que le seul dépassement, si bien que dépasser le seuil de mille tokens double le coût de tout l'appel. L'autre grille à lire deux fois est celle de DeepSeek : depuis le 16 août, ses deux modèles V4 sont facturés au tarif de pointe de 01h00 à 04h00 et de 06h00 à 10h00 UTC en semaine, et à exactement la moitié à toute autre heure, si bien que la même tâche peut coûter le double selon le moment où vous la lancez.
Le moyen le moins cher de traverser ce tableau est souvent un abonnement au lieu de trois. Fello AI réunit GPT, Claude, Gemini, Grok, Perplexity et d'autres dans une seule app pour Mac, iPhone et iPad, à partir de 11,99 $ par mois dans la plupart des pays.
Meilleurs modèles open-weight en octobre 2026
Le meilleur modèle à poids ouverts en octobre 2026 est le MiMo-V2.6-Pro de Xiaomi, publié le 21 septembre sous licence MIT simple : 1,02 billion de paramètres dont 42 milliards actifs et un contexte de 1M de tokens. Artificial Analysis le mesure à 46,3 sur l'Intelligence Index v4.3.2, le meilleur score ouvert qu'elle ait jamais publié, devant GLM-5.3 à 44,8 et Kimi K3 à 43,6, pour seulement 0,13 $ par tâche de l'indice. La limite : les votants humains d'Arena ne le classent que 19e sur WebDev et 26e sur le texte.
Deux autres modèles ouverts mènent encore quelque part. Kimi K3 est le modèle ouvert le mieux classé sur Arena, quatorzième sur WebDev et quatorzième sur l'Agent Arena. GLM-5.3 est le modèle ouvert le plus fort sur Terminal-Bench 4.0 à 41,9 %, mais sous une licence Z.ai propre et non MIT.
Pour les équipes qui hébergent leurs propres poids, le choix pratique reste GLM 5.3 Flash (Z.ai, MIT) : 41,8 sur v4.3.2 pour 320 Md au total dont 18 Md actifs. Ce n'est pas un GLM 5.3 allégé mais un modèle distinct sur une base réentraînée, d'où sa licence MIT. Un modèle de 1,02 billion de paramètres n'est pas une affaire de station de travail, et le seul téléchargement de K3 pèse environ 1,56 To. Dans l'étage le moins cher, DeepSeek-V4.1-Flash a remplacé V4-Flash le 10 septembre : MIT, nativement multimodal, 39,5 sur v4.3.2 et 0,15 $ / 0,60 $ hors pointe.
Trois autres sont à surveiller. Mistral Large 4 (en préversion publique depuis le 6 octobre) est le modèle le mieux noté venu des États-Unis ou d'Europe à promettre des poids ouverts, à 38,4, mais il n'est pas encore téléchargeable : Mistral promet les poids d'ici fin octobre et n'a pas indiqué de licence. Le Qwen3.8-Flash-Next d'Alibaba, 125 Md dont seulement 6 Md actifs, préfigure l'architecture Qwen4 et obtient 39,8. Le Hy4 Preview de Tencent, 770 Md au total et 49 Md actifs sous Apache 2.0, n'a pas de note d'Artificial Analysis mais se situe dix-huitième sur Arena WebDev.
| Modèle | Idéal pour | Benchmark clé | Contexte / Licence | Où l'exécuter |
|---|---|---|---|---|
| MiMo-V2.6-Pro | Le plus haut Intelligence Index ouvert jamais mesuré | II 46,3 (v4.3.2), au-dessus de GLM-5.3 et Kimi K3, à 0,13 $ par tâche ; 34,8 % Terminal-Bench 4.0 ; GDPval-AA v2.1 1685 ; 1,02 billion/42 Md actifs | 1M / MIT | Hugging Face (XiaomiMiMo), fournisseurs, auto-hébergement |
| Kimi K3 | Modèle ouvert le mieux classé sur Arena | II 43,6 (v4.3.2) ; #14 Arena WebDev, meilleure place ouverte ; #14 Agent Arena ; 2.8T/104B actifs | 1M / Kimi K3 License | Hugging Face (96 shards, 1.56 To), Moonshot API, fournisseurs |
| GLM 5.3 Flash | Meilleur modèle ouvert que la plupart des équipes peuvent réellement faire tourner | II 41,8 (v4.3.2), sur la frontière de Pareto intelligence-coût à environ $0.25 par tâche de l'index ; 320B/18B actifs, nativement multimodal | 1M / MIT | Hugging Face, API Z.ai ($0.15/$0.50), OpenRouter |
| GLM-5.2 | Repli avec un bilan indépendant | II 33,7 (v4.3.2) ; #27 Arena WebDev (1,603.2), #20 Agent Arena ; 744B/40B actifs | 1M / MIT | Z.ai, Hugging Face, OpenRouter |
| GLM 5.3 | Ouvert depuis le 28 août, mais sous licence maison | II 44,8 (v4.3.2), le meilleur score ouvert que nous ayons trouvé ; même base 744B que GLM-5.2, post-entraînée seulement, checkpoint publié compté à 753B ; CyberGym 84,5 % et Terminal-Bench 3.0 28,3 (chiffres de l'éditeur) | 1M / GLM 5.3 License (model-as-a-service au-delà de 10 Md$ de CA nécessite une revue de sécurité Z.ai) | Hugging Face, API Z.ai ($1.40/$4.40), GLM Coding Plan, ZCode |
| DeepSeek V4.1-Flash | Meilleur rapport qualité-prix ouvert si vous l'hébergez vous-même | II 39,5 (v4.3.2) contre 34,3 pour la version V4-Flash 0731 qu'il remplace ; 552B, 8B actifs au prefill et 16B au décodage | 1M / MIT | DeepSeek API (0,15 $/0,60 $ hors pointe, 0,30 $/1,20 $ en pointe depuis le 10 septembre), local |
| Tencent Hy4 Preview | Plus grand modèle sous licence permissive à ce jour | 770B/49B actifs ; 2,99/4,00 sur le panel maison de Tencent de 203 tâches contre 2,94 pour Kimi K3 et 2,92 pour GLM 5.3 (éditeur) ; pas de note Artificial Analysis ; #18 Arena WebDev (1632), #19 Agent Arena | 1M+ / Apache 2.0 | Hugging Face (BF16 et FP8), Tencent Cloud TokenHub, OpenRouter |
| Qwen3.8-Flash-Next | Avant-goût de l'architecture Qwen4 | 125B au total plus un embedding N-gramme de 51B, 6B actifs ; 91,7 GPQA Diamond et 62,5 SWE-Bench Pro (éditeur) ; II 39,8 (v4.3.2) ; #17 Arena WebDev (1633) | 262K à 1M / Qwen Community License 1.0 | Hugging Face, fournisseurs, auto-hébergement |
| LongCat-2.0 | Programmeur ouvert frontier entraîné sur des puces chinoises | II 33 (v4.1) ; 59,5 % SWE-Bench Pro (éditeur), 1.6T/~48B actifs | 1M / MIT | Hugging Face, GitHub, OpenRouter |
| MiniMax M3 | Multimodal bon marché à long contexte | II 29,2 (v4.3.2 ; 44 en v4.1), 59 % SWE-Bench Pro, multimodal | 1M / MiniMax Community License | Hugging Face, API 0,30 $/1M (50 % de remise) |
| Nex-N2-Pro | Meilleur score de programmation ouvert | II 41 (v4.1) ; 80,8 SWE-Bench Verified, 397B/17B actifs | Basé sur Qwen / Apache 2.0 | Hugging Face, fournisseurs, auto-hébergement |
| Kimi K2.7 Code | Meilleur programmeur ouvert sous licence commerciale | +21,8 % sur Kimi Code Bench v2 vs K2.6 (éditeur) ; 1T/32B actifs | 256K / Modified MIT | Hugging Face, DeepInfra, fournisseurs |
| DeepSeek V4-Pro | Travail agentique en conditions réelles | II 44 (v4.1), 1.6T/49B actifs | 1M / MIT | DeepSeek API (0,66 $/1,98 $ hors pointe, 1,32 $/3,96 $ en pointe depuis le 16 août), local |
| Hy3 | Le plus récent arrivant à licence permissive | II 41 (v4.1) ; #56 sur Arena WebDev (1,508.4) | Apache 2.0 | Hugging Face, fournisseurs, auto-hébergement |
| Inkling | Premier open model de Thinking Machines | II 41 (v4.1), agentique 32,3, sorti le 15 juillet | Open weights | Hugging Face, fournisseurs, auto-hébergement |
| Inkling Small | Même famille à un quart de la taille | II 40 (v4.1), agentique 30,8 ; 276B/12B actifs, entrée texte, image et audio | Apache 2.0 | Hugging Face (BF16 et NVFP4), fournisseurs, auto-hébergement |
| NVIDIA Nemotron 3 Ultra | Affiné par NVIDIA, licence entièrement permissive | II 38 (v4.1), 65-70,4 SWE-Bench Verified, 550B/55B actifs | 1M / OpenMDW | OpenRouter, Hugging Face, AWS (8x B200 auto-hébergement) |
| Qwen 3.5 (397B / 17B actifs) | Multimodal, décodage rapide | 88,4 GPQA, 91,3 AIME 2026, 83,6 LiveCodeBench v6 | 1M / ouvert | Together, OpenRouter, local |
| Qwen3.6-35B-A3B | Programmeur agentique ouvert efficace (3B actifs) | 86,0 GPQA Diamond, 92,7 AIME 2026, 35B/3B actifs | 262K (jusqu'à 1M YaRN) / Apache 2.0 | Hugging Face, OpenRouter, local |
| Qwen3.6-27B | Programmeur dense exécutable sur portable | 87,8 GPQA Diamond, dense 27B, multimodal | 256K / Apache 2.0 | Local Mac/PC, Hugging Face, OpenRouter |
| Rio 3.5 Open 397B | Fine-tune de Qwen 3.5, raisonnement multilingue | 70,8 Terminal-Bench 2.1 (first-party), bat Qwen 3.7 Plus sur 4/5 | 397B/17B actifs / MIT | Hugging Face, fournisseurs, auto-hébergement |
| Llama 4 Maverick | Modèle phare de la lignée Meta | 17B actifs / 400B de paramètres au total | Llama 4 license | Cloud Meta, Hugging Face, local |
| NVIDIA Nemotron 3 Nano Omni | Edge / faible consommation | Multimodal, empreinte très réduite | Compact / ouvert | Local, outil NVIDIA |
Ici la licence compte autant que le score brut, et août a creusé l'écart entre les deux groupes. Kimi K2.7 (Modified MIT), DeepSeek V4 (MIT), GLM 5.3 Flash (MIT), MiMo-V2.6-Pro (MIT), GLM-5.2 (MIT), LongCat-2.0 (MIT), Hy3 (Apache 2.0), Hy4 Preview (Apache 2.0), Nex-N2-Pro (Apache 2.0) et Nemotron 3 Ultra (OpenMDW) autorisent tous clairement l'usage commercial sans examen du chiffre d'affaires.
Le reste porte des conditions à lire avant de construire dessus : MiniMax M3 et MiniMax H3 arrivent sous leurs propres licences communautaires, H3 exigeant en plus une demande depuis les États-Unis, l'UE, le Royaume-Uni et la Corée du Sud ; Kimi K3 se place sur une licence maison avec un seuil de revenus pour quiconque le revend comme service ; GLM 5.3 impose une revue de sécurité Z.ai à tout opérateur de model-as-a-service au-delà de 10 milliards de dollars de chiffre d'affaires ; et la Qwen Community License 1.0 de Qwen3.8-Flash-Next impose une licence distincte de Qwen pour exploiter une activité de model-as-a-service ou d'assistant de travail IA, l'usage interne restant exempté. Aucun open model n'est plus premier sur aucun classement d'Arena que nous suivons : Claude Opus 5 a pris le classement Agent en juillet, le dernier qu'un open model ait dominé.
Benchmarks, prix et usage sur le terrain
Chaque classement de cette page combine trois éléments : des benchmarks publics de sept maisons indépendantes (Artificial Analysis, Arena anciennement LMArena, Scale SEAL, LiveBench, EQ-Bench, ARC Prize et le classement officiel Terminal-Bench 4.0, couvrant l'index Intelligence, GPQA Diamond, ARC-AGI-1 à 3, Humanity's Last Exam, GDPval-AA, FrontierMath, HMMT, MCP Atlas, SWE Atlas et le Remote Labor Index), les tarifs d'API et d'abonnement publiés sur la page de prix officielle de chaque fournisseur, et l'usage sur le terrain par l'équipe éditoriale de FelloAI qui exécute de vrais prompts sur la même tâche sur chaque modèle. Nous récupérons de nouveau les sources officielles de prix et de benchmarks avant chaque mise à jour mensuelle.
Les benchmarks sont pondérés selon le cas d'usage : SWE-bench et Terminal-Bench portent la programmation, GPQA Diamond et ARC-AGI-2 portent la précision, GDPval-AA (le benchmark de livrables professionnels d'Artificial Analysis) informe la qualité des tâches professionnelles tandis que le style d'écriture est jugé avant tout par des tests sur le terrain, FrontierMath et HMMT portent la résolution de problèmes. Nous précisons quand un benchmark est annoncé par l'éditeur mais non vérifié de façon indépendante, et nous écartons toute affirmation que nous ne pouvons pas reproduire face à une source en direct. Nous classons sur les scores mesurés : la couronne d'une catégorie change dès qu'un modèle dépasse le tenant sur les classements qui définissent cette catégorie, sans attendre les classements fondés sur des votes, et un modèle qui n'est pas encore largement disponible est signalé sur sa carte plutôt que privé de carte. Nous revérifions les rangs autant que les chiffres, car un score peut rester exact pendant que le classement autour de lui bouge. Lorsqu'un modèle passe par une mise à niveau majeure entre deux mises à jour, nous reclassons la catégorie et ajoutons une ligne « Ce qui a changé ce mois-ci » au bas de l'analyse approfondie.
Posez la question à ChatGPT, Claude et Gemini et gardez la meilleure réponse. Sans trois factures.
Fello AI fonctionne sur Mac, iPhone et iPad, gratuitement pour démarrer.
Télécharger Fello AI