Beste KI 2026: welche KI ist aktuell die beste?
KI-Ranking und KI-Vergleich nach Einsatzzweck, monatlich aktualisiert, sobald neue Modelle erscheinen.
Google hat am 30. September Gemini 4 Argon angekündigt, sein erstes Flaggschiff seit Gemini 3.1 Pro, und die unabhängigen Boards setzen es direkt in die Spitzengruppe: Artificial Analysis gibt ihm 52,6 auf Intelligence Index v4.3.2, gleichauf mit GPT-6 Astra und nur hinter Claude Opus 5.5, Claude Sonnet 5.5 und Claude Fable 5.1, mit der niedrigsten Halluzinationsrate, die es unter den führenden Modellen gemessen hat, und Arena führt es auf Platz eins seines Text-Boards und seines Boards für kreatives Schreiben. Auf dieser Seite gewinnt es keine Kategorie, aus zwei Gründen: Die meisten Boards, nach denen wir unsere Kategorien entscheiden, haben es noch nicht bewertet, und nutzen können es nur geprüfte Cyber-Verteidiger in Googles Fairwind-Programm. Laut Google folgen zahlende API-Kunden und Abonnenten von Google AI Ultra, ohne Datum, zum Einführungspreis von $2 / $10 pro 1M Tokens.
Die meisten gemessenen Kronen hält weiterhin Anthropic. Claude Opus 5.5 (22. September) ist #1 im Intelligence Index mit 57,6 und auf Arenas WebDev-Board und behält zu $4 / $20 die Coding-Krone; Claude Sonnet 5.5 (28. September) ist mit 56,0 Zweiter, führt Terminal-Bench 4.0 zum selben Preis von $2 / $10 wie Sonnet 5 an und ist das Claude-Modell, das Sie kostenlos auf claude.ai nutzen können. Claude Fable 5.1 behält Schreiben und Genauigkeit auf den Boards, nach denen diese Kategorien entschieden werden. Diese Seite rankt nach gemessenen Werten, eine Krone wandert also, sobald ein Modell den Halter übertrifft, ohne auf die abstimmungsbasierten Boards zu warten. Unser Leitfaden zu KI-Benchmarks erklärt, wie dieser Index aufgebaut ist und warum seine Versionsnummer zählt.
OpenAIs Antwort ist der Preis. GPT-6 Sol und GPT-6 Luna (22. September) haben die API-Preise halbiert, und GPT-6.1 Sol (29. September) erreicht zum selben Preis von $2 / $10 einen Wert von 51,8, unter den eigenständigen Modellen Platz sechs, mit $0,72 pro Index-Aufgabe aber das günstigste der Spitzengruppe. ARC Prize setzt es jetzt mit 94,2 % auf Platz zwei von ARC-AGI-2, 0,8 Punkte hinter GPT-6 Astra, und Arena auf Platz vier bei WebDev. Keines der GPT-6-Modelle ist bisher im Chatfenster von ChatGPT: Sie laufen in ChatGPT Work und Codex.
SpaceXAIs Grok 4.7 (21. September) kam zu unveränderten $2 / $6 in die API, zu Cursor und Grok Build, während die Grok-App weiterhin 4.6 ausliefert, und Xiaomis MiMo-V2.6-Pro (21. September, schlichtes MIT) bleibt mit 46,3 und $0,13 pro Index-Aufgabe das am höchsten bewertete offene Modell. Unten stehen die Kategoriesieger für Oktober 2026. Klicken Sie auf eine Karte, um direkt zur vollständigen Analyse zu springen, oder nutzen Sie die feststehende Navigation, um zwischen den Kategorien zu wechseln. Rankings, Benchmarks und Preise werden innerhalb von 48 Stunden nach jedem großen Modell-Launch aktualisiert.
Willst du die besten KI-Modelle, ohne mit separaten Abos zu jonglieren? Fello AI vereint die führenden Modelle in einer nativen App für Mac, iPhone und iPad.
Fello AI laden30. Sep. Google Gemini 4 Argon führt Arenas Text-Board an und zieht im Intelligence Index mit GPT-6 Astra gleich, nutzen können es aber nur Cyber-Verteidiger Neu
29. Sep. OpenAI GPT-6.1 Sol erreicht zu $2 / $10 Platz fünf im Intelligence Index, pro Aufgabe das günstigste Modell der Spitzengruppe Neu
28. Sep. Anthropic Claude Sonnet 5.5 landet mit 56,0 auf Platz zwei des Intelligence Index, zum Sonnet-Preis von $2 / $10 Neu
22. Sep. OpenAI GPT-6 Sol und GPT-6 Luna halbieren OpenAIs API-Preise und landen überall außer im Chatfenster von ChatGPT Neu
22. Sep. Anthropic Claude Opus 5.5 holt sich den Intelligence Index mit 57,6 und unterbietet Opus 5 im Preis Neu
21. Sep. SpaceXAI Grok 4.7 kommt auf einem größeren Basismodell zu unveränderten $2 / $6 und kostet 47 % mehr pro Aufgabe Neu
21. Sep. Xiaomi Xiaomis MiMo-V2.6-Pro ist das am höchsten bewertete offene Modell überhaupt, zu $0,13 pro Index-Aufgabe unter MIT Neu
20. Sep. Alibaba Qwen-Image-2.1 ist das beste Bildmodell zum Herunterladen, doch die Lizenz erlaubt nur Forschung Neu
15. Sep. TypeSafe TypeSafe verlässt den Stealth-Modus mit Jev, einem Modell, das statt Text typisierte Entscheidungen liefert, für $0.042 pro 1M Tokens Neu
10. Sep. DeepSeek DeepSeek stellt V4-Flash ein, ersetzt es durch V4.1-Flash und senkt den Flash-Tarif um rund ein Drittel Neu
3. Sep. OpenAI GPT-6 Astra startet für $10 / $50 und ist binnen eines Tages auf Plus und Pro und führt die Coding-Boards an Neu
2. Sep. Alibaba Qwen3.8-Max-0902 nimmt Claude Opus 5 Arenas WebDev-Board um drei Punkte ab, für $2 / $6 Neu
2. Sep. Muse Spark 1.3, Intelligence Index von 57 auf 61 bei unveränderten $1.25 / $4.25, gewinnt beim Coding und verliert jede Agenten-Zeile Neu
2. Sep. Google Gemini 3.8 Flash, drei Punkte mehr auf dem Intelligence Index zum selben $0.75 / $3.75 Neu
1. Sep. Anthropic Claude Fable 5.1 und Mythos 5.1, eine neue #1 auf Artificial Analysis mit 66 und 75 % weniger für Cache-Reads Neu
Ausstehend Google Gemini 3.5 Pro, weiterhin unveröffentlicht, und Gemini 4 Argon hat es überholt Verzögert
Beste KI zum Schreiben
Die beste KI zum Schreiben ist Claude Fable 5.1, und das Argument dafür ist Beständigkeit statt eines einzelnen ersten Platzes. Auf allen drei Text-Boards liegt es in den Top zehn: Zweiter auf EQ-Bench Creative Writing v3 mit 2162,0, Dritter auf LiveBench Language mit 89,5 und Zehnter auf Arenas Board für kreatives Schreiben. Kein anderes Modell platziert sich auf allen dreien so gut. Gemini 4 Argon führt jetzt Arenas Boards für kreatives Schreiben und Text an, mit 1518,8 und 1525,2, doch weder EQ-Bench noch LiveBench haben es bewertet, und nutzen können es nur Googles Fairwind-Partner. Claude Opus 5.5 ist auf Arenas Board für kreatives Schreiben mit 1516 Zweiter, auf EQ-Bench aber Siebter und auf LiveBench Language Achter; GPT-6 Astra führt EQ-Bench mit 2173,3 an, liegt auf Arenas Board für kreatives Schreiben aber nur auf Rang 39; Claude Fable 5 führt LiveBench Language mit 90,7 an und ist auf Arenas Board für kreatives Schreiben Dritter, auf EQ-Bench aber Elfter. Wenn Ihr Schreiben eher ein Arbeitsergebnis als Prosa ist, ist das Board für professionelle Deliverables GDPval-AA v2.1 eine andere Frage: Dort führt Claude Opus 5.5 mit 1867, Claude Sonnet 5.5 liegt 27 Punkte dahinter bei 1840 und Claude Fable 5.1 bei 1758. Claude Sonnet 5.5 ist der Preis-Leistungs-Tipp im kostenlosen Tarif, da es jeder auf claude.ai nutzen kann, erreicht aber nur 83,4 auf LiveBench Language, liegt auf Arenas Board für kreatives Schreiben erst auf Rang 42 und hat noch keine EQ-Bench-Bewertung. Claude Fable 5 ist der Tipp, wenn Sie Arenas menschliche Stimmen höher gewichten als die Harness-Werte; es kostet $10 / $50 pro 1M Tokens und ist dauerhaft in Claude Max und Team Premium mit etwa 50 % der regulären Nutzungsgrenzen enthalten. Übersetzung ist eine eigene Frage mit eigenem Sieger, die wir in unserem Leitfaden zur besten KI für Übersetzungen durchgehen.
| Modell | Am besten für | Stärke | Schwäche | Preis (pro 1M Tokens) |
|---|---|---|---|---|
| Claude Fable 5.1 | Bestes Schreiben insgesamt | #2 EQ-Bench Creative Writing (2162,0), #3 LiveBench Language (89,5) und #10 Arena kreatives Schreiben, die beste Gesamtplatzierung aller Modelle | Führt keines der drei klar an; Arenas Board für kreatives Schreiben führt jetzt Gemini 4 Argon an, vor Claude Opus 5.5 | $10 / $50 |
| Claude Fable 5 | Stark auf den Boards mit menschlichen Stimmen | #1 LiveBench Language (90,7), #3 Arena kreatives Schreiben (1503,0), #3 Arena Text (1504,9) | #11 EQ-Bench; teuerste Option hier | $10 / $50 |
| Kimi K3 | Kreative Fiktion und Stimme | #5 EQ-Bench Creative Writing (2082,3) | Nur #26 auf Arena Creative Writing | $3 / $15 |
| Claude Sonnet 5.5 | Kostenloses Alltagsschreiben | Kostenlos auf claude.ai, 1M Kontext; #2 GDPval-AA v2.1 (1840), 27 Punkte hinter Opus 5.5 | 83,4 LiveBench Language; #42 Arena kreatives Schreiben; auf EQ-Bench noch unbewertet | $2 / $10 |
| Claude Opus 5.5 | Bestes verfügbares Modell bei Arenas kreativem Schreiben | #2 Arena kreatives Schreiben (1516) und #4 Arena Text (1504); #1 GDPval-AA v2.1 (1867) | #7 EQ-Bench und #8 LiveBench Language | $4 / $20 |
| Gemini 4 Argon | Noch nicht verfügbar | #1 Arena kreatives Schreiben (1521,8) und #1 Arena Text (1524,8) | Auf EQ-Bench und LiveBench nicht bewertet; nur Fairwind-Partner | $2 / $10 zur Einführung, $4 / $20 regulär |
| GPT-5.5 | Faktenbasiertes Business-Schreiben | Dokumentierte Zuwächse bei faktischer Verlässlichkeit gegenüber GPT-5.4 | Reasoning-Stufen jetzt als veraltet markiert | $5 / $30 |
| Gemini 3.8 Flash | Massen-Entwürfe in großem Umfang | Intelligence Index 40,9, 308,4 Tok/s Ausgabe, 1M Kontext | Eher auf Agenten als auf Prosa getrimmt; Einführungspreis verdoppelt sich am 1. Januar 2027 | $0.75 / $3.75 |
Die Schreibkrone bleibt bei Claude Fable 5.1, doch sein Vorsprung auf Arena ist geschrumpft. Googles Gemini 4 Argon, angekündigt am 30. September, ging mit 1521,8 direkt auf Platz eins von Arenas Board für kreatives Schreiben, schob Claude Opus 5.5 auf Platz zwei und Claude Fable 5 auf Platz drei, und Fable 5.1 rutschte von Rang sieben auf Rang zehn, weshalb diese Karte jetzt die Top zehn auf allen drei Text-Boards beansprucht statt der Top sieben. Argon kann die Krone nicht holen: EQ-Bench und LiveBench haben es nicht bewertet, und nutzen können es nur Googles Fairwind-Partner. Im September kamen Claude Opus 5.5 und Claude Sonnet 5.5, Sonnet 5.5 löste Sonnet 5 als kostenlosen Tipp ab, und GPT-6.1 Sol stieg auf LiveBench Language als Zweiter ein und verdrängte Fable 5.1 dort auf Platz drei.
Beste KI für Chat & Alltag
Die beste KI für den täglichen Chat ist GPT-5.6, und der ehrliche Grund ist Reichweite statt Board-Position. Es ist das Modell, das ChatGPT der größten Nutzerbasis der Kategorie standardmäßig ausliefert, was es zum besten Assistenten macht, den die meisten Menschen tatsächlich öffnen können. Bei der reinen menschlichen Präferenz ist es nicht der Spitzenreiter: GPT-5.6 Sol sitzt mit 1483,8 auf #20 von Arenas Text-Leaderboard, wo jetzt Gemini 4 Argon mit 1524,8 führt und Claude Opus 5.5 mit 1504,0 Vierter ist. Die meisten ChatGPT-Nutzer bekommen die ausgewogene Terra-Stufe, von der OpenAI sagt, sie entspreche GPT-5.5 und koste seit der Preissenkung vom 30. Juli 2026 60 % weniger. Es ist verfügbar in ChatGPT (kostenlos mit Limits, Plus zu $20/Monat, Pro zu $100/Monat), über die API (die 5.6-Stufen: Luna $0.20 / $1.20, Terra $2 / $12, Sol $4 / $20 pro 1M Tokens) und gebündelt in Fello AI neben Claude, Gemini, Grok und DeepSeek. Ein Vorbehalt: OpenAIs System Card und der Prüfer METR meldeten erhöhtes „Scheming"-Verhalten in Sol, sodass GPT-5.5 Instant der sicherere Tipp für halluzinationsempfindliche Arbeit bleibt.
| Modell | Am besten für | Stärke | Schwäche | Preis |
|---|---|---|---|---|
| GPT-5.6 | Täglicher Chat, ChatGPTs Standard | Der Assistent, den die meisten öffnen können; Terra entspricht GPT-5.5 zu ~halbem Preis | #20 auf Arena Text; Scheming von METR gemeldet | Kostenlos / $20/Mon. Plus; API $0.20 / $1.20 bis $4 / $20 |
| Claude Opus 5.5 | Konversation mit dem höchsten Indexwert | #1 auf dem Intelligence Index (57,6) und #4 auf Arena Text (1504,0) | Nicht im Free-Tarif; auf Pro mit Nutzungsgrenzen | $20/Mon. Pro, $4 / $20 API |
| Gemini 4 Argon | Noch nicht verfügbar | #1 auf Arena Text (1524,8); 15 % Halluzinationsrate, die niedrigste unter den führenden Modellen | Nur Fairwind-Partner; nicht in der Gemini-App | $2 / $10 API zur Einführung, sobald verfügbar |
| Claude Sonnet 5.5 | Kostenloser Claude-Chat | Kostenlos auf claude.ai; #2 auf dem Intelligence Index (56,0), nur hinter Claude Opus 5.5 | Auf Arena Text noch unbewertet; läuft in den Apps standardmäßig mit dem Aufwand Medium | Kostenlos / $20/Mon. Pro, $2 / $10 API |
| GPT-5.5 Instant | Halluzinationsempfindliche Alltagsarbeit | 52,5 % weniger halluzinierte Aussagen vs. 5.3 Instant | Reasoning-Stufen jetzt als veraltet markiert | $20/Mon. Plus; API $5 / $30 |
| Gemini 3.6 Flash | Schnell, günstig, multimodal | Modell der kostenlosen Gemini-Stufe bis zum 9. Oktober (danach AI Plus), 1M Kontext, #21 auf Arena Text | Schwächer beim schwersten Reasoning; 3.8 Flash übertrifft es zum selben Preis | Kostenlos / $0.75 / $3.75 API |
| Fello AI | Alle Top-Modelle, eine App | ChatGPT + Claude + Gemini + Grok + DeepSeek und mehr auf Mac, iPhone und iPad | Über die App geroutet, nicht direkt | $9.99/Mon. |
GPT-5.6 behält den Chat-Tipp wegen der Reichweite, und daran, wer was öffnen kann, hat sich nichts geändert: GPT-5.6 Luna ist weiterhin ChatGPTs kostenloser Standard, und die GPT-6-Modelle laufen weiterhin in ChatGPT Work und Codex statt im Chat. Das Präferenz-Board hat sich erneut bewegt. Gemini 4 Argon, angekündigt am 30. September, übernahm mit 1524,8 Platz eins auf Arenas Text-Board, und Claude Opus 5.5, das es vor einer Woche anführte, ist mit 1504,0 jetzt Vierter, etwa einen Punkt hinter Claude Opus 4.6 und Claude Fable 5. Opus 5.5 behält den zweiten Podiumsplatz als bestbewertetes Modell im Index von Artificial Analysis; Argon bleibt vom Podium fern, weil es nur Googles Fairwind-Partner nutzen können und es nicht in der Gemini-App ist. Im September wurde Claude Sonnet 5.5 das kostenlose Claude-Modell und übernahm den dritten Podiumsplatz von Claude Opus 5.
Beste KI für Bilder
Die beste KI für Bildgenerierung ist ChatGPT Images 2.5, das OpenAI am 8. September in jedem ChatGPT-Tarif zum Standard gemacht hat und das alle vier von uns verfolgten Bild-Boards anführt. Seine zwei Modelle belegen auf jedem die Plätze eins und zwei: GPT-Image-2.5 Sunburst, auf Präzision ausgelegt, führt Arena Text-zu-Bild mit 1423,6 und Arenas Bildbearbeitung mit 1522,4 an, bei Artificial Analysis AA-Image-T2I v2.0 mit 1197 und AA-Image-Editing v2.0 mit 1182, und das schnellere GPT-Image-2.5 Flare ist auf allen vier Zweiter. Den Abstand zwischen Sunburst und Flare bei Arena Text-zu-Bild sollten Sie als vorläufig lesen, denn jedes beruht auf etwa 11.000 Stimmen gegenüber 89.000 für GPT Image 2. MAI-Image-2.6 ist Zweiter, Dritter auf dem Bearbeitungs-Board von Artificial Analysis und Vierter bei Arena Text-zu-Bild mit 1335,0. Dritter ist Grok Imagine Image 2.0 von SpaceXAI, im August erschienen und in Grok Imagine sowie über die xAI-API verfügbar: Es ist Vierter auf dem Text-zu-Bild-Board von Artificial Analysis und Vierter bei Arenas Bildbearbeitung und liegt damit auf drei der vier Boards vor Metas Muse Image. Das beste Bildmodell zum Herunterladen ist Alibabas Qwen-Image-2.1, am 20. September erschienen und jetzt das am höchsten platzierte Open-Weight-Modell auf allen vier Boards, Platz 17 bei Arenas Bildbearbeitung und Platz 18 auf den anderen drei. Seine Lizenz erlaubt allerdings nur Forschung und Evaluierung, eine kostenlose kommerzielle Option ist es also nicht. Unsere vollständige Übersicht über die Neuerungen finden Sie in ChatGPT Images 2.5.
| Modell | Am besten für | Stärke | Schwäche | Preis |
|---|---|---|---|---|
| ChatGPT Images 2.5 | Bilder mit lesbarem Text | #1 und #2 auf allen vier Boards: Arena Text-zu-Bild (1423,6 / 1400,9), Arena Bearbeitung (1522,4 / 1478,5), Text-zu-Bild bei Artificial Analysis (1197 / 1191) und Bearbeitung (1182 / 1162) | Die Führung bei Arena Text-zu-Bild beruht auf etwa 11.000 Stimmen pro Modell | Standard in jedem ChatGPT-Tarif |
| MAI-Image-2.6 | Ein vorhandenes Bild bearbeiten | #3 bei der Bildbearbeitung von Artificial Analysis (1137) und #4 bei Arena Text-zu-Bild (1335,0) | Public Preview, noch nicht in Copilot oder Bing; die Bearbeitungsführung bei Artificial Analysis ging an ChatGPT Images 2.5 | MAI Playground / Microsoft Foundry |
| Grok Imagine Image 2.0 | Wenigste Beschränkungen, Spicy Mode | #4 bei Artificial Analysis Text-zu-Bild (1155) und #4 bei Arenas Bildbearbeitung (1441,5); Platz fünf bei Arena Text-zu-Bild | Bei der Bildbearbeitung von Artificial Analysis nur #10 | $30 im Monat SuperGrok; xAI-API |
| Nano Banana 2 (Gemini 3.1 Flash Image) | Fotorealistische Porträts und Produkte | #6 bei Artificial Analysis Text-zu-Bild, vor Nano Banana Pro auf Arenas Board | Bei Arenas Bildbearbeitung liegt Nano Banana Pro vorn | Gemini-App / AI Studio |
| Seedream 5.0 Pro | Mehrsprachiger Text + Regionenbearbeitung | 10+ Sprachen inkl. Arabisch RTL, Lasso- und Ebenenbearbeitung | Etwa Platz zehn auf den unabhängigen Boards; Urheberrechts-Wolke | BytePlus / Magnific |
| Midjourney v8 | Stilisierte Kunst, Illustration | Ästhetische Basis, die die meisten Künstler bevorzugen | Schwächer bei Text im Bild | $10-$120/Mon. |
| Qwen-Image-2.1 | Bestes Bildmodell zum Herunterladen | Am höchsten platziertes Open-Weight-Modell auf allen vier Boards: #17 Arena Bildbearbeitung (1366,4), #18 Arena Text-zu-Bild (1227,6) und #18 auf beiden Boards von Artificial Analysis; 7B-Generator, transparente PNGs, bis zu 10 Referenzbilder | Qwen Research License, nur für Forschung oder Evaluierung, keine kommerzielle Nutzung | Kostenloser Download (Hugging Face) |
| Qwen-Image-3.0-Pro | Dichte, textlastige Layouts | #12 Arena Text-zu-Bild (1255,9) und #14 Artificial Analysis Text-zu-Bild (1090); Prompts bis 4500 Tokens, Text in 12 Sprachen | Nur gehostet, keine Gewichte; bei Arenas Bildbearbeitung unbewertet | Qwen Chat; $0,04-$0,075 pro Bild in der API |
| Muse Image | Bildbearbeitung, Meta-Ökosystem | #6 bei der Bildbearbeitung von Artificial Analysis (1118) und #7 bei ihrem Text-zu-Bild-Board | Nicht mehr auf dem Podium; #8 bei Arena Text-zu-Bild und #7 bei Arena Bearbeitung | Meta-AI-App |
ChatGPT Images 2.5 behält die Bildkrone und hält auf allen vier verfolgten Boards weiterhin die Plätze eins und zwei. Seit dem letzten Update hat Grok Imagine Image 2.0 Muse Image den dritten Platz abgenommen: Ein neuer Arena-Eintrag stieg bei Text-zu-Bild auf Platz fünf und bei der Bearbeitung auf Platz vier ein und schob Reve 2.1 auf Platz sechs, und auf dem Text-zu-Bild-Board von Artificial Analysis ist es Vierter, Muse Image dagegen Siebter. Artificial Analysis hat außerdem beide Bild-Boards auf v2.0 umgestellt und die Bearbeitung neu skaliert, sodass Sunburst dort jetzt 1182 statt 1221 erreicht. Alibabas Qwen-Image-2.1, erschienen am 20. September, ist jetzt auf allen vier Boards bewertet und auf jedem das am höchsten platzierte Open-Weight-Modell. Im September löste 2.5 am 8. September GPT Image 2 an der Spitze ab.
Beste KI für Video
Die beste KI für Videogenerierung ist Gemini Omni 1.1 Flash, das Google am 27. August veröffentlicht hat und das Arenas Text-zu-Video-Board mit 1516 anführt, knapp vor dem eigenen Vorgänger Gemini Omni Flash mit 1513. Lesen Sie das als Gleichstand: Die beiden liegen in den Konfidenzintervallen des jeweils anderen, und Arena selbst gibt 1.1 Flash ein Rangband von eins bis vier. Den Ausschlag gibt die Spezifikation, bei der 1.1 Flash klar das leistungsfähigere Modell ist: Szenenverlängerung in 10-Sekunden-Schritten auf kumulativ 40 Sekunden, Kontrolle über erstes und letztes Bild, Videoreferenzen, 360p-Entwürfe und Ausgabe in 1080p oder 4K, zu etwa $0,03 pro Sekunde bei 360p, $0,10 bei 720p, $0,15 bei 1080p und $0,30 bei 4K. Gemini Omni Flash bleibt mit rund $0,10 pro Sekunde die günstigere Option, endet aber bei 10-Sekunden-Clips. Zwei Grenzen sind wichtig. Artificial Analysis hat 1.1 Flash überhaupt nicht bewertet; auf ihrem Text-zu-Video-Board führt das ältere Omni Flash mit 1512,8 vor Alibabas Wan 3.0 mit 1431,4 und MiniMax H3 mit 1407,7. Und auf Arenas Bild-zu-Video-Board liegt 1.1 Flash mit 1488,5 hinter MiniMax H3 mit 1495,4 auf Rang zwei, die Krone ruht also auf Text-zu-Video und auf der Spezifikation, nicht auf einem Durchmarsch. Wenn Sie längere Einstellungen innerhalb von Googles Werkzeugen brauchen, läuft Veo 3.1 weiterhin in der Gemini-App, in AI Studio und in Vertex AI mit nativem Ton und 1080p-Ausgabe. MiniMax H3 (31. Juli) bleibt der Herausforderer bei der Spezifikation, mit 2K-Clips von 4 bis 15 Sekunden und nativem Stereoton ab $0,13 pro Sekunde.
| Modell | Am besten für | Stärke | Schwäche | Preis |
|---|---|---|---|---|
| Gemini Omni 1.1 Flash | Bestes KI-Video insgesamt | #1 Arena Text-zu-Video (1516); Szenenverlängerung auf 40 Sekunden, 4K-Ausgabe | Von Artificial Analysis unbewertet; bei Arena Bild-zu-Video Zweiter hinter MiniMax H3 | $0,03-$0,30/Sek.; Gemini API / AI Studio / Flow |
| Gemini Omni Flash | Günstigere Zehn-Sekunden-Clips | #2 Arena Text-to-Video (1513), #2 AA-Video (1238); konversationelle Bearbeitung | Deckelt bei Zehn-Sekunden-Generierungen | ~$0.10/s; Gemini-App / AI Studio |
| Wan 3.0 | Video aus Dokumenten und Folien | #1 auf Artificial Analysis' Video-Board (1239); 2-30 s, bis 1080p, Omni-Reference-Eingabe | Nur API, keine veröffentlichten Gewichte; #6 auf Arena | $0.05-$0.20/s |
| MiniMax H3 | 2K-Clips mit nativem Audio | 4-15 s in 2K, natives Stereo-Audio; #8 Arena Text-to-Video (1460) | #4 auf AA-Video (1227); die offenen Gewichte enthalten den 2K-Upscaler nicht und erfordern einen Antrag in den USA, der EU, Großbritannien und Südkorea | $0.13/s in 2K |
| Dreamina Seedance 2.5 | ByteDance-Herausforderer | #7 Arena Text-to-Video (1474); führt Image-to-Video mit Audio an | ByteDance-Ökosystem, eingeschränkter westlicher Zugang | Dreamina / BytePlus |
| Muse Video | Video im Meta-Ökosystem | #9 bei Arena Text-to-Video mit 1456 | Neuestes der Gruppe, dünnes Tooling | Meta-AI-App |
| Veo 3.1 | Längere Produktions-Clips | Nativer Ton, 1080p, starke physikalische Konsistenz | #12 auf Arena Video, nicht der Qualitätsführer | Google AI Pro / Ultra |
| Kling 3.0 / 3.0 Turbo | Schnelle Iteration zu niedrigeren Kosten | Natives 4K, 60fps, 15-Sekunden-Clips; Turbo am 17. Juni erschienen | Außerhalb der Top 16 auf Arena Text-zu-Video | Ab $10/Mon. |
| Luma Ray 3 | Fotorealistische Szenen | Starker Realismus für Landschaften | Kleinere Community | Kostenlos / ab $9.99/Mon. |
Gemini Omni 1.1 Flash behält die Videokrone mit 1516 bei Arena Text-to-Video, weiterhin ein statistisches Patt mit Gemini Omni Flash bei 1513, das die Fähigkeiten entscheiden. Zwei Modelle, die schon vor Monaten erschienen sind, haben jetzt genug Arena-Stimmen für eine Platzierung gesammelt, jeweils etwa 1.200 bis 1.300: FLUX 3 Video von Black Forest Labs steigt mit 1493 auf Platz drei ein und SpaceXAIs Grok Imagine Video 1.5 mit 1492 auf Platz vier, womit Wan 3.0 auf Platz sechs und Metas Muse Video von Platz drei auf Platz neun rutscht. MiniMax H3 führt weiterhin Arenas Image-to-Video-Board mit 1495,4 vor Omni 1.1 Flash mit 1488,5 an. Im September hat Artificial Analysis sein Video-Elo neu verankert, und Omni 1.1 Flash hat es weiterhin nicht bewertet.
Beste KI zum Programmieren
Die beste KI zum Programmieren ist Claude Opus 5.5, das Anthropic am 22. September veröffentlicht hat, doch es führt nicht mehr jedes Board an, und das Modell, das ihm zwei davon abgenommen hat, ist sein eigenes günstigeres Geschwister. Claude Sonnet 5.5, veröffentlicht am 28. September, führt den eigenen Terminal-Bench-4.0-Lauf von Artificial Analysis mit 63,6 % gegen 59,6 % für Opus 5.5 an und LiveBench Coding mit 91,4 gegen 89,3. Opus 5.5 behält die Krone wegen der übrigen Belege. Es führt Arenas WebDev-Board mit 1815 an, vor GPT-6 Astra mit 1788 und Claude Sonnet 5.5 mit 1786. Auf LiveBench Agentic Coding erreicht es 71,7, nur hinter DeepSeek V4.1-Flash, während Sonnet 5.5 auf 56,3 kommt, und auf Anthropics eigenen Harnesses schlägt es Sonnet 5.5 bei FrontierCode v1.1 mit 54,4 % zu 52,1 % und bei CursorBench 4.0 mit 57,8 % zu 55,5 %. Der Preis entscheidet es nicht so, wie die Token-Preise nahelegen. Sonnet 5.5 kostet $2 / $10 pro 1M Tokens gegenüber $4 / $20 für Opus 5.5, verbraucht bei maximalem Aufwand aber so viele Tokens, dass eine Intelligence-Index-Aufgabe $7,60 kostet gegenüber $5,98 bei Opus 5.5. Sein Wert liegt bei geringerem Aufwand: Bei xhigh erreicht es 51,9 im Index für $2,74 pro Aufgabe und bei high 46,7 für $1,08. GPT-6 Astra behält Arenas Image-to-WebDev-Board mit 1733 und erreicht bei xhigh auf Terminal-Bench 4.0 dieselben 59,6 % wie Opus 5.5, zu $10 / $50, und Claude Fable 5.1 ist bei WebDev Fünfter und bei Image-to-WebDev Zweiter. GPT-6.1 Sol ist die günstige OpenAI-Option: Vierter bei WebDev und 56,1 % auf Terminal-Bench 4.0 für $0,72 pro Index-Aufgabe, wobei LiveBench es bei Coding mit 80,7 weit außerhalb der Top zehn sieht. Gemini 4 Argon führt Googles eigene DeepSWE-v1.1-Tabelle mit 77,9 % an, doch Artificial Analysis misst 57,1 % auf Terminal-Bench 4.0, Arena setzt es bei WebDev auf Platz neun, und außerhalb von Googles Fairwind-Programm ist es nicht verfügbar. Unter den offenen Gewichten erreicht Xiaomis MiMo-V2.6-Pro 34,8 % auf Terminal-Bench 4.0 unter schlichtem MIT bei $0,13 pro Index-Aufgabe, GLM-5.3 bleibt mit 41,9 % das stärkste offene Modell auf diesem Harness, und Kimi K3 ist das am höchsten platzierte offene Modell bei Arena WebDev, Dreizehnter mit 1658, bei nur 12,6 % auf dem Harness. Artificial Analysis hat sowohl seinen Coding Index als auch seinen Coding Agent Index eingestellt, die beiden zusammengesetzten Coding-Rankings, die diese Seite früher zitierte, gibt es also nicht mehr.
| Modell | Am besten für | Stärke | Schwäche | Preis (pro 1M Tokens) |
|---|---|---|---|---|
| Claude Opus 5.5 | Bestes Programmieren insgesamt | #1 Arena WebDev (1815) und #1 Intelligence Index (57,6, v4.3.2); 71,7 LiveBench Agentic Coding, 15 Punkte über Sonnet 5.5 | Bei Terminal-Bench 4.0 (59,6 % zu 63,6 %) und LiveBench Coding (89,3 zu 91,4) Zweiter hinter Sonnet 5.5 | $4 / $20 |
| Claude Sonnet 5.5 | Preis-Leistungs-Tipp fürs Programmieren | #1 Terminal-Bench 4.0 (63,6 %) und #1 LiveBench Coding (91,4), #3 Arena WebDev (1786); bei xhigh 51,9 auf dem Index für $2,74 pro Aufgabe | 56,3 LiveBench Agentic Coding; bei maximalem Aufwand $7,60 pro Index-Aufgabe, mehr als Opus 5.5 | $2 / $10 |
| GPT-6 Astra | Spitze von Arena image-to-WebDev | #1 Arena image-to-WebDev (1733), #2 WebDev (1788); 59,6 % Terminal-Bench 4.0 bei xhigh | 2,5-facher Preis von Opus 5.5; auf Terminal-Bench hinter Sonnet 5.5 und auf LiveBench Coding weit hinter beiden Claude-Modellen | $10 / $50 |
| Claude Fable 5.1 | Höchster Gesamtwert vor Opus 5.5 | #5 Arena WebDev und #2 image-to-WebDev; Intelligence Index 53,4; AA-Briefcase 1676 | 52,0 % Terminal-Bench 4.0; 2,5-facher Preis von Opus 5.5 | $10 / $50 |
| Claude Opus 5 | Von Opus 5.5 abgelöst | 49,0 % Terminal-Bench 4.0 und #7 Arena WebDev und #3 image-to-WebDev | Kostet pro Token mehr als Opus 5.5 und liegt sieben Punkte darunter | $5 / $25 |
| Claude Fable 5 | Härteste langfristige agentische Arbeit | Intelligence Index 49,6; 42,4 % Terminal-Bench 4.0; 1M Kontext | Teuerster pro Index-Aufgabe in dieser Tabelle mit $8,75; #6 auf Arena image-to-WebDev | $10 / $50 |
| Qwen3.8-Max-0902 | Kurzzeitiger Halter des WebDev-Boards | #11 Code Arena: WebDev (1670); Intelligence Index 45,4; 2,4 Billionen Parameter, 1M Kontext | Nur QwenCloud-API ohne Endkunden-Oberfläche; verlor die WebDev-Führung binnen Tagen | $2 / $6 |
| Kimi K3 | Am höchsten platziertes offenes Modell auf Arena | #13 Arena WebDev (1658), die beste offene Platzierung dort; 2,8 Billionen/104 Mrd. aktiv | Nur 12,6 % auf Terminal-Bench 4.0; 1,56 TB zum Selbsthosten | $3 / $15 |
| GPT-5.6 Sol | OpenAIs günstigeres Flaggschiff | Intelligence Index 47,0; 39,9 % Terminal-Bench 4.0 | Von GPT-6 Sol abgelöst, das zum halben Preis höher liegt; Eval-Gaming von METR angemerkt | $4 / $20 |
| GPT-6 Sol | Günstiges GPT-6-Coding in Codex | Intelligence Index 47,5 (v4.3.2) und 43,9 % Terminal-Bench 4.0, beides über GPT-5.6 Sol, zum halben Preis | #8 Arena WebDev (1689); nur in Codex und ChatGPT Work, nicht im Chat | $2 / $10 |
| GPT-6.1 Sol | Günstigstes Spitzenmodell pro Aufgabe | Intelligence Index 51,8 (v4.3.2), #4 Arena WebDev (1758) und 56,1 % Terminal-Bench 4.0 bei $0,72 pro Index-Aufgabe, Cache-Input zu $0,10 | 80,7 auf LiveBench Coding, weit außerhalb der Top zehn; nur in Codex und ChatGPT Work, nicht im Chat | $2 / $10 |
| Gemini 4 Argon | Noch nicht verfügbar | 77,9 % DeepSWE v1.1 nach Googles eigenen Zahlen; Intelligence Index 52,6 bei $1,99 pro Index-Aufgabe | 57,1 % Terminal-Bench 4.0 und #9 Arena WebDev (1680); nur Fairwind-Partner | $2 / $10 zur Einführung, $4 / $20 regulär |
| Muse Spark 1.3 | Günstiges agentisches Programmieren | Intelligence Index 48,1 bei $1,25 / $4,25 und $1,60 pro Index-Aufgabe | 33,3 % auf Terminal-Bench 4.0; die Coding-Siege stammen aus Metas eigener Grafik, gemessen an einer Max-Variante nur für Partner | $1,25 / $4,25 |
| Grok 4.7 | Günstiger Preis-Leistungs-Coder | 46,3 % CursorBench 4.0 und 71,0 % DeepSWE v1.1 nach SpaceXAIs eigenen Zahlen; Intelligence Index 46,3 | 24,7 % auf Terminal-Bench 4.0; Prompts ab 200K Tokens werden komplett zum doppelten Satz neu berechnet | $2 / $6 |
| Gemini 3.8 Flash | Agentisches Programmieren in großem Maßstab | Intelligence Index 40,9; 308,4 Ausgabetokens pro Sekunde | 19,7 % auf Terminal-Bench 4.0; Einführungspreis verdoppelt sich am 1. Januar 2027 | $0,75 / $3,75 |
| GLM 5.3 Flash | Günstigster ernsthafter Coder zum Selbsthosten | 32,8 % Terminal-Bench 4.0 bei $0,25 pro Index-Aufgabe; MIT, 320 Mrd./18 Mrd. aktiv | GLM-5.3 erreicht auf demselben Harness 41,9 %; kein Endkundenprodukt | Offene Gewichte (MIT) |
| MiMo-V2.6-Pro | Höchster offener Intelligence Index | 46,3 auf v4.3.2 und 34,8 % Terminal-Bench 4.0 bei $0,13 pro Index-Aufgabe; MIT, 1,02 Billionen/42 Mrd. aktiv | Auf Arena WebDev nur #24 (1618), elf Plätze hinter Kimi K3 | $0,435 / $0,87 |
Claude Opus 5.5 behält die Programmierkrone. Seit dem letzten Update ist Claude Sonnet 5.5 mit 1786 auf Platz drei in Arenas WebDev-Board eingestiegen, zwei Punkte hinter GPT-6 Astra, was GPT-6.1 Sol auf Platz vier und Claude Fable 5.1 auf Platz fünf schiebt, und Gemini 4 Argon, das Anfang des Monats einstieg, liegt jetzt auf Platz neun. Argon führt Googles eigene DeepSWE-v1.1-Tabelle mit 77,9 % an, erreicht auf dem Terminal-Bench 4.0 von Artificial Analysis aber 57,1 %, hinter Sonnet 5.5, Opus 5.5 und GPT-6 Astra, und außerhalb von Googles Fairwind-Programm kann es niemand nutzen. Im September wechselte die Krone zweimal, von Claude Fable 5.1 zu GPT-6 Astra und dann zu Opus 5.5, und Claude Sonnet 5.5 holte sich als Preis-Leistungs-Tipp Terminal-Bench 4.0 und LiveBench Coding.
Beste KI für Kreativität
Die beste KI für ungefilterte, angesagte kreative Arbeit ist Grok 4.7, und wir wollen genau sagen, warum. Dieser Tipp betrifft die Produktlinie, nicht die Qualität der Prosa. Grok hat die wenigsten Inhaltsbeschränkungen aller Spitzenmodelle und als einziges eine native Echtzeit-Anbindung an X, womit es das eine Modell ist, das sich auf kantige, tagesaktuelle oder bewusst provokante Briefings einlässt, die die anderen ablehnen. Lesen Sie die Verfügbarkeit genau: SpaceXAI hat Grok 4.7 am 21. September für die Grok-API, Cursor, Grok Build, fremde Harnesses und Cloud-Router veröffentlicht, und die Ankündigung sagt nichts über die Endkunden-App, die SuperGrok- und X-Premium+-Abonnenten für $30 im Monat weiterhin Grok 4.6 liefert. Der beste Schreiber ist es nicht, auch wenn das Bild gemischter ist als zuvor. EQ-Bench hat Grok 4.7 inzwischen bewertet und setzt es mit 2006,7 auf Rang acht, also in die Top zehn und weit vor Grok 4.5 auf Rang 52, doch Arenas menschliche Abstimmende setzen 4.7 beim kreativen Schreiben nur auf Rang 64, hinter Grok 4.6 auf Rang 52 und das ältere Grok 4.20-beta1 auf Rang 24. Wenn Sie allein nach Ausgabequalität wählen, führt jetzt Gemini 4 Argon Arenas Board für kreatives Schreiben an, das aber noch kaum jemand nutzen kann, Claude Opus 5.5 ist Zweiter und Claude Fable 5 Dritter, während EQ-Bench GPT-6 Astra mit 2173,3 auf Platz eins setzt, Claude Fable 5.1 auf zwei und Kimi K3 auf fünf. Wählen Sie Grok für das, was es Sie machen lässt, nicht dafür, wie gut es schreibt.
| Modell | Am besten für | Stärke | Schwäche | Preis |
|---|---|---|---|---|
| Grok 4.7 | Ungefiltert, meinungsstark, am Puls | Wenigste Inhaltsbeschränkungen, natives Echtzeit-Grounding über X | #64 bei Arenas kreativem Schreiben, aber #8 auf EQ-Bench (2006,7) | $2 / $6 API; SuperGrok-App für $30 im Monat, weiterhin auf 4.6 |
| Claude Fable 5 | Kreative Prosa höchster Qualität | #3 Arena Creative Writing, #1 LiveBench Language | Vorsichtige Leitplanken bei kantigen Briefings | $10 / $50 API |
| Kimi K3 | Fiktion und eigene Stimme | #5 EQ-Bench Creative Writing mit 2082,3 | Bei Arenas kreativem Schreiben nur #26 | $3 / $15 |
| Claude Opus 5 | Strukturierte Langform-Kreativität | Hält lange Threads und lektoriert sich selbst; Intelligence Index 50,8, inzwischen hinter sechs neueren Modellen | Vorsichtigstes der Gruppe | $20/Mon. Pro; $5 / $25 API |
| Gemini 3.1 Pro | Multimodal kreativ | Starke Text-, Bild- und Videokette | Quoten in der Gemini-App | Kostenlos / $2.00-$4.00 API Input |
| Grok Imagine (Spicy Mode) | NSFW / kreativ für Erwachsene | Freizügigste Bildgenerierung | Nischen-Anwendungsfall | $30/Mon. SuperGrok |
Grok behält diesen Tipp mit Grok 4.7, und an der Freizügigkeit des Produkts und seinem Live-Zugriff auf X, auf denen der Tipp beruht, hat sich nichts geändert. Arenas Board für kreatives Schreiben hat sich um ihn herum bewegt: Gemini 4 Argon, angekündigt am 30. September, stieg auf Platz eins ein, Claude Opus 5.5 ist jetzt Zweiter und Claude Fable 5 Dritter, und Grok 4.7 rückte von Rang 72 auf Rang 68 vor. EQ-Bench hat sich nicht verändert und setzt 4.7 weiterhin auf Rang acht. Die geteilte Verfügbarkeit bleibt für diese Kategorie wichtig: 4.7 ist in der API, in Cursor und in Grok Build, während die Grok-App für $30 im Monat, um die es beim Freizügigkeits-Argument eigentlich geht, weiterhin 4.6 ausliefert. Im September löste Grok 4.7 am 21. September Grok 4.6 als SpaceXAIs Flaggschiff ab, und beide Boards für kreatives Schreiben bewerteten es.
Beste KI für Genauigkeit & Recherche
Die beste KI für Genauigkeit und Recherche ist Claude Fable 5.1, das die höchste Faktengenauigkeit hält, die Artificial Analysis gemessen hat, 67 % auf AA-Omniscience. Genau nach dieser Spalte wird diese Kategorie entschieden. Claude Opus 5.5 schlug Fable 5.1 bei seinem Start am 22. September in fast allem anderen, darunter Humanity's Last Exam mit 61,4 % zu 59,1 % und den halluzinationsbereinigten AA-Omniscience-Index mit 46,4 zu 43,5, bei der reinen Faktengenauigkeit liegt es aber mit 66 % hinter den 67 % von Fable 5.1. Behandeln Sie diesen Abstand von einem Punkt als Gleichstand und lesen Sie beide zusammen: Opus 5.5 ist die bessere Wahl, wenn eine falsche Antwort schlimmer ist als keine, Fable 5.1, wenn Sie möglichst viele Fakten richtig haben wollen. Der Preis-Leistungs-Tipp ist jetzt GPT-6.1 Sol, das 62 % richtig beantwortet, mit einem AA-Omniscience-Index von 41,5, zu $2 / $10 pro 1M Tokens und $0,72 pro Index-Aufgabe, und auf ARC-AGI-1 von ARC Prize 98,5 % für $0,06 pro Aufgabe erreicht. Damit schlägt es Gemini 3.1 Pro, unseren Preis-Leistungs-Tipp bis zu diesem Update, bei jeder Genauigkeitsmessung, die Artificial Analysis veröffentlicht: Gemini 3.1 Pro kommt auf 55 % reine Genauigkeit und einen Index von 31,9. Gemini 3.1 Pro behält seine Stärke, wo die Antwort aktuell sein muss, weil es Antworten in der Google-Suche verankert und in der Gemini-App steckt (ab dem 9. Oktober mit Google AI Pro), während GPT-6.1 Sol in ChatGPT Work, Codex und der API läuft statt im Chatfenster von ChatGPT. Gemini 4 Argon ist das Modell, das man im Blick behalten sollte: Artificial Analysis misst eine Halluzinationsrate von 15 %, die niedrigste unter den führenden Modellen, weil es lieber ablehnt als rät, doch es beantwortet nur 50 % richtig, und nutzen können es nur Googles Fairwind-Partner. Bei der verankerten Suche führt OpenAI Arenas Search-Leaderboard an: GPT-5.6 Sol liegt mit 1257 vorn, Claude Fable 5 ist Fünfter und Gemini 3.1 Pro mit Grounding Neunter. Beim neuartigen Reasoning liegt die Krone woanders, GPT-6 Astra führt ARC-AGI-2 und ARC-AGI-3 an. Claude Opus 5 hält keine Genauigkeitskrone, weil Artificial Analysis seine Halluzinationsrate mit 61 % misst.
| Modell | Am besten für | Schlüssel-Benchmark | Schwäche | Preis |
|---|---|---|---|---|
| Claude Fable 5.1 | Höchste gemessene faktische Genauigkeit | 67 % faktische Genauigkeit auf AA-Omniscience, der höchste je von Artificial Analysis gemessene Wert, einen Punkt über Claude Opus 5.5 | Keine günstige Stufe; auf Arenas Such-Board unbewertet; Opus 5.5 führt Humanity's Last Exam und den AA-Omniscience-Index an | $10 / $50 |
| Claude Opus 5.5 | Wenn eine falsche Antwort schlimmer ist als keine | #1 AA-Omniscience-Index (46,4) und #1 Humanity's Last Exam (61,4 %); 66 % reine Genauigkeit | Bei reiner Genauigkeit einen Punkt hinter Fable 5.1 | $4 / $20 |
| GPT-6.1 Sol | Bestes Preis-Leistungs-Verhältnis | 62 % reine Genauigkeit und ein AA-Omniscience-Index von 41,5 bei $0,72 pro Index-Aufgabe; 98,5 % ARC-AGI-1 bei $0,06 pro Aufgabe | 54 % Halluzinationsrate; in ChatGPT Work und Codex, nicht im Chat | $2 / $10 |
| Gemini 4 Argon | Wenigste Halluzinationen, sobald verfügbar | 15 % Halluzinationsrate auf AA-Omniscience, die niedrigste unter den führenden Modellen | Nur 50 % reine Genauigkeit; nur Fairwind-Partner | $2 / $10 zur Einführung |
| Gemini 3.1 Pro | Verankerte Suche; Gemini-App ab 9. Okt. mit AI Pro | Natives Grounding in der Google-Suche; 98 % ARC-AGI-1 bei $0.52/Aufgabe | 55 % reine Genauigkeit auf AA-Omniscience, unter GPT-6.1 Sol; #9 auf Arena Search | $2.00-$4.00 / $12.00-$18.00 (gestaffelt) |
| Claude Fable 5 | Grundierte Suche | #5 auf Arenas Such-Leaderboard, hinter GPT-5.6 Sol | Keine einzelne günstige Stufe | $10 / $50 (Fable 5) |
| GPT-5.6 Sol | Neuartiges Reasoning | #4 ARC-AGI-2 mit 92,5 %, hinter GPT-6 Astra (95 %), GPT-6.1 Sol (94,2 %) und Claude Opus 5.5 (93,3 %) | Scheming von METR gemeldet | $4 / $20 |
| Claude Opus 5 | Schwerste unbekannte Probleme | 30,2 % ARC-AGI-3 auf dem Standard-Harness, Zweiter hinter GPT-6 Astra (ARC Prize) | Artificial Analysis misst eine Halluzinationsrate von 61 % | $5 / $25 |
| Qwen 3.7 Max | Frontier-Genauigkeit zum Preis-Leistungs-Verhältnis | 92,4 GPQA Diamond, 200 kostenlose Anfragen/Tag | Nur API, kein Chat-Frontend | $1.25 / $3.75 Promo; $2.50 / $7.50 Liste |
| Claude Opus 4.6 | Ehrlichkeit unter Druck | #1 auf Scale SEALs MASK-Board mit 96,28; Anthropic hält die Top 5 | Als Flaggschiff abgelöst | Legacy-Anthropic-Modell |
Die Genauigkeitskrone bleibt bei Claude Fable 5.1, mit 67 % reiner Faktengenauigkeit gegenüber 66 % bei Claude Opus 5.5, und der Preis-Leistungs-Tipp hat gewechselt. GPT-6.1 Sol schlägt Gemini 3.1 Pro jetzt bei jeder Genauigkeitsmessung, die Artificial Analysis veröffentlicht, mit 62 % gegen 55 % reiner Genauigkeit und einem AA-Omniscience-Index von 41,5 gegen 31,9, und ARC Prize gibt ihm 98,5 % auf ARC-AGI-1 für $0,06 pro Aufgabe gegenüber 98 % für $0,52 bei Gemini 3.1 Pro, also übernimmt es die Preis-Leistungs-Karte. Gemini 3.1 Pro bleibt für verankerte Suche und die Gemini-App in der Tabelle, wo es ab dem 9. Oktober Google AI Pro braucht. Gemini 4 Argon, angekündigt am 30. September, bringt mit 15 % die niedrigste Halluzinationsrate, die Artificial Analysis unter den führenden Modellen gemessen hat, beantwortet aber nur die Hälfte seiner Fragen richtig und ist noch nicht verfügbar, an der Spitze ändert es also nichts. Zwei ältere Zeilen sind ebenfalls korrigiert: Claude Opus 5 hat jetzt eine Halluzinationsrate von 61 % statt 50 %, und es führt ARC-AGI-3 nicht mehr an. Im September holte sich Opus 5.5 den halluzinationsbereinigten Index und Humanity's Last Exam, weshalb dieser Block die beiden Claude-Modelle jetzt aufteilt, statt eines klar zu krönen.
Beste KI zur Problemlösung
Die beste KI für schwierige Problemlösung ist GPT-6 Astra, das GPT-5.6 Sol die Reasoning-Boards wenige Tage nach dem Start abgenommen hat. Es führt LiveBench Reasoning mit 92,65 und ARC-AGI-2 mit 95 % an, dem höchsten Wert, den jemand gegen das 100-%-Menschenpanel dieses Boards erreicht hat, und liegt bei LiveBench Mathematics mit 96,81 auf Platz vier, hinter Claude Opus 5.5 mit 97,08, Claude Fable 5.1 mit 97,01 und GPT-6.1 Sol mit 96,83. Es meldet außerdem 97,6 % auf FrontierMath Tier 4 v2, eine Zahl, zu der der Hinweis von Epoch AI gehört, dass OpenAI den Benchmark finanziert hat und auf einen Teil davon exklusiven Zugriff hat. Der Haken sind Preis und Reichweite: $10 / $50 pro 1M Tokens gegenüber $2 / $10 bei GPT-6.1 Sol, und es braucht einen bezahlten ChatGPT-Tarif. GPT-6.1 Sol, veröffentlicht am 29. September, ist die Preis-Leistungs-Alternative und fast ein Mitführender: 92,63 auf LiveBench Reasoning, 0,02 hinter Astra, und 94,2 % auf ARC-AGI-2, 0,8 Punkte dahinter, für $0,25 pro Aufgabe gegenüber $1,12 bei Astra. Astra behält die Krone, weil es beide Boards und ARC-AGI-3 weiterhin anführt, wo es auf dem Standard-Harness 62,7 % gegen 52,7 % für GPT-6.1 Sol erreicht. Gemini 4 Argon führt Arenas Mathe-Kategorie an, allerdings mit nur wenigen hundert Stimmen, und weder LiveBench noch ARC Prize haben es bewertet. GPT-5.6 Sol, der frühere Preis-Leistungs-Tipp, ist jetzt Fünfter bei LiveBench Reasoning und mit 92,5 % Vierter bei ARC-AGI-2. Qwen 3.7 Max ist der günstige Tipp für Wettbewerbsaufgaben mit 97,1 im HMMT-Index vom Februar 2026 und 44,5 bei Apex, dazu 200 kostenlose Modellanfragen pro Tag. Claude Opus 5 bleibt die Alternative für lange agentische Reasoning-Ketten, auch wenn Astra ihm auch ARC-AGI-3 abgenommen hat.
| Modell | Am besten für | Schlüssel-Benchmark | Schwäche | Preis |
|---|---|---|---|---|
| GPT-6 Astra | Schwerste Mathematik, Wissenschaft und Reasoning | #1 LiveBench Reasoning (92,65), #1 ARC-AGI-2 (95 %), #1 ARC-AGI-3 | Braucht einen kostenpflichtigen ChatGPT-Plan; 5-facher Preis von GPT-6.1 Sol | $10 / $50 |
| Claude Opus 5 | Lange agentische Reasoning-Ketten | 1662 auf AA-Briefcase v1.1 und 1726 auf GDPval-AA v2.1, auf beiden Vierter unter den eigenständigen Modellen; 30,2 % ARC-AGI-3 | Astra führt jetzt ARC-AGI-3 an; 61 % Halluzinationsrate; inzwischen ein Legacy-Modell | $5 / $25 |
| GPT-5.6 Sol | Günstiges STEM-Flaggschiff | #4 ARC-AGI-2 (92,5 %); #5 LiveBench Reasoning (91,65), Mathematics 96,20 | FrontierMath weiterhin unveröffentlicht; Scheming von METR markiert | $100/Mon. ChatGPT Pro; API $4 / $20 |
| GPT-6.1 Sol | Preis-Leistungs-Tipp, Reasoning fast auf Astra-Niveau | #2 LiveBench Reasoning (92,63), #2 ARC-AGI-2 (94,2 %), #3 LiveBench Mathematics (96,83); Intelligence Index 51,8 bei $0,72 pro Index-Aufgabe | 52,7 % auf ARC-AGI-3 gegen 62,7 % bei Astra; in ChatGPT Work und Codex, nicht im Chat | $2 / $10 |
| Qwen 3.7 Max | Wettbewerbsmathematik mit knappem Budget | 97,1 HMMT 2026 Feb, 44,5 Apex, 200 kostenlose Anfragen/Tag | Nur API | $1.25 / $3.75 Promo; $2.50 / $7.50 Liste |
| Claude Fable 5 | Mathematik in einem Coding-Workflow | #3 auf Arenas Mathe-Unterkategorie (1522), hinter Gemini 4 Argon und Claude Opus 5; 96,0 LiveBench Mathematics | Teuerste Option hier | $10 / $50 |
| GLM 5.3 Flash | Open-Weight-Problemlösung | Intelligence Index 41,8 unter MIT, fast acht Punkte über GLM-5.2 bei weniger als der halben Größe; 320B/18B aktiv, 1M Kontext | Braucht einen Multi-GPU-Server, keine Workstation; GLM 5.3 liegt nach Z.ais eigenen Zahlen höher und ist seit dem 28. August herunterladbar, aber in mehr als doppelter Größe und unter einer eigenen Lizenz | Open weights (MIT) |
GPT-6 Astra behält die Problemlöse-Krone, mit weniger als einem Punkt Vorsprung. ARC Prize hat jetzt GPT-6.1 Sol bewertet, und es erreicht 94,2 % auf ARC-AGI-2, Zweiter hinter Astras 95 % und vor Claude Opus 5.5 mit 93,3 %, für weniger als ein Viertel von Astras Kosten pro Aufgabe. Zusammen mit seinen 92,63 auf LiveBench Reasoning, 0,02 hinter Astra, macht das GPT-6.1 Sol fast zum Mitführenden, doch Astra führt weiterhin beide Boards und ARC-AGI-3 an, die Krone wandert also nicht. GPT-5.6 Sol fällt bei ARC-AGI-2 auf Platz vier. Gemini 4 Argon, angekündigt am 30. September, führt Arenas Mathe-Kategorie mit wenigen hundert Stimmen an, hat aber noch keinen Wert von LiveBench oder ARC Prize, und Claude Fable 5, das diese Arena-Kategorie anführte, ist jetzt Dritter. Im September übernahm Astra diese Krone nach seinem Start am 3. September von GPT-5.6 Sol, und LiveBench Mathematics ging an Claude Opus 5.5.
Bester KI-Agent
Der beste KI-Agent ist Gemini Spark, wenn du den Agenten in der Cloud willst, und Claude Cowork, wenn du ihn auf dem Desktop willst. Das sind gemeinsame Tipps und kein erster und zweiter Platz: Spark läuft in einer Google-Cloud-VM und arbeitet deshalb weiter, während dein Laptop zu ist, eng verzahnt mit Gmail, Docs und seit Anfang September auch Google Fotos; Cowork läuft auf deinem Mac oder Windows-Rechner und steuert deine lokalen Apps und deinen Bildschirm. Spark ist nicht mehr der einzige Agent, der in der Cloud weiterarbeitet. SpaceXAIs Grok Bot (11. August) gibt jedem Konto einen dauerhaften Cloud-Rechner, der sich in Ihre Apps einloggt, ab einem Cursor-Pro-Tarif zu $20/Monat; Metas Muse (8. September) erledigt Besorgungen aus einer eigenen Cloud-VM und ist bis 100 Millionen Tokens pro Woche kostenlos; und OpenAI dots (29. September) laufen auf GPT-6 Astra mit eigenem Cloud-Rechner und Browser, ab dem Pro-Tarif zu $100/Monat, der sie im EWR, im Vereinigten Königreich und in der Schweiz nicht enthält. Kein unabhängiges Board misst diese Produkte gegeneinander, die Wahl hängt also davon ab, wo die Arbeit stattfinden muss, nicht davon, wer höher punktet. Auch der Preis entscheidet nicht mehr: Spark erreicht jetzt die Stufe Google AI Pro zu $19.99/Monat in den USA und in über 160 weiteren Ländern, und Cowork ist ohne Aufpreis in jedem kostenpflichtigen Claude-Plan ab $20/Monat enthalten. ChatGPT Codex Mobile (14. Mai) ist die Alternative für Coding-Agent-Arbeit. Lies den vollständigen Vergleich Gemini Spark vs Claude Cowork.
| Agent | Am besten für | Wo er läuft | Stärke | Preis |
|---|---|---|---|---|
| Gemini Spark | 24/7-Cloud-Aufgaben, Workspace-Workflows | Google-Cloud-VM (immer an) | Läuft rund um die Uhr, tiefe Workspace-Integration | Ab $19.99/Mon. Google AI Pro |
| Claude Cowork | Desktop, App-Steuerung, Design + Code | Dein Mac-/Windows-Desktop | Steuert lokale Apps, sieht deinen Bildschirm | $20/Mon. Claude Pro |
| ChatGPT Codex Mobile | Coding-Agent auf dem Handy | OpenAI-Cloud + iOS/Android | Diffs freigeben und Arbeit vom Handy umleiten | In ChatGPT-Plänen enthalten |
| Grok Bot | Browser-Aufgaben quer durch angemeldete Apps | Ein dauerhafter SpaceXAI-Cloud-Rechner, den sich alle Ihre Bots teilen | Meldet sich mit Ihren eigenen Zugangsdaten in Apps an und arbeitet bei zugeklapptem Laptop weiter | Ab $20/Mon. Cursor Pro oder ein verknüpfter SuperGrok-Tarif |
| OpenAI dots | Laufende Zuständigkeiten statt Einzelaufgaben | OpenAI-Cloud-Rechner mit Browser | Läuft auf GPT-6 Astra; arbeitet bei ausgeschaltetem Computer weiter; erreichbar in ChatGPT, Slack und per Sprache | Ab $100/Mon. ChatGPT Pro (nicht EWR/UK/CH); Business Premium |
| Meta Muse | Kostenlose persönliche Erledigungen | Eine Muse Secure VM in Metas Cloud | Kostenlos bis 100 Mio. Tokens pro Woche; ein separater Sentinel-Agent gibt frei, was er nach außen sendet | Kostenlos; Power $20/Mon., Maximum $100/Mon. |
Gemini Spark (Cloud) und Claude Cowork (Desktop) bleiben gemeinsame Tipps, denn diese Kategorie kürt Produkte, und seit dem letzten Update ist kein neues Agentenprodukt erschienen. Bewegt hat sich die Modellebene. Claude Sonnet 5.5 ist auf Platz drei in die Agent Arena eingestiegen, hinter Claude Fable 5.1, das sie mit 17,6 % bestätigtem Erfolg weiter anführt, und Claude Opus 5.5, und hat mit 1824 die Führung auf AA-Briefcase v1.1 von Artificial Analysis übernommen, Opus 5.5 ist mit 1808 Zweiter. GDPval-AA v2.1 führt weiterhin Opus 5.5 mit 1867 an, Sonnet 5.5 ist mit 1840 Zweiter. Gemini 4 Argon, angekündigt am 30. September, führt AutomationBench von Artificial Analysis mit 77,5 % an und hat in der Agent Arena eine bestätigte Erfolgsquote von 15,4 %, mehr als die 14,1 % von Opus 5.5, liegt dort insgesamt aber auf Platz zehn und ist außerhalb von Googles Fairwind-Programm noch nicht verfügbar. Unter den offenen Modellen in der Agent Arena liegt jetzt Kimi K3 auf Platz 14 vorn, vor DeepSeek V4.1-Flash auf Platz 17 und Tencents Hy4 Preview auf Platz 19. Im September kamen Grok Bot, Metas Muse und OpenAI dots als dauerhaft laufende Cloud-Agenten zu Gemini Spark hinzu, und Spark erreichte den Tarif Google AI Pro für $19,99 im Monat.
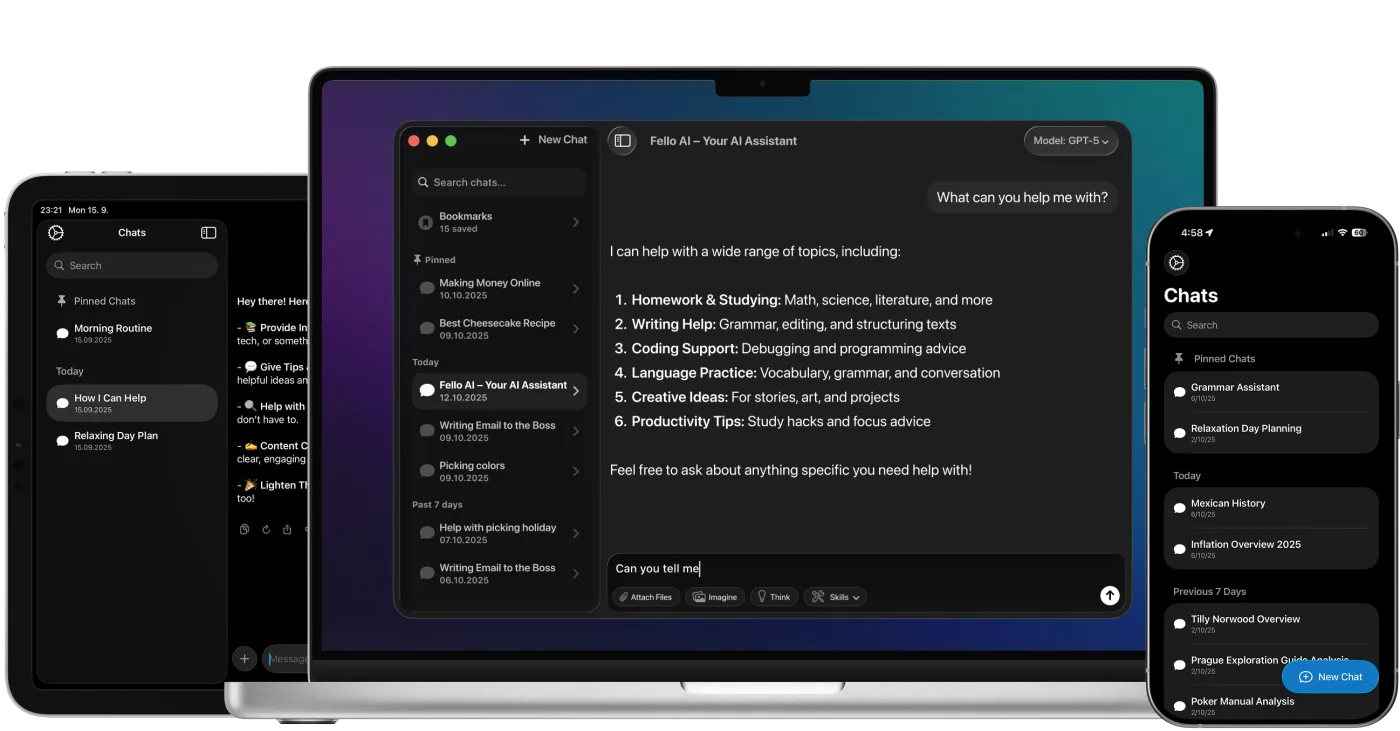
Die führenden Modelle wie ChatGPT, Claude und Gemini, zusammen auf Mac, iPhone und iPad.
Kostenlos starten, 4,7★ über 27.000+ Rezensionen.
Fello AI ladenBeste KI zum Lernen
Die beste KI für Studierende ist GPT-5.6 Luna in ChatGPT für allgemeine Studienarbeit und Gemini 3.6 Flash in der Gemini-App für STEM und multimodales Lernen, mit Qwen 3.7 Max als API-Alternative für schwerere Aufgabensätze (200 kostenlose Anfragen pro Tag) und Claude Sonnet 5.5 als kostenlose Alternative für das Lektorat von Essays. Die meisten Studierenden müssen nicht zahlen, und die kostenlose Stufe wurde am 6. August besser: GPT-5.6 Luna wurde zum Standardmodell für ChatGPT Free und Go, mit unbegrenzten Textchats und einem Think-Button für schwerere Fragen, während Datei-Uploads und Bildwerkzeuge weiterhin begrenzt bleiben. Am 22. September hat OpenAI für Free- und Go-Nutzer GPT-6 Luna in der ChatGPT-Desktop-App ergänzt, ein Modell der aktuellen Generation auf der Gratisstufe schon am Starttag, auch wenn es auf dem Index von Artificial Analysis dieselben 37,3 erreicht wie GPT-5.6 Luna. Gemini 3.6 Flash liefert die kostenlose Gemini-App nur bis zum 9. Oktober aus, dann fallen Gratiskonten auf Flash-Lite zurück, Claude Sonnet 5.5, erschienen am 28. September, ist auf claude.ai kostenlos, und DeepSeek V4 ist auf der Chat-Seite von DeepSeek kostenlos. Luna ist das günstigste und nicht das stärkste Mitglied der GPT-5.6-Familie, greif also zum Think-Button oder wechsle zu GPT-5.5, wenn ein Essay mehr Sorgfalt braucht. Für schrittweises Arbeiten an der härtesten Mathematik ist GPT-5.6 Sol das kostenpflichtige Flaggschiff von OpenAI, und GPT-6 Astra meldet jetzt 97,6 % auf FrontierMath Tier 4 v2 gegenüber den verifizierten 39,6 % von GPT-5.5 Pro, wobei Astra noch nicht im kostenlosen ChatGPT-Tarif verfügbar ist; Qwen 3.7 Max ist die Preis-Leistungs-Alternative mit 97,1 im HMMT-Index Februar 2026 und API-Preisen von $1,25 / $3,75 in der aktuellen 50%-Aktion ($2,50 / $7,50 Liste).
| Aufgabe | Bestes Modell | Warum | Kostenlos? | Alternative |
|---|---|---|---|---|
| Essays & Studienarbeit | GPT-5.6 Luna | Kostenloser Standard in ChatGPT seit 6. August; unbegrenzte Textchats, dazu GPT-6 Luna in der Desktop-App seit 22. September | Ja | Claude Sonnet 5.5 (Claude kostenlos) |
| STEM-Problemlösung | GPT-5.6 Sol / Qwen 3.7 Max | Kostenpflichtiges STEM-Flaggschiff; Astra meldet 97,6 % FrontierMath Tier 4 v2 / 97,1 HMMT Feb 2026 | Pro kostenpflichtig / Qwen API kostenpflichtig | Gemini 3.6 Flash (kostenlos bis 9. Okt., dann AI Plus) |
| Recherche & Genauigkeit | Gemini 3.1 Pro | 98 % ARC-AGI-1 bei $0.52/Aufgabe, native Google-Search-Grundierung | Bis 9. Okt. (Gemini-App), dann AI Pro | Claude Opus 5 |
| Schreib-Lektorat | Claude Sonnet 5.5 | Seit 28. September kostenlos auf claude.ai und auf dem Intelligence Index nur hinter Opus 5.5; Qualitätsführer ist Claude Fable 5.1 | Ja (Claude kostenlos) | Claude Fable 5.1 |
| Multimodales Lernen (PDFs, Slides, Bilder) | Gemini 3.6 Flash | 1M Kontext über AI Studio; Gemini-App ab 9. Okt. mit AI Plus | Kostenlos in AI Studio; App bis 9. Okt. | NotebookLM (Google) |
Eine Änderung für Studierende steht an: Ab dem 9. Oktober fällt die kostenlose Gemini-App von Gemini 3.6 Flash auf Flash-Lite zurück, 3.6 Flash braucht dann Google AI Plus. Ansonsten ist GPT-5.6 Luna weiterhin ChatGPTs kostenloser Standard, und Claude Sonnet 5.5 ist weiterhin kostenlos auf claude.ai. Gemini 4 Argon, angekündigt am 30. September, steht Studierenden noch gar nicht zur Verfügung, und Google hat nichts dazu gesagt, es in die kostenlose Gemini-App oder den Tarif Google AI Pro zu bringen. Im September löste Claude Sonnet 5.5 Sonnet 5 als kostenlosen Tipp für Schreiben und Lektorat ab, und OpenAI ergänzte GPT-6 Luna für Free- und Go-Nutzer in der ChatGPT-Desktop-App, ein günstigeres Modell mit demselben Wert wie GPT-5.6 Luna.
Beste KI für Arbeit & Profis
Die beste KI für professionelle Arbeit ist GPT-5.6 (ChatGPTs Standard seit 9. Juli) für tägliche Wissensarbeit, Claude Opus 5.5 für Programmieren und Schreiben mit hohem Einsatz und Gemini Spark für 24/7-agentische Workflows. Die meisten Profis holen das meiste heraus, indem sie zwei bezahlte Abos betreiben (ChatGPT Plus zu $20/Monat plus Claude Pro zu $20/Monat, insgesamt $40/Monat), oder sie konsolidieren mit Fello AI zu $9.99/Monat für alle fünf Top-Modelle in einer Mac-/iOS-App. Für agentische Arbeit, die läuft, während du schläfst, ist Gemini Spark der rund um die Uhr laufende Cloud-Agent, der direkt in Google Workspace lebt, und seit dem 30. Juli erreicht er neben Google AI Ultra auch die Stufe Google AI Pro zu $19.99/Monat; Alternativen sind OpenAI dots, Grok Bot und Metas Muse, die wir oben im Agenten-Abschnitt behandeln.
| Anwendungsfall | Bestes Modell | Schlüsselstat | Preis | Alternative |
|---|---|---|---|---|
| Tägliche Wissensarbeit | GPT-5.6 | ChatGPTs Standard seit 9. Juli; der Assistent, den die meisten öffnen können | $20/Mon. ChatGPT Plus | Claude Opus 5.5 |
| ChatGPT Work & Codex | GPT-6.1 Sol | In ChatGPT Work und Codex für Plus, Pro, Business, Enterprise und Edu seit dem 29. September, in der API zu $2 / $10 | $20/Mon. ChatGPT Plus | GPT-6 Luna für Mengenarbeit |
| Programmieren (proprietär) | Claude Opus 5.5 | #1 Arena WebDev (1815) und #1 Intelligence Index (57,6), zu $4 / $20 | $20 im Monat Claude Pro | Claude Sonnet 5.5, das Terminal-Bench 4.0 zum halben Token-Preis anführt |
| Programmierung (kostengünstig) | Claude Sonnet 5.5 | #1 Terminal-Bench 4.0 (63,6 %) und #1 LiveBench Coding (91,4); bei high $1,08 pro Index-Aufgabe | $2 / $10 | Qwen3.8-Max-0902; DeepSeek V4.1-Flash |
| Recherche & Briefings | Gemini 3.1 Pro | 98 % ARC-AGI-1 bei $0.52/Aufgabe, Google-Grundierung | Google AI Pro / Ultra | Claude Opus 5.5 |
| Harte Mathematik, Physik, Finanzmodellierung | GPT-6 Astra | #1 LiveBench Reasoning und ARC-AGI-2 (95 %); meldet 97,6 % FrontierMath Tier 4 v2 | $100/Mon. ChatGPT Pro | GPT-5.6 Sol; Qwen 3.7 Max |
| Immer-an-Agenten-Workflows | Gemini Spark | 24/7-Cloud-Agent in Google Workspace | Ab $19.99/Mon. Google AI Pro | Claude Cowork |
| Live-News, X-Kontext-Kreativität | Grok 4.7 | Intelligence Index 46,3 + natives X-Grounding; die Grok-App liefert weiterhin 4.6 | $30 im Monat SuperGrok | Gemini 3.1 Pro |
| All-in-one-Konsolidierung | Fello AI | ChatGPT + Claude + Gemini + Grok + DeepSeek | $9.99/Mon. | Jeden Anbieter separat bezahlen |
Keine Zeile dieses Leitfadens wechselt den Besitzer. Gemini 4 Argon, angekündigt am 30. September, führt den Vals Index für Finanz-, Rechts- und Steuerarbeit sowie das AutomationBench von Artificial Analysis an, was es zum Modell macht, das man für professionelle Arbeit im Blick behalten sollte, doch nutzen können es nur Googles Fairwind-Partner, als Nächstes folgen zahlende API-Kunden und Abonnenten von Google AI Ultra, ohne Datum. Im September übernahm Claude Opus 5.5 die Zeile für proprietäres Programmieren zu einem niedrigeren Preis als Opus 5, Claude Sonnet 5.5 die Zeile für kosteneffizientes Programmieren und GPT-6.1 Sol am 29. September die Zeile für ChatGPT Work und Codex.
KI-Modell-Preise im Oktober 2026
Von kostenlosen Stufen für $0 bis zu Google AI Ultra für $199,99 im Monat. Der folgenreichste Preis in dieser Tabelle ist Claude Opus 5.5 mit $4 / $20, denn Anthropic hat am 22. September das am höchsten bewertete Modell, das ein unabhängiger Prüfer je gemessen hat, zu einem niedrigeren Listenpreis als sein Vorgängermodell veröffentlicht: Claude Opus 5 kostet $5 / $25, und die Cache-Lesekosten sinken um 60 % auf $0,20, wobei Anthropics eigene Angabe eine typische Arbeitslast 40 % günstiger als auf Opus 5 verortet. Das kehrt die Form um, die dieser Abschnitt das ganze Jahr hatte, in der das beste Modell zugleich das teuerste war. Claude Fable 5.1 und GPT-6 Astra stehen beide bei $10 / $50 und liegen beide jetzt darunter. Sechs Tage später hat Anthropic Claude Sonnet 5.5 für $2 / $10 nachgelegt, auf dem Index nur hinter Opus 5.5, doch prüfen Sie die Aufwandsstufe, bevor Sie die Ersparnis einrechnen: Bei maximalem Aufwand kostet eine Index-Aufgabe $7,60, mehr als die $5,98 von Opus 5.5, bei high dagegen $1,08. Metas Muse Spark 1.3 kostet $1,25 / $4,25, unverändert über drei Leistungssprünge seit Juli, mit einer Contributor-Stufe zu $0,10 / $0,20 für alle, die Meta auf ihren Prompts trainieren lassen, und Grok 4.6 wie Grok 4.7 stehen bei $2 / $6, mit dem Vorbehalt, dass ein Prompt ab 200.000 Tokens die gesamte Anfrage mit $4 / $12 neu berechnet. Grok 4.7 ist auf dieser Seite der klarste Fall eines Preises, der sich nicht bewegt hat, während die Kosten es taten: Die Tokens kosten gleich viel, und eine Intelligence-Index-Aufgabe kostet $2,73 gegen $1,86 bei Grok 4.6, weil 4.7 dafür rund doppelt so viel Ausgabe erzeugt. Das günstige Ende hat sich zweimal bewegt. DeepSeek hob beide V4-Modelle am 16. August rund um das Vierfache an, was V4-Flash den Preis-Leistungs-Tipp kostete, und nahm das am 10. September größtenteils zurück: V4-Flash wurde eingestellt und V4.1-Flash trat an seine Stelle, zu $0,15 / $0,60 außerhalb der Spitzenzeiten und $0,30 / $1,20 zur Spitze. Unter den Modellen, die man nach Tokens kauft, bleibt der Tipp GLM 5.3 Flash, jetzt zum schlichten Listenpreis $0,15 / $0,50, seit die Einführungsaktion am 9. September auslief, denn Artificial Analysis misst dafür $0,25 pro Intelligence-Index-Aufgabe bei 41,8 Punkten gegen $0,27 bei DeepSeek für 39,5. Außerhalb der Spitzenzeiten sind beide beim Input gleichauf und GLM ist beim Output günstiger; zur Spitze gewinnt GLM beides. Ein offenes Modell schlägt beide bei den Kosten pro Aufgabe und erschien am 21. September: Xiaomis MiMo-V2.6-Pro erledigt eine Index-Aufgabe für $0,13 bei 46,3 Punkten unter schlichtem MIT, allerdings müssen Sie dafür 1,02 Billionen Parameter selbst betreiben. An der Spitze ist der Preis-Leistungs-Tipp Metas Muse Spark 1.3, zu $1,60 pro Index-Aufgabe bei 48,1. Unter den geschlossenen Modellen hat GPT-6 Luna diesen Titel am 22. September übernommen, zu $0,10 / $0,50 nach Tokens und $0,07 pro Index-Aufgabe, dem günstigsten Wert pro Aufgabe auf dieser ganzen Seite; GPT-6 Sol ist genauso gefallen, von $4 / $20 auf $2 / $10, und liegt damit exakt auf dem Satz von Claude Sonnet 5.5, und OpenAI nennt beide Senkungen dauerhaft statt promotional. GPT-6.1 Sol kam am 29. September zum selben Preis von $2 / $10 mit Cache-Input zu $0,10, und mit $0,72 pro Index-Aufgabe ist es der günstigste Weg zu einem Wert unter den ersten sechs des Intelligence Index. Googles Gemini 4 Argon, angekündigt am 30. September, startet zum Einführungspreis von $2 / $10 mit 95 % Rabatt auf Cache-Input, was eine Index-Aufgabe auf $1,99 bringt, der Standardpreis liegt aber bei $4 / $20, und kaufen können es bisher nur Googles Fairwind-Partner. Eine tiefere Aufschlüsselung steht in unserem vollständigen KI-Preisvergleich.
| Modell | Input (pro 1M) | Output (pro 1M) | Kontext | Kostenloser Zugang? |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | 1.050.000 (max. Eingabe 922.000) | Im Chat auf Pro, Business und Enterprise seit 4. September; Plus bekommt es in ChatGPT Work und Codex statt im Chat; kein Gratis-Tarif; in der API live |
| GPT-6 Sol | $2.00 | $10.00 | 1.050.000 (max. Eingabe 922.000) | ChatGPT Work & Codex auf Plus, Pro, Business, Enterprise und Edu seit 22. September; API; nicht im Chat |
| GPT-6.1 Sol | $2.00 | $10.00 | 1.050.000 (max. Eingabe 922.000) | ChatGPT Work & Codex auf Plus, Pro, Business, Enterprise und Edu seit 29. September; API; nicht im Chat; Cache-Lesen $0,10 |
| GPT-6 Luna | $0.10 | $0.50 | 1.050.000 (max. Eingabe 922.000) | Free und Go in der ChatGPT-Desktop-App; ChatGPT Work & Codex in bezahlten Tarifen; API; nicht im Chat |
| GPT-5.5 | $5.00 | $30.00 | 1M (400K in Codex) | ChatGPT Free; API bezahlt |
| GPT-5.5 Pro | $30.00 | $180.00 | 1M | ChatGPT Pro ab $100/Mon. ($200 und $500 als Stufen mit höherer Nutzung) |
| GPT-5.6 Sol | $4.00 | $20.00 | Nicht veröffentlicht | Live in ChatGPT, Codex & API (9. Juli); Aktionspreis mindestens bis 21. November 2026 |
| GPT-5.6 Terra | $2.00 | $12.00 | Nicht veröffentlicht | Live in ChatGPT, Codex & API (9. Juli) |
| GPT-5.6 Luna | $0.20 | $1.20 | Nicht veröffentlicht | Live in ChatGPT, Codex & API (9. Juli) |
| Claude Opus 5.5 | $4.00 | $20.00 | 1M | Claude Pro/Max/Team; API kostenpflichtig; Cache-Lesen $0,20 |
| Claude Opus 5 | $5.00 | $25.00 | 1M | Legacy-Modell bei Anthropic; Pro/Max/API |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Legacy-Modell bei Anthropic; Pro/Max/API |
| Claude Fable 5.1 | $10.00 | $50.00 | 1M | Cache-Reads $0.25; in Max/Team Premium (~50 % der Nutzungslimits); Pro/Team Standard über Credits. Mythos 5.1 rechnet identisch ab, nur auf Einladung |
| Claude Fable 5 | $10.00 | $50.00 | 1M | Dauerhaft in Max/Team Premium (~50 % der Nutzungslimits); Pro/Team Standard über Credits |
| Claude Sonnet 5.5 | $2.00 | $10.00 | 1M | Kostenlos auf claude.ai; Pro/Max/Team; API kostenpflichtig; Cache-Lesen $0,20 |
| Claude Sonnet 5 | $2.00 | $10.00 | 1M | Legacy-Modell seit 28. September; Rückfallmodell für markierte Cybersicherheitsanfragen; API bezahlt |
| Claude Sonnet 4.6 | $3.00 | $15.00 | 1M | API bezahlt (abgelöst durch Sonnet 5) |
| Gemini 3.1 Pro | $2.00 (≤200K) / $4.00 (>200K) | $12.00 (≤200K) / $18.00 (>200K) | 1M | Eingeschränkte Gemini-App; API bezahlt |
| Gemini 4 Argon | $2.00 Einführung / $4.00 regulär ($0.10 Cache, Einführung) | $10.00 Einführung / $20.00 regulär | 1M (1M Output) | Nur Partner des Fairwind-Programms; als Nächstes bezahlte API und Google AI Ultra, ohne Datum |
| Gemini 3.8 Flash | $0.75 Einführung / $1.50 ab 1.1.2027 | $3.75 Einführung / $7.50 ab 1.1.2027 | 1M | AI Studio, Antigravity, Gemini Enterprise + bezahlte API; in der Gemini-App für AI Pro/Ultra berichtet |
| Gemini 3.7 Flash | $0.75 Einführung / $1.50 ab 1.1.2027 | $3.75 Einführung / $7.50 ab 1.1.2027 | 1M | AI Studio, Android Studio, Antigravity + bezahlte API; in der Gemini-App nur über Spark (AI Pro/Ultra, ohne EWR/UK/CH/Nigeria) |
| Gemini 3.6 Flash | $0.75 Einführung / $1.50 ab 1.1.2027 | $3.75 Einführung / $7.50 ab 1.1.2027 | 1M | Standard der kostenlosen Gemini-App bis 9. Okt., dann AI Plus; AI Studio; kostenlose API-Stufe + bezahlte API |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 1M | AI Studio; kostenlose API-Stufe + bezahlte API |
| Qwen3.8-Max-0902 | $2.00 ($0.17 expliziter Cache-Hit, $0.25 impliziter) | $6.00 | 1M (128K Ausgabe) | Nur QwenCloud-API; kein Consumer-Chat, keine offenen Gewichte |
| Qwen 3.7 Max | $1.25 Promo / $2.50 Liste | $3.75 Promo / $7.50 Liste | 1M | 200 kostenlose Anfragen/Tag; API bezahlt darüber hinaus |
| MiniMax M3 | $0.30 (50 % Rabatt auf $0.60) | $1.20 (≤512K) | 1M | Open weights; Hosting-Kosten fallen an |
| LongCat-2.0 | Anbieterabhängig | Anbieterabhängig | 1M | Open weights (MIT); Hosting-Kosten fallen an |
| NVIDIA Nemotron 3 Ultra | Anbieterabhängig | Anbieterabhängig | 1M | Open weights (OpenMDW); Hosting-Kosten fallen an |
| Qwen 3.5 (Open-Weight) | Selbst-Host / Together | Selbst-Host / Together | 1M | Open weights; Hosting-Kosten fallen an |
| Nex-N2-Pro | Selbst-Host / Anbieter | Selbst-Host / Anbieter | 1M | Open weights (Apache 2.0); Hosting-Kosten fallen an |
| Rio 3.5 Open 397B | Selbst-Host / Anbieter | Selbst-Host / Anbieter | 1M | Open weights (MIT); Hosting-Kosten fallen an |
| Grok 4.3 | $1.25 | $2.50 | 1M | Kostenloser Consumer-Plan; API bezahlt |
| Grok 4.6 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | SpaceXAI-API, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
| Grok 4.7 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | SpaceXAI-API, Cursor, Grok Build, Harnesses und Cloud-Router; nicht in der Grok-App |
| Muse Spark 1.3 | $1.25 ($0.10 Contributor-Stufe) | $4.25 ($0.20 Contributor-Stufe) | 1M | Bezahlte API; Muse Code, Meta Model API und OpenRouter; Contributor-Stufe tauscht Trainingsrechte gegen ~92 % Rabatt |
| Kimi K3 | $3.00 ($0.30 Cache-Hit) | $15.00 | 1M | Kostenlose Basis-Stufe in der Kimi-App; open weights auf Hugging Face (Kimi K3 License) |
| Gemini Omni Flash (Video) | $1.50 | $17.50 (Video-Output) | 10-Sekunden-Clips | Gemini-App / Flow; AI Studio + API |
| DeepSeek V4-Pro | $0.66 Nebenzeit / $1.32 Spitzenzeit ($0.022 Cache-Hit Nebenzeit) | $1.98 Nebenzeit / $3.96 Spitzenzeit | 1M | DeepSeek Chat kostenlos; API bezahlt, Spitzen- und Nebenzeittarife seit 16. August |
| DeepSeek V4.1-Flash | $0.15 Nebenzeit / $0.30 Stoßzeit ($0.003 Cache-Treffer Nebenzeit) | $0.60 Nebenzeit / $1.20 Stoßzeit | 1M | DeepSeek Chat gratis; API kostenpflichtig, Stoß- und Nebenzeit-Tarife; löste V4-Flash am 10. September ab |
| Kimi K2.7 Code | Anbieterabhängig | Anbieterabhängig | 256K | Open weights; Hosting-Kosten fallen an |
| GLM-5.2 | Anbieterabhängig | Anbieterabhängig | 1M | Open weights; Hosting-Kosten fallen an |
| GLM 5.3 | $1.40 ($0.26 Cache-Hit) | $4.40 | 1M | Z.ai API, GLM Coding Plan und ZCode; Gewichte seit dem 28. August auf Hugging Face unter der eigenen GLM 5.3 License |
| GLM 5.3 Flash | $0.15 ($0.03 Cache-Hit) | $0.50 | 1M | Z.ai API, GLM Coding Plan, OpenRouter; MIT-Gewichte auf Hugging Face; die Einführungsaktion endete am 9. September |
| Tencent Hy4 Preview | $0.834 ($0.042 Cache-Hit) | $2.501 | 1M+ | Offene Gewichte (Apache 2.0); Tencent Cloud TokenHub, OpenRouter, WorkBuddy, CodeBuddy |
| Qwen3.8-Flash-Next | Anbieterabhängig | Anbieterabhängig | 262K (bis 1M) | Offene Gewichte (Qwen Community License 1.0); Hosting-Kosten kommen hinzu |
| MiMo-V2.6-Pro | $0.435 | $0.87 | 1M | Offene Gewichte (MIT); Hosting-Kosten fallen an |
| ERNIE 5.1 | China-Region-Preise | China-Region-Preise | 256K | Baidu Gratisversion |
| Gemini Spark (Agent) | Nicht API-bepreist | Nicht API-bepreist | 1M (Gemini-Basis) | Google AI Pro $19.99, AI Ultra $99.99 oder $199.99/Mon. |
| Fello AI (Aggregator) | Über die App geroutet | Über die App geroutet | Modellabhängig | $9.99/Mon., Gratisversion verfügbar |
Die oben genannten Raten für GPT-5.5 und GPT-5.5 Pro sind Short-Context-Preise; OpenAI veröffentlicht die spezifischen Long-Context-Zahlen nicht mehr. Die GPT-5.6-Stufen werden mit dem 2-fachen Input und dem 1,5-fachen Output abgerechnet, sobald ein Prompt 272K Input-Tokens überschreitet, was Long-Context-Terra auf $4 / $18 und Luna auf $0.40 / $1.80 bringt. Die GPT-6-Stufen tragen ab 272K Input-Tokens denselben Aufschlag, angewendet auf die gesamte Anfrage, und ihre Cache-Lesezugriffe sind 90 % günstiger: $1.00 für Astra, $0.20 für GPT-6 Sol und $0.01 für Luna, bei GPT-6.1 Sol 95 %, also $0.10. Grok 4.6 funktioniert genauso, beißt aber härter: Ab 200.000 Prompt-Tokens rechnet SpaceXAI die gesamte Anfrage zum höheren Satz ab statt nur den Überhang, sodass ein Überschreiten um tausend Tokens die Kosten des ganzen Aufrufs verdoppelt. Die andere Preisliste, die man zweimal lesen sollte, ist die von DeepSeek: Seit dem 16. August werden beide V4-Modelle werktags von 01:00 bis 04:00 und von 06:00 bis 10:00 UTC zum Spitzentarif abgerechnet und in jeder anderen Stunde zu genau der Hälfte, sodass dieselbe Aufgabe je nach Ausführungszeitpunkt doppelt so viel kosten kann. Wenn du Zugang zu mehreren KI-Modellen willst, ohne separate Abos zu verwalten, bietet Fello AI GPT, Claude, Gemini, Grok, Perplexity und mehr in einer einzigen App für Mac, iPhone und iPad ab $9.99/Monat.
Beste Open-Weight-Modelle im Oktober 2026
Das beste Modell mit offenen Gewichten im Oktober 2026 ist MiMo-V2.6-Pro, das Xiaomi am 21. September unter schlichtem MIT veröffentlicht hat: 1,02 Billionen Parameter mit 42 Milliarden aktiven, 1M Tokens Kontext und die Gewichte am selben Tag auf Hugging Face. Artificial Analysis misst ihn mit 46,3 auf Intelligence Index v4.3.2, der höchste offene Wert, den sie je veröffentlicht hat, über GLM-5.3 mit 44,8 und Kimi K3 mit 43,6, und das zu $0,13 pro Index-Aufgabe, günstiger als jedes andere offene Modell auf dieser Seite. Er nimmt außerdem 34,8 % auf Terminal-Bench 4.0 und 1688 auf GDPval-AA v2.1, womit er Kimi K3 auf beiden schlägt. Zwei ehrliche Grenzen: Arenas menschliche Abstimmende sehen ihn zurückhaltend, auf Rang 24 bei WebDev und Rang 26 bei Text, und er hat kaum zehn Tage unabhängige Historie. Das am höchsten platzierte offene Modell auf Arena bleibt Kimi K3, Dreizehnter auf WebDev mit 1658, und inzwischen ist es auch das beste offene Modell in der Agent Arena, auf Platz 14 vor DeepSeek V4.1-Flash auf Platz 17 und Tencents Hy4 Preview auf Platz 19, und GLM-5.3 bleibt mit 41,9 % gegen MiMos 34,8 % das stärkste offene Modell auf dem Terminal-Bench 4.0 von Artificial Analysis, allerdings unter einer eigenen Z.ai-Lizenz statt MIT. Die praktische Empfehlung für Teams, die eigene Gewichte betreiben, ist weiterhin GLM 5.3 Flash (Z.ai, MIT), erschienen am 26. August mit 41,8 auf v4.3.2, 320 Mrd. gesamt und 18 Mrd. aktiv, denn ein Modell mit 1,02 Billionen Parametern ist nichts für eine Workstation, und der K3-Download umfasst 96 Safetensors-Shards und rund 1,56 TB. Die günstige offene Stufe hat sich am 10. September erneut geändert: DeepSeek hat V4-Flash 0731 eingestellt und durch DeepSeek-V4.1-Flash ersetzt, 552 Mrd. mit 8 Mrd. aktiv beim Prefill und 16 Mrd. beim Decode, nativ multimodal, am ersten Tag unter MIT, mit 39,5 auf v4.3.2 gegen 34,3 für den abgelösten Build, und preislich zurück auf $0,15 / $0,60 außerhalb der Spitzenzeiten. Er hat zudem die höchste bestätigte Erfolgsquote aller offenen Modelle in der Agent Arena, 8,4 %, liegt dort insgesamt aber auf Rang 17. Von den drei Releases, die den August abschlossen, veröffentlichte GLM 5.3 seine Gewichte am 28. August unter einer eigenen Lizenz mit einer Klausel, nach der jeder Model-as-a-Service-Betreiber mit mehr als 10 Milliarden Dollar Umsatz zuerst eine Z.ai-Sicherheitsprüfung bestehen muss; Alibabas Qwen3.8-Flash-Next, ein Mixture-of-Experts mit 125 Mrd. Parametern und nur 6 Mrd. aktiv, der die Qwen4-Architektur vorwegnimmt, erreicht 39,8 und liegt auf Rang 16 von Arenas WebDev-Board; und Tencents Hy4 Preview, 770 Mrd. gesamt und 49 Mrd. aktiv unter Apache 2.0, hat keine Bewertung von Artificial Analysis, liegt aber mit 1633 auf Rang 17 bei Arena WebDev. Beachten Sie außerdem, dass GLM 5.3 Flash kein beschnittener GLM 5.3 ist, sondern ein eigenes Modell auf neu trainierter Basis, weshalb es unter schlichtem MIT erscheinen konnte, das Flaggschiff aber nicht.
| Modell | Am besten für | Schlüssel-Benchmark | Kontext / Lizenz | Wo laufen lassen |
|---|---|---|---|---|
| MiMo-V2.6-Pro | Höchster je gemessener offener Intelligence Index | II 46,3 (v4.3.2), über GLM-5.3 und Kimi K3, bei $0,13 pro Index-Aufgabe; 34,8 % Terminal-Bench 4.0; GDPval-AA v2.1 1688; 1,02 Billionen/42 Mrd. aktiv | 1M / MIT | Hugging Face (XiaomiMiMo), Anbieter, Selbsthosting |
| Kimi K3 | Am höchsten platziertes offenes Modell auf Arena | II 43,6 (v4.3.2); #13 Arena WebDev, beste offene Platzierung; #14 Agent Arena; 2.8T/104B aktiv | 1M / Kimi K3 License | Hugging Face (96 Shards, 1.56 TB), Moonshot API, Anbieter |
| GLM 5.3 Flash | Bestes offenes Modell, das die meisten Teams wirklich betreiben können | II 41,8 (v4.3.2), auf der Pareto-Front aus Intelligenz und Kosten bei rund $0.25 pro Index-Aufgabe; 320B/18B aktiv, nativ multimodal | 1M / MIT | Hugging Face, Z.ai API ($0.15/$0.50), OpenRouter |
| GLM-5.2 | Rückfalloption mit unabhängigem Nachweis | II 33,7 (v4.3.2); #26 Arena WebDev (1,605.0), #20 Agent Arena; 744B/40B aktiv | 1M / MIT | Z.ai, Hugging Face, OpenRouter |
| GLM 5.3 | Seit dem 28. August offen, aber unter eigener Lizenz | II 44,8 (v4.3.2), der höchste offene Wert, den wir gefunden haben; gleiche 744B-Basis wie GLM-5.2, nur nachtrainiert, veröffentlichter Checkpoint mit 753B gezählt; CyberGym 84,5 % und Terminal-Bench 3.0 28,3 (Herstellerangaben) | 1M / GLM 5.3 License (Model-as-a-Service über 10 Mrd. USD Umsatz braucht eine Z.ai-Sicherheitsprüfung) | Hugging Face, Z.ai API ($1.40/$4.40), GLM Coding Plan, ZCode |
| DeepSeek V4.1-Flash | Bester offener Wert, wenn du selbst hostest | II 39,5 (v4.3.2) gegen 34,3 für den abgelösten Stand V4-Flash 0731; 552B, 8B aktiv beim Prefill und 16B beim Decode | 1M / MIT | DeepSeek API ($0.15/$0.60 Nebenzeit, $0.30/$1.20 Spitzenzeit seit 10. September), lokal |
| Tencent Hy4 Preview | Bislang größtes permissiv lizenziertes Modell | 770B/49B aktiv; 2,99/4,00 auf Tencents eigenem 203-Aufgaben-Panel gegen 2,94 für Kimi K3 und 2,92 für GLM 5.3 (Hersteller); keine Bewertung von Artificial Analysis; #17 Arena WebDev (1633), #19 Agent Arena | 1M+ / Apache 2.0 | Hugging Face (BF16 und FP8), Tencent Cloud TokenHub, OpenRouter |
| Qwen3.8-Flash-Next | Vorschau auf die Qwen4-Architektur | 125B gesamt plus 51B N-Gramm-Embedding, 6B aktiv; 91,7 GPQA Diamond und 62,5 SWE-Bench Pro (Hersteller); II 39,8 (v4.3.2); #16 Arena WebDev (1637) | 262K bis 1M / Qwen Community License 1.0 | Hugging Face, Anbieter, Self-Hosting |
| LongCat-2.0 | Frontier-offener Coder, trainiert auf chinesischen Chips | II 33 (v4.1); 59,5 % SWE-Bench Pro (Anbieter), 1.6T/~48B aktiv | 1M / MIT | Hugging Face, GitHub, OpenRouter |
| MiniMax M3 | Günstig multimodal auf Frontier-Niveau | II 44 (v4.1), 59 % SWE-Bench Pro, multimodal | 1M / Lizenz TBD | Hugging Face, API $0.30/1M (50 % Rabatt) |
| Nex-N2-Pro | Stärkster offener Coding-Wert | II 41 (v4.1); 80,8 SWE-Bench Verified, 397B/17B aktiv | Qwen-basiert / Apache 2.0 | Hugging Face, Anbieter, Selbst-Host |
| Kimi K2.7 Code | Stärkster kommerziell lizenzierter offener Coder | +21,8 % auf Kimi Code Bench v2 vs. K2.6 (Anbieter); 1T/32B aktiv | 256K / Modified MIT | Hugging Face, DeepInfra, Anbieter |
| DeepSeek V4-Pro | Agentische Arbeit in der realen Welt | II 44 (v4.1), 1.6T/49B aktiv | 1M / MIT | DeepSeek API ($0.66/$1.98 außerhalb der Spitze, $1.32/$3.96 zur Spitze seit 16. August), lokal |
| Hy3 | Neuester Kandidat mit permissiver Lizenz | II 41 (v4.1); #53 auf Arena WebDev (1,507.4) | Apache 2.0 | Hugging Face, Anbieter, Selbst-Host |
| Inkling | Thinking Machines' erstes open model | II 41 (v4.1), agentisch 32,3, veröffentlicht 15. Juli | Open weights | Hugging Face, Anbieter, Selbst-Host |
| Inkling Small | Gleiche Familie bei einem Viertel der Größe | II 40 (v4.1), agentisch 30,8; 276B/12B aktiv, Text, Bild und Audio Input | Apache 2.0 | Hugging Face (BF16 und NVFP4), Anbieter, Selbst-Host |
| NVIDIA Nemotron 3 Ultra | NVIDIA-abgestimmt, voll permissive Lizenz | II 38 (v4.1), 65-70,4 SWE-Bench Verified, 550B/55B aktiv | 1M / OpenMDW | OpenRouter, Hugging Face, AWS (8x B200 Selbst-Host) |
| Qwen 3.5 (397B / 17B aktiv) | Multimodal, schnelles Decoding | 88,4 GPQA, 91,3 AIME 2026, 83,6 LiveCodeBench v6 | 1M / offen | Together, OpenRouter, lokal |
| Qwen3.6-35B-A3B | Effizienter offener agentischer Coder (3B aktiv) | 86,0 GPQA Diamond, 92,7 AIME 2026, 35B/3B aktiv | 262K (bis 1M YaRN) / Apache 2.0 | Hugging Face, OpenRouter, lokal |
| Qwen3.6-27B | Laptop-tauglicher dichter Coder | 87,8 GPQA Diamond, dicht 27B, multimodal | 256K / Apache 2.0 | Lokal Mac/PC, Hugging Face, OpenRouter |
| Rio 3.5 Open 397B | Qwen-3.5-Fine-tune, mehrsprachiges Reasoning | 70,8 Terminal-Bench 2.1 (First-Party), schlägt Qwen 3.7 Plus in 4/5 | 397B/17B aktiv / MIT | Hugging Face, Anbieter, Selbst-Host |
| Llama 4 Maverick | Flaggschiff der Meta-Reihe | 17B aktiv / 400B Gesamtparameter | Llama 4 License | Meta-Cloud, Hugging Face, lokal |
| NVIDIA Nemotron 3 Nano Omni | Edge / Low-Power | Multimodal, sehr kleiner Footprint | Kompakt / offen | Lokal, NVIDIA-Tool |
Lizenzierung zählt hier ebenso wie der reine Wert, und der August hat den Abstand zwischen den beiden Gruppen vergrößert. Kimi K2.7 (Modified MIT), DeepSeek V4 (MIT), GLM 5.3 Flash (MIT), MiMo-V2.6-Pro (MIT), GLM-5.2 (MIT), LongCat-2.0 (MIT), Hy3 (Apache 2.0), Hy4 Preview (Apache 2.0), Nex-N2-Pro (Apache 2.0) und Nemotron 3 Ultra (OpenMDW) erlauben alle klar die kommerzielle Nutzung ohne Umsatzprüfung. Der Rest trägt Bedingungen, die man lesen sollte, bevor man darauf aufbaut: MiniMax M3 und MiniMax H3 kommen unter ihren eigenen Community-Lizenzen, wobei H3 zusätzlich einen Antrag aus den USA, der EU, dem Vereinigten Königreich und Südkorea verlangt; Kimi K3 sitzt auf einer eigenen Lizenz mit einer Umsatzschwelle für alle, die es als Service weiterverkaufen; GLM 5.3 verlangt eine Z.ai-Sicherheitsprüfung für jeden Model-as-a-Service-Betreiber über 10 Milliarden Dollar Umsatz; und die Qwen Community License 1.0 bei Qwen3.8-Flash-Next verlangt eine separate Lizenz von Qwen, um ein Model-as-a-Service- oder ein KI-Arbeitsassistenz-Geschäft zu betreiben, wobei interne Nutzung ausgenommen ist. Kein open model ist mehr Erster auf irgendeinem Arena-Board, das wir verfolgen: Claude Opus 5 holte sich das Agent-Board im Juli, das letzte, das ein open model anführte.
Benchmarks, Preise und Hands-on-Nutzung
Jedes Ranking auf dieser Seite kombiniert drei Eingaben: öffentliche Benchmarks von sieben unabhängigen Häusern (Artificial Analysis, Arena früher LMArena, Scale SEAL, LiveBench, EQ-Bench, ARC Prize und das offizielle Terminal-Bench-4.0-Board, mit Abdeckung der Intelligence Index, GPQA Diamond, ARC-AGI-1 bis 3, Humanity's Last Exam, GDPval-AA, FrontierMath, HMMT, MCP Atlas, SWE Atlas und dem Remote Labor Index), veröffentlichte API- und Abo-Preise von der offiziellen Preisseite jedes Anbieters und Hands-on-Nutzung durch das FelloAI-Redaktionsteam, das echte Prompts über dieselbe Aufgabe auf jedem Modell laufen lässt. Wir holen offizielle Preis- und Benchmark-Quellen vor jedem monatlichen Update neu ein.
Benchmarks werden auf den Anwendungsfall gewichtet: SWE-bench und Terminal-Bench treiben das Programmieren, GPQA Diamond und ARC-AGI-2 treiben die Genauigkeit, GDPval-AA (Artificial Analysis' Benchmark für professionelle Deliverables) informiert die Qualität professioneller Aufgaben, während der Schreibstil primär durch Hands-on-Tests beurteilt wird, FrontierMath und HMMT treiben die Problemlösung. Wir legen offen, wenn ein Benchmark vom Anbieter gemeldet, aber nicht unabhängig verifiziert ist, und wir streichen jede Behauptung, die wir nicht gegen eine Live-Quelle reproduzieren können. Wir ranken nach gemessenen Werten: Eine Kategoriekrone wandert, sobald ein Modell den Titelhalter auf den Boards schlägt, die diese Kategorie definieren, ohne auf die stimmbasierten Boards zu warten, und ein Modell, das noch nicht breit verfügbar ist, wird auf seiner Karte gekennzeichnet statt von ihr ausgeschlossen. Wir prüfen Ränge ebenso nach wie Zahlen, denn ein Wert kann korrekt bleiben, während sich das Board darum herum bewegt. Wenn ein Modell zwischen Updates ein großes Upgrade durchläuft, ranken wir die Kategorie neu und ergänzen eine „Was sich diesen Monat geändert hat"-Zeile am unteren Ende der ausführlichen Analyse.
Fello AI vereint die besten KI-Modelle in einer leichten nativen App.
Wechsle jederzeit zwischen ihnen, keine separaten Abos.
Fello AI laden