Mejor IA 2026: cuál es la mejor inteligencia artificial actualmente
Ranking y comparativa de IA por uso, actualizados cada mes a medida que llegan nuevos modelos.
- La más inteligente en general y para programarClaude Opus 5.5
- Razonamiento más difícilGPT-6 Astra
- ImágenesChatGPT Images 2.5
- Mejor opción gratisClaude Sonnet 5.5
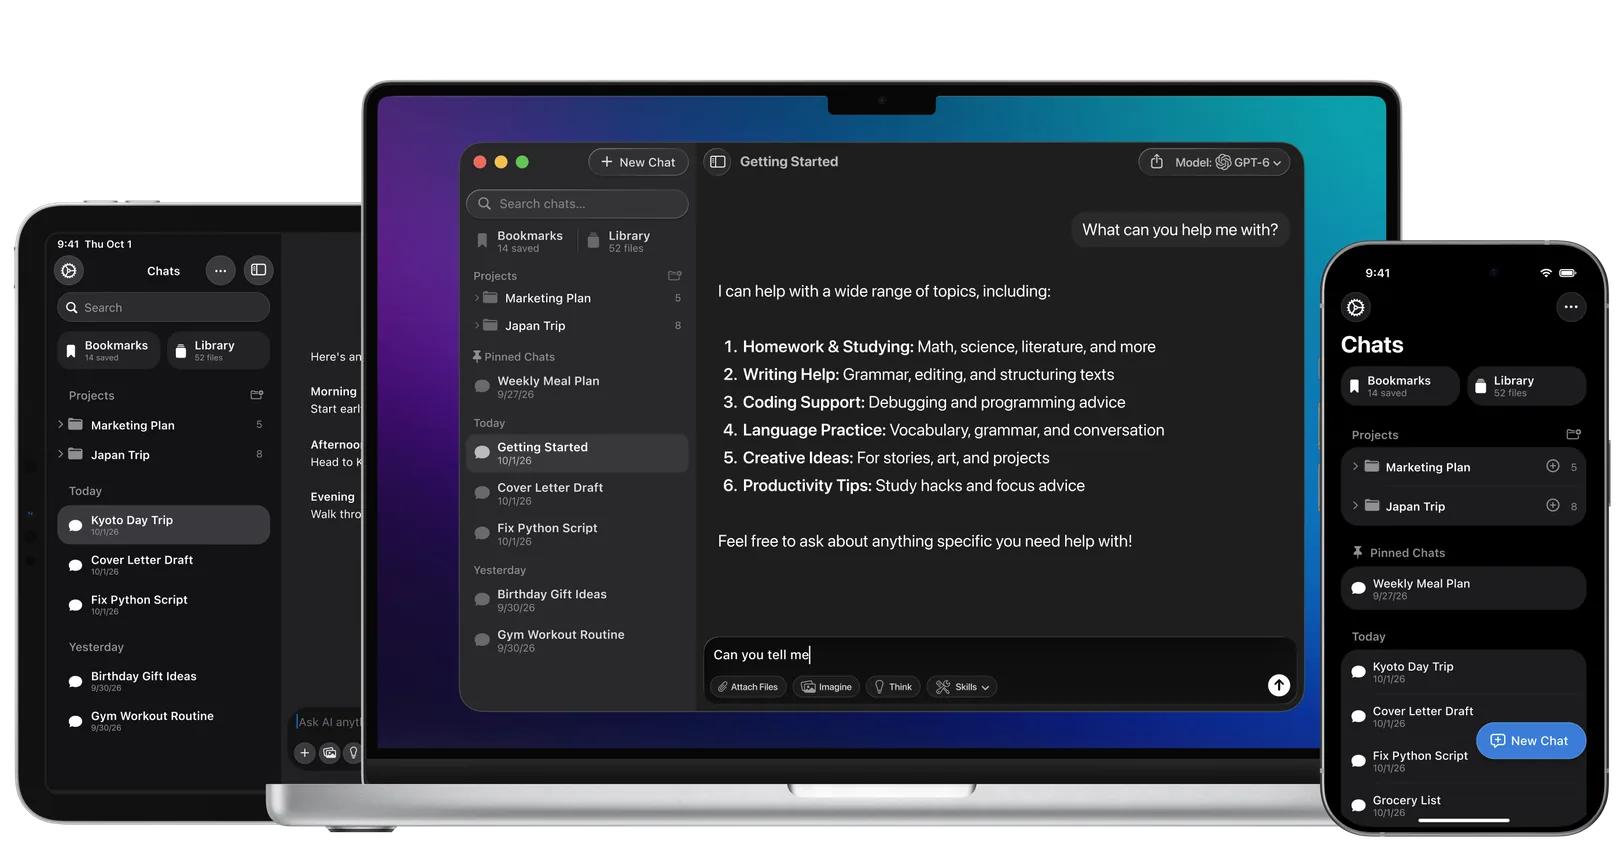
Deja de saltar entre apps de IA
Chat, búsqueda, PDF e imágenes en una sola app para Mac, iPhone y iPad.
Gratis para empezar·4,7★ en más de 27 000 reseñas
Los rankings muestran quién gana de media. Tu prompt no es de media. Pregunta a ChatGPT, Claude y Gemini en una sola ventana y quédate con la mejor respuesta.
Descargar Fello AIAnthropic tiene la mayoría de las coronas medidas este mes. Claude Opus 5.5 (22 de septiembre) es #1 en el Intelligence Index con 57,6 y en el tablero WebDev de Arena, Claude Sonnet 5.5 (28 de septiembre) es segundo con 56,0 y gratis en claude.ai, y Claude Haiku 5.5 (7 de octubre) completa la familia a $0,10 / $0,50. Nuestra guía de benchmarks de IA explica cómo se construye ese índice.
Gemini 4 Argon de Google (30 de septiembre) marca 52,6, igual que GPT-6 Astra, y es primero en el tablero de texto de Arena, y desde el 13 de octubre está abierto a los suscriptores de Google AI Pro y Ultra y en la API de pago, lo que lo pone segundo en el podio de chat, pero no gana ninguna categoría: EQ-Bench, LiveBench y ARC Prize aún no lo han valorado. OpenAI compite en precio: GPT-6 Sol y Luna redujeron a la mitad sus tarifas de API, y GPT-6.1 Sol (29 de septiembre) marca 51,8 a $2 / $10, el modelo más barato del grupo de cabeza por tarea del índice.
Muse Wonder de Meta (12 de octubre) es la novedad de frontera más reciente: Muse Wonder Full marca 55,8, tercero tras los dos modelos Claude, pero solo funciona dentro de la suscripción Muse Code de Meta, y Muse Wonder en la API marca 52,4 a los mismos $4 / $20 que Opus 5.5. Grok 4.7 (21 de septiembre) llegó a la API a los mismos $2 / $6, y el MiMo-V2.6-Pro de Xiaomi sigue siendo el modelo abierto con mejor puntuación, 46,3. El 6 de octubre Mistral lanzó Mistral Large 4 y Google publicó Nano Banana 2.1; ninguno se lleva una corona, pero el vídeo pasa a MiniMax H3. Actualizamos los rankings en las 48 horas siguientes a cada gran lanzamiento.
13 oct Google Gemini 4 Argon se abre a Google AI Pro, Ultra y la API de pago, y ocupa el segundo puesto del podio de chat Nuevo
12 oct Muse Wonder Full entra tercero en el Intelligence Index, pero solo dentro de la suscripción Muse Code de Meta Nuevo
7 oct Anthropic Claude Haiku 5.5 logra 43,4 al precio de GPT-6 Luna, y cualquier plan de Claude puede elegirlo, también el gratuito Nuevo
6 oct Mistral Mistral Large 4 es el modelo más potente de Estados Unidos o Europa que promete pesos abiertos, pero aún no se puede descargar Nuevo
6 oct Google Nano Banana 2.1 sustituye a Nano Banana 2 a mitad de precio por imagen y entra quinto en Arena texto a imagen Nuevo
30 sep Google Gemini 4 Argon lidera el tablero de texto de Arena e iguala a GPT-6 Astra en el Intelligence Index, pero solo pueden usarlo defensores de ciberseguridad Nuevo
29 sep OpenAI GPT-6.1 Sol llega al quinto puesto del Intelligence Index a $2 / $10, el más barato por tarea del grupo de cabeza Nuevo
28 sep Anthropic Claude Sonnet 5.5 queda segundo en el Intelligence Index con 56,0, al precio de Sonnet de $2 / $10 Nuevo
22 sep OpenAI GPT-6 Sol y GPT-6 Luna parten por la mitad los precios de API de OpenAI y llegan a todas partes menos al chat de ChatGPT Nuevo
22 sep Anthropic Claude Opus 5.5 se lleva el Intelligence Index con 57,6 y baja el precio de Opus 5 Nuevo
21 sep SpaceXAI Grok 4.7 llega sobre un modelo base mayor a los mismos $2 / $6 y cuesta un 47 % más por tarea Nuevo
21 sep Xiaomi El MiMo-V2.6-Pro de Xiaomi es el modelo abierto con la mayor puntuación jamás medida, a $0,13 por tarea del índice bajo MIT Nuevo
20 sep Alibaba Qwen-Image-2.1 es el mejor modelo de imagen que puedes descargar, pero su licencia solo permite investigación Nuevo
15 sep TypeSafe TypeSafe sale del sigilo con Jev, un modelo que devuelve decisiones tipadas en lugar de texto, a $0.042 por 1M de tokens Nuevo
Pendiente Google Gemini 3.5 Pro, aún sin lanzar, y Gemini 4 Argon se le ha adelantado Retrasado
Mejor IA para escritura
La mejor IA para escribir es Claude Fable 5.1, y el argumento a su favor es la constancia más que un único primer puesto.
Está entre los diez primeros de los tres tableros de prosa: segundo en EQ-Bench Creative Writing v3 con 2162,0, tercero en LiveBench Language con 89,5 y noveno en el tablero de escritura creativa de Arena. Ningún otro modelo se coloca tan bien en los tres. Gemini 4 Argon lidera ahora los tableros de escritura creativa y de texto de Arena, con 1519,2 y 1525,4, y desde el 13 de octubre pueden usarlo los suscriptores de Google AI Pro, pero ni EQ-Bench ni LiveBench lo han valorado todavía.
Claude Opus 5.5 es segundo en el tablero de escritura creativa de Arena con 1517, pero séptimo en EQ-Bench y décimo en LiveBench Language; GPT-6 Astra lidera EQ-Bench con 2173,3 pero ocupa el puesto 42 en el tablero de escritura creativa de Arena; Claude Fable 5 encabeza LiveBench Language con 90,7 y es tercero en el tablero de escritura creativa de Arena, pero undécimo en EQ-Bench. Si lo que escribes es un entregable de trabajo más que prosa, el tablero de entregables profesionales GDPval-AA v2.1 es otra cuestión, y lo lidera Claude Opus 5.5 con 1866, por delante del nuevo Muse Wonder Full de Meta con 1857, Claude Sonnet 5.5 con 1838 y Claude Fable 5.1 con 1756.
Claude Sonnet 5.5 es la elección de valor del nivel gratuito, ya que cualquiera puede usarlo en claude.ai, aunque logra 83,4 en LiveBench Language, solo ocupa el puesto 24 en el tablero de escritura creativa de Arena y EQ-Bench aún no lo ha valorado. Claude Fable 5 es la elección si das más peso a los votos humanos de Arena que a las puntuaciones de los harness; cuesta $10 / $50 por 1M de tokens y está incluido de forma permanente en Claude Max y Team Premium con alrededor del 50 % de los límites de uso habituales. La traducción es otra cuestión con otro ganador, que analizamos en nuestra guía de la mejor IA para traducir.
| Modelo | Mejor para | Fortaleza | Debilidad | Precio (por 1M de tokens) |
|---|---|---|---|---|
| Claude Fable 5.1 | Mejor escritura en general | #2 EQ-Bench Creative Writing (2162,0), #3 LiveBench Language (89,5) y #9 escritura creativa de Arena, la mejor colocación combinada de todos | No lidera ninguno de los tres en solitario; Gemini 4 Argon lidera ahora la escritura creativa de Arena, con Claude Opus 5.5 segundo | $10 / $50 |
| Claude Fable 5 | Fuerte en los tableros de votos humanos | #1 LiveBench Language (90,7), #3 escritura creativa de Arena (1501,5), #4 Arena texto (1503,7) | #11 EQ-Bench; la opción más cara aquí | $10 / $50 |
| Kimi K3 | Ficción creativa y voz | #5 EQ-Bench Creative Writing (2082,3) | Solo #28 en Arena escritura creativa | $3 / $15 |
| Claude Sonnet 5.5 | Escritura gratuita para el día a día | Gratis en claude.ai, contexto 1M; #3 GDPval-AA v2.1 (1838), tras Opus 5.5 y Muse Wonder Full | 83,4 LiveBench Language; #24 escritura creativa de Arena; aún sin valorar en EQ-Bench | $2 / $10 |
| Claude Opus 5.5 | El mejor en escritura creativa de Arena entre los disponibles | #2 escritura creativa de Arena (1517) y #2 Arena texto (1507); #1 GDPval-AA v2.1 (1866) | #7 EQ-Bench y #10 LiveBench Language | $4 / $20 |
| Gemini 4 Argon | La prosa más votada en Arena | #1 escritura creativa de Arena (1519,2) y #1 Arena texto (1525,4) | Sin valorar en EQ-Bench ni LiveBench | $19.99/mes Google AI Pro; $2 / $10 API introductorio hasta el 30/11 |
| GPT-5.5 | Escritura de negocios anclada en hechos | Mejoras documentadas de fiabilidad factual sobre GPT-5.4 | Los niveles de razonamiento están ahora marcados como obsoletos | $5 / $30 |
| Gemini 3.8 Flash | Borradores en volumen a escala | Intelligence Index 40,9, 308,4 tok/s de salida, contexto 1M | Ajustado a agentes más que a prosa; el precio introductorio se duplica el 1 de enero de 2027 | $0.75 / $3.75 |
La corona de escritura sigue en manos de Claude Fable 5.1, pero su margen en Arena se ha estrechado. Gemini 4 Argon de Google, anunciado el 30 de septiembre, entró directamente primero en el tablero de escritura creativa de Arena con 1519,2, relegando a Claude Opus 5.5 al segundo puesto y a Claude Fable 5 al tercero, y Fable 5.1 bajó del séptimo al décimo y desde entonces ha subido al noveno, así que lo que afirma esta tarjeta es ahora el top diez de los tres tableros de prosa en lugar del top siete. Argon aún no puede llevarse la corona: desde el 13 de octubre pueden usarlo los suscriptores de Google AI Pro y Ultra, pero EQ-Bench y LiveBench siguen sin valorarlo. En septiembre llegaron Claude Opus 5.5 y Claude Sonnet 5.5, Sonnet 5.5 sustituyó a Sonnet 5 como elección gratuita y GPT-6.1 Sol entró segundo en LiveBench Language, empujando allí a Fable 5.1 al tercer puesto.
Mejor IA para chat & asistente diario
La mejor IA para el chat del día a día es GPT-6, y la razón honesta es el alcance en lugar de la posición en los tableros. Desde el 7 de octubre es con lo que ChatGPT responde por defecto: GPT-6 Sol en Plus, Pro, Business y Enterprise, y GPT-6 Luna en Free y Go, que se despliega desde el 8 de octubre. Eso lo convierte en el asistente que la mayoría de la gente puede abrir de verdad.
En preferencia humana pura está lejos de la cabeza. GPT-6 Sol ocupa el #67 del tablero de texto de Arena con 1455,9, por debajo de su predecesor GPT-5.6 Sol en el #20, mientras Gemini 4 Argon lidera con 1525,4 y Claude Opus 5.5 es segundo con 1507,1. Artificial Analysis da a GPT-6 Sol 47,6 en el Intelligence Index v4.3.2 con esfuerzo máximo y a GPT-6 Luna 38,1. En la API, Sol cuesta $2 / $10 y Luna $0,10 / $0,50 por 1M de tokens.
| Modelo | Mejor para | Fortaleza | Debilidad | Precio |
|---|---|---|---|---|
| GPT-6 | Chat diario, por defecto de ChatGPT | El asistente que la mayoría puede abrir: Sol en planes de pago, Luna en Free y Go | GPT-6 Sol solo #67 en Arena texto | Gratis / $20/mes Plus; API $0.10 / $0.50 (Luna) a $2 / $10 (Sol) |
| Gemini 4 Argon | La conversación más votada | #1 en Arena texto (1525,4); tasa de alucinación del 15 %, la más baja entre los modelos punteros | Valoración de Arena aún preliminar; Google AI Pro o superior en la app de Gemini | $19.99/mes Google AI Pro; $2 / $10 API introductorio hasta el 30/11 |
| Claude Opus 5.5 | La conversación con mayor puntuación | #1 en el Intelligence Index (57,6) y #2 en Arena texto (1507,1) | No está en el plan Free; con límites de uso en Pro | $20/mes Pro, $4 / $20 API |
| Claude Sonnet 5.5 | Chat gratuito con Claude | Gratis en claude.ai; #2 en el Intelligence Index (56,0), solo por detrás de Claude Opus 5.5 | Solo #32 en Arena texto; en las apps funciona por defecto con esfuerzo Medium | Gratis / $20/mes Pro, $2 / $10 API |
| GPT-5.5 Instant | Trabajo diario sensible a las alucinaciones | 52,5 % menos afirmaciones alucinadas vs. 5.3 Instant | Los niveles de razonamiento están ahora marcados como obsoletos | $20/mes Plus; API $5 / $30 |
| Gemini 3.6 Flash | Rápido, barato, multimodal | Contexto 1M, #23 en Arena texto | En la app de Gemini requiere Google AI Plus desde el 9 de octubre; 3.8 Flash lo supera al mismo precio | AI Plus / $0.75 / $3.75 API |
| Fello AI | Muchos modelos líderes, una app | ChatGPT + Claude + Gemini + Grok + DeepSeek y más en Mac, iPhone y iPad | Enrutado por la app, no directo | Desde $11.99/mes |
La elección para chat pasa de GPT-5.6 a GPT-6, por la misma razón por la que la tenía GPT-5.6: el 7 de octubre OpenAI convirtió GPT-6 en el modelo por defecto de ChatGPT, Sol en los planes de pago y Luna en Free y Go desde el 8 de octubre. Los tableros por votación lo sitúan por debajo de su predecesor, GPT-6 Sol #67 en Arena texto frente al #20 de GPT-5.6 Sol, y por eso esta elección se basa en el alcance. Desde el 13 de octubre Gemini 4 Argon está en la app de Gemini para los suscriptores de Google AI Pro y Ultra, así que el líder del tablero de texto de Arena, con 1525,4, ocupa el segundo puesto del podio; Claude Opus 5.5 pasa al tercero y Claude Sonnet 5.5 sigue en la tabla como la elección para Claude gratis.
Mejor IA para crear imágenes
La mejor IA para generar imágenes es ChatGPT Images 2.5, que OpenAI convirtió en la opción predeterminada de todos los planes de ChatGPT el 8 de septiembre y que lidera los cuatro tableros de imagen que seguimos.
Sus dos modelos quedan primero y segundo en cada uno: GPT-Image-2.5 Sunburst, pensado para la precisión, lidera Arena texto a imagen con 1424,6 y la edición de imágenes de Arena con 1523,6, y en Artificial Analysis AA-Image-T2I v2.0 con 1197 y AA-Image-Editing v2.0 con 1182, con el más rápido GPT-Image-2.5 Flare segundo en los cuatro. Toma como provisional la distancia entre Sunburst y Flare en Arena texto a imagen, porque cada uno se apoya en unos 17.000 votos frente a los 93.000 de GPT Image 2. MAI-Image-2.6 es el segundo, tercero en el tablero de edición de Artificial Analysis y quinto en Arena texto a imagen con 1332,1, en empate estadístico con Grok Imagine Image 2.0, justo por delante.
El tercero es Grok Imagine Image 2.0 de SpaceXAI, lanzado en agosto y disponible en Grok Imagine y en la API de xAI: es cuarto en el tablero de texto a imagen de Artificial Analysis, en la edición de imágenes de Arena y ahora también en Arena texto a imagen, por delante de Muse Image de Meta en tres de los cuatro tableros. Nano Banana 2.1 de Google, lanzado el 6 de octubre, es ahora el modelo de Google mejor situado: sexto en Arena texto a imagen con 1327,8, en la misma franja de puestos que MAI-Image-2.6 y Grok Imagine Image 2.0, y sexto en la edición de Arena, aunque Artificial Analysis aún no lo ha valorado.
El mejor modelo de imagen que puedes descargar es Qwen-Image-2.1 de Alibaba, lanzado el 20 de septiembre y ahora el modelo de pesos abiertos mejor situado en los cuatro tableros, 18.º en la edición de imágenes de Arena y en los dos tableros de Artificial Analysis y 19.º en Arena texto a imagen. Su licencia solo permite investigación y evaluación, así que no es una opción comercial gratuita. Nuestro análisis completo de lo que se lanzó está en ChatGPT Images 2.5.
| Modelo | Mejor para | Fortaleza | Debilidad | Precio |
|---|---|---|---|---|
| ChatGPT Images 2.5 | Imágenes con texto legible | #1 y #2 en los cuatro tableros: Arena texto a imagen (1424,6 / 1397,6), Arena edición (1523,6 / 1481,0), texto a imagen de Artificial Analysis (1197 / 1191) y edición (1182 / 1162) | Su liderato en Arena texto a imagen se apoya en unos 17.000 votos por modelo | Predeterminado en todos los planes de ChatGPT |
| MAI-Image-2.6 | Editar una imagen que ya tienes | #3 en edición de imágenes de Artificial Analysis (1137) y #5 en Arena texto a imagen (1332,1) | Vista previa pública, aún no en Copilot ni en Bing; perdió el liderato de edición de Artificial Analysis ante ChatGPT Images 2.5 | MAI Playground / Microsoft Foundry |
| Grok Imagine Image 2.0 | Menos restricciones, modo Spicy | #4 en texto a imagen de Artificial Analysis (1155) y #4 en edición de imágenes de Arena (1439,1); #4 en Arena texto a imagen (1333,5) | Solo #10 en edición de imágenes de Artificial Analysis | $30 al mes SuperGrok; API de xAI |
| Nano Banana 2.1 | El modelo de imagen de Google para el día a día | #6 Arena texto a imagen (1327,8) y #6 en edición de imágenes de Arena (1428,1), el mejor de cualquier modelo de Google; en la API, la mitad del precio por imagen de Nano Banana 2 | Aún sin valorar por Artificial Analysis; los tokens de entrada cuestan el triple que en Nano Banana 2 | Aplicación Gemini / AI Studio; $0,0336 por imagen 1K |
| Seedream 5.0 Pro | Texto multilingüe + edición por regiones | 10+ idiomas incl. árabe RTL, edición con lazo y capas | En torno al décimo puesto en los tableros independientes; incertidumbre de derechos de autor | BytePlus / Magnific |
| Midjourney v8 | Arte estilizado, ilustración | Base estética que la mayoría de los artistas prefieren | Más flojo en texto dentro de la imagen | $10-$120/mes |
| Qwen-Image-2.1 | El mejor modelo de imagen que puedes descargar | El modelo de pesos abiertos mejor situado en los cuatro tableros: #18 edición de imágenes de Arena (1368,7), #19 Arena texto a imagen (1222,9) y #18 en los dos tableros de Artificial Analysis; generador de 7B, PNG transparentes, hasta 10 imágenes de referencia | Qwen Research License, solo para investigación o evaluación, sin uso comercial | Descarga gratuita (Hugging Face) |
| Qwen-Image-3.0-Pro | Composiciones densas con mucho texto | #13 Arena texto a imagen (1255,2) y #14 texto a imagen de Artificial Analysis (1090); prompts de hasta 4500 tokens, texto en 12 idiomas | Solo alojado, sin pesos; sin valorar en la edición de imágenes de Arena | Qwen Chat; $0,04-$0,075 por imagen en la API |
| Muse Image | Edición de imágenes, ecosistema Meta | #6 en edición de imágenes de Artificial Analysis (1118) y #7 en su texto a imagen | Fuera del podio; #9 en Arena texto a imagen y #8 en edición de Arena | App de Meta AI |
ChatGPT Images 2.5 mantiene la corona de imagen y sigue ocupando el primer y el segundo puesto en los cuatro tableros que seguimos. Desde la última actualización Google lanzó Nano Banana 2.1 el 6 de octubre, y Arena lo situó quinto en texto a imagen y sexto en edición, el mejor de cualquier modelo de Google, en la misma franja de puestos que MAI-Image-2.6 y Grok Imagine Image 2.0. Ocupa la fila de Nano Banana 2 en la tabla en lugar de un puesto en el podio: ahora va por detrás de MAI-Image-2.6 y de Grok Imagine Image 2.0 en los dos tableros de Arena, y Artificial Analysis aún no lo ha valorado.
Desde entonces Grok Imagine Image 2.0 ha subido al cuarto puesto en Arena texto a imagen, 1,4 puntos por encima de MAI-Image-2.6, quinto; Nano Banana 2.1 es ahora sexto y Reve 2.1, séptimo. A principios de mes Grok Imagine Image 2.0 le quitó el tercer puesto a Muse Image, y Artificial Analysis pasó sus dos tableros de imagen a la v2.0. En septiembre, Images 2.5 sustituyó a GPT Image 2 en la cima el 8 de septiembre.
Mejor IA para crear vídeos
La mejor IA para generar vídeo es MiniMax H3, que MiniMax lanzó el 31 de julio con pesos abiertos, y lo que la respalda es que se queda cerca de la cabeza en todas partes en lugar de ganar un único tablero.
Lidera el tablero de imagen a vídeo de Arena con 1495,4, por delante de Gemini Omni 1.1 Flash con 1488,5 y del Wan 3.0 de Alibaba con 1479,8; en el tablero de imagen a vídeo de Artificial Analysis es segundo con 1181, solo por detrás de MiniMax H3 Max, un modelo que Fal construyó sobre él; y es cuarto en el tablero de texto a vídeo de Artificial Analysis con 1137. Su punto débil es el tablero de texto a vídeo de Arena, donde es octavo con 1460,3.
Genera clips 2K de 4 a 15 segundos con audio estéreo nativo, desde $0,13 por segundo en 2K, y los pesos están en Hugging Face con la licencia comunitaria propia de MiniMax, sin el escalador 2K y con solicitud previa en EE. UU., la UE, el Reino Unido y Corea del Sur. Gemini Omni 1.1 Flash, nuestra elección hasta esta actualización, sigue liderando el tablero de texto a vídeo de Arena con 1516,2, en empate estadístico con Gemini Omni Flash con 1512,9, y es la elección para tomas largas: extensión de escena en pasos de 10 segundos hasta 40 segundos, control del primer y el último fotograma y salida en 4K, desde unos $0,03 por segundo en 360p hasta $0,30 en 4K.
Pero Artificial Analysis ya lo ha valorado, y queda octavo en texto a vídeo con 1113, sin ninguna valoración de imagen a vídeo. Wan 3.0 lidera el tablero de texto a vídeo de Artificial Analysis con 1156 y es tercero en el de imagen a vídeo de Arena, pero solo sexto en el de texto a vídeo de Arena. Si necesitas tomas más largas dentro de las herramientas de Google, Veo 3.1 sigue funcionando en la aplicación Gemini, AI Studio y Vertex AI con audio nativo y salida en 1080p.
| Modelo | Mejor para | Fortaleza | Debilidad | Precio |
|---|---|---|---|---|
| MiniMax H3 | Mejor vídeo con IA en general | #1 Arena imagen a vídeo (1495,4), #2 imagen a vídeo de Artificial Analysis (1181), #4 texto a vídeo de Artificial Analysis (1137); clips 2K de 4-15 s con audio estéreo nativo | #8 en Arena texto a vídeo (1460); los pesos abiertos excluyen el escalador 2K y exigen solicitud en EE. UU., la UE, el Reino Unido y Corea del Sur | $0.13/s en 2K |
| Gemini Omni 1.1 Flash | Tomas largas y 4K | #1 Arena texto a vídeo (1516), #2 Arena imagen a vídeo (1488,5); extensión de escena a 40 segundos, salida en 4K | Solo #8 en texto a vídeo de Artificial Analysis (1113); sin valoración de imagen a vídeo de Artificial Analysis | $0,03-$0,30/s; Gemini API / AI Studio / Flow |
| Gemini Omni Flash | Clips de diez segundos más baratos | #2 Arena texto a vídeo (1513), #3 imagen a vídeo de Artificial Analysis (1178); edición conversacional | Se queda en generaciones de diez segundos | ~$0.10/s; app Gemini / AI Studio |
| Wan 3.0 | Vídeo a partir de documentos y diapositivas | #1 texto a vídeo de Artificial Analysis (1156), #3 Arena imagen a vídeo (1479,8); 2-30 s, hasta 1080p, entrada Omni-Reference | Solo API, sin pesos publicados; #6 en Arena texto a vídeo | $0.05-$0.20/s |
| Dreamina Seedance 2.5 | Aspirante de ByteDance | #3 texto a vídeo de Artificial Analysis (1143), #4 Arena imagen a vídeo (1477,4) | #7 Arena texto a vídeo (1474); ecosistema ByteDance, acceso occidental limitado | Dreamina / BytePlus |
| Muse Video | Vídeo en el ecosistema Meta | #9 en Arena texto a vídeo con 1456 | El más nuevo del grupo, herramientas escasas | Aplicación Meta AI |
| Veo 3.1 | Clips de producción más largos | Audio nativo, 1080p, fuerte consistencia física | #12 en Arena vídeo, no el líder de calidad | Google AI Pro / Ultra |
| Kling 3.0 / 3.0 Turbo | Iteración rápida a menor coste | 4K nativo, 60fps, clips de 15 segundos; Turbo salió el 17 de junio | Fuera del top 16 en Arena texto a vídeo | Desde $10/mes |
| Luma Ray 3 | Escenas fotorrealistas | Fuerte realismo para paisajes | Comunidad más pequeña | Gratis / desde $9.99/mes |
La corona de vídeo pasa de Gemini Omni 1.1 Flash a MiniMax H3. Desde la última actualización Artificial Analysis ha valorado por primera vez Omni 1.1 Flash, y en su tablero de texto a vídeo, ahora en la versión 2.0, queda octavo con 1113, por detrás de Wan 3.0 con 1156 y de MiniMax H3 con 1137. Como H3 sigue primero en el tablero de imagen a vídeo de Arena y segundo en el de Artificial Analysis, solo por detrás de un modelo construido sobre él, H3 se sitúa ahora mejor en el conjunto de los cuatro tableros que seguimos.
Omni 1.1 Flash conserva el primer puesto en el tablero de texto a vídeo de Arena, todavía en empate estadístico con Gemini Omni Flash, así que sigue en el podio como la elección para texto a vídeo, y Wan 3.0 le quita el tercer puesto a Dreamina Seedance 2.0. A principios de mes FLUX 3 Video y Grok Imagine Video 1.5 entraron tercero y cuarto en el tablero de texto a vídeo de Arena. En septiembre, Gemini Omni 1.1 Flash ocupó el primer puesto del tablero de texto a vídeo de Arena y MiniMax H3 se hizo con el primero del de imagen a vídeo.
Mejor IA para programar
La mejor IA para programar es Claude Opus 5.5, que Anthropic lanzó el 22 de septiembre, aunque ya no lidera todos los tableros, y el modelo que le quitó dos de ellos es su propio hermano más barato.
Claude Sonnet 5.5, lanzado el 28 de septiembre, lidera la ejecución propia de Terminal-Bench 4.0 de Artificial Analysis con un 63,6 % frente al 59,6 % de Opus 5.5 y LiveBench Coding con 91,4 frente a 89,3. Opus 5.5 mantiene la corona por el resto de las pruebas. Lidera el tablero WebDev de Arena con 1813, por delante de GPT-6 Astra con 1786 y Claude Sonnet 5.5 con 1774. Logra 71,7 en LiveBench Agentic Coding, solo por detrás de DeepSeek V4.1-Flash, donde Sonnet 5.5 se queda en 56,3, y en los harness propios de Anthropic supera a Sonnet 5.5 en FrontierCode v1.1, 54,4 % frente a 52,1 %, y en CursorBench 4.0, 57,8 % frente a 55,5 %. El precio favorece ahora a Sonnet 5.5 con cualquier nivel de esfuerzo.
Cuesta $2 / $10 por 1M de tokens frente a los $4 / $20 de Opus 5.5, y Artificial Analysis sitúa ya incluso una tarea del Intelligence Index con esfuerzo máximo en $5,46 frente a los $5,98 de Opus 5.5; en xhigh logra 51,9 en el índice por $2,01 la tarea y en high 46,7 por $0,88. Opus 5.5 también ha tomado el tablero imagen a WebDev de Arena con 1748,5, por delante de Sonnet 5.5 con 1740,0 y GPT-6 Astra con 1731,4; Astra iguala el 59,6 % de Opus 5.5 en Terminal-Bench 4.0 en xhigh, a $10 / $50, y Claude Fable 5.1 es quinto en WebDev y cuarto en imagen a WebDev.
GPT-6.1 Sol es la opción barata de OpenAI: cuarto en WebDev y 56,1 % en Terminal-Bench 4.0 por $0,72 por tarea del índice, aunque LiveBench lo deja muy fuera de los diez primeros en Coding, con 80,7. Gemini 4 Argon lidera la tabla de la propia Google en DeepSWE v1.1 con un 77,9 %, pero Artificial Analysis mide un 57,1 % en Terminal-Bench 4.0, Arena lo sitúa noveno en WebDev y desde el 13 de octubre está en la API de pago y en Antigravity para los suscriptores de Google AI Ultra.
Claude Haiku 5.5, lanzado el 7 de octubre a $0,10 / $0,50, es el Claude barato para el trabajo de subagentes a gran volumen: un 33 % en la ejecución de Terminal-Bench 4.0 de Artificial Analysis, igual que GLM 5.3 Flash, y 57,2 en LiveBench Agentic Coding, justo por encima de Sonnet 5.5, aunque Arena solo lo sitúa en el puesto 30 en WebDev. Entre los pesos abiertos, el MiMo-V2.6-Pro de Xiaomi logra un 34,8 % en Terminal-Bench 4.0 bajo MIT puro a $0,13 por tarea del índice, GLM-5.3 sigue siendo el modelo abierto más fuerte en ese harness con un 41,9 % y Kimi K3 es el modelo abierto mejor situado en Arena WebDev, decimocuarto con 1654, con solo un 12,6 % en el harness.
Artificial Analysis ha retirado tanto su Coding Index como su Coding Agent Index, así que las dos clasificaciones compuestas de programación que citaba esta página ya no existen.
| Modelo | Mejor para | Fortaleza | Debilidad | Precio (por 1M de tokens) |
|---|---|---|---|---|
| Claude Opus 5.5 | Mejor programación en general | #1 Arena WebDev (1813) y #1 Intelligence Index (57,6, v4.3.2); 71,7 en LiveBench Agentic Coding, 15 puntos por encima de Sonnet 5.5 | Segundo tras Sonnet 5.5 en Terminal-Bench 4.0 (59,6 % frente a 63,6 %) y LiveBench Coding (89,3 frente a 91,4) | $4 / $20 |
| Claude Sonnet 5.5 | La opción de valor para programar | #1 Terminal-Bench 4.0 (63,6 %) y #1 LiveBench Coding (91,4), #3 Arena WebDev (1774); en xhigh 51,9 en el índice por $2,01 la tarea | 56,3 en LiveBench Agentic Coding, 15 puntos por detrás de Opus 5.5 | $2 / $10 |
| GPT-6 Astra | Segundo en WebDev de Arena | #2 Arena WebDev (1786) y #3 imagen a WebDev (1731,4); 59,6 % Terminal-Bench 4.0 en xhigh | 2,5 veces el precio de Opus 5.5; por detrás de Sonnet 5.5 en Terminal-Bench y muy por detrás de ambos modelos Claude en LiveBench Coding | $10 / $50 |
| Claude Fable 5.1 | Mayor puntuación compuesta antes de Opus 5.5 | #5 Arena WebDev y #4 imagen a WebDev; Intelligence Index 53,4; AA-Briefcase 1675 | 52,0 % Terminal-Bench 4.0; 2,5 veces el precio de Opus 5.5 | $10 / $50 |
| Claude Opus 5 | Sustituido por Opus 5.5 | 49,0 % Terminal-Bench 4.0 y #7 Arena WebDev y #7 imagen a WebDev | Cuesta más por token que Opus 5.5 y puntúa siete puntos menos | $5 / $25 |
| Claude Fable 5 | Trabajo agéntico más duro y de horizonte largo | Intelligence Index 49,6; 42,4 % Terminal-Bench 4.0; contexto de 1M | El más caro por tarea del índice en esta tabla, $8,75; #10 en Arena imagen a WebDev | $10 / $50 |
| Qwen3.8-Max-0902 | Breve dueño del tablero WebDev de Arena | #10 Code Arena: WebDev (1674); Intelligence Index 45,4; 2,4 billones de parámetros, contexto de 1M | Solo API de QwenCloud, sin interfaz de consumo; perdió el liderato de WebDev en días | $2 / $6 |
| Kimi K3 | Modelo abierto mejor situado en Arena | #14 Arena WebDev (1654), la mejor posición abierta en ese tablero; 2,8 billones/104.000 millones activos | Solo 12,6 % en Terminal-Bench 4.0; 1,56 TB para alojarlo | $3 / $15 |
| GPT-5.6 Sol | El buque insignia barato de OpenAI | Intelligence Index 47,0; 39,9 % Terminal-Bench 4.0 | Sustituido por GPT-6 Sol, que puntúa más alto a mitad de precio; METR le señaló manipulación de evaluaciones | $4 / $20 |
| GPT-6 Sol | Programación con GPT-6 barata en Codex | Intelligence Index 47,6 (v4.3.2) y 43,9 % en Terminal-Bench 4.0, ambos por encima de GPT-5.6 Sol y a mitad de precio | #8 Arena WebDev (1688) | $2 / $10 |
| GPT-6.1 Sol | El modelo de cabeza más barato por tarea | Intelligence Index 51,8 (v4.3.2), #4 Arena WebDev (1755) y 56,1 % en Terminal-Bench 4.0 a $0,72 por tarea del índice, con entrada en caché a $0,10 | 80,7 en LiveBench Coding, muy fuera de los diez primeros; solo en Codex y ChatGPT Work, no en Chat | $2 / $10 |
| Gemini 4 Argon | Tareas de software largas | 77,9 % en DeepSWE v1.1 según las cifras de Google; Intelligence Index 52,6 a $1,99 por tarea del índice | 57,1 % en Terminal-Bench 4.0 y #9 Arena WebDev (1678) | $2 / $10 introductorio hasta el 30/11, $4 / $20 estándar |
| Muse Spark 1.3 | Programación agéntica barata | Intelligence Index 48,1 a $1,25 / $4,25 y $1,60 por tarea del índice | 33,3 % en Terminal-Bench 4.0; las victorias en programación salen del gráfico de la propia Meta, medido en una variante max solo para socios | $1,25 / $4,25 |
| Muse Wonder Full | El modelo más potente de Meta, dentro de Muse Code | Intelligence Index 55,8 (v4.3.2), tercero entre modelos distintos; #2 GDPval-AA v2.1 (1857); 57,1 % Terminal-Bench 4.0 | Solo con suscripción a Muse Code (planes de $50 y $200), sin API; Arena aún no lo ha valorado | Muse Code, desde $50/mes |
| Muse Wonder | El modelo de frontera de Meta en la API | Intelligence Index 52,4 (v4.3.2); 52,0 % Terminal-Bench 4.0; contexto de 1M | Los mismos $4 / $20 que Opus 5.5, que puntúa 5,2 puntos más; $4,52 por tarea del índice | $4 / $20 |
| Grok 4.7 | Programador barato con buena relación | 46,3 % CursorBench 4.0 y 71,0 % DeepSWE v1.1 según las cifras de la propia SpaceXAI; Intelligence Index 46,3 | 24,7 % en Terminal-Bench 4.0; los prompts de 200K tokens o más refacturan la petición entera al doble | $2 / $6 |
| Gemini 3.8 Flash | Programación agéntica a escala | Intelligence Index 40,9; 308,4 tokens de salida por segundo | 19,7 % en Terminal-Bench 4.0; el precio de lanzamiento se duplica el 1 de enero de 2027 | $0,75 / $3,75 |
| GLM 5.3 Flash | El programador serio más barato que puedes alojar | 32,8 % Terminal-Bench 4.0 a $0,25 por tarea del índice; MIT, 320.000 millones/18.000 millones activos | GLM-5.3 llega al 41,9 % en el mismo harness; sin producto de consumo | Pesos abiertos (MIT) |
| Claude Haiku 5.5 | El Claude más barato para subagentes | Intelligence Index 43,4 (v4.3.2) a $0,21 por tarea del índice; 33 % Terminal-Bench 4.0, igual que GLM 5.3 Flash; 57,2 en LiveBench Agentic Coding, por encima de Sonnet 5.5 | #30 Arena WebDev (1587); Anthropic dice que Sonnet 5.5 y Opus 5.5 siguen siendo mejores para la programación agéntica compleja; los prompts de más de 100K tokens cuestan cinco veces más | $0,10 / $0,50 |
| MiMo-V2.6-Pro | El mayor Intelligence Index abierto | 46,3 en v4.3.2 y 34,8 % Terminal-Bench 4.0 a $0,13 por tarea del índice; MIT, 1,02 billones/42.000 millones activos | Solo #19 en Arena WebDev (1629), cinco puestos por detrás de Kimi K3 | $0,435 / $0,87 |
Claude Opus 5.5 mantiene la corona de programación. Desde la última actualización llegó el 7 de octubre Claude Haiku 5.5, a $0,10 / $0,50, que ocupa una fila de la tabla como el Claude más barato para el trabajo de subagentes, aunque Arena solo lo sitúa en el puesto 30 en WebDev. Artificial Analysis cifra ahora una tarea del índice de Sonnet 5.5 con esfuerzo máximo en $5,46, por debajo de los $5,98 de Opus 5.5, así que Opus 5.5 conserva la corona por WebDev y LiveBench Agentic Coding, no por coste. Claude Sonnet 5.5 ha entrado tercero en el tablero WebDev de Arena con 1774, por detrás de GPT-6 Astra con 1786, lo que empuja a GPT-6.1 Sol al cuarto puesto y a Claude Fable 5.1 al quinto, y Gemini 4 Argon, que entró a principios de mes, es ahora noveno. Desde entonces Opus 5.5 también ha arrebatado a GPT-6 Astra el tablero imagen a WebDev de Arena, y el 12 de octubre llegó Muse Wonder de Meta con dos filas de la tabla: Muse Wonder Full marca 55,8 en el índice pero solo funciona en Muse Code, y Muse Wonder cuesta los mismos $4 / $20 que Opus 5.5 por 52,4.
Argon lidera la propia tabla de DeepSWE v1.1 de Google con un 77,9 %, pero en el Terminal-Bench 4.0 de Artificial Analysis logra un 57,1 %, por detrás de Sonnet 5.5, Opus 5.5 y GPT-6 Astra, y su lanzamiento público del 13 de octubre no cambió esas puntuaciones. En septiembre la corona cambió de manos dos veces, de Claude Fable 5.1 a GPT-6 Astra y después a Opus 5.5, y Claude Sonnet 5.5 se llevó Terminal-Bench 4.0 y LiveBench Coding como opción de valor.
Mejor IA para creatividad
La mejor IA para trabajo creativo sin filtros y a la última es Grok 4.7, y queremos ser exactos sobre por qué. Esta elección va de la línea de producto, no de la calidad de la prosa.
Grok lleva las menores restricciones de contenido de cualquier modelo de frontera y la única integración nativa con X en tiempo real, lo que lo convierte en el único modelo que entra en encargos atrevidos, de actualidad o deliberadamente provocadores que los demás rechazan. SpaceXAI lanzó Grok 4.7 el 21 de septiembre en la API de Grok, Cursor y Grok Build, y desde el 3 de octubre también impulsa el modo Expert de grok.com, además del modo Fast para los suscriptores de pago. No es el mejor escritor, aunque el panorama es más mixto que antes.
EQ-Bench ya ha valorado Grok 4.7 y lo sitúa octavo con 2006,7, dentro de su top diez y muy por encima de Grok 4.5 en el 52, pero los votantes humanos de Arena solo lo colocan en el puesto 74 de escritura creativa, por detrás de Grok 4.6 en el 54 y del más antiguo Grok 4.20-beta1 en el 23. Si eliges solo por calidad de salida, Gemini 4 Argon lidera ahora el tablero de escritura creativa de Arena, disponible en Google AI Pro desde el 13 de octubre, con Claude Opus 5.5 segundo y Claude Fable 5 tercero, mientras que EQ-Bench pone primero a GPT-6 Astra con 2173,3, segundo a Claude Fable 5.1 y quinto a Kimi K3. Elige Grok por lo que te dejará hacer, no por lo bien que escribe.
| Modelo | Mejor para | Fortaleza | Debilidad | Precio |
|---|---|---|---|---|
| Grok 4.7 | Sin filtros, con opinión, a la última | Menos restricciones de contenido, anclaje nativo en X en tiempo real | #74 en escritura creativa de Arena, aunque #8 en EQ-Bench (2006,7) | $2 / $6 API; app SuperGrok de $30 al mes |
| Claude Fable 5 | Prosa creativa de máxima calidad | #3 Arena escritura creativa, #1 LiveBench Language | Límites cautelosos ante encargos atrevidos | $10 / $50 API |
| Kimi K3 | Ficción y voz propia | #5 EQ-Bench Creative Writing con 2082,3 | Solo #28 en escritura creativa de Arena | $3 / $15 |
| Claude Opus 5 | Creatividad estructurada de formato largo | Mantiene hilos largos y se autoedita; Intelligence Index 50,8, ahora por detrás de seis modelos más nuevos | El más cauteloso del grupo | $20/mes Pro; $5 / $25 API |
| Gemini 3.1 Pro | Creatividad multimodal | Fuerte cadena de texto, imagen y vídeo | En la app de Gemini requiere Google AI Pro desde el 9 de octubre | AI Pro / $2.00-$4.00 API entrada |
| Grok Imagine (Spicy Mode) | NSFW / creatividad para adultos | La generación de imágenes más permisiva | Caso de uso de nicho | $30/mes SuperGrok |
Grok mantiene esta elección con Grok 4.7, y no ha cambiado nada en lo permisivo del producto ni en su acceso en directo a X, que es en lo que se apoya la elección. El tablero de escritura creativa de Arena se movió a su alrededor: Gemini 4 Argon, anunciado el 30 de septiembre, entró primero, Claude Opus 5.5 es ahora segundo y Claude Fable 5 tercero, y Grok 4.7 ha bajado al puesto 74. EQ-Bench no ha cambiado y sigue situando a 4.7 octavo. La app de la que trata de verdad el argumento de la permisividad se puso al día el 3 de octubre, cuando Grok 4.7 empezó a impulsar el modo Expert de grok.com. En septiembre, Grok 4.7 sustituyó a Grok 4.6 como buque insignia de SpaceXAI el 21 de septiembre y lo valoraron los dos tableros de escritura creativa.
Mejor IA para precisión & investigación
La mejor IA para precisión e investigación es Claude Fable 5.1, que tiene la mayor precisión factual que ha medido Artificial Analysis, un 67 % en AA-Omniscience.
Esa es exactamente la columna con la que se decide esta categoría. Claude Opus 5.5 superó a Fable 5.1 en casi todo lo demás al llegar el 22 de septiembre, incluido Humanity's Last Exam con un 61,4 % frente al 59,1 % y el índice AA-Omniscience que penaliza las alucinaciones con 46,4 frente a 43,5, pero en precisión factual pura marca un 66 % frente al 67 % de Fable 5.1. Toma esa diferencia de un punto como un empate y lee los dos juntos: Opus 5.5 es mejor apuesta cuando una respuesta equivocada es peor que ninguna, y Fable 5.1 cuando quieres acertar el mayor número de datos.
La elección de valor es ahora GPT-6.1 Sol, que responde bien al 62 % con un índice AA-Omniscience de 41,5 a $2 / $10 por 1M de tokens y $0,72 por tarea del índice, y logra un 98,5 % en ARC-AGI-1 de ARC Prize por $0,06 la tarea. Eso supera a Gemini 3.1 Pro, nuestra elección de valor hasta esta actualización, en todas las medidas de precisión que publica Artificial Analysis: marca un 55 % de precisión pura y un índice de 31,9.
Gemini 3.1 Pro mantiene su argumento cuando la respuesta tiene que estar al día, porque ancla las respuestas en la Búsqueda de Google y está en la app de Gemini (con Google AI Pro o superior desde el 9 de octubre), mientras que GPT-6.1 Sol funciona en ChatGPT Work, Codex y la API y no en la ventana de chat de ChatGPT. Gemini 4 Argon es el modelo a seguir: Artificial Analysis mide una tasa de alucinación del 15 %, la más baja entre los modelos punteros, porque prefiere no responder antes que adivinar, pero solo acierta el 50 %; desde el 13 de octubre está en la app de Gemini con Google AI Pro o superior.
En la búsqueda anclada en concreto, el tablero de búsqueda de Arena lo lidera OpenAI: GPT-5.6 Sol está arriba con 1257, Claude Fable 5 es quinto y Gemini 3.1 Pro con anclaje noveno. En el razonamiento novedoso la corona está en otra parte, con GPT-6 Astra liderando ARC-AGI-2 y ARC-AGI-3. Claude Opus 5 no tiene ninguna corona de precisión porque Artificial Analysis mide su tasa de alucinación en un 61 %.
| Modelo | Mejor para | Benchmark clave | Debilidad | Precio |
|---|---|---|---|---|
| Claude Fable 5.1 | La mayor precisión factual medida | 67 % de precisión factual en AA-Omniscience, la mayor que ha medido Artificial Analysis, un punto por encima de Claude Opus 5.5 | Sin nivel barato; sin valorar en el tablero de búsqueda de Arena; Opus 5.5 lidera Humanity's Last Exam y el índice AA-Omniscience | $10 / $50 |
| Claude Opus 5.5 | Cuando una respuesta equivocada es peor que ninguna | #1 índice AA-Omniscience (46,4) y #1 Humanity's Last Exam (61,4 %); 66 % de precisión pura | Un punto por detrás de Fable 5.1 en precisión pura | $4 / $20 |
| GPT-6.1 Sol | Mejor valor | 62 % de precisión pura y un índice AA-Omniscience de 41,5 a $0,72 por tarea del índice; 98,5 % ARC-AGI-1 a $0,06 la tarea | Tasa de alucinación del 54 %; en ChatGPT Work y Codex, no en Chat | $2 / $10 |
| Gemini 4 Argon | Menos alucinaciones | Tasa de alucinación del 15 % en AA-Omniscience, la más baja entre los modelos punteros | Solo un 50 % de precisión pura | $19.99/mes Google AI Pro; $2 / $10 API introductorio |
| Gemini 3.1 Pro | Búsqueda anclada; app de Gemini con AI Pro desde el 9 oct. | Anclaje nativo en la Búsqueda de Google; 98 % ARC-AGI-1 a $0.52/tarea | 55 % de precisión pura en AA-Omniscience, por debajo de GPT-6.1 Sol; #9 en Arena búsqueda | $2.00-$4.00 / $12.00-$18.00 (escalonado) |
| Claude Fable 5 | Búsqueda anclada | #5 en la tabla de búsqueda de Arena, por detrás de GPT-5.6 Sol | Ningún nivel barato único | $10 / $50 (Fable 5) |
| GPT-5.6 Sol | Razonamiento novedoso | #4 ARC-AGI-2 con 92,5 %, por detrás de GPT-6 Astra (95 %), GPT-6.1 Sol (94,2 %) y Claude Opus 5.5 (93,3 %) | Scheming señalado por METR | $4 / $20 |
| Claude Opus 5 | Los problemas inéditos más difíciles | 30,2 % ARC-AGI-3 en el harness estándar, segundo tras GPT-6 Astra (ARC Prize) | Artificial Analysis mide una tasa de alucinación del 61 % | $5 / $25 |
| Qwen 3.7 Max | Precisión frontier a precio de valor | 92,4 GPQA Diamond, 200 solicitudes gratis/día | Solo API, sin front-end de chat | $1.25 / $3.75 promo; $2.50 / $7.50 lista |
| Claude Opus 4.6 | Honestidad bajo presión | #1 en el tablero MASK de Scale SEAL con 96,28; Anthropic ocupa el top 5 | Reemplazado como buque insignia | Modelo legacy de Anthropic |
La corona de precisión sigue con Claude Fable 5.1, con un 67 % de precisión factual pura frente al 66 % de Claude Opus 5.5, y la elección de valor ha cambiado. GPT-6.1 Sol supera ahora a Gemini 3.1 Pro en todas las medidas de precisión que publica Artificial Analysis, un 62 % de precisión pura frente al 55 % y un índice AA-Omniscience de 41,5 frente a 31,9, y ARC Prize le da un 98,5 % en ARC-AGI-1 por $0,06 la tarea frente al 98 % por $0,52 de Gemini 3.1 Pro, así que se queda con la tarjeta de valor. Gemini 3.1 Pro sigue en la tabla por la búsqueda anclada y la app de Gemini, donde requiere Google AI Pro desde el 9 de octubre.
Gemini 4 Argon, anunciado el 30 de septiembre, trae la tasa de alucinación más baja que Artificial Analysis ha medido entre los modelos punteros, un 15 %, pero solo responde bien a la mitad de sus preguntas, así que su lanzamiento público del 13 de octubre no cambia nada en la cima. También hemos corregido dos líneas antiguas: la tasa de alucinación de Claude Opus 5 es ahora del 61 % y no del 50 %, y ya no lidera ARC-AGI-3. En septiembre, Opus 5.5 se llevó el índice que penaliza las alucinaciones y Humanity's Last Exam, por eso este bloque reparte ahora entre los dos modelos Claude en vez de coronar a uno.
Mejor IA para resolución de problemas
La mejor IA para resolver problemas difíciles es GPT-6 Astra, que le quitó los tableros de razonamiento a GPT-5.6 Sol a los pocos días de su lanzamiento.
Lidera LiveBench Reasoning con 92,65 y ARC-AGI-2 con un 95 %, la puntuación más alta que nadie ha logrado frente al panel humano del 100 % de ese tablero, y es cuarto en LiveBench Mathematics con 96,81, por detrás de Claude Opus 5.5 con 97,08, Claude Fable 5.1 con 97,01 y GPT-6.1 Sol con 96,83. También declara un 97,6 % en FrontierMath Tier 4 v2, una cifra que conviene leer junto a la advertencia de Epoch AI de que OpenAI financió el benchmark y tiene acceso exclusivo a parte de él. La pega son el precio y el alcance: $10 / $50 por 1M de tokens frente a los $2 / $10 de GPT-6.1 Sol, y necesita un plan de pago de ChatGPT.
GPT-6.1 Sol, lanzado el 29 de septiembre, es la alternativa de valor y casi un colíder: 92,63 en LiveBench Reasoning, a 0,02 de Astra, y un 94,2 % en ARC-AGI-2, a 0,8 puntos, por $0,25 la tarea frente a los $1,12 de Astra. Astra mantiene la corona porque sigue liderando ambos tableros y ARC-AGI-3, donde logra un 62,7 % en el harness estándar frente al 52,7 % de GPT-6.1 Sol. Gemini 4 Argon lidera la categoría de matemáticas de Arena, pero con solo unos cientos de votos, y ni LiveBench ni ARC Prize lo han valorado. GPT-5.6 Sol, la antigua elección de valor, es ahora quinto en LiveBench Reasoning y cuarto en ARC-AGI-2 con un 92,5 %.
Qwen 3.7 Max es la elección económica para problemas de competición con 97,1 en el índice HMMT de febrero de 2026 y 44,5 en Apex, con 200 solicitudes gratuitas al día. Claude Opus 5 sigue siendo la alternativa para cadenas largas de razonamiento agéntico, aunque Astra también le ha quitado ARC-AGI-3.
| Modelo | Mejor para | Benchmark clave | Debilidad | Precio |
|---|---|---|---|---|
| GPT-6 Astra | Matemáticas, ciencia y razonamiento más duros | #1 LiveBench Reasoning (92,65), #1 ARC-AGI-2 (95 %), #1 ARC-AGI-3 | Requiere un plan de pago de ChatGPT; 5 veces el precio de GPT-6.1 Sol | $10 / $50 |
| Claude Opus 5 | Cadenas largas de razonamiento agéntico | 1662 en AA-Briefcase v1.1 y 1724 en GDPval-AA v2.1, cuarto entre modelos distintos en ambos; 30,2 % ARC-AGI-3 | Astra lidera ahora ARC-AGI-3; 61 % de tasa de alucinación; ahora es un modelo heredado | $5 / $25 |
| GPT-5.6 Sol | Buque insignia STEM asequible | #4 ARC-AGI-2 (92,5 %); #5 LiveBench Reasoning (91,65), Mathematics 96,20 | FrontierMath aún sin publicar; METR señaló comportamiento tramposo | $100/mes ChatGPT Pro; API $4 / $20 |
| GPT-6.1 Sol | Opción de valor, razonamiento casi al nivel de Astra | #2 LiveBench Reasoning (92,63), #2 ARC-AGI-2 (94,2 %), #3 LiveBench Mathematics (96,83); Intelligence Index 51,8 a $0,72 por tarea del índice | 52,7 % en ARC-AGI-3 frente al 62,7 % de Astra; en ChatGPT Work y Codex, no en Chat | $2 / $10 |
| Qwen 3.7 Max | Matemáticas de competición con presupuesto ajustado | 97,1 HMMT 2026 feb, 44,5 Apex, 200 solicitudes gratis/día | Solo API | $1.25 / $3.75 promo; $2.50 / $7.50 lista |
| Claude Fable 5 | Matemáticas dentro de un flujo de programación | #3 en la subcategoría de matemáticas de Arena (1522), por detrás de Gemini 4 Argon y Claude Opus 5; 96,0 LiveBench Mathematics | La opción más cara aquí | $10 / $50 |
| GLM 5.3 Flash | Resolución de problemas open-weight | Intelligence Index 41,8 bajo MIT, casi ocho puntos por encima de GLM-5.2 con menos de la mitad de tamaño; 320B/18B activos, contexto 1M | Necesita un servidor multi-GPU, no una estación de trabajo; GLM 5.3 puntúa más alto según las propias cifras de Z.ai y se puede descargar desde el 28 de agosto, pero con más del doble de tamaño y bajo una licencia propia | Open weights (MIT) |
GPT-6 Astra mantiene la corona de resolución de problemas, por menos de un punto. ARC Prize ha valorado ya GPT-6.1 Sol, que logra un 94,2 % en ARC-AGI-2, segundo tras el 95 % de Astra y por delante del 93,3 % de Claude Opus 5.5, por menos de una cuarta parte del coste por tarea de Astra. Junto con su 92,63 en LiveBench Reasoning, a 0,02 de Astra, eso convierte a GPT-6.1 Sol en casi un colíder, pero Astra sigue liderando ambos tableros y ARC-AGI-3, así que la corona no cambia de manos. GPT-5.6 Sol cae al cuarto puesto en ARC-AGI-2. Gemini 4 Argon, anunciado el 30 de septiembre, lidera la categoría de matemáticas de Arena con unos cientos de votos pero aún no tiene puntuación de LiveBench ni de ARC Prize, y Claude Fable 5, que lideraba esa categoría de Arena, es ahora tercero. En septiembre, Astra le quitó esta corona a GPT-5.6 Sol tras su lanzamiento del 3 de septiembre, y LiveBench Mathematics pasó a Claude Opus 5.5.
Mejor agente de IA
El mejor agente de IA es Gemini Spark si lo quieres en la nube y Claude Cowork si lo quieres en tu escritorio.
Son elecciones conjuntas, no un primero y un segundo: Spark corre en una VM de Google Cloud, así que sigue trabajando con el portátil cerrado, integrado con Gmail, Docs y, desde principios de septiembre, Google Fotos; Cowork corre en tu Mac o tu PC con Windows y maneja tus aplicaciones locales y tu pantalla. Spark ya no es el único agente que sigue trabajando en la nube.
Grok Bot de SpaceXAI (11 de agosto) da a cada cuenta un ordenador persistente en la nube que inicia sesión en tus apps, desde un plan Cursor Pro de $20/mes; Muse de Meta (8 de septiembre) hace recados desde una VM propia en la nube y es gratis hasta 100 millones de tokens a la semana; y OpenAI dots (29 de septiembre) funcionan con GPT-6 Astra con su propio ordenador y navegador en la nube, desde el plan Pro de $100/mes, que no los incluye en el EEE, el Reino Unido ni Suiza. Ningún tablero independiente enfrenta a estos productos, así que la elección va de dónde tiene que ocurrir el trabajo y no de quién puntúa más.
El precio tampoco desempata ya: Spark llega ahora al nivel Google AI Pro de $19.99/mes en EE. UU. y en más de 160 países más, y Cowork se incluye sin coste adicional en todos los planes de pago de Claude desde $20/mes. ChatGPT Codex Mobile (14 de mayo) es la alternativa para el trabajo de agente de programación. Lee la comparativa completa de Gemini Spark y Claude Cowork.
| Agente | Mejor para | Dónde se ejecuta | Fortaleza | Precio |
|---|---|---|---|---|
| Gemini Spark | Tareas en la nube 24/7, flujos de Workspace | VM de Google Cloud (siempre activa) | Siempre activo, integración profunda con Workspace | Desde $19.99/mes Google AI Pro |
| Claude Cowork | Escritorio, manejo de apps, diseño + código | Tu escritorio Mac/Windows | Maneja apps locales, ve tu pantalla | $20/mes Claude Pro |
| ChatGPT Codex Mobile | Agente de programación en el móvil | Nube de OpenAI + iOS/Android | Aprobar diffs y redirigir el trabajo desde el móvil | Incluido en los planes de ChatGPT |
| Grok Bot | Tareas de navegador en apps con sesión iniciada | Un ordenador persistente en la nube de SpaceXAI compartido por todos tus Bots | Inicia sesión en las apps con tus propias credenciales y sigue trabajando con el portátil cerrado | Desde $20/mes Cursor Pro, o un plan SuperGrok vinculado |
| OpenAI dots | Responsabilidades continuas, no tareas sueltas | Ordenador y navegador en la nube de OpenAI | Funciona con GPT-6 Astra; sigue trabajando con tu ordenador apagado; disponible en ChatGPT, Slack y por voz | Desde $100/mes ChatGPT Pro (no en EEE/UK/CH); Business Premium |
| Meta Muse | Recados personales gratis | Una Muse Secure VM en la nube de Meta | Gratis hasta 100M de tokens a la semana; un agente Sentinel aparte aprueba lo que envía | Gratis; Power $20/mes, Maximum $100/mes |
Gemini Spark (en la nube) y Claude Cowork (de escritorio) siguen siendo la elección conjunta, porque esta categoría premia productos y desde la última actualización no ha salido ningún producto de agentes nuevo. Lo que se movió fue la capa de modelos. Claude Sonnet 5.5 ha entrado tercero en la Agent Arena, por detrás de Claude Fable 5.1, que la sigue liderando con un 17,6 % de éxito confirmado, y de Claude Opus 5.5, y ha tomado el liderato de AA-Briefcase v1.1 de Artificial Analysis con 1823, con Opus 5.5 segundo con 1807. Opus 5.5 sigue liderando GDPval-AA v2.1 con 1866, con el nuevo Muse Wonder Full de Meta segundo con 1857 y Sonnet 5.5 tercero con 1838. Gemini 4 Argon, anunciado el 30 de septiembre, lidera el AutomationBench de Artificial Analysis con un 77,5 % y tiene una tasa de éxito confirmado del 15,4 % en la Agent Arena, por encima del 14,1 % de Opus 5.5, pero allí es décimo en la clasificación general y desde el 13 de octubre está en la API de pago y en la app de Gemini con Google AI Pro.
Entre los modelos abiertos de la Agent Arena, Kimi K3 es ahora el mejor situado, decimocuarto, por delante de DeepSeek V4.1-Flash, decimoséptimo, y del Hy4 Preview de Tencent, decimonoveno. En septiembre, Grok Bot, Muse de Meta y OpenAI dots se unieron a Gemini Spark como agentes en la nube siempre activos, y Spark llegó al plan Google AI Pro de $19,99 al mes.
Pulsa ⌥ Space en tu Mac, pregunta y sigue trabajando. También en iPhone y iPad.
Gratis para empezar, 4,7★ en más de 27 000 reseñas.
Descargar Fello AIMejor IA para estudiar
La mejor IA para estudiantes es GPT-6 Luna dentro de ChatGPT para el trabajo de curso general y Gemini 3.6 Flash para STEM y estudio multimodal, con Qwen 3.7 Max como alternativa por API para los ejercicios más difíciles (200 solicitudes gratis al día) y Claude Sonnet 5.5 como alternativa gratuita para editar ensayos.
La mayoría de los estudiantes no necesita pagar. Desde el 8 de octubre, ChatGPT Free y Go están pasando de GPT-5.6 Luna a GPT-6 Luna, al que Artificial Analysis da 38,1 en su índice frente a 37,3; el plan gratuito tiene chats de texto ilimitados, aunque la subida de archivos y las herramientas de imagen siguen limitadas. Claude Sonnet 5.5 es gratis en claude.ai, donde las cuentas gratuitas también pueden elegir Claude Haiku 5.5 (7 de octubre), el modelo de Claude que menos gasta de tu límite de uso.
Gemini cambió el 9 de octubre: la app gratuita de Gemini funciona ahora en modo Auto, que envía la mayoría de los prompts a Flash-Lite, así que elegir tú mismo Gemini 3.6 Flash requiere Google AI Plus, aunque sigue gratis en Google AI Studio. Para resolver paso a paso las matemáticas más difíciles, GPT-6 Astra declara un 97,6 % en FrontierMath Tier 4 v2, pero no está en el plan gratuito de ChatGPT; Qwen 3.7 Max es la alternativa económica con 97,1 en HMMT de febrero de 2026 y un precio de API de $1,25 / $3,75 con su promoción actual del 50 % ($2,50 / $7,50 de tarifa).
| Tarea | Mejor modelo | Por qué | ¿Gratis? | Alternativa |
|---|---|---|---|---|
| Ensayos & trabajo de curso | GPT-6 Luna | El modelo de ChatGPT Free y Go, en despliegue desde el 8 de octubre; chats de texto ilimitados | Sí | Claude Sonnet 5.5 (Claude gratis) |
| Resolución de problemas STEM | GPT-6 Sol / Qwen 3.7 Max | Modelo de pago por defecto de ChatGPT; Astra declara 97,6 % en FrontierMath Tier 4 v2 / 97,1 HMMT feb 2026 | Plus de pago / Qwen API de pago | Gemini 3.6 Flash (AI Plus desde el 9 oct.) |
| Investigación & precisión | Gemini 3.1 Pro | 98 % ARC-AGI-1 a $0.52/tarea, anclaje nativo en Google Search | AI Pro (aplicación Gemini) desde el 9 oct. | Claude Opus 5 |
| Edición de escritura | Claude Sonnet 5.5 | Gratis en claude.ai desde el 28 de septiembre y solo por detrás de Opus 5.5 en el Intelligence Index; Claude Fable 5.1 es el líder en calidad | Sí (Claude gratis) | Claude Fable 5.1 |
| Estudio multimodal (PDF, diapositivas, imágenes) | Gemini 3.6 Flash | Contexto 1M vía AI Studio; la app de Gemini requiere AI Plus desde el 9 oct. | Gratis en AI Studio | NotebookLM (Google) |
Dos cambios para estudiantes. El modelo gratuito de ChatGPT pasa de GPT-5.6 Luna a GPT-6 Luna, en despliegue en Free y Go desde el 8 de octubre, así que GPT-6 Luna se queda con la fila de ensayos. Y desde el 9 de octubre la app gratuita de Gemini funciona en modo Auto, que envía la mayoría de los prompts a Flash-Lite, así que elegir Gemini 3.6 Flash en la app requiere Google AI Plus.
Anthropic también lanzó Claude Haiku 5.5 el 7 de octubre, que pueden elegir las cuentas gratuitas de Claude, y Claude Sonnet 5.5 sigue gratis en claude.ai. Gemini 4 Argon, público desde el 13 de octubre, viene con Google AI Pro, así que lo tienen los estudiantes de EE. UU. con el año gratis de AI Pro de Google, pero no el plan gratuito ni la oferta de Google AI Plus para estudiantes de otros países. En septiembre, Claude Sonnet 5.5 sustituyó a Sonnet 5 como elección gratuita para escribir y editar.
Mejor IA para el trabajo & profesionales
La mejor IA para el trabajo profesional es GPT-6 (por defecto en ChatGPT desde el 7 de octubre, Sol en los planes de pago) para el trabajo de conocimiento diario, Claude Opus 5.5 para programar y escribir cuando hay mucho en juego, y Gemini Spark para flujos agénticos 24/7.
La mayoría de los profesionales sacan el máximo partido con dos suscripciones de pago (ChatGPT Plus a $20/mes más Claude Pro a $20/mes, un total de $40/mes). O con una sola factura: Fello AI cubre ChatGPT, Claude y Gemini para el trabajo diario. Para el trabajo agéntico que sigue mientras duermes, Gemini Spark es el agente en la nube siempre activo que vive dentro de Google Workspace, y desde el 30 de julio llega al plan Google AI Pro de $19,99/mes además de a Google AI Ultra; OpenAI dots, Grok Bot y Muse de Meta son las alternativas, explicadas en la sección de agentes.
| Caso de uso | Mejor modelo | Dato clave | Precio | Alternativa |
|---|---|---|---|---|
| Trabajo de conocimiento diario | GPT-6 | Por defecto de ChatGPT desde el 7 de octubre; GPT-6 Sol en Plus | $20/mes ChatGPT Plus | Claude Opus 5.5 |
| Investigación legal, financiera y fiscal | Gemini 4 Argon | #1 Vals Index (68,9 %) y #1 AutomationBench-AA (77,5 %) | $19.99/mes Google AI Pro | Claude Opus 5.5 |
| ChatGPT Work y Codex | GPT-6.1 Sol | En ChatGPT Work y Codex para Plus, Pro, Business, Enterprise y Edu desde el 29 de septiembre, a $2 / $10 en la API | $20/mes ChatGPT Plus | GPT-6 Luna para trabajo de volumen |
| Programación (propietaria) | Claude Opus 5.5 | #1 Arena WebDev (1813) y #1 Intelligence Index (57,6), a $4 / $20 | $20 al mes Claude Pro | Claude Sonnet 5.5, que lidera Terminal-Bench 4.0 a mitad de precio por token |
| Programación (rentable) | Claude Sonnet 5.5 | #1 Terminal-Bench 4.0 (63,6 %) y #1 LiveBench Coding (91,4); $0,88 por tarea del índice con esfuerzo high | $2 / $10 | Qwen3.8-Max-0902; DeepSeek V4.1-Flash |
| Investigación & informes | Gemini 3.1 Pro | 98 % ARC-AGI-1 a $0.52/tarea, anclaje de Google | Google AI Pro / Ultra | Claude Opus 5.5 |
| Matemáticas duras, física, modelado financiero | GPT-6 Astra | #1 LiveBench Reasoning y ARC-AGI-2 (95 %); declara 97,6 % en FrontierMath Tier 4 v2 | $100/mes ChatGPT Pro | GPT-6.1 Sol; Qwen 3.7 Max |
| Flujos de agente siempre activos | Gemini Spark | Agente en la nube 24/7 dentro de Google Workspace | Desde $19.99/mes Google AI Pro | Claude Cowork |
| Noticias en vivo, creatividad con contexto de X | Grok 4.7 | Intelligence Index 46,3 + anclaje nativo en X; en la app de Grok desde el 3 de octubre | $30 al mes SuperGrok | Gemini 3.1 Pro |
| Consolidación todo en uno | Fello AI | ChatGPT + Claude + Gemini + Grok + DeepSeek | Desde $11.99/mes | Pagar a cada proveedor por separado |
La fila del trabajo de conocimiento diario pasa de GPT-5.6 a GPT-6, que se convirtió en el modelo por defecto de ChatGPT el 7 de octubre. Gemini 4 Argon se queda con una nueva fila de trabajo legal, financiero y fiscal: lidera el Vals Index de ese trabajo y el AutomationBench de Artificial Analysis, y desde el 13 de octubre está en la app de Gemini con Google AI Pro por $19.99 al mes. En septiembre, Claude Opus 5.5 se quedó con la fila de programación propietaria a un precio inferior al de Opus 5, Claude Sonnet 5.5 con la de programación rentable y GPT-6.1 Sol con la de ChatGPT Work y Codex el 29 de septiembre.
Precios de los modelos de IA en octubre de 2026
Desde niveles gratuitos de $0 hasta Google AI Ultra a $199,99 al mes. El precio que más importa en esta tabla es el de Claude Opus 5.5, a $4 / $20. Desde el 22 de septiembre, el modelo con la puntuación más alta que ha medido cualquier evaluador independiente cuesta menos que el Claude Opus 5 al que sustituye ($5 / $25), y las lecturas de caché bajan un 60 % hasta $0,20. Claude Fable 5.1 y GPT-6 Astra están los dos a $10 / $50 y los dos puntúan por debajo.
La tarifa más concurrida es ahora $2 / $10, compartida por Claude Sonnet 5.5, GPT-6 Sol y GPT-6.1 Sol. GPT-6.1 Sol es la vía más barata hacia una puntuación entre los seis primeros del Intelligence Index, a $0,72 por tarea del índice. Con Sonnet 5.5 la factura la decide el nivel de esfuerzo: con esfuerzo high una tarea del índice cuesta $0,88 y con el máximo $5,46, ya algo menos que los $5,98 de Opus 5.5, y Anthropic redujo a la mitad sus lecturas de caché, a $0,10, el 7 de octubre. Gemini 4 Argon de Google también sale a un precio introductorio de $2 / $10 ($4 / $20 el estándar), hasta el 30 de noviembre, y desde el 13 de octubre cualquiera puede comprarlo en la API de pago.
El precio por token y el coste por tarea pueden separarse. Grok 4.7 cuesta $2 / $6, igual que Grok 4.6, pero una tarea del índice cuesta $2,73 frente a $1,86, porque 4.7 emite alrededor del doble de salida. Mistral Large 4 (en vista previa pública desde el 6 de octubre) tiene un precio de lista de $1,36 / $4,18, aunque la propia página del modelo de Mistral muestra la mitad, y es tan prolijo que una tarea del índice cuesta $1,13 para una puntuación de 38,4. En la frontera, la elección por valor es el Muse Spark 1.3 de Meta, a $1,25 / $4,25, o $1,60 por tarea del índice con 48,1.
En el extremo barato, GPT-6 Luna es el modelo más barato por tarea de esta página: $0,10 / $0,50, o $0,07 por tarea del índice. Claude Haiku 5.5 (7 de octubre) iguala ese precio por token en prompts de hasta 100.000 tokens y logra 43,4 frente al 38,1 de Luna, pero escribe tanto más que una tarea del índice cuesta $0,21 con esfuerzo máximo, o $0,12 por 41,3 en xhigh; por encima de 100.000 tokens sube a $0,50 / $2,50. Entre los modelos abiertos que se compran por tokens, la elección sigue siendo GLM 5.3 Flash a $0,15 / $0,50 ($0,25 por tarea del índice con 41,8), por delante de DeepSeek V4.1-Flash a $0,15 / $0,60 fuera de pico y $0,30 / $1,20 en pico ($0,27 con 39,5). El MiMo-V2.6-Pro de Xiaomi es aún más barato, $0,13 por tarea del índice con 46,3, pero solo si alojas tú mismo sus 1,02 billones de parámetros. Para un desglose más profundo, consulta nuestra guía completa de comparación de precios de IA.
| Modelo | Entrada (por 1M) | Salida (por 1M) | Contexto | ¿Acceso gratis? |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | 1 050 000 (entrada máx. 922 000) | En Chat en Pro, Business y Enterprise desde el 4 de septiembre; Plus lo tiene en ChatGPT Work y Codex, no en Chat; sin plan gratuito; activo en la API |
| GPT-6 Sol | $2.00 | $10.00 | 1 050 000 (entrada máx. 922 000) | Chat de ChatGPT en Plus, Pro, Business y Enterprise desde el 7 de octubre; Work y Codex; API |
| GPT-6.1 Sol | $2.00 | $10.00 | 1 050 000 (entrada máx. 922 000) | ChatGPT Work y Codex en Plus, Pro, Business, Enterprise y Edu desde el 29 de septiembre; API; no en Chat; lecturas de caché $0,10 |
| GPT-6 Luna | $0.10 | $0.50 | 1 050 000 (entrada máx. 922 000) | Chat de ChatGPT en Free y Go, en despliegue desde el 8 de octubre; Work y Codex en planes de pago; API |
| GPT-5.5 | $5.00 | $30.00 | 1M (400K en Codex) | ChatGPT Free; API de pago |
| GPT-5.5 Pro | $30.00 | $180.00 | 1M | ChatGPT Pro desde $100/mes (niveles de mayor uso a $200 y $500) |
| GPT-5.6 Sol | $4.00 | $20.00 | No publicado | En vivo en ChatGPT, Codex & API (9 de julio); tarifa promocional al menos hasta el 21 de noviembre de 2026 |
| GPT-5.6 Terra | $2.00 | $12.00 | No publicado | En vivo en ChatGPT, Codex & API (9 de julio) |
| GPT-5.6 Luna | $0.20 | $1.20 | No publicado | En vivo en ChatGPT, Codex & API (9 de julio) |
| Claude Opus 5.5 | $4.00 | $20.00 | 1M | Claude Pro/Max/Team; API de pago; lecturas de caché $0,20 |
| Claude Opus 5 | $5.00 | $25.00 | 1M | Modelo legacy en Anthropic; Pro/Max/API |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Modelo legacy en Anthropic; Pro/Max/API |
| Claude Fable 5.1 | $10.00 | $50.00 | 1M | Lecturas de caché $0.25; en Max/Team Premium (~50 % de los límites de uso); Pro/Team Standard vía créditos. Mythos 5.1 factura igual, solo por invitación |
| Claude Fable 5 | $10.00 | $50.00 | 1M | Permanente en Max/Team Premium (~50 % de los límites de uso); Pro/Team Standard vía créditos |
| Claude Sonnet 5.5 | $2.00 | $10.00 | 1M | Gratis en claude.ai; Pro/Max/Team; API de pago; lecturas de caché $0,10 desde el 7 de octubre |
| Claude Sonnet 5 | $2.00 | $10.00 | 1M | Modelo legacy desde el 28 de septiembre; respaldo para peticiones de ciberseguridad marcadas; API de pago |
| Claude Sonnet 4.6 | $3.00 | $15.00 | 1M | API de pago (reemplazado por Sonnet 5) |
| Claude Haiku 5.5 | $0.10 (≤100K) / $0.50 (>100K) | $0.50 (≤100K) / $2.50 (>100K) | 1M | Free, Pro, Max, Team y Enterprise en Claude.ai (web, iOS, Android); API de pago; lecturas de caché $0,01 |
| Gemini 3.1 Pro | $2.00 (≤200K) / $4.00 (>200K) | $12.00 (≤200K) / $18.00 (>200K) | 1M | App de Gemini con Google AI Pro o superior desde el 9 oct.; API de pago |
| Gemini 4 Argon | $2.00 introductorio hasta el 30/11 / $4.00 estándar ($0.10 en caché, introductorio) | $10.00 introductorio / $20.00 estándar | 1M, compartido entre entrada y salida | API de pago desde el 13 de octubre; app de Gemini en Google AI Pro y Ultra |
| Gemini 3.8 Flash | $0.75 introductorio / $1.50 desde el 1/1/2027 | $3.75 introductorio / $7.50 desde el 1/1/2027 | 1M | AI Studio, Antigravity, Gemini Enterprise + API de pago; en la aplicación de Gemini reportado para AI Pro/Ultra |
| Gemini 3.7 Flash | $0.75 introductorio / $1.50 desde el 1/1/2027 | $3.75 introductorio / $7.50 desde el 1/1/2027 | 1M | AI Studio, Android Studio, Antigravity + API de pago; en la aplicación de Gemini solo vía Spark (AI Pro/Ultra, excluye EEE/RU/CH/Nigeria) |
| Gemini 3.6 Flash | $0.75 introductorio / $1.50 desde el 1/1/2027 | $3.75 introductorio / $7.50 desde el 1/1/2027 | 1M | App de Gemini con AI Plus o superior desde el 9 oct.; AI Studio; nivel gratuito de API + API de pago |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 1M | AI Studio; nivel gratuito de API + API de pago |
| Qwen3.8-Max-0902 | $2.00 ($0.17 cache hit explícito, $0.25 implícito) | $6.00 | 1M (salida de 128K) | Solo API de QwenCloud; sin chat de consumo; pesos abiertos solo para la versión de texto Qwen3.8-2.4T-A95B en la que se basa |
| Qwen 3.7 Max | $1.25 promo / $2.50 lista | $3.75 promo / $7.50 lista | 1M | 200 solicitudes gratis/día; API de pago más allá |
| MiniMax M3 | $0.30 (50 % de descuento sobre $0.60) | $1.20 (≤512K) | 1M | Open weights; se aplican costes de alojamiento |
| LongCat-2.0 | Depende del proveedor | Depende del proveedor | 1M | Open weights (MIT); se aplican costes de alojamiento |
| NVIDIA Nemotron 3 Ultra | Depende del proveedor | Depende del proveedor | 1M | Open weights (OpenMDW); se aplican costes de alojamiento |
| Qwen 3.5 (open-weight) | Autoalojado / Together | Autoalojado / Together | 1M | Open weights; se aplican costes de alojamiento |
| Nex-N2-Pro | Autoalojado / proveedores | Autoalojado / proveedores | 1M | Open weights (Apache 2.0); se aplican costes de alojamiento |
| Rio 3.5 Open 397B | Autoalojado / proveedores | Autoalojado / proveedores | 1M | Open weights (MIT); se aplican costes de alojamiento |
| Grok 4.3 | $1.25 | $2.50 | 1M | Plan de consumo gratuito; API de pago |
| Grok 4.6 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | API de SpaceXAI, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
| Grok 4.7 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | API de SpaceXAI, Cursor, Grok Build, harnesses y routers en la nube; no en la app de Grok |
| Muse Spark 1.3 | $1.25 ($0.10 nivel Contributor) | $4.25 ($0.20 nivel Contributor) | 1M | API de pago; Muse Code, Meta Model API y OpenRouter; el nivel Contributor cambia derechos de entrenamiento por un ~92 % de descuento |
| Muse Wonder | $4.00 | $20.00 | 1M | API de pago; Meta Model API, Muse Code y OpenRouter; Muse Wonder Full solo en Muse Code, en los planes de $50 y $200 |
| Kimi K3 | $3.00 ($0.30 cache-hit) | $15.00 | 1M | Nivel básico gratuito en la aplicación de Kimi; open weights en Hugging Face (Kimi K3 License) |
| Mistral Large 4 | $1.36 ($0.68 en la página del modelo de Mistral) | $4.18 ($2.09) | 512K (1M según Mistral) | API en vista previa pública desde el 6 de octubre; pesos abiertos prometidos para finales de octubre, sin licencia anunciada aún |
| Gemini Omni Flash (vídeo) | $1.50 | $17.50 (salida de vídeo) | Clips de 10 segundos | Aplicación Gemini / Flow; AI Studio + API |
| DeepSeek V4-Pro | $0.66 en valle / $1.32 en punta ($0.022 cache-hit en valle) | $1.98 en valle / $3.96 en punta | 1M | DeepSeek Chat gratis; API de pago, tarifas punta y valle desde el 16 de agosto |
| DeepSeek V4.1-Flash | $0.15 en valle / $0.30 en punta ($0.003 acierto de caché en valle) | $0.60 en valle / $1.20 en punta | 1M | DeepSeek Chat gratis; API de pago, tarifas de valle y punta; sustituyó a V4-Flash el 10 de septiembre |
| Kimi K2.7 Code | Depende del proveedor | Depende del proveedor | 256K | Open weights; se aplican costes de alojamiento |
| GLM-5.2 | Depende del proveedor | Depende del proveedor | 1M | Open weights; se aplican costes de alojamiento |
| GLM 5.3 | $1.40 ($0.26 cache-hit) | $4.40 | 1M | API de Z.ai, GLM Coding Plan y ZCode; pesos en Hugging Face desde el 28 de agosto bajo la GLM 5.3 License propia |
| GLM 5.3 Flash | $0.15 ($0.03 cache-hit) | $0.50 | 1M | API de Z.ai, GLM Coding Plan, OpenRouter; pesos MIT en Hugging Face; la promoción de lanzamiento acabó el 9 de septiembre |
| Tencent Hy4 Preview | $0.834 ($0.042 cache-hit) | $2.501 | 1M+ | Pesos abiertos (Apache 2.0); Tencent Cloud TokenHub, OpenRouter, WorkBuddy, CodeBuddy |
| Qwen3.8-Flash-Next | Depende del proveedor | Depende del proveedor | 262K (hasta 1M) | Pesos abiertos (Qwen Community License 1.0); se suman los costes de alojamiento |
| MiMo-V2.6-Pro | $0.435 | $0.87 | 1M | Pesos abiertos (MIT); el alojamiento se paga aparte |
| ERNIE 5.1 | Precio para la región de China | Precio para la región de China | 256K | Nivel gratuito de Baidu |
| Gemini Spark (agente) | Sin precio de API | Sin precio de API | 1M (base Gemini) | Google AI Pro $19.99, AI Ultra $99.99 o $199.99/mes |
| Fello AI (agregador) | Enrutado por la app | Enrutado por la app | Depende del modelo | Desde $11.99/mes, plan gratuito disponible |
Las tarifas de GPT-5.5 y GPT-5.5 Pro de arriba son precios de contexto corto; OpenAI ya no publica las cifras específicas de contexto largo. Los niveles GPT-5.6 se facturan a 2x entrada y 1,5x salida una vez que un prompt supera los 272K tokens de entrada, lo que sitúa a Terra de contexto largo en $4 / $18 y a Luna en $0.40 / $1.80. Los niveles GPT-6 llevan el mismo recargo por encima de 272K tokens de entrada, aplicado a toda la solicitud, y sus lecturas de caché salen un 90 % más baratas: $1.00 en Astra, $0.20 en GPT-6 Sol y $0.01 en Luna, con GPT-6.1 Sol un 95 % más barato, a $0.10.
Grok 4.6 funciona igual, pero muerde más fuerte: a partir de 200.000 tokens de prompt, SpaceXAI refactura la petición entera a la tarifa más alta en lugar de solo el exceso, así que pasarse por mil tokens duplica el coste de toda la llamada. La otra tarifa que conviene leer dos veces es la de DeepSeek: desde el 16 de agosto sus dos modelos V4 se facturan a precio de punta de 01:00 a 04:00 y de 06:00 a 10:00 UTC entre semana, y a exactamente la mitad en cualquier otra hora, así que la misma tarea puede costar el doble según cuándo la ejecutes.
La forma más barata de recorrer esta tabla suele ser una suscripción en lugar de tres. Fello AI reúne GPT, Claude, Gemini, Grok, Perplexity y más en una sola app para Mac, iPhone y iPad, desde $11,99 al mes en la mayoría de los países.
Mejores modelos open-weight en octubre de 2026
El mejor modelo de pesos abiertos en octubre de 2026 es el MiMo-V2.6-Pro de Xiaomi, publicado el 21 de septiembre bajo MIT puro: 1,02 billones de parámetros con 42.000 millones activos y contexto de 1M de tokens. Artificial Analysis lo mide en 46,3 en el Intelligence Index v4.3.2, la mayor puntuación abierta que ha publicado nunca, por delante de GLM-5.3 con 44,8 y de Kimi K3 con 43,6, y a solo $0,13 por tarea del índice. La pega: los votantes humanos de Arena solo lo sitúan en el puesto 19 en WebDev y en el 26 en texto.
Otros dos modelos abiertos aún lideran en algo. Kimi K3 es el modelo abierto mejor situado en Arena, decimocuarto en WebDev y decimocuarto en la Agent Arena. GLM-5.3 es el modelo abierto más fuerte en Terminal-Bench 4.0, con un 41,9 %, aunque bajo una licencia propia de Z.ai y no MIT.
Para equipos que ejecutan sus propios pesos, la elección práctica sigue siendo GLM 5.3 Flash (Z.ai, MIT): 41,8 en v4.3.2 con 320.000 millones en total y 18.000 millones activos. No es un GLM 5.3 recortado sino un modelo aparte sobre una base entrenada de nuevo, y por eso sale bajo MIT. Un modelo de 1,02 billones de parámetros no es algo para una estación de trabajo, y solo la descarga de K3 ocupa unos 1,56 TB. En el escalón más barato, DeepSeek-V4.1-Flash sustituyó a V4-Flash el 10 de septiembre: MIT, multimodal de forma nativa, 39,5 en v4.3.2 y $0,15 / $0,60 fuera de pico.
Hay tres más que vigilar. Mistral Large 4 (en vista previa pública desde el 6 de octubre) es el modelo con mayor puntuación de Estados Unidos o Europa que promete pesos abiertos, con 38,4, pero aún no se puede descargar: Mistral promete los pesos antes de que acabe octubre y no ha indicado la licencia. El Qwen3.8-Flash-Next de Alibaba, de 125.000 millones con solo 6.000 millones activos, adelanta la arquitectura Qwen4 y puntúa 39,8. El Hy4 Preview de Tencent, 770.000 millones en total y 49.000 millones activos bajo Apache 2.0, no tiene valoración de Artificial Analysis pero es decimoctavo en Arena WebDev.
| Modelo | Mejor para | Benchmark clave | Contexto / Licencia | Dónde ejecutar |
|---|---|---|---|---|
| MiMo-V2.6-Pro | El mayor Intelligence Index abierto jamás medido | II 46,3 (v4.3.2), por encima de GLM-5.3 y Kimi K3, a $0,13 por tarea del índice; 34,8 % Terminal-Bench 4.0; GDPval-AA v2.1 1685; 1,02 billones/42.000 millones activos | 1M / MIT | Hugging Face (XiaomiMiMo), proveedores, autoalojado |
| Kimi K3 | Modelo abierto mejor situado en Arena | II 43,6 (v4.3.2); #14 Arena WebDev, la mejor posición abierta; #14 Agent Arena; 2.8T/104B activos | 1M / Kimi K3 License | Hugging Face (96 shards, 1.56 TB), Moonshot API, proveedores |
| GLM 5.3 Flash | Mejor modelo abierto que la mayoría de equipos puede ejecutar de verdad | II 41,8 (v4.3.2), en la frontera de Pareto entre inteligencia y coste, a unos $0.25 por tarea del índice; 320B/18B activos, nativamente multimodal | 1M / MIT | Hugging Face, API de Z.ai ($0.15/$0.50), OpenRouter |
| GLM-5.2 | Respaldo con historial independiente | II 33,7 (v4.3.2); #27 Arena WebDev (1,603.2), #20 Agent Arena; 744B/40B activos | 1M / MIT | Z.ai, Hugging Face, OpenRouter |
| GLM 5.3 | Abierto desde el 28 de agosto, pero con licencia propia | II 44,8 (v4.3.2), la puntuación abierta más alta que hemos encontrado; misma base de 744B que GLM-5.2, solo post-entrenada, checkpoint publicado contado en 753B; CyberGym 84,5 % y Terminal-Bench 3.0 28,3 (cifras del fabricante) | 1M / GLM 5.3 License (model-as-a-service por encima de 10 000 M USD de ingresos necesita revisión de seguridad de Z.ai) | Hugging Face, API de Z.ai ($1.40/$4.40), GLM Coding Plan, ZCode |
| DeepSeek V4.1-Flash | Mejor valor abierto si lo alojas tú mismo | II 39,5 (v4.3.2) frente a 34,3 de la versión V4-Flash 0731 que sustituye; 552B, 8B activos en prefill y 16B en decodificación | 1M / MIT | DeepSeek API ($0.15/$0.60 en valle, $0.30/$1.20 en punta desde el 10 de septiembre), local |
| Tencent Hy4 Preview | Mayor modelo con licencia permisiva hasta la fecha | 770B/49B activos; 2,99/4,00 en el panel propio de Tencent de 203 tareas frente a 2,94 de Kimi K3 y 2,92 de GLM 5.3 (fabricante); sin valoración de Artificial Analysis; #18 Arena WebDev (1632), #19 Agent Arena | 1M+ / Apache 2.0 | Hugging Face (BF16 y FP8), Tencent Cloud TokenHub, OpenRouter |
| Qwen3.8-Flash-Next | Anticipo de la arquitectura Qwen4 | 125B totales más un embedding de N-gramas de 51B, 6B activos; 91,7 GPQA Diamond y 62,5 SWE-Bench Pro (fabricante); II 39,8 (v4.3.2); #17 Arena WebDev (1633) | 262K a 1M / Qwen Community License 1.0 | Hugging Face, proveedores, autoalojamiento |
| LongCat-2.0 | Programador abierto frontier entrenado en chips chinos | II 33 (v4.1); 59,5 % SWE-Bench Pro (proveedor), 1.6T/~48B activos | 1M / MIT | Hugging Face, GitHub, OpenRouter |
| MiniMax M3 | Multimodal barato de contexto largo | II 29,2 (v4.3.2; 44 en v4.1), 59 % SWE-Bench Pro, multimodal | 1M / MiniMax Community License | Hugging Face, API $0.30/1M (50 % de descuento) |
| Nex-N2-Pro | Puntuación de programación abierta más fuerte | II 41 (v4.1); 80,8 SWE-Bench Verified, 397B/17B activos | Basado en Qwen / Apache 2.0 | Hugging Face, proveedores, autoalojado |
| Kimi K2.7 Code | Programador abierto con licencia comercial más fuerte | +21,8 % en Kimi Code Bench v2 vs. K2.6 (proveedor); 1T/32B activos | 256K / Modified MIT | Hugging Face, DeepInfra, proveedores |
| DeepSeek V4-Pro | Trabajo agéntico del mundo real | II 44 (v4.1), 1.6T/49B activos | 1M / MIT | DeepSeek API ($0.66/$1.98 fuera de pico, $1.32/$3.96 en pico desde el 16 de agosto), local |
| Hy3 | El participante más nuevo con licencia permisiva | II 41 (v4.1); #56 en Arena WebDev (1,508.4) | Apache 2.0 | Hugging Face, proveedores, autoalojado |
| Inkling | Primer modelo open-weight de Thinking Machines | II 41 (v4.1), agéntico 32,3, lanzado el 15 de julio | Open weights | Hugging Face, proveedores, autoalojado |
| Inkling Small | Misma familia a una cuarta parte del tamaño | II 40 (v4.1), agéntico 30,8; 276B/12B activos, entrada de texto, imagen y audio | Apache 2.0 | Hugging Face (BF16 y NVFP4), proveedores, autoalojado |
| NVIDIA Nemotron 3 Ultra | Afinado por NVIDIA, licencia totalmente permisiva | II 38 (v4.1), 65-70,4 SWE-Bench Verified, 550B/55B activos | 1M / OpenMDW | OpenRouter, Hugging Face, AWS (8x B200 autoalojado) |
| Qwen 3.5 (397B / 17B activos) | Multimodal, decodificación rápida | 88,4 GPQA, 91,3 AIME 2026, 83,6 LiveCodeBench v6 | 1M / abierto | Together, OpenRouter, local |
| Qwen3.6-35B-A3B | Programador agéntico abierto eficiente (3B activos) | 86,0 GPQA Diamond, 92,7 AIME 2026, 35B/3B activos | 262K (a 1M YaRN) / Apache 2.0 | Hugging Face, OpenRouter, local |
| Qwen3.6-27B | Programador denso ejecutable en portátil | 87,8 GPQA Diamond, denso 27B, multimodal | 256K / Apache 2.0 | Local Mac/PC, Hugging Face, OpenRouter |
| Rio 3.5 Open 397B | Fine-tune de Qwen 3.5, razonamiento multilingüe | 70,8 Terminal-Bench 2.1 (first-party), supera a Qwen 3.7 Plus en 4/5 | 397B/17B activos / MIT | Hugging Face, proveedores, autoalojado |
| Llama 4 Maverick | Buque insignia de la línea Meta | 17B activos / 400B de parámetros totales | Llama 4 license | Nube de Meta, Hugging Face, local |
| NVIDIA Nemotron 3 Nano Omni | Edge / bajo consumo | Multimodal, huella muy pequeña | Compacto / abierto | Local, herramienta NVIDIA |
Aquí la licencia importa tanto como la puntuación bruta, y agosto ha ensanchado la distancia entre los dos grupos. Kimi K2.7 (Modified MIT), DeepSeek V4 (MIT), GLM 5.3 Flash (MIT), MiMo-V2.6-Pro (MIT), GLM-5.2 (MIT), LongCat-2.0 (MIT), Hy3 (Apache 2.0), Hy4 Preview (Apache 2.0), Nex-N2-Pro (Apache 2.0) y Nemotron 3 Ultra (OpenMDW) todos permiten claramente el uso comercial sin prueba de ingresos.
El resto lleva condiciones que conviene leer antes de construir sobre ellas: MiniMax M3 y MiniMax H3 vienen bajo sus propias licencias comunitarias, y H3 exige además una solicitud desde EE. UU., la UE, el Reino Unido y Corea del Sur; Kimi K3 se sitúa en una licencia propia con un umbral de ingresos para quien lo revenda como servicio; GLM 5.3 exige una revisión de seguridad de Z.ai a cualquier operador de model-as-a-service por encima de 10 000 millones de dólares de ingresos; y la Qwen Community License 1.0 de Qwen3.8-Flash-Next exige una licencia aparte de Qwen para explotar un negocio de model-as-a-service o de asistente de trabajo con IA, aunque el uso interno queda exento. Ningún modelo open-weight es ya el primero en ningún tablero de Arena que sigamos: Claude Opus 5 se llevó el tablero Agent en julio, el último que lideró un modelo open-weight.
Benchmarks, precios y uso práctico
Cada clasificación de esta página combina tres entradas: benchmarks públicos de siete casas independientes (Artificial Analysis, Arena antes LMArena, Scale SEAL, LiveBench, EQ-Bench, ARC Prize y el tablero oficial de Terminal-Bench 4.0, cubriendo el Intelligence Index, GPQA Diamond, ARC-AGI-1 al 3, Humanity's Last Exam, GDPval-AA, FrontierMath, HMMT, MCP Atlas, SWE Atlas y el Remote Labor Index), precios de API y suscripción publicados en la página de precios oficial de cada proveedor, y uso práctico por parte del equipo editorial de FelloAI que ejecuta prompts reales sobre la misma tarea en cada modelo. Volvemos a obtener las fuentes oficiales de precios y benchmarks antes de cada actualización mensual.
Los benchmarks se ponderan según el caso de uso: SWE-bench y Terminal-Bench impulsan la programación, GPQA Diamond y ARC-AGI-2 impulsan la precisión, GDPval-AA (el benchmark de entregables profesionales de Artificial Analysis) informa la calidad de las tareas profesionales mientras que el estilo de escritura se juzga principalmente por pruebas prácticas, FrontierMath y HMMT impulsan la resolución de problemas. Revelamos cuándo un benchmark es reportado por el proveedor pero no verificado de forma independiente, y descartamos cualquier afirmación que no podamos reproducir contra una fuente en vivo. Clasificamos por puntuaciones medidas: la corona de una categoría se mueve en cuanto un modelo supera al titular en los tableros que definen esa categoría, sin esperar a los tableros basados en votos, y un modelo que todavía no está ampliamente disponible se señala en su tarjeta en lugar de quedarse sin ella. Revisamos los puestos además de las cifras, porque una puntuación puede seguir siendo correcta mientras el tablero que la rodea se mueve. Cuando un modelo pasa por una actualización importante entre actualizaciones, volvemos a clasificar la categoría y añadimos una línea «Qué cambió este mes» al pie del análisis a fondo.
Pregunta a ChatGPT, Claude y Gemini y quédate con la mejor respuesta. Sin tres facturas.
Fello AI funciona en Mac, iPhone y iPad, y es gratis para empezar.
Descargar Fello AI