Melhores IAs de 2026: qual a melhor inteligência artificial
Ranking e comparação das melhores IAs por utilização, atualizados todos os meses à medida que chegam novos modelos.
- O mais inteligente no geral e para programarClaude Opus 5.5
- Raciocínio mais difícilGPT-6 Astra
- ImagensChatGPT Images 2.5
- Melhor escolha grátisClaude Sonnet 5.5
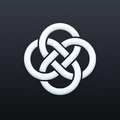
Deixe de saltar entre aplicações de IA
Chat, pesquisa, PDFs e imagens numa só aplicação para Mac, iPhone e iPad.
Grátis para começar·4,7★ em mais de 27 000 críticas
Os rankings mostram quem ganha em média. O seu prompt não é médio. Pergunte ao ChatGPT, ao Claude e ao Gemini numa só janela e fique com a melhor resposta.
Descarregar Fello AIA Anthropic detém este mês a maioria das coroas medidas. O Claude Opus 5.5 (22 de setembro) é #1 no Intelligence Index com 57,6 e no quadro WebDev da Arena, o Claude Sonnet 5.5 (28 de setembro) é segundo com 56,0 e grátis no claude.ai, e o Claude Haiku 5.5 (7 de outubro) completa a família a $0,10 / $0,50. O nosso guia de benchmarks de IA explica como esse índice é construído.
O Gemini 4 Argon da Google (30 de setembro) marca 52,6, a par do GPT-6 Astra, e é primeiro no quadro de texto da Arena, e desde 13 de outubro está aberto aos subscritores do Google AI Pro e do Ultra e na API paga, o que o coloca em segundo no pódio de chat, mas não vence nenhuma categoria: o EQ-Bench, o LiveBench e o ARC Prize ainda não o avaliaram. A OpenAI compete no preço: o GPT-6 Sol e o Luna cortaram para metade os preços da API, e o GPT-6.1 Sol (29 de setembro) marca 51,8 a $2 / $10, o modelo mais barato do grupo da frente por tarefa do índice.
O Muse Wonder da Meta (12 de outubro) é a novidade de topo mais recente: o Muse Wonder Full marca 55,8, terceiro atrás dos dois modelos Claude, mas só funciona dentro da subscrição Muse Code da Meta, e o Muse Wonder na API marca 52,4 aos mesmos $4 / $20 do Opus 5.5. O Grok 4.7 (21 de setembro) chegou à API pelos mesmos $2 / $6, e o MiMo-V2.6-Pro da Xiaomi continua a ser o modelo aberto com melhor pontuação, 46,3. A 6 de outubro, a Mistral lançou o Mistral Large 4 e a Google lançou o Nano Banana 2.1; nenhum leva uma coroa, mas o vídeo passa para o MiniMax H3. Atualizamos os rankings nas 48 horas seguintes a cada grande lançamento.
13 out. Google O Gemini 4 Argon abre-se ao Google AI Pro, ao Ultra e à API paga, e fica em segundo no pódio de chat Novo
12 out. O Muse Wonder Full fica em terceiro no Intelligence Index, mas só dentro da subscrição Muse Code da Meta Novo
7 out. Anthropic Claude Haiku 5.5 faz 43,4 ao preço do GPT-6 Luna, e qualquer plano do Claude o pode escolher, incluindo o gratuito Novo
6 out. Mistral O Mistral Large 4 é o modelo mais forte dos EUA ou da Europa que promete pesos abertos, mas ainda não o pode descarregar Novo
6 out. Google O Nano Banana 2.1 substitui o Nano Banana 2 a metade do preço por imagem e entra em quinto no Arena texto para imagem Novo
30 set. Google O Gemini 4 Argon lidera o quadro de texto da Arena e iguala o GPT-6 Astra no Intelligence Index, mas só defensores de cibersegurança o podem usar Novo
29 set. OpenAI O GPT-6.1 Sol chega ao quinto lugar do Intelligence Index a $2 / $10, o mais barato por tarefa do grupo da frente Novo
28 set. Anthropic O Claude Sonnet 5.5 fica em segundo no Intelligence Index com 56,0, ao preço Sonnet de $2 / $10 Novo
22 set. OpenAI O GPT-6 Sol e o GPT-6 Luna cortam para metade os preços da API da OpenAI e chegam a todo o lado menos ao chat do ChatGPT Novo
22 set. Anthropic O Claude Opus 5.5 leva o Intelligence Index com 57,6 e fica abaixo do preço do Opus 5 Novo
21 set. SpaceXAI O Grok 4.7 chega sobre um modelo base maior aos mesmos $2 / $6 e custa mais 47 % por tarefa Novo
21 set. Xiaomi O MiMo-V2.6-Pro da Xiaomi é o modelo aberto com a maior pontuação alguma vez medida, a $0,13 por tarefa do índice sob MIT Novo
20 set. Alibaba O Qwen-Image-2.1 é o melhor modelo de imagem que pode descarregar, mas a licença só permite investigação Novo
15 set. TypeSafe A TypeSafe sai do modo furtivo com o Jev, um modelo que devolve decisões tipadas em vez de texto, a $0.042 por 1M de tokens Novo
Pendente Google Gemini 3.5 Pro, ainda por lançar, e o Gemini 4 Argon passou-lhe à frente Atrasado
Melhor IA para escrita
A melhor IA para escrever é o Claude Fable 5.1, e o argumento a seu favor é a consistência e não um único primeiro lugar.
Está entre os dez primeiros nos três quadros de prosa: segundo no EQ-Bench Creative Writing v3 com 2162,0, terceiro no LiveBench Language com 89,5 e nono no quadro de escrita criativa da Arena. Nenhum outro modelo se coloca tão bem nos três. O Gemini 4 Argon lidera agora os quadros de escrita criativa e de texto da Arena, com 1519,2 e 1525,4, e desde 13 de outubro os subscritores do Google AI Pro podem usá-lo, mas nem o EQ-Bench nem o LiveBench o avaliaram ainda.
O Claude Opus 5.5 é segundo no quadro de escrita criativa da Arena com 1517, mas sétimo no EQ-Bench e décimo no LiveBench Language; o GPT-6 Astra lidera o EQ-Bench com 2173,3 mas está em 42.º no quadro de escrita criativa da Arena; o Claude Fable 5 lidera o LiveBench Language com 90,7 e é terceiro no quadro de escrita criativa da Arena, mas décimo primeiro no EQ-Bench. Se o que escreve é um entregável de trabalho e não prosa, o quadro de entregáveis profissionais GDPval-AA v2.1 é outra questão, e lidera-o o Claude Opus 5.5 com 1866, à frente do novo Muse Wonder Full da Meta com 1857, do Claude Sonnet 5.5 com 1838 e do Claude Fable 5.1 com 1756.
O Claude Sonnet 5.5 é a escolha de relação qualidade-preço do nível gratuito, já que qualquer pessoa o pode usar em claude.ai, embora faça 83,4 no LiveBench Language, esteja apenas em 24.º no quadro de escrita criativa da Arena e ainda não tenha avaliação no EQ-Bench. O Claude Fable 5 é a escolha se der mais peso aos votos humanos da Arena do que às pontuações dos harnesses; custa $10 / $50 por 1M de tokens e está incluído de forma permanente no Claude Max e no Team Premium com cerca de 50 % dos limites de utilização habituais. A tradução é outra questão com outro vencedor, que analisamos no nosso guia da melhor IA para tradução.
| Modelo | Melhor para | Ponto forte | Ponto fraco | Preço (por 1M de tokens) |
|---|---|---|---|---|
| Claude Fable 5.1 | Melhor escrita no geral | #2 EQ-Bench Creative Writing (2162,0), #3 LiveBench Language (89,5) e #9 escrita criativa da Arena, a melhor colocação combinada de todos | Não lidera nenhum dos três de forma isolada; o Gemini 4 Argon lidera agora a escrita criativa da Arena, com o Claude Opus 5.5 em segundo | $10 / $50 |
| Claude Fable 5 | Forte nos quadros de votos humanos | #1 LiveBench Language (90,7), #3 escrita criativa da Arena (1501,5), #4 Arena texto (1503,7) | #11 EQ-Bench; a opção mais cara aqui | $10 / $50 |
| Kimi K3 | Ficção criativa e voz | #5 EQ-Bench Creative Writing (2082,3) | Apenas #28 na Arena escrita criativa | $3 / $15 |
| Claude Sonnet 5.5 | Escrita gratuita para o dia a dia | Grátis em claude.ai, contexto 1M; #3 GDPval-AA v2.1 (1838), atrás do Opus 5.5 e do Muse Wonder Full | 83,4 LiveBench Language; #24 escrita criativa da Arena; ainda sem avaliação no EQ-Bench | $2 / $10 |
| Claude Opus 5.5 | O melhor em escrita criativa da Arena entre os disponíveis | #2 escrita criativa da Arena (1517) e #2 Arena texto (1507); #1 GDPval-AA v2.1 (1866) | #7 EQ-Bench e #10 LiveBench Language | $4 / $20 |
| Gemini 4 Argon | A prosa mais votada na Arena | #1 escrita criativa da Arena (1519,2) e #1 Arena texto (1525,4) | Sem avaliação no EQ-Bench nem no LiveBench | $19.99/mês Google AI Pro; $2 / $10 API de lançamento até 30/11 |
| GPT-5.5 | Escrita empresarial ancorada em factos | Ganhos documentados de fiabilidade factual sobre o GPT-5.4 | Níveis de raciocínio agora marcados como obsoletos | $5 / $30 |
| Gemini 3.8 Flash | Rascunhos em massa à escala | Intelligence Index 40,9, 308,4 tok/s de saída, contexto 1M | Afinado para agentes e não para prosa; o preço introdutório duplica a 1 de janeiro de 2027 | $0.75 / $3.75 |
A coroa da escrita continua com o Claude Fable 5.1, mas a sua margem na Arena estreitou-se. O Gemini 4 Argon da Google, anunciado a 30 de setembro, entrou diretamente em primeiro no quadro de escrita criativa da Arena com 1519,2, empurrando o Claude Opus 5.5 para segundo e o Claude Fable 5 para terceiro, e o Fable 5.1 desceu de sétimo para décimo e entretanto subiu para nono, pelo que este cartão afirma agora o top dez dos três quadros de prosa em vez do top sete. O Argon ainda não pode ficar com a coroa: desde 13 de outubro os subscritores do Google AI Pro e do Ultra podem usá-lo, mas o EQ-Bench e o LiveBench continuam sem o avaliar. Em setembro chegaram o Claude Opus 5.5 e o Claude Sonnet 5.5, o Sonnet 5.5 substituiu o Sonnet 5 como escolha gratuita e o GPT-6.1 Sol entrou em segundo no LiveBench Language, empurrando aí o Fable 5.1 para terceiro.
Melhor IA para chat & assistente do dia a dia
A melhor IA para o chat do dia a dia é o GPT-6, e a razão honesta é o alcance em vez da posição nos quadros. Desde 7 de outubro, é com ele que o ChatGPT responde por predefinição: o GPT-6 Sol no Plus, Pro, Business e Enterprise, e o GPT-6 Luna no Free e Go, em implementação desde 8 de outubro. Isso faz dele o assistente que a maioria das pessoas consegue realmente abrir.
Na preferência humana pura, está longe da liderança. O GPT-6 Sol está em #67 no quadro de texto da Arena com 1455,9, abaixo do seu antecessor GPT-5.6 Sol em #20, enquanto o Gemini 4 Argon lidera com 1525,4 e o Claude Opus 5.5 é segundo com 1507,1. A Artificial Analysis dá ao GPT-6 Sol 47,6 no Intelligence Index v4.3.2 com esforço máximo e ao GPT-6 Luna 38,1. Na API, o Sol custa $2 / $10 e o Luna $0,10 / $0,50 por 1M de tokens.
| Modelo | Melhor para | Ponto forte | Ponto fraco | Preço |
|---|---|---|---|---|
| GPT-6 | Chat do dia a dia, predefinição do ChatGPT | O assistente que a maioria consegue abrir: Sol nos planos pagos, Luna no Free e Go | GPT-6 Sol apenas #67 na Arena texto | Grátis / $20/mês Plus; API $0.10 / $0.50 (Luna) a $2 / $10 (Sol) |
| Gemini 4 Argon | A conversa mais votada | #1 na Arena texto (1525,4); taxa de alucinação de 15 %, a mais baixa entre os modelos de topo | Classificação da Arena ainda preliminar; Google AI Pro ou superior na aplicação Gemini | $19.99/mês Google AI Pro; $2 / $10 API de lançamento até 30/11 |
| Claude Opus 5.5 | A conversa com a pontuação mais alta | #1 no Intelligence Index (57,6) e #2 na Arena texto (1507,1) | Não está no plano Free; com limites de utilização no Pro | $20/mês Pro, $4 / $20 API |
| Claude Sonnet 5.5 | Chat gratuito com o Claude | Grátis em claude.ai; #2 no Intelligence Index (56,0), atrás apenas do Claude Opus 5.5 | Apenas #32 na Arena texto; nas apps corre por omissão com esforço Medium | Grátis / $20/mês Pro, $2 / $10 API |
| GPT-5.5 Instant | Trabalho diário sensível a alucinações | 52,5 % menos afirmações alucinadas vs 5.3 Instant | Níveis de raciocínio agora marcados como obsoletos | $20/mês Plus; API $5 / $30 |
| Gemini 3.6 Flash | Rápido, barato, multimodal | Contexto 1M, #23 na Arena texto | Na aplicação Gemini exige o Google AI Plus desde 9 de outubro; o 3.8 Flash supera-o ao mesmo preço | AI Plus / $0.75 / $3.75 API |
| Fello AI | Muitos modelos líderes, uma aplicação | ChatGPT + Claude + Gemini + Grok + DeepSeek e mais no Mac, iPhone e iPad | Encaminhado pela aplicação, não direto | Desde $11.99/mês |
A escolha para chat passa do GPT-5.6 para o GPT-6, pela mesma razão por que o GPT-5.6 a tinha: a 7 de outubro, a OpenAI tornou o GPT-6 a predefinição do ChatGPT, o Sol nos planos pagos e o Luna no Free e Go a partir de 8 de outubro. Os quadros por votação colocam-no abaixo do antecessor, o GPT-6 Sol em #67 na Arena texto contra #20 do GPT-5.6 Sol, e é por isso que esta escolha assenta no alcance. Desde 13 de outubro, o Gemini 4 Argon está na aplicação Gemini para os subscritores do Google AI Pro e do Ultra, pelo que o líder do quadro de texto da Arena, com 1525,4, fica com o segundo lugar do pódio; o Claude Opus 5.5 passa para terceiro e o Claude Sonnet 5.5 continua na tabela como a escolha para o Claude grátis.
Melhor IA para criar imagens
A melhor IA para gerar imagens é o ChatGPT Images 2.5, que a OpenAI tornou predefinido em todos os planos do ChatGPT a 8 de setembro e que lidera os quatro quadros de imagem que acompanhamos.
Os seus dois modelos ficam em primeiro e segundo em cada um: o GPT-Image-2.5 Sunburst, pensado para a precisão, lidera o Arena texto para imagem com 1424,6 e a edição de imagens da Arena com 1523,6, e na Artificial Analysis o AA-Image-T2I v2.0 com 1197 e o AA-Image-Editing v2.0 com 1182, com o mais rápido GPT-Image-2.5 Flare em segundo nos quatro. Leia a distância entre o Sunburst e o Flare no Arena texto para imagem como provisória, porque cada um assenta em cerca de 17 000 votos contra os 93 000 do GPT Image 2. O MAI-Image-2.6 é o segundo, terceiro no quadro de edição da Artificial Analysis e quinto no Arena texto para imagem com 1332,1, num empate estatístico com o Grok Imagine Image 2.0, logo à frente.
O terceiro é o Grok Imagine Image 2.0 da SpaceXAI, lançado em agosto e disponível no Grok Imagine e na API da xAI: é quarto no quadro de texto para imagem da Artificial Analysis, na edição de imagens da Arena e agora também no Arena texto para imagem, à frente do Muse Image da Meta em três dos quatro quadros. O Nano Banana 2.1 da Google, lançado a 6 de outubro, é agora o modelo da Google mais bem colocado: sexto no Arena texto para imagem com 1327,8, na mesma faixa de posições do MAI-Image-2.6 e do Grok Imagine Image 2.0, e sexto na edição da Arena, embora a Artificial Analysis ainda não o tenha avaliado.
O melhor modelo de imagem que pode descarregar é o Qwen-Image-2.1 da Alibaba, lançado a 20 de setembro e agora o modelo de pesos abertos mais bem colocado nos quatro quadros, 18.º na edição de imagens da Arena e nos dois quadros da Artificial Analysis e 19.º no Arena texto para imagem. A sua licença só permite investigação e avaliação, por isso não é uma opção comercial gratuita. A nossa análise completa do que foi lançado está em ChatGPT Images 2.5.
| Modelo | Melhor para | Ponto forte | Ponto fraco | Preço |
|---|---|---|---|---|
| ChatGPT Images 2.5 | Imagens com texto legível | #1 e #2 nos quatro quadros: Arena texto para imagem (1424,6 / 1397,6), Arena edição (1523,6 / 1481,0), texto para imagem da Artificial Analysis (1197 / 1191) e edição (1182 / 1162) | A liderança no Arena texto para imagem assenta em cerca de 17 000 votos por modelo | Predefinição em todos os planos ChatGPT |
| MAI-Image-2.6 | Editar uma imagem que já tem | #3 na edição de imagens da Artificial Analysis (1137) e #5 no Arena texto para imagem (1332,1) | Pré-visualização pública, ainda não no Copilot nem no Bing; perdeu a liderança da edição da Artificial Analysis para o ChatGPT Images 2.5 | MAI Playground / Microsoft Foundry |
| Grok Imagine Image 2.0 | Menos restrições, modo Spicy | #4 em texto para imagem da Artificial Analysis (1155) e #4 na edição de imagens da Arena (1439,1); #4 no Arena texto para imagem (1333,5) | Apenas #10 na edição de imagens da Artificial Analysis | $30 por mês SuperGrok; API da xAI |
| Nano Banana 2.1 | O modelo de imagem da Google para o dia a dia | #6 Arena texto para imagem (1327,8) e #6 na edição de imagens da Arena (1428,1), o melhor de qualquer modelo da Google; na API, metade do preço por imagem do Nano Banana 2 | Ainda sem avaliação da Artificial Analysis; os tokens de entrada custam o triplo do Nano Banana 2 | Aplicação Gemini / AI Studio; $0,0336 por imagem 1K |
| Seedream 5.0 Pro | Texto multilíngue + edição por regiões | 10+ idiomas incl. árabe RTL, edição com laço e camadas | Por volta do décimo lugar nos quadros independentes; incerteza de direitos de autor | BytePlus / Magnific |
| Midjourney v8 | Arte estilizada, ilustração | Base estética que a maioria dos artistas prefere | Mais fraco em texto dentro da imagem | $10-$120/mês |
| Qwen-Image-2.1 | O melhor modelo de imagem que pode descarregar | O modelo de pesos abertos mais bem colocado nos quatro quadros: #18 edição de imagens da Arena (1368,7), #19 Arena texto para imagem (1222,9) e #18 nos dois quadros da Artificial Analysis; gerador de 7B, PNG transparentes, até 10 imagens de referência | Qwen Research License, apenas para investigação ou avaliação, sem uso comercial | Descarga gratuita (Hugging Face) |
| Qwen-Image-3.0-Pro | Composições densas com muito texto | #13 Arena texto para imagem (1255,2) e #14 texto para imagem da Artificial Analysis (1090); prompts até 4500 tokens, texto em 12 idiomas | Apenas alojado, sem pesos; sem avaliação na edição de imagens da Arena | Qwen Chat; $0,04-$0,075 por imagem na API |
| Muse Image | Edição de imagens, ecossistema Meta | #6 na edição de imagens da Artificial Analysis (1118) e #7 no seu texto para imagem | Fora do pódio; #9 no Arena texto para imagem e #8 na edição da Arena | Aplicação Meta AI |
O ChatGPT Images 2.5 mantém a coroa da imagem e continua em primeiro e segundo nos quatro quadros que acompanhamos. Desde a última atualização, a Google lançou o Nano Banana 2.1 a 6 de outubro, e a Arena colocou-o em quinto no texto para imagem e em sexto na edição, o melhor de qualquer modelo da Google, na mesma faixa de posições do MAI-Image-2.6 e do Grok Imagine Image 2.0. Fica com a linha do Nano Banana 2 na tabela em vez de um lugar no pódio: está agora atrás do MAI-Image-2.6 e do Grok Imagine Image 2.0 nos dois quadros da Arena, e a Artificial Analysis ainda não o avaliou.
Entretanto, o Grok Imagine Image 2.0 subiu para quarto no Arena texto para imagem, 1,4 pontos acima do MAI-Image-2.6, em quinto; o Nano Banana 2.1 é agora sexto e o Reve 2.1, sétimo. No início do mês, o Grok Imagine Image 2.0 tirou o terceiro lugar ao Muse Image, e a Artificial Analysis passou os seus dois quadros de imagem para a v2.0. Em setembro, o Images 2.5 substituiu o GPT Image 2 no topo a 8 de setembro.
Melhor IA para criar vídeos
A melhor IA para gerar vídeo é o MiniMax H3, que a MiniMax lançou a 31 de julho com pesos abertos, e o que o justifica é ficar perto do topo em todo o lado em vez de ganhar um único quadro.
Lidera o quadro de imagem para vídeo da Arena com 1495,4, à frente do Gemini Omni 1.1 Flash com 1488,5 e do Wan 3.0 da Alibaba com 1479,8; no quadro de imagem para vídeo da Artificial Analysis é segundo com 1181, atrás apenas do MiniMax H3 Max, um modelo que a Fal construiu sobre ele; e é quarto no quadro de texto para vídeo da Artificial Analysis com 1137. O seu ponto fraco é o quadro de texto para vídeo da Arena, onde é oitavo com 1460,3.
Gera clipes 2K de 4 a 15 segundos com áudio estéreo nativo, desde $0,13 por segundo em 2K, e os pesos estão no Hugging Face sob a licença comunitária própria da MiniMax, sem o upscaler 2K e mediante candidatura nos EUA, na UE, no Reino Unido e na Coreia do Sul. O Gemini Omni 1.1 Flash, a nossa escolha até esta atualização, continua a liderar o quadro de texto para vídeo da Arena com 1516,2, num empate estatístico com o Gemini Omni Flash com 1512,9, e é a escolha para planos longos: extensão de cena em passos de 10 segundos até 40 segundos, controlo do primeiro e do último fotograma e saída em 4K, desde cerca de $0,03 por segundo em 360p até $0,30 em 4K.
Mas a Artificial Analysis já o avaliou, e fica em oitavo no texto para vídeo com 1113, sem qualquer avaliação de imagem para vídeo. O Wan 3.0 lidera o quadro de texto para vídeo da Artificial Analysis com 1156 e é terceiro no quadro de imagem para vídeo da Arena, mas apenas sexto no de texto para vídeo da Arena. Se precisar de planos mais longos nas ferramentas da Google, o Veo 3.1 continua a funcionar na aplicação Gemini, no AI Studio e no Vertex AI com áudio nativo e saída em 1080p.
| Modelo | Melhor para | Ponto forte | Ponto fraco | Preço |
|---|---|---|---|---|
| MiniMax H3 | Melhor vídeo com IA no geral | #1 Arena imagem para vídeo (1495,4), #2 imagem para vídeo da Artificial Analysis (1181), #4 texto para vídeo da Artificial Analysis (1137); clipes 2K de 4-15 s com áudio estéreo nativo | #8 no Arena texto para vídeo (1460); os pesos abertos excluem o upscaler 2K e exigem candidatura nos EUA, na UE, no Reino Unido e na Coreia do Sul | $0.13/s em 2K |
| Gemini Omni 1.1 Flash | Planos longos e 4K | #1 Arena texto para vídeo (1516), #2 Arena imagem para vídeo (1488,5); extensão de cena até 40 segundos, saída em 4K | Apenas #8 em texto para vídeo da Artificial Analysis (1113); sem avaliação de imagem para vídeo da Artificial Analysis | $0,03-$0,30/s; Gemini API / AI Studio / Flow |
| Gemini Omni Flash | Clipes de dez segundos mais baratos | #2 Arena texto para vídeo (1513), #3 imagem para vídeo da Artificial Analysis (1178); edição conversacional | Fica-se por gerações de dez segundos | ~$0.10/s; aplicação Gemini / AI Studio |
| Wan 3.0 | Vídeo a partir de documentos e diapositivos | #1 texto para vídeo da Artificial Analysis (1156), #3 Arena imagem para vídeo (1479,8); 2-30 s, até 1080p, entrada Omni-Reference | Apenas API, sem pesos publicados; #6 no Arena texto para vídeo | $0.05-$0.20/s |
| Dreamina Seedance 2.5 | Rival da ByteDance | #3 texto para vídeo da Artificial Analysis (1143), #4 Arena imagem para vídeo (1477,4) | #7 Arena texto para vídeo (1474); ecossistema ByteDance, acesso ocidental limitado | Dreamina / BytePlus |
| Muse Video | Vídeo no ecossistema Meta | #9 no Arena texto para vídeo com 1456 | O mais recente do grupo, ferramentas escassas | Aplicação Meta AI |
| Veo 3.1 | Clips de produção mais longos | Áudio nativo, 1080p, forte consistência física | #12 na Arena vídeo, não o líder de qualidade | Google AI Pro / Ultra |
| Kling 3.0 / 3.0 Turbo | Iteração rápida a menor custo | 4K nativo, 60fps, clips de 15 segundos; o Turbo saiu a 17 de junho | Fora do top 16 na Arena texto para vídeo | A partir de $10/mês |
| Luma Ray 3 | Cenas fotorrealistas | Forte realismo para paisagens | Comunidade mais pequena | Grátis / a partir de $9.99/mês |
A coroa do vídeo passa do Gemini Omni 1.1 Flash para o MiniMax H3. Desde a última atualização, a Artificial Analysis avaliou pela primeira vez o Omni 1.1 Flash, e no seu quadro de texto para vídeo, agora na versão 2.0, fica em oitavo com 1113, atrás do Wan 3.0 com 1156 e do MiniMax H3 com 1137. Como o H3 continua em primeiro no quadro de imagem para vídeo da Arena e em segundo no da Artificial Analysis, atrás apenas de um modelo construído sobre ele, o H3 classifica-se agora melhor no conjunto dos quatro quadros que acompanhamos.
O Omni 1.1 Flash mantém o primeiro lugar no quadro de texto para vídeo da Arena, ainda num empate estatístico com o Gemini Omni Flash, por isso continua no pódio como a escolha para texto para vídeo, e o Wan 3.0 tira o terceiro lugar ao Dreamina Seedance 2.0. No início do mês, o FLUX 3 Video e o Grok Imagine Video 1.5 entraram em terceiro e quarto no quadro de texto para vídeo da Arena. Em setembro, o Gemini Omni 1.1 Flash manteve o primeiro lugar no quadro de texto para vídeo da Arena e o MiniMax H3 ficou com o primeiro lugar no de imagem para vídeo.
Melhor IA para programação
A melhor IA para programar é o Claude Opus 5.5, que a Anthropic lançou a 22 de setembro, embora já não lidere todos os quadros, e o modelo que lhe tirou dois deles é o seu próprio irmão mais barato.
O Claude Sonnet 5.5, lançado a 28 de setembro, lidera a execução própria do Terminal-Bench 4.0 da Artificial Analysis com 63,6 % contra 59,6 % do Opus 5.5 e o LiveBench Coding com 91,4 contra 89,3. O Opus 5.5 mantém a coroa pelo resto das provas. Lidera o quadro WebDev da Arena com 1813, à frente do GPT-6 Astra com 1786 e do Claude Sonnet 5.5 com 1774. Faz 71,7 no LiveBench Agentic Coding, atrás apenas do DeepSeek V4.1-Flash, onde o Sonnet 5.5 fica pelos 56,3, e nos harnesses da própria Anthropic bate o Sonnet 5.5 no FrontierCode v1.1, 54,4 % contra 52,1 %, e no CursorBench 4.0, 57,8 % contra 55,5 %. O preço favorece agora o Sonnet 5.5 em qualquer nível de esforço.
Custa $2 / $10 por 1M de tokens contra $4 / $20 do Opus 5.5, e a Artificial Analysis coloca agora até uma tarefa do Intelligence Index no esforço máximo em $5,46 contra $5,98 do Opus 5.5; em xhigh faz 51,9 no índice por $2,01 por tarefa e em high 46,7 por $0,88. O Opus 5.5 também tomou o quadro imagem para WebDev da Arena com 1748,5, à frente do Sonnet 5.5 com 1740,0 e do GPT-6 Astra com 1731,4; o Astra iguala os 59,6 % do Opus 5.5 no Terminal-Bench 4.0 em xhigh, a $10 / $50, e o Claude Fable 5.1 é quinto no WebDev e quarto em imagem para WebDev.
O GPT-6.1 Sol é a opção barata da OpenAI: quarto no WebDev e 56,1 % no Terminal-Bench 4.0 por $0,72 por tarefa do índice, embora o LiveBench o deixe bem fora dos dez primeiros no Coding, com 80,7. O Gemini 4 Argon lidera a tabela da própria Google no DeepSWE v1.1 com 77,9 %, mas a Artificial Analysis mede 57,1 % no Terminal-Bench 4.0, a Arena coloca-o em nono no WebDev e desde 13 de outubro está na API paga e no Antigravity para os subscritores do Google AI Ultra.
O Claude Haiku 5.5, lançado a 7 de outubro a $0,10 / $0,50, é o Claude barato para trabalho de subagentes em grande volume: 33 % na execução do Terminal-Bench 4.0 da Artificial Analysis, ao nível do GLM 5.3 Flash, e 57,2 no LiveBench Agentic Coding, logo acima do Sonnet 5.5, embora a Arena só o coloque em 30.º no WebDev. Entre os pesos abertos, o MiMo-V2.6-Pro da Xiaomi faz 34,8 % no Terminal-Bench 4.0 sob MIT simples a $0,13 por tarefa do índice, o GLM-5.3 continua a ser o modelo aberto mais forte nesse harness com 41,9 % e o Kimi K3 é o modelo aberto mais bem colocado no Arena WebDev, décimo quarto com 1654, com apenas 12,6 % no harness.
A Artificial Analysis retirou tanto o seu Coding Index como o seu Coding Agent Index, pelo que as duas classificações compostas de programação que esta página citava já não existem.
| Modelo | Melhor para | Ponto forte | Ponto fraco | Preço (por 1M de tokens) |
|---|---|---|---|---|
| Claude Opus 5.5 | Melhor programação no geral | #1 Arena WebDev (1813) e #1 Intelligence Index (57,6, v4.3.2); 71,7 no LiveBench Agentic Coding, 15 pontos acima do Sonnet 5.5 | Segundo atrás do Sonnet 5.5 no Terminal-Bench 4.0 (59,6 % contra 63,6 %) e no LiveBench Coding (89,3 contra 91,4) | $4 / $20 |
| Claude Sonnet 5.5 | A escolha de valor para programar | #1 Terminal-Bench 4.0 (63,6 %) e #1 LiveBench Coding (91,4), #3 Arena WebDev (1774); em xhigh 51,9 no índice por $2,01 por tarefa | 56,3 no LiveBench Agentic Coding, 15 pontos atrás do Opus 5.5 | $2 / $10 |
| GPT-6 Astra | Segundo no WebDev da Arena | #2 Arena WebDev (1786) e #3 imagem para WebDev (1731,4); 59,6 % Terminal-Bench 4.0 em xhigh | 2,5 vezes o preço do Opus 5.5; atrás do Sonnet 5.5 no Terminal-Bench e bem atrás dos dois modelos Claude no LiveBench Coding | $10 / $50 |
| Claude Fable 5.1 | Maior pontuação composta antes do Opus 5.5 | #5 Arena WebDev e #4 imagem para WebDev; Intelligence Index 53,4; AA-Briefcase 1675 | 52,0 % Terminal-Bench 4.0; 2,5 vezes o preço do Opus 5.5 | $10 / $50 |
| Claude Opus 5 | Substituído pelo Opus 5.5 | 49,0 % Terminal-Bench 4.0 e #7 Arena WebDev e #7 imagem para WebDev | Custa mais por token do que o Opus 5.5 e pontua sete pontos abaixo | $5 / $25 |
| Claude Fable 5 | Trabalho agêntico mais duro e de horizonte longo | Intelligence Index 49,6; 42,4 % Terminal-Bench 4.0; contexto de 1M | O mais caro por tarefa do índice neste quadro, $8,75; #10 no Arena imagem para WebDev | $10 / $50 |
| Qwen3.8-Max-0902 | Detentor breve do quadro WebDev da Arena | #10 Code Arena: WebDev (1674); Intelligence Index 45,4; 2,4 biliões de parâmetros, contexto de 1M | Apenas API da QwenCloud, sem interface para consumidores; perdeu a liderança do WebDev em dias | $2 / $6 |
| Kimi K3 | Modelo aberto mais bem colocado na Arena | #14 Arena WebDev (1654), a melhor colocação aberta nesse quadro; 2,8 biliões/104 mil milhões ativos | Apenas 12,6 % no Terminal-Bench 4.0; 1,56 TB para alojar | $3 / $15 |
| GPT-5.6 Sol | O topo de gama mais barato da OpenAI | Intelligence Index 47,0; 39,9 % Terminal-Bench 4.0 | Substituído pelo GPT-6 Sol, que pontua mais alto por metade do preço; a METR assinalou manipulação de avaliações | $4 / $20 |
| GPT-6 Sol | Programação GPT-6 barata no Codex | Intelligence Index 47,6 (v4.3.2) e 43,9 % no Terminal-Bench 4.0, ambos acima do GPT-5.6 Sol e por metade do preço | #8 Arena WebDev (1688) | $2 / $10 |
| GPT-6.1 Sol | O modelo da frente mais barato por tarefa | Intelligence Index 51,8 (v4.3.2), #4 Arena WebDev (1755) e 56,1 % no Terminal-Bench 4.0 a $0,72 por tarefa do índice, com entrada em cache a $0,10 | 80,7 no LiveBench Coding, bem fora dos dez primeiros; apenas no Codex e no ChatGPT Work, não no Chat | $2 / $10 |
| Gemini 4 Argon | Tarefas de software longas | 77,9 % no DeepSWE v1.1 segundo os números da Google; Intelligence Index 52,6 a $1,99 por tarefa do índice | 57,1 % no Terminal-Bench 4.0 e #9 Arena WebDev (1678) | $2 / $10 de lançamento até 30/11, $4 / $20 normal |
| Muse Spark 1.3 | Programação agêntica barata | Intelligence Index 48,1 a $1,25 / $4,25 e $1,60 por tarefa do índice | 33,3 % no Terminal-Bench 4.0; as vitórias em programação vêm do gráfico da própria Meta, medido numa variante max só para parceiros | $1,25 / $4,25 |
| Muse Wonder Full | O modelo mais forte da Meta, dentro do Muse Code | Intelligence Index 55,8 (v4.3.2), terceiro entre modelos distintos; #2 GDPval-AA v2.1 (1857); 57,1 % Terminal-Bench 4.0 | Só com subscrição do Muse Code (planos de $50 e $200), sem API; a Arena ainda não o avaliou | Muse Code, desde $50/mês |
| Muse Wonder | O modelo de topo da Meta na API | Intelligence Index 52,4 (v4.3.2); 52,0 % Terminal-Bench 4.0; contexto de 1M | Os mesmos $4 / $20 do Opus 5.5, que pontua 5,2 pontos mais; $4,52 por tarefa do índice | $4 / $20 |
| Grok 4.7 | Programador barato com boa relação | 46,3 % CursorBench 4.0 e 71,0 % DeepSWE v1.1 pelos números da própria SpaceXAI; Intelligence Index 46,3 | 24,7 % no Terminal-Bench 4.0; prompts de 200K tokens ou mais refaturam o pedido inteiro ao dobro | $2 / $6 |
| Gemini 3.8 Flash | Programação agêntica em escala | Intelligence Index 40,9; 308,4 tokens de saída por segundo | 19,7 % no Terminal-Bench 4.0; o preço de lançamento duplica a 1 de janeiro de 2027 | $0,75 / $3,75 |
| GLM 5.3 Flash | O programador sério mais barato que consegue alojar | 32,8 % Terminal-Bench 4.0 a $0,25 por tarefa do índice; MIT, 320 mil milhões/18 mil milhões ativos | O GLM-5.3 chega a 41,9 % no mesmo harness; sem produto para consumidores | Pesos abertos (MIT) |
| Claude Haiku 5.5 | O Claude mais barato para subagentes | Intelligence Index 43,4 (v4.3.2) a $0,21 por tarefa do índice; 33 % Terminal-Bench 4.0, ao nível do GLM 5.3 Flash; 57,2 no LiveBench Agentic Coding, acima do Sonnet 5.5 | #30 Arena WebDev (1587); a Anthropic diz que o Sonnet 5.5 e o Opus 5.5 continuam melhores para programação agêntica complexa; prompts acima de 100K tokens custam cinco vezes mais | $0,10 / $0,50 |
| MiMo-V2.6-Pro | O maior Intelligence Index aberto | 46,3 na v4.3.2 e 34,8 % Terminal-Bench 4.0 a $0,13 por tarefa do índice; MIT, 1,02 biliões/42 mil milhões ativos | Apenas #19 no Arena WebDev (1629), cinco lugares atrás do Kimi K3 | $0,435 / $0,87 |
O Claude Opus 5.5 mantém a coroa da programação. Desde a última atualização chegou a 7 de outubro o Claude Haiku 5.5, a $0,10 / $0,50, que fica com uma linha da tabela como o Claude mais barato para trabalho de subagentes, embora a Arena só o coloque em 30.º no WebDev. A Artificial Analysis coloca agora uma tarefa do índice do Sonnet 5.5 no esforço máximo em $5,46, abaixo dos $5,98 do Opus 5.5, pelo que o Opus 5.5 mantém a coroa pelo WebDev e pelo LiveBench Agentic Coding, não pelo custo. O Claude Sonnet 5.5 entrou em terceiro no quadro WebDev da Arena com 1774, atrás do GPT-6 Astra com 1786, o que empurra o GPT-6.1 Sol para quarto e o Claude Fable 5.1 para quinto, e o Gemini 4 Argon, que entrou no início do mês, está agora em nono. Desde então, o Opus 5.5 também tirou ao GPT-6 Astra o quadro imagem para WebDev da Arena, e a 12 de outubro chegou o Muse Wonder da Meta com duas linhas da tabela: o Muse Wonder Full marca 55,8 no índice mas só funciona no Muse Code, e o Muse Wonder custa os mesmos $4 / $20 do Opus 5.5 por 52,4.
O Argon lidera a própria tabela DeepSWE v1.1 da Google com 77,9 %, mas no Terminal-Bench 4.0 da Artificial Analysis faz 57,1 %, atrás do Sonnet 5.5, do Opus 5.5 e do GPT-6 Astra, e o seu lançamento público a 13 de outubro não mudou essas pontuações. Em setembro a coroa mudou de mãos duas vezes, do Claude Fable 5.1 para o GPT-6 Astra e depois para o Opus 5.5, e o Claude Sonnet 5.5 ficou com o Terminal-Bench 4.0 e o LiveBench Coding como escolha de relação qualidade-preço.
Melhor IA para criatividade
A melhor IA para trabalho criativo sem filtros e na moda é o Grok 4.7, e queremos ser exatos quanto ao motivo. Esta escolha é sobre a linha de produto, não sobre a qualidade da prosa.
O Grok tem as menores restrições de conteúdo de qualquer modelo de fronteira e a única integração nativa com o X em tempo real, o que faz dele o único modelo que pega em encargos ousados, atuais ou deliberadamente provocadores que os outros recusam. A SpaceXAI lançou o Grok 4.7 a 21 de setembro na API do Grok, no Cursor e no Grok Build, e desde 3 de outubro também alimenta o modo Expert do grok.com, além do modo Fast para os assinantes pagos. Não é o melhor a escrever, embora o quadro seja mais misto do que era.
O EQ-Bench já avaliou o Grok 4.7 e coloca-o em oitavo com 2006,7, dentro do seu top dez e muito acima do Grok 4.5 em 52.º, mas os votantes humanos da Arena põem o 4.7 apenas em 74.º na escrita criativa, atrás do Grok 4.6 em 54.º e do mais antigo Grok 4.20-beta1 em 23.º. Se escolher só pela qualidade do resultado, o Gemini 4 Argon lidera agora o quadro de escrita criativa da Arena, disponível no Google AI Pro desde 13 de outubro, com o Claude Opus 5.5 em segundo e o Claude Fable 5 em terceiro, enquanto o EQ-Bench coloca o GPT-6 Astra em primeiro com 2173,3, o Claude Fable 5.1 em segundo e o Kimi K3 em quinto. Escolha o Grok pelo que ele o deixará fazer, não por como escreve.
| Modelo | Melhor para | Ponto forte | Ponto fraco | Preço |
|---|---|---|---|---|
| Grok 4.7 | Sem filtros, com opinião, na moda | Menos restrições de conteúdo, ancoragem nativa no X em tempo real | #74 na escrita criativa da Arena, embora #8 no EQ-Bench (2006,7) | $2 / $6 API; app SuperGrok de $30 por mês |
| Claude Fable 5 | Prosa criativa da mais alta qualidade | #3 Arena escrita criativa, #1 LiveBench Language | Barreiras cautelosas em briefings ousados | $10 / $50 API |
| Kimi K3 | Ficção e voz própria | #5 EQ-Bench Creative Writing com 2082,3 | Apenas #28 na escrita criativa da Arena | $3 / $15 |
| Claude Opus 5 | Criatividade estruturada de formato longo | Mantém fios longos e autoedita-se; Intelligence Index 50,8, agora atrás de seis modelos mais recentes | O mais cauteloso do grupo | $20/mês Pro; $5 / $25 API |
| Gemini 3.1 Pro | Criativo multimodal | Forte cadeia de texto, imagem e vídeo | Na aplicação Gemini exige o Google AI Pro desde 9 de outubro | AI Pro / $2.00-$4.00 API entrada |
| Grok Imagine (Spicy Mode) | NSFW / criativo para adultos | A geração de imagens mais permissiva | Caso de utilização de nicho | $30/mês SuperGrok |
O Grok mantém esta escolha com o Grok 4.7, e nada mudou na permissividade do produto nem no seu acesso em direto ao X, que é onde a escolha assenta. O quadro de escrita criativa da Arena mexeu à sua volta: o Gemini 4 Argon, anunciado a 30 de setembro, entrou em primeiro, o Claude Opus 5.5 é agora segundo e o Claude Fable 5 terceiro, e o Grok 4.7 desceu para 74.º. O EQ-Bench não mudou e continua a pôr o 4.7 em oitavo. A aplicação de que trata realmente o argumento da permissividade apanhou o atraso a 3 de outubro, quando o Grok 4.7 passou a alimentar o modo Expert do grok.com. Em setembro, o Grok 4.7 substituiu o Grok 4.6 como topo de gama da SpaceXAI a 21 de setembro e os dois quadros de escrita criativa avaliaram-no.
Melhor IA para precisão & investigação
A melhor IA para precisão e investigação é o Claude Fable 5.1, que detém a maior precisão factual que a Artificial Analysis já mediu, 67 % no AA-Omniscience.
É exatamente essa a coluna com que esta categoria é decidida. O Claude Opus 5.5 bateu o Fable 5.1 em quase tudo o resto quando chegou a 22 de setembro, incluindo o Humanity's Last Exam com 61,4 % contra 59,1 % e o índice AA-Omniscience que penaliza alucinações com 46,4 contra 43,5, mas na precisão factual pura marca 66 % contra 67 % do Fable 5.1. Trate essa diferença de um ponto como um empate e leia os dois em conjunto: o Opus 5.5 é a melhor aposta quando uma resposta errada é pior do que nenhuma, o Fable 5.1 quando quer acertar o maior número de factos.
A escolha de relação qualidade-preço é agora o GPT-6.1 Sol, que responde corretamente a 62 % das perguntas com um índice AA-Omniscience de 41,5 a $2 / $10 por 1M de tokens e $0,72 por tarefa do índice, e faz 98,5 % no ARC-AGI-1 da ARC Prize por $0,06 por tarefa. Isso supera o Gemini 3.1 Pro, a nossa escolha de relação qualidade-preço até esta atualização, em todas as medidas de precisão que a Artificial Analysis publica: este marca 55 % de precisão pura e um índice de 31,9.
O Gemini 3.1 Pro mantém o seu argumento quando a resposta tem de estar atualizada, porque ancora as respostas na Pesquisa Google e está na aplicação Gemini (com o Google AI Pro ou superior desde 9 de outubro), enquanto o GPT-6.1 Sol funciona no ChatGPT Work, no Codex e na API e não na janela de chat do ChatGPT. O Gemini 4 Argon é o modelo a acompanhar: a Artificial Analysis mede uma taxa de alucinação de 15 %, a mais baixa entre os modelos de topo, porque prefere não responder a adivinhar, mas só acerta 50 %; desde 13 de outubro está na aplicação Gemini a partir do Google AI Pro.
Na pesquisa ancorada em particular, o quadro de pesquisa da Arena é liderado pela OpenAI: o GPT-5.6 Sol está no topo com 1257, o Claude Fable 5 é quinto e o Gemini 3.1 Pro com ancoragem é nono. No raciocínio inédito a coroa está noutro lado, com o GPT-6 Astra a liderar o ARC-AGI-2 e o ARC-AGI-3. O Claude Opus 5 não tem nenhuma coroa de precisão porque a Artificial Analysis mede a sua taxa de alucinação em 61 %.
| Modelo | Melhor para | Benchmark-chave | Ponto fraco | Preço |
|---|---|---|---|---|
| Claude Fable 5.1 | Maior precisão factual medida | 67 % de precisão factual no AA-Omniscience, a maior que a Artificial Analysis mediu, um ponto acima do Claude Opus 5.5 | Sem escalão barato; não avaliado no quadro de pesquisa da Arena; o Opus 5.5 lidera o Humanity's Last Exam e o índice AA-Omniscience | $10 / $50 |
| Claude Opus 5.5 | Quando uma resposta errada é pior do que nenhuma | #1 índice AA-Omniscience (46,4) e #1 Humanity's Last Exam (61,4 %); 66 % de precisão pura | Um ponto atrás do Fable 5.1 na precisão pura | $4 / $20 |
| GPT-6.1 Sol | Melhor valor | 62 % de precisão pura e um índice AA-Omniscience de 41,5 a $0,72 por tarefa do índice; 98,5 % ARC-AGI-1 a $0,06 por tarefa | Taxa de alucinação de 54 %; no ChatGPT Work e no Codex, não no Chat | $2 / $10 |
| Gemini 4 Argon | Menos alucinações | Taxa de alucinação de 15 % no AA-Omniscience, a mais baixa entre os modelos de topo | Apenas 50 % de precisão pura | $19.99/mês Google AI Pro; $2 / $10 API de lançamento |
| Gemini 3.1 Pro | Pesquisa ancorada; aplicação Gemini com AI Pro a partir de 9 out. | Ancoragem nativa na Pesquisa Google; 98 % ARC-AGI-1 a $0.52/tarefa | 55 % de precisão pura no AA-Omniscience, abaixo do GPT-6.1 Sol; #9 na Arena pesquisa | $2.00-$4.00 / $12.00-$18.00 (escalonado) |
| Claude Fable 5 | Pesquisa ancorada | #5 no quadro de pesquisa da Arena, atrás do GPT-5.6 Sol | Sem um único nível barato | $10 / $50 (Fable 5) |
| GPT-5.6 Sol | Raciocínio inédito | #4 ARC-AGI-2 com 92,5 %, atrás do GPT-6 Astra (95 %), do GPT-6.1 Sol (94,2 %) e do Claude Opus 5.5 (93,3 %) | Scheming assinalado pelo METR | $4 / $20 |
| Claude Opus 5 | Os problemas inéditos mais difíceis | 30,2 % ARC-AGI-3 no harness padrão, segundo atrás do GPT-6 Astra (ARC Prize) | A Artificial Analysis mede uma taxa de alucinação de 61 % | $5 / $25 |
| Qwen 3.7 Max | Precisão frontier a preço vantajoso | 92,4 GPQA Diamond, 200 pedidos grátis/dia | Apenas API, sem front-end de chat | $1.25 / $3.75 promo; $2.50 / $7.50 tabela |
| Claude Opus 4.6 | Honestidade sob pressão | #1 no quadro MASK da Scale SEAL com 96,28; a Anthropic ocupa o top 5 | Substituído como modelo de topo | Modelo legacy da Anthropic |
A coroa da precisão continua com o Claude Fable 5.1, com 67 % de precisão factual pura contra 66 % do Claude Opus 5.5, e a escolha de relação qualidade-preço mudou. O GPT-6.1 Sol supera agora o Gemini 3.1 Pro em todas as medidas de precisão que a Artificial Analysis publica, 62 % de precisão pura contra 55 % e um índice AA-Omniscience de 41,5 contra 31,9, e a ARC Prize dá-lhe 98,5 % no ARC-AGI-1 por $0,06 por tarefa contra 98 % por $0,52 do Gemini 3.1 Pro, pelo que fica com o cartão de relação qualidade-preço. O Gemini 3.1 Pro continua na tabela pela pesquisa ancorada e pela aplicação Gemini, onde exige o Google AI Pro desde 9 de outubro.
O Gemini 4 Argon, anunciado a 30 de setembro, traz a taxa de alucinação mais baixa que a Artificial Analysis já mediu entre os modelos de topo, 15 %, mas só responde corretamente a metade das perguntas, pelo que o seu lançamento público a 13 de outubro não muda nada no topo. Corrigimos também duas linhas antigas: a taxa de alucinação do Claude Opus 5 é agora de 61 % e não de 50 %, e já não lidera o ARC-AGI-3. Em setembro, o Opus 5.5 ficou com o índice que penaliza alucinações e com o Humanity's Last Exam, e é por isso que este bloco divide agora os dois modelos Claude em vez de coroar um só.
Melhor IA para resolução de problemas
A melhor IA para resolver problemas difíceis é o GPT-6 Astra, que tirou os quadros de raciocínio ao GPT-5.6 Sol poucos dias depois do lançamento.
Lidera o LiveBench Reasoning com 92,65 e o ARC-AGI-2 com 95 %, a pontuação mais alta que alguém já obteve contra o painel humano de 100 % desse quadro, e está em quarto no LiveBench Mathematics com 96,81, atrás do Claude Opus 5.5 com 97,08, do Claude Fable 5.1 com 97,01 e do GPT-6.1 Sol com 96,83. Declara também 97,6 % no FrontierMath Tier 4 v2, um número que deve ser lido com o aviso da Epoch AI de que a OpenAI financiou o benchmark e tem acesso exclusivo a parte dele. O problema é o preço e o alcance: $10 / $50 por 1M de tokens contra $2 / $10 do GPT-6.1 Sol, e precisa de um plano pago do ChatGPT.
O GPT-6.1 Sol, lançado a 29 de setembro, é a alternativa de relação qualidade-preço e quase um colíder: 92,63 no LiveBench Reasoning, a 0,02 do Astra, e 94,2 % no ARC-AGI-2, a 0,8 pontos, por $0,25 por tarefa contra $1,12 do Astra. O Astra mantém a coroa porque continua a liderar os dois quadros e o ARC-AGI-3, onde faz 62,7 % no harness padrão contra 52,7 % do GPT-6.1 Sol. O Gemini 4 Argon lidera a categoria de matemática da Arena, mas com apenas algumas centenas de votos, e nem o LiveBench nem a ARC Prize o avaliaram. O GPT-5.6 Sol, a antiga escolha de relação qualidade-preço, é agora quinto no LiveBench Reasoning e quarto no ARC-AGI-2 com 92,5 %.
O Qwen 3.7 Max é a escolha económica para problemas de competição com 97,1 no índice HMMT de fevereiro de 2026 e 44,5 no Apex, com 200 pedidos gratuitos por dia. O Claude Opus 5 continua a ser a alternativa para cadeias longas de raciocínio agêntico, embora o Astra também lhe tenha tirado o ARC-AGI-3.
| Modelo | Melhor para | Benchmark-chave | Ponto fraco | Preço |
|---|---|---|---|---|
| GPT-6 Astra | Matemática, ciência e raciocínio mais difíceis | #1 LiveBench Reasoning (92,65), #1 ARC-AGI-2 (95 %), #1 ARC-AGI-3 | Exige um plano pago do ChatGPT; 5x o preço do GPT-6.1 Sol | $10 / $50 |
| Claude Opus 5 | Longas cadeias de raciocínio agêntico | 1662 no AA-Briefcase v1.1 e 1724 no GDPval-AA v2.1, quarto entre modelos distintos em ambos; 30,2 % ARC-AGI-3 | O Astra lidera agora o ARC-AGI-3; 61 % de taxa de alucinação; agora um modelo legado | $5 / $25 |
| GPT-5.6 Sol | Topo de gama STEM acessível | #4 ARC-AGI-2 (92,5 %); #5 LiveBench Reasoning (91,65), Mathematics 96,20 | FrontierMath ainda não publicado; METR sinalizou comportamento manipulador | $100/mês ChatGPT Pro; API $4 / $20 |
| GPT-6.1 Sol | Escolha de valor, raciocínio quase ao nível do Astra | #2 LiveBench Reasoning (92,63), #2 ARC-AGI-2 (94,2 %), #3 LiveBench Mathematics (96,83); Intelligence Index 51,8 a $0,72 por tarefa do índice | 52,7 % no ARC-AGI-3 contra 62,7 % do Astra; no ChatGPT Work e no Codex, não no Chat | $2 / $10 |
| Qwen 3.7 Max | Matemática de competição com orçamento apertado | 97,1 HMMT 2026 fev., 44,5 Apex, 200 pedidos grátis/dia | Apenas API | $1.25 / $3.75 promo; $2.50 / $7.50 tabela |
| Claude Fable 5 | Matemática dentro de um fluxo de programação | #3 na subcategoria de matemática da Arena (1522), atrás do Gemini 4 Argon e do Claude Opus 5; 96,0 LiveBench Mathematics | A opção mais cara aqui | $10 / $50 |
| GLM 5.3 Flash | Resolução de problemas open-weight | Intelligence Index 41,8 sob MIT, quase oito pontos acima do GLM-5.2 com menos de metade do tamanho; 320B/18B ativos, contexto 1M | Exige um servidor multi-GPU, não uma estação de trabalho; o GLM 5.3 pontua mais alto segundo os números da própria Z.ai e é transferível desde 28 de agosto, mas com mais do dobro do tamanho e sob uma licença própria | Open weights (MIT) |
O GPT-6 Astra mantém a coroa da resolução de problemas, por menos de um ponto. A ARC Prize avaliou entretanto o GPT-6.1 Sol, que faz 94,2 % no ARC-AGI-2, segundo atrás dos 95 % do Astra e à frente dos 93,3 % do Claude Opus 5.5, por menos de um quarto do custo por tarefa do Astra. Juntamente com os seus 92,63 no LiveBench Reasoning, a 0,02 do Astra, isso faz do GPT-6.1 Sol quase um colíder, mas o Astra continua a liderar os dois quadros e o ARC-AGI-3, pelo que a coroa não muda de mãos. O GPT-5.6 Sol desce para quarto no ARC-AGI-2. O Gemini 4 Argon, anunciado a 30 de setembro, lidera a categoria de matemática da Arena com algumas centenas de votos mas ainda não tem pontuação do LiveBench nem da ARC Prize, e o Claude Fable 5, que liderava essa categoria da Arena, é agora terceiro. Em setembro, o Astra tirou esta coroa ao GPT-5.6 Sol depois do seu lançamento a 3 de setembro, e o LiveBench Mathematics passou para o Claude Opus 5.5.
Melhor agente de IA
O melhor agente de IA é o Gemini Spark se quiser o agente na cloud e o Claude Cowork se o quiser no seu computador.
São escolhas conjuntas e não um primeiro e um segundo: o Spark corre numa VM da Google Cloud, pelo que continua a trabalhar com o portátil fechado, ligado ao Gmail, ao Docs e, desde o início de setembro, ao Google Fotos; o Cowork corre no seu Mac ou Windows e comanda as suas aplicações locais e o seu ecrã. O Spark já não é o único agente que continua a trabalhar na cloud.
O Grok Bot da SpaceXAI (11 de agosto) dá a cada conta um computador persistente na cloud que inicia sessão nas suas aplicações, a partir de um plano Cursor Pro de $20/mês; o Muse da Meta (8 de setembro) trata de tarefas a partir de uma VM própria na cloud e é grátis até 100 milhões de tokens por semana; e os OpenAI dots (29 de setembro) funcionam com o GPT-6 Astra, com computador e navegador próprios na cloud, a partir do plano Pro de $100/mês, que não os inclui no EEE, no Reino Unido nem na Suíça. Nenhum quadro independente mede estes produtos uns contra os outros, pelo que a escolha é sobre onde o trabalho tem de acontecer e não sobre quem pontua mais.
O preço também já não desempata: o Spark chega agora ao nível Google AI Pro de $19.99/mês nos EUA e em mais de 160 outros países, e o Cowork está incluído sem custo adicional em todos os planos pagos do Claude a partir de $20/mês. O ChatGPT Codex Mobile (14 de maio) é a alternativa para trabalho de agente de programação. Leia a comparação completa entre Gemini Spark e Claude Cowork.
| Agente | Melhor para | Onde funciona | Ponto forte | Preço |
|---|---|---|---|---|
| Gemini Spark | Tarefas na cloud 24/7, fluxos do Workspace | VM da Google Cloud (sempre ativa) | Sempre ativo, integração profunda com o Workspace | Desde $19.99/mês Google AI Pro |
| Claude Cowork | Ambiente de trabalho, condução de aplicações, design + código | O seu ambiente de trabalho Mac/Windows | Conduz aplicações locais, vê o seu ecrã | $20/mês Claude Pro |
| ChatGPT Codex Mobile | Agente de programação no telemóvel | Cloud da OpenAI + iOS/Android | Aprovar diffs e reencaminhar o trabalho a partir do telemóvel | Incluído nos planos ChatGPT |
| Grok Bot | Tarefas de navegador nas aplicações com sessão iniciada | Um computador persistente na cloud da SpaceXAI partilhado por todos os seus Bots | Inicia sessão nas aplicações com as suas próprias credenciais e continua com o portátil fechado | Desde $20/mês Cursor Pro, ou um plano SuperGrok associado |
| OpenAI dots | Responsabilidades contínuas, não tarefas soltas | Computador e navegador na cloud da OpenAI | Funciona com o GPT-6 Astra; continua a trabalhar com o computador desligado; disponível no ChatGPT, no Slack e por voz | Desde $100/mês ChatGPT Pro (fora do EEE/RU/CH); Business Premium |
| Meta Muse | Tarefas pessoais grátis | Uma Muse Secure VM na cloud da Meta | Grátis até 100M de tokens por semana; um agente Sentinel separado aprova o que envia | Grátis; Power $20/mês, Maximum $100/mês |
O Gemini Spark (na nuvem) e o Claude Cowork (no computador) continuam a ser a escolha conjunta, porque esta categoria premeia produtos e desde a última atualização não saiu nenhum produto de agentes novo. Mexeu-se a camada dos modelos. O Claude Sonnet 5.5 entrou em terceiro na Agent Arena, atrás do Claude Fable 5.1, que continua a liderá-la com 17,6 % de sucesso confirmado, e do Claude Opus 5.5, e tomou a liderança do AA-Briefcase v1.1 da Artificial Analysis com 1823, com o Opus 5.5 em segundo com 1807. O Opus 5.5 continua a liderar o GDPval-AA v2.1 com 1866, com o novo Muse Wonder Full da Meta em segundo com 1857 e o Sonnet 5.5 em terceiro com 1838. O Gemini 4 Argon, anunciado a 30 de setembro, lidera o AutomationBench da Artificial Analysis com 77,5 % e tem uma taxa de sucesso confirmado de 15,4 % na Agent Arena, acima dos 14,1 % do Opus 5.5, mas está em décimo na classificação geral e desde 13 de outubro está na API paga e na aplicação Gemini com o Google AI Pro.
Entre os modelos abertos da Agent Arena, o Kimi K3 é agora o mais bem colocado, em décimo quarto, à frente do DeepSeek V4.1-Flash, em décimo sétimo, e do Hy4 Preview da Tencent, em décimo nono. Em setembro, o Grok Bot, o Muse da Meta e o OpenAI dots juntaram-se ao Gemini Spark como agentes na nuvem sempre ativos, e o Spark chegou ao plano Google AI Pro de $19,99 por mês.
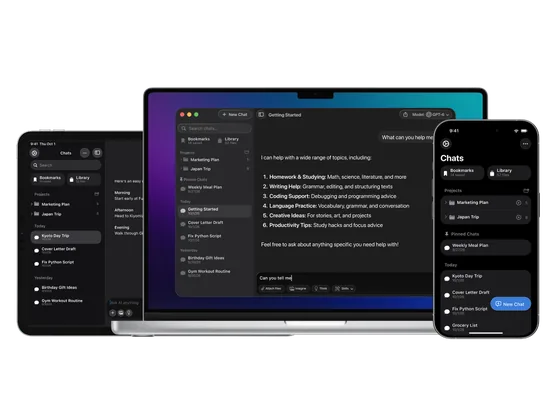
Prima ⌥ Space no seu Mac, pergunte e continue a trabalhar. Também no iPhone e iPad.
Grátis para começar, 4,7★ em mais de 27 000 críticas.
Descarregar Fello AIMelhor IA para estudar
A melhor IA para estudantes é o GPT-6 Luna dentro do ChatGPT para o trabalho de curso geral e o Gemini 3.6 Flash para STEM e estudo multimodal, com o Qwen 3.7 Max como alternativa por API para os exercícios mais difíceis (200 pedidos grátis por dia) e o Claude Sonnet 5.5 como alternativa gratuita para rever ensaios.
A maioria dos estudantes não precisa de pagar. Desde 8 de outubro, o ChatGPT Free e Go estão a passar do GPT-5.6 Luna para o GPT-6 Luna, a que a Artificial Analysis dá 38,1 no seu índice contra 37,3; o plano gratuito tem conversas de texto ilimitadas, embora o envio de ficheiros e as ferramentas de imagem continuem limitados. O Claude Sonnet 5.5 é grátis no claude.ai, onde as contas gratuitas também podem escolher o Claude Haiku 5.5 (7 de outubro), o modelo Claude que menos gasta do seu limite de utilização.
O Gemini mudou a 9 de outubro: a aplicação Gemini gratuita funciona agora no modo Auto, que envia a maioria dos prompts para o Flash-Lite, pelo que escolher o Gemini 3.6 Flash por si exige o Google AI Plus, embora continue grátis no Google AI Studio. Para resolver passo a passo a matemática mais difícil, o GPT-6 Astra reporta 97,6 % no FrontierMath Tier 4 v2, mas não está no plano gratuito do ChatGPT; o Qwen 3.7 Max é a alternativa económica com 97,1 no HMMT de fevereiro de 2026 e preço de API de $1,25 / $3,75 na promoção atual de 50 % ($2,50 / $7,50 de tabela).
| Tarefa | Melhor modelo | Porquê | Grátis? | Alternativa |
|---|---|---|---|---|
| Ensaios & trabalho de curso | GPT-6 Luna | O modelo do ChatGPT Free e Go, em implementação desde 8 de outubro; conversas de texto ilimitadas | Sim | Claude Sonnet 5.5 (Claude grátis) |
| Resolução de problemas STEM | GPT-6 Sol / Qwen 3.7 Max | Predefinição paga do ChatGPT; o Astra reporta 97,6 % no FrontierMath Tier 4 v2 / 97,1 HMMT fev 2026 | Plus pago / Qwen API pago | Gemini 3.6 Flash (AI Plus desde 9 out.) |
| Investigação & precisão | Gemini 3.1 Pro | 98 % ARC-AGI-1 a $0.52/tarefa, ancoragem nativa na Pesquisa Google | AI Pro (aplicação Gemini) desde 9 out. | Claude Opus 5 |
| Revisão de escrita | Claude Sonnet 5.5 | Grátis em claude.ai desde 28 de setembro e atrás apenas do Opus 5.5 no Intelligence Index; o Claude Fable 5.1 é o líder em qualidade | Sim (Claude grátis) | Claude Fable 5.1 |
| Estudo multimodal (PDFs, slides, imagens) | Gemini 3.6 Flash | Contexto 1M via AI Studio; a aplicação Gemini exige AI Plus desde 9 out. | Grátis no AI Studio | NotebookLM (Google) |
Duas mudanças para estudantes. O modelo gratuito do ChatGPT passa do GPT-5.6 Luna para o GPT-6 Luna, em implementação no Free e Go desde 8 de outubro, pelo que o GPT-6 Luna fica com a linha dos ensaios. E desde 9 de outubro a aplicação Gemini gratuita funciona no modo Auto, que envia a maioria dos prompts para o Flash-Lite, pelo que escolher o Gemini 3.6 Flash na aplicação exige o Google AI Plus.
A Anthropic também lançou o Claude Haiku 5.5 a 7 de outubro, que as contas Claude gratuitas podem escolher, e o Claude Sonnet 5.5 continua grátis no claude.ai. O Gemini 4 Argon, público desde 13 de outubro, vem com o Google AI Pro, pelo que os estudantes nos EUA com o ano grátis de AI Pro da Google o têm, mas não o plano gratuito nem a oferta Google AI Plus para estudantes noutros países. Em setembro, o Claude Sonnet 5.5 substituiu o Sonnet 5 como escolha gratuita para escrever e rever.
Melhor IA para o trabalho & profissionais
A melhor IA para o trabalho profissional é o GPT-6 (predefinição do ChatGPT desde 7 de outubro, Sol nos planos pagos) para o trabalho de conhecimento diário, o Claude Opus 5.5 para programar e escrever quando muito está em jogo, e o Gemini Spark para fluxos agênticos 24/7.
A maioria dos profissionais tira o máximo partido de duas subscrições pagas (ChatGPT Plus a $20/mês mais Claude Pro a $20/mês, um total de $40/mês). Ou de uma só fatura: o Fello AI cobre o ChatGPT, o Claude e o Gemini para o trabalho diário. Para o trabalho agêntico que continua enquanto dorme, o Gemini Spark é o agente na nuvem sempre ativo que vive dentro do Google Workspace, e desde 30 de julho chega ao plano Google AI Pro de $19,99/mês, além do Google AI Ultra; os OpenAI dots, o Grok Bot e o Muse da Meta são as alternativas, apresentadas na secção de agentes.
| Caso de utilização | Melhor modelo | Dado-chave | Preço | Alternativa |
|---|---|---|---|---|
| Trabalho de conhecimento diário | GPT-6 | Predefinição do ChatGPT desde 7 de outubro; GPT-6 Sol no Plus | $20/mês ChatGPT Plus | Claude Opus 5.5 |
| Pesquisa jurídica, financeira e fiscal | Gemini 4 Argon | #1 Vals Index (68,9 %) e #1 AutomationBench-AA (77,5 %) | $19.99/mês Google AI Pro | Claude Opus 5.5 |
| ChatGPT Work e Codex | GPT-6.1 Sol | No ChatGPT Work e no Codex para Plus, Pro, Business, Enterprise e Edu desde 29 de setembro, a $2 / $10 na API | $20/mês ChatGPT Plus | GPT-6 Luna para trabalho de volume |
| Programação (proprietária) | Claude Opus 5.5 | #1 Arena WebDev (1813) e #1 Intelligence Index (57,6), a $4 / $20 | $20 por mês Claude Pro | Claude Sonnet 5.5, que lidera o Terminal-Bench 4.0 a metade do preço por token |
| Programação (económica) | Claude Sonnet 5.5 | #1 Terminal-Bench 4.0 (63,6 %) e #1 LiveBench Coding (91,4); $0,88 por tarefa do índice com esforço high | $2 / $10 | Qwen3.8-Max-0902; DeepSeek V4.1-Flash |
| Investigação & briefings | Gemini 3.1 Pro | 98 % ARC-AGI-1 a $0.52/tarefa, ancoragem Google | Google AI Pro / Ultra | Claude Opus 5.5 |
| Matemática difícil, física, modelação financeira | GPT-6 Astra | #1 LiveBench Reasoning e ARC-AGI-2 (95 %); reporta 97,6 % no FrontierMath Tier 4 v2 | $100/mês ChatGPT Pro | GPT-6.1 Sol; Qwen 3.7 Max |
| Fluxos de agente sempre ativos | Gemini Spark | Agente na cloud 24/7 dentro do Google Workspace | Desde $19.99/mês Google AI Pro | Claude Cowork |
| Notícias em direto, criativo com contexto do X | Grok 4.7 | Intelligence Index 46,3 + ancoragem nativa no X; na aplicação Grok desde 3 de outubro | $30 por mês SuperGrok | Gemini 3.1 Pro |
| Consolidação tudo-em-um | Fello AI | ChatGPT + Claude + Gemini + Grok + DeepSeek | Desde $11.99/mês | Pagar a cada fornecedor em separado |
A linha do trabalho de conhecimento diário passa do GPT-5.6 para o GPT-6, que se tornou a predefinição do ChatGPT a 7 de outubro. O Gemini 4 Argon fica com uma nova linha para trabalho jurídico, financeiro e fiscal: lidera o Vals Index desse trabalho e o AutomationBench da Artificial Analysis, e desde 13 de outubro está na aplicação Gemini com o Google AI Pro a $19.99 por mês. Em setembro, o Claude Opus 5.5 ficou com a linha de programação proprietária a um preço inferior ao do Opus 5, o Claude Sonnet 5.5 com a de programação económica e o GPT-6.1 Sol com a do ChatGPT Work e Codex a 29 de setembro.
Preços dos modelos de IA em outubro de 2026
De escalões gratuitos a $0 até ao Google AI Ultra a $199,99 por mês. O preço que mais conta neste quadro é o do Claude Opus 5.5, a $4 / $20. Desde 22 de setembro, o modelo com a pontuação mais alta que qualquer avaliador independente já mediu custa menos do que o Claude Opus 5 que substitui ($5 / $25), e as leituras de cache descem 60 % para $0,20. O Claude Fable 5.1 e o GPT-6 Astra estão ambos a $10 / $50 e ambos pontuam abaixo.
O tarifário mais concorrido é agora $2 / $10, partilhado pelo Claude Sonnet 5.5, pelo GPT-6 Sol e pelo GPT-6.1 Sol. O GPT-6.1 Sol é o caminho mais barato para uma pontuação entre os seis primeiros do Intelligence Index, a $0,72 por tarefa do índice. No Sonnet 5.5 é o nível de esforço que decide a conta: com esforço high uma tarefa do índice custa $0,88 e no máximo $5,46, agora um pouco menos do que os $5,98 do Opus 5.5, e a Anthropic reduziu para metade as leituras de cache, para $0,10, a 7 de outubro. O Gemini 4 Argon da Google também sai a um preço de lançamento de $2 / $10 ($4 / $20 no preço normal), até 30 de novembro, e desde 13 de outubro qualquer pessoa o pode comprar na API paga.
O preço por token e o custo por tarefa podem divergir. O Grok 4.7 custa $2 / $6, tal como o Grok 4.6, mas uma tarefa do índice custa $2,73 contra $1,86, porque o 4.7 emite cerca do dobro da saída. O Mistral Large 4 (em pré-visualização pública desde 6 de outubro) tem um preço de tabela de $1,36 / $4,18, embora a própria página do modelo na Mistral mostre metade, e é tão prolixo que uma tarefa do índice custa $1,13 para uma pontuação de 38,4. Na fronteira, a escolha por valor é o Muse Spark 1.3 da Meta, a $1,25 / $4,25, ou $1,60 por tarefa do índice com 48,1.
Na ponta barata, o GPT-6 Luna é o modelo mais barato por tarefa desta página: $0,10 / $0,50, ou $0,07 por tarefa do índice. O Claude Haiku 5.5 (7 de outubro) iguala esse preço por token em prompts até 100 000 tokens e faz 43,4 contra 38,1 do Luna, mas escreve tanto mais que uma tarefa do índice custa $0,21 no esforço máximo, ou $0,12 por 41,3 em xhigh; acima de 100 000 tokens sobe para $0,50 / $2,50. Entre os modelos abertos que se compram ao token, a escolha continua a ser o GLM 5.3 Flash a $0,15 / $0,50 ($0,25 por tarefa do índice com 41,8), à frente do DeepSeek V4.1-Flash a $0,15 / $0,60 fora de pico e $0,30 / $1,20 em pico ($0,27 com 39,5). O MiMo-V2.6-Pro da Xiaomi é ainda mais barato, $0,13 por tarefa do índice com 46,3, mas só se alojar os seus 1,02 biliões de parâmetros. Para uma análise mais aprofundada, veja o nosso guia completo de comparação de preços de IA.
| Modelo | Entrada (por 1M) | Saída (por 1M) | Contexto | Acesso grátis? |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | 1 050 000 (entrada máx. 922 000) | No Chat em Pro, Business e Enterprise desde 4 de setembro; o Plus tem-no no ChatGPT Work e no Codex, não no Chat; sem plano gratuito; ativo na API |
| GPT-6 Sol | $2.00 | $10.00 | 1 050 000 (entrada máx. 922 000) | Chat do ChatGPT em Plus, Pro, Business e Enterprise desde 7 de outubro; Work e Codex; API |
| GPT-6.1 Sol | $2.00 | $10.00 | 1 050 000 (entrada máx. 922 000) | ChatGPT Work e Codex em Plus, Pro, Business, Enterprise e Edu desde 29 de setembro; API; não no Chat; leituras de cache $0,10 |
| GPT-6 Luna | $0.10 | $0.50 | 1 050 000 (entrada máx. 922 000) | Chat do ChatGPT em Free e Go, em implementação desde 8 de outubro; Work e Codex nos planos pagos; API |
| GPT-5.5 | $5.00 | $30.00 | 1M (400K no Codex) | ChatGPT Free; API paga |
| GPT-5.5 Pro | $30.00 | $180.00 | 1M | ChatGPT Pro a partir de $100/mês (níveis de maior utilização a $200 e $500) |
| GPT-5.6 Sol | $4.00 | $20.00 | Não publicado | Em direto no ChatGPT, Codex & API (9 de julho); tarifa promocional pelo menos até 21 de novembro de 2026 |
| GPT-5.6 Terra | $2.00 | $12.00 | Não publicado | Em direto no ChatGPT, Codex & API (9 de julho) |
| GPT-5.6 Luna | $0.20 | $1.20 | Não publicado | Em direto no ChatGPT, Codex & API (9 de julho) |
| Claude Opus 5.5 | $4.00 | $20.00 | 1M | Claude Pro/Max/Team; API paga; leituras de cache $0,20 |
| Claude Opus 5 | $5.00 | $25.00 | 1M | Modelo legacy na Anthropic; Pro/Max/API |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Modelo legacy na Anthropic; Pro/Max/API |
| Claude Fable 5.1 | $10.00 | $50.00 | 1M | Leituras de cache $0.25; no Max/Team Premium (~50 % dos limites de utilização); Pro/Team Standard via créditos. O Mythos 5.1 fatura de forma idêntica, apenas por convite |
| Claude Fable 5 | $10.00 | $50.00 | 1M | Permanente no Max/Team Premium (~50 % dos limites de utilização); Pro/Team Standard via créditos |
| Claude Sonnet 5.5 | $2.00 | $10.00 | 1M | Grátis em claude.ai; Pro/Max/Team; API paga; leituras de cache $0,10 desde 7 de outubro |
| Claude Sonnet 5 | $2.00 | $10.00 | 1M | Modelo legacy desde 28 de setembro; recurso para pedidos de cibersegurança assinalados; API paga |
| Claude Sonnet 4.6 | $3.00 | $15.00 | 1M | API paga (substituído pelo Sonnet 5) |
| Claude Haiku 5.5 | $0.10 (≤100K) / $0.50 (>100K) | $0.50 (≤100K) / $2.50 (>100K) | 1M | Free, Pro, Max, Team e Enterprise em Claude.ai (web, iOS, Android); API paga; leituras de cache $0,01 |
| Gemini 3.1 Pro | $2.00 (≤200K) / $4.00 (>200K) | $12.00 (≤200K) / $18.00 (>200K) | 1M | Aplicação Gemini com Google AI Pro ou superior desde 9 out.; API paga |
| Gemini 4 Argon | $2.00 de lançamento até 30/11 / $4.00 normal ($0.10 em cache, lançamento) | $10.00 de lançamento / $20.00 normal | 1M, partilhado entre entrada e saída | API paga desde 13 de outubro; aplicação Gemini no Google AI Pro e no Ultra |
| Gemini 3.8 Flash | $0.75 introdutório / $1.50 a partir de 1/1/2027 | $3.75 introdutório / $7.50 a partir de 1/1/2027 | 1M | AI Studio, Antigravity, Gemini Enterprise + API paga; na aplicação Gemini reportado para AI Pro/Ultra |
| Gemini 3.7 Flash | $0.75 introdutório / $1.50 a partir de 1/1/2027 | $3.75 introdutório / $7.50 a partir de 1/1/2027 | 1M | AI Studio, Android Studio, Antigravity + API paga; na aplicação Gemini apenas via Spark (AI Pro/Ultra, exclui EEE/RU/CH/Nigéria) |
| Gemini 3.6 Flash | $0.75 introdutório / $1.50 a partir de 1/1/2027 | $3.75 introdutório / $7.50 a partir de 1/1/2027 | 1M | Aplicação Gemini com AI Plus ou superior desde 9 out.; AI Studio; nível API gratuito + API paga |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 1M | AI Studio; nível API gratuito + API paga |
| Qwen3.8-Max-0902 | $2.00 ($0.17 cache hit explícito, $0.25 implícito) | $6.00 | 1M (saída de 128K) | Apenas API na QwenCloud; sem chat de consumo; pesos abertos apenas na versão de texto Qwen3.8-2.4T-A95B em que se baseia |
| Qwen 3.7 Max | $1.25 promo / $2.50 tabela | $3.75 promo / $7.50 tabela | 1M | 200 pedidos grátis/dia; API paga para além disso |
| MiniMax M3 | $0.30 (50 % de desconto sobre $0.60) | $1.20 (≤512K) | 1M | Open weights; custos de alojamento aplicáveis |
| LongCat-2.0 | Depende do fornecedor | Depende do fornecedor | 1M | Open weights (MIT); custos de alojamento aplicáveis |
| NVIDIA Nemotron 3 Ultra | Depende do fornecedor | Depende do fornecedor | 1M | Open weights (OpenMDW); custos de alojamento aplicáveis |
| Qwen 3.5 (open-weight) | Auto-alojamento / Together | Auto-alojamento / Together | 1M | Open weights; custos de alojamento aplicáveis |
| Nex-N2-Pro | Auto-alojamento / fornecedores | Auto-alojamento / fornecedores | 1M | Open weights (Apache 2.0); custos de alojamento aplicáveis |
| Rio 3.5 Open 397B | Auto-alojamento / fornecedores | Auto-alojamento / fornecedores | 1M | Open weights (MIT); custos de alojamento aplicáveis |
| Grok 4.3 | $1.25 | $2.50 | 1M | Plano de consumo gratuito; API paga |
| Grok 4.6 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | API da SpaceXAI, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
| Grok 4.7 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | API da SpaceXAI, Cursor, Grok Build, harnesses e routers na nuvem; não na aplicação Grok |
| Muse Spark 1.3 | $1.25 ($0.10 nível Contributor) | $4.25 ($0.20 nível Contributor) | 1M | API paga; Muse Code, Meta Model API e OpenRouter; o nível Contributor troca direitos de treino por um desconto de ~92 % |
| Muse Wonder | $4.00 | $20.00 | 1M | API paga; Meta Model API, Muse Code e OpenRouter; o Muse Wonder Full só existe no Muse Code, nos planos de $50 e $200 |
| Kimi K3 | $3.00 ($0.30 cache-hit) | $15.00 | 1M | Nível básico gratuito na aplicação Kimi; open weights no Hugging Face (Kimi K3 License) |
| Mistral Large 4 | $1.36 ($0.68 na página do modelo da Mistral) | $4.18 ($2.09) | 512K (1M segundo a Mistral) | API em pré-visualização pública desde 6 de outubro; pesos abertos prometidos até ao fim de outubro, licença ainda por anunciar |
| Gemini Omni Flash (vídeo) | $1.50 | $17.50 (saída de vídeo) | Clips de 10 segundos | Aplicação Gemini / Flow; AI Studio + API |
| DeepSeek V4-Pro | $0.66 fora de ponta / $1.32 em ponta ($0.022 cache-hit fora de ponta) | $1.98 fora de ponta / $3.96 em ponta | 1M | DeepSeek Chat grátis; API paga, preços de ponta e fora de ponta desde 16 de agosto |
| DeepSeek V4.1-Flash | $0.15 fora de ponta / $0.30 em ponta ($0.003 acerto de cache fora de ponta) | $0.60 fora de ponta / $1.20 em ponta | 1M | DeepSeek Chat gratuito; API paga, tarifas fora de ponta e em ponta; substituiu o V4-Flash a 10 de setembro |
| Kimi K2.7 Code | Depende do fornecedor | Depende do fornecedor | 256K | Open weights; custos de alojamento aplicáveis |
| GLM-5.2 | Depende do fornecedor | Depende do fornecedor | 1M | Open weights; custos de alojamento aplicáveis |
| GLM 5.3 | $1.40 ($0.26 cache-hit) | $4.40 | 1M | API da Z.ai, GLM Coding Plan e ZCode; pesos no Hugging Face desde 28 de agosto sob a licença própria GLM 5.3 License |
| GLM 5.3 Flash | $0.15 ($0.03 cache-hit) | $0.50 | 1M | API da Z.ai, GLM Coding Plan, OpenRouter; pesos MIT no Hugging Face; a promoção de lançamento acabou a 9 de setembro |
| Tencent Hy4 Preview | $0.834 ($0.042 cache-hit) | $2.501 | 1M+ | Pesos abertos (Apache 2.0); Tencent Cloud TokenHub, OpenRouter, WorkBuddy, CodeBuddy |
| Qwen3.8-Flash-Next | Depende do fornecedor | Depende do fornecedor | 262K (até 1M) | Pesos abertos (Qwen Community License 1.0); acrescem custos de alojamento |
| MiMo-V2.6-Pro | $0.435 | $0.87 | 1M | Pesos abertos (MIT); os custos de alojamento aplicam-se |
| ERNIE 5.1 | Preço para a região China | Preço para a região China | 256K | Nível gratuito da Baidu |
| Gemini Spark (agente) | Sem preço de API | Sem preço de API | 1M (base Gemini) | Google AI Pro $19.99, AI Ultra $99.99 ou $199.99/mês |
| Fello AI (agregador) | Encaminhado pela aplicação | Encaminhado pela aplicação | Depende do modelo | Desde $11.99/mês, versão gratuita disponível |
As tarifas do GPT-5.5 e GPT-5.5 Pro acima são preços de contexto curto; a OpenAI já não publica os números específicos de contexto longo. Os níveis GPT-5.6 são faturados a 2x a entrada e 1,5x a saída assim que um prompt ultrapassa os 272K tokens de entrada, o que coloca o Terra de contexto longo em $4 / $18 e o Luna em $0.40 / $1.80. Os níveis GPT-6 têm a mesma sobretaxa acima de 272K tokens de entrada, aplicada a todo o pedido, e as suas leituras de cache ficam 90 % mais baratas: $1.00 no Astra, $0.20 no GPT-6 Sol e $0.01 no Luna, com o GPT-6.1 Sol 95 % mais barato, a $0.10.
O Grok 4.6 funciona da mesma forma, mas morde com mais força: a partir de 200 000 tokens de prompt, a SpaceXAI volta a faturar o pedido inteiro à taxa mais alta em vez de apenas o excedente, pelo que ultrapassar o limite por mil tokens duplica o custo de toda a chamada. A outra tabela que convém ler duas vezes é a da DeepSeek: desde 16 de agosto, os seus dois modelos V4 são faturados ao preço de ponta das 01:00 às 04:00 e das 06:00 às 10:00 UTC nos dias úteis, e a exatamente metade em qualquer outra hora, pelo que a mesma tarefa pode custar o dobro consoante a hora a que a executar.
A forma mais barata de percorrer esta tabela é muitas vezes uma subscrição em vez de três. O Fello AI reúne GPT, Claude, Gemini, Grok, Perplexity e mais numa única aplicação para Mac, iPhone e iPad, desde $11,99 por mês na maioria dos países.
Melhores modelos open-weight em outubro de 2026
O melhor modelo de pesos abertos em outubro de 2026 é o MiMo-V2.6-Pro da Xiaomi, publicado a 21 de setembro sob MIT simples: 1,02 biliões de parâmetros com 42 mil milhões ativos e contexto de 1M de tokens. A Artificial Analysis mede-o em 46,3 no Intelligence Index v4.3.2, a maior pontuação aberta que alguma vez publicou, à frente do GLM-5.3 com 44,8 e do Kimi K3 com 43,6, e a apenas $0,13 por tarefa do índice. O senão: os votantes humanos da Arena só o colocam em 19.º no WebDev e em 26.º no texto.
Dois outros modelos abertos ainda lideram em algo. O Kimi K3 é o modelo aberto mais bem colocado na Arena, décimo quarto no WebDev e décimo quarto na Agent Arena. O GLM-5.3 é o modelo aberto mais forte no Terminal-Bench 4.0, com 41,9 %, embora sob uma licença própria da Z.ai e não MIT.
Para equipas que alojam os seus próprios pesos, a escolha prática continua a ser o GLM 5.3 Flash (Z.ai, MIT): 41,8 na v4.3.2 com 320 mil milhões no total e 18 mil milhões ativos. Não é um GLM 5.3 reduzido mas um modelo separado sobre uma base treinada de novo, e é por isso que sai sob MIT. Um modelo de 1,02 biliões de parâmetros não é coisa para uma estação de trabalho, e só o descarregamento do K3 ocupa cerca de 1,56 TB. No patamar mais barato, o DeepSeek-V4.1-Flash substituiu o V4-Flash a 10 de setembro: MIT, nativamente multimodal, 39,5 na v4.3.2 e $0,15 / $0,60 fora de pico.
Há mais três a acompanhar. O Mistral Large 4 (em pré-visualização pública desde 6 de outubro) é o modelo com a pontuação mais alta dos EUA ou da Europa que promete pesos abertos, com 38,4, mas ainda não o pode descarregar: a Mistral promete os pesos até ao fim de outubro e não indicou a licença. O Qwen3.8-Flash-Next da Alibaba, de 125 mil milhões com apenas 6 mil milhões ativos, antecipa a arquitetura Qwen4 e pontua 39,8. O Hy4 Preview da Tencent, 770 mil milhões no total e 49 mil milhões ativos sob Apache 2.0, não tem avaliação da Artificial Analysis mas está em 18.º no Arena WebDev.
| Modelo | Melhor para | Benchmark-chave | Contexto / Licença | Onde executar |
|---|---|---|---|---|
| MiMo-V2.6-Pro | O maior Intelligence Index aberto alguma vez medido | II 46,3 (v4.3.2), acima do GLM-5.3 e do Kimi K3, a $0,13 por tarefa do índice; 34,8 % Terminal-Bench 4.0; GDPval-AA v2.1 1685; 1,02 biliões/42 mil milhões ativos | 1M / MIT | Hugging Face (XiaomiMiMo), fornecedores, alojamento próprio |
| Kimi K3 | Modelo aberto mais bem colocado na Arena | II 43,6 (v4.3.2); #14 Arena WebDev, a melhor posição aberta; #14 Agent Arena; 2.8T/104B ativos | 1M / Kimi K3 License | Hugging Face (96 shards, 1.56 TB), Moonshot API, fornecedores |
| GLM 5.3 Flash | Melhor modelo aberto que a maioria das equipas consegue mesmo executar | II 41,8 (v4.3.2), na fronteira de Pareto entre inteligência e custo, a cerca de $0.25 por tarefa do índice; 320B/18B ativos, nativamente multimodal | 1M / MIT | Hugging Face, API da Z.ai ($0.15/$0.50), OpenRouter |
| GLM-5.2 | Recurso com historial independente | II 33,7 (v4.3.2); #27 Arena WebDev (1,603.2), #20 Agent Arena; 744B/40B ativos | 1M / MIT | Z.ai, Hugging Face, OpenRouter |
| GLM 5.3 | Aberto desde 28 de agosto, mas com licença própria | II 44,8 (v4.3.2), a pontuação aberta mais alta que encontrámos; mesma base de 744B do GLM-5.2, apenas pós-treinada, checkpoint publicado contado em 753B; CyberGym 84,5 % e Terminal-Bench 3.0 28,3 (números do fabricante) | 1M / GLM 5.3 License (model-as-a-service acima de 10 mil milhões USD de receita precisa de revisão de segurança da Z.ai) | Hugging Face, API da Z.ai ($1.40/$4.40), GLM Coding Plan, ZCode |
| DeepSeek V4.1-Flash | Melhor relação qualidade-preço aberta se o alojar por conta própria | II 39,5 (v4.3.2) contra 34,3 da versão V4-Flash 0731 que substitui; 552B, 8B ativos no prefill e 16B na descodificação | 1M / MIT | DeepSeek API ($0.15/$0.60 fora de ponta, $0.30/$1.20 em ponta desde 10 de setembro), local |
| Tencent Hy4 Preview | Maior modelo com licença permissiva até agora | 770B/49B ativos; 2,99/4,00 no painel próprio da Tencent com 203 tarefas contra 2,94 do Kimi K3 e 2,92 do GLM 5.3 (fabricante); sem classificação da Artificial Analysis; #18 Arena WebDev (1632), #19 Agent Arena | 1M+ / Apache 2.0 | Hugging Face (BF16 e FP8), Tencent Cloud TokenHub, OpenRouter |
| Qwen3.8-Flash-Next | Antevisão da arquitetura Qwen4 | 125B no total mais um embedding de N-gramas de 51B, 6B ativos; 91,7 GPQA Diamond e 62,5 SWE-Bench Pro (fabricante); II 39,8 (v4.3.2); #17 Arena WebDev (1633) | 262K a 1M / Qwen Community License 1.0 | Hugging Face, fornecedores, auto-alojamento |
| LongCat-2.0 | Programador aberto frontier treinado em chips chineses | II 33 (v4.1); 59,5 % SWE-Bench Pro (fornecedor), 1.6T/~48B ativos | 1M / MIT | Hugging Face, GitHub, OpenRouter |
| MiniMax M3 | Multimodal barato de contexto longo | II 29,2 (v4.3.2; 44 na v4.1), 59 % SWE-Bench Pro, multimodal | 1M / MiniMax Community License | Hugging Face, API $0.30/1M (50 % de desconto) |
| Nex-N2-Pro | Pontuação de programação aberta mais forte | II 41 (v4.1); 80,8 SWE-Bench Verified, 397B/17B ativos | Baseado em Qwen / Apache 2.0 | Hugging Face, fornecedores, auto-alojamento |
| Kimi K2.7 Code | Programador aberto com licença comercial mais forte | +21,8 % no Kimi Code Bench v2 vs K2.6 (fornecedor); 1T/32B ativos | 256K / Modified MIT | Hugging Face, DeepInfra, fornecedores |
| DeepSeek V4-Pro | Trabalho agêntico em condições reais | II 44 (v4.1), 1.6T/49B ativos | 1M / MIT | DeepSeek API ($0.66/$1.98 fora de pico, $1.32/$3.96 em pico desde 16 de agosto), local |
| Hy3 | O mais recente participante com licença permissiva | II 41 (v4.1); #56 na Arena WebDev (1,508.4) | Apache 2.0 | Hugging Face, fornecedores, auto-alojamento |
| Inkling | Primeiro modelo open-weight da Thinking Machines | II 41 (v4.1), agêntico 32,3, lançado a 15 de julho | Open weights | Hugging Face, fornecedores, auto-alojamento |
| Inkling Small | Mesma família a um quarto do tamanho | II 40 (v4.1), agêntico 30,8; 276B/12B ativos, entrada de texto, imagem e áudio | Apache 2.0 | Hugging Face (BF16 e NVFP4), fornecedores, auto-alojamento |
| NVIDIA Nemotron 3 Ultra | Afinado pela NVIDIA, licença totalmente permissiva | II 38 (v4.1), 65-70,4 SWE-Bench Verified, 550B/55B ativos | 1M / OpenMDW | OpenRouter, Hugging Face, AWS (8x B200 auto-alojamento) |
| Qwen 3.5 (397B / 17B ativos) | Multimodal, descodificação rápida | 88,4 GPQA, 91,3 AIME 2026, 83,6 LiveCodeBench v6 | 1M / aberto | Together, OpenRouter, local |
| Qwen3.6-35B-A3B | Programador agêntico aberto eficiente (3B ativos) | 86,0 GPQA Diamond, 92,7 AIME 2026, 35B/3B ativos | 262K (até 1M YaRN) / Apache 2.0 | Hugging Face, OpenRouter, local |
| Qwen3.6-27B | Programador denso executável em portátil | 87,8 GPQA Diamond, denso 27B, multimodal | 256K / Apache 2.0 | Local Mac/PC, Hugging Face, OpenRouter |
| Rio 3.5 Open 397B | Fine-tune de Qwen 3.5, raciocínio multilíngue | 70,8 Terminal-Bench 2.1 (first-party), bate o Qwen 3.7 Plus em 4/5 | 397B/17B ativos / MIT | Hugging Face, fornecedores, auto-alojamento |
| Llama 4 Maverick | Modelo de topo da linha Meta | 17B ativos / 400B de parâmetros no total | Llama 4 license | Cloud da Meta, Hugging Face, local |
| NVIDIA Nemotron 3 Nano Omni | Edge / baixo consumo | Multimodal, pegada muito reduzida | Compacto / aberto | Local, ferramenta NVIDIA |
Aqui a licença importa tanto como a pontuação bruta, e agosto alargou a distância entre os dois grupos. Kimi K2.7 (Modified MIT), DeepSeek V4 (MIT), GLM 5.3 Flash (MIT), MiMo-V2.6-Pro (MIT), GLM-5.2 (MIT), LongCat-2.0 (MIT), Hy3 (Apache 2.0), Hy4 Preview (Apache 2.0), Nex-N2-Pro (Apache 2.0) e Nemotron 3 Ultra (OpenMDW) permitem todos claramente a utilização comercial sem qualquer teste de receita.
Os restantes trazem condições que convém ler antes de construir sobre eles: o MiniMax M3 e o MiniMax H3 chegam sob as suas próprias licenças comunitárias, exigindo o H3 ainda um pedido a partir dos EUA, da UE, do Reino Unido e da Coreia do Sul; o Kimi K3 assenta numa licença própria com um limiar de receita para quem o revenda como serviço; o GLM 5.3 exige uma revisão de segurança da Z.ai a qualquer operador de model-as-a-service acima de 10 mil milhões de dólares de receita; e a Qwen Community License 1.0 do Qwen3.8-Flash-Next exige uma licença à parte da Qwen para explorar um negócio de model-as-a-service ou de assistente de trabalho com IA, embora o uso interno esteja isento. Nenhum modelo open-weight é já o primeiro em qualquer quadro da Arena que seguimos: o Claude Opus 5 arrebatou o quadro Agent em julho, o último que um modelo open-weight liderou.
Benchmarks, preços e utilização prática
Cada classificação desta página combina três entradas: benchmarks públicos de sete casas independentes (Artificial Analysis, Arena antiga LMArena, Scale SEAL, LiveBench, EQ-Bench, ARC Prize e o quadro oficial Terminal-Bench 4.0, cobrindo o Intelligence Index, GPQA Diamond, ARC-AGI-1 a 3, Humanity's Last Exam, GDPval-AA, FrontierMath, HMMT, MCP Atlas, SWE Atlas e o Remote Labor Index), preços de API e subscrição publicados na página de preços oficial de cada fornecedor, e utilização prática pela equipa editorial da FelloAI que executa prompts reais sobre a mesma tarefa em cada modelo. Voltamos a obter as fontes oficiais de preços e benchmarks antes de cada atualização mensal.
Os benchmarks são ponderados consoante o caso de utilização: o SWE-bench e o Terminal-Bench impulsionam a programação, o GPQA Diamond e o ARC-AGI-2 impulsionam a precisão, o GDPval-AA (o benchmark de entregáveis profissionais da Artificial Analysis) informa a qualidade das tarefas profissionais ao passo que o estilo de escrita é avaliado sobretudo por testes práticos, o FrontierMath e o HMMT impulsionam a resolução de problemas. Revelamos quando um benchmark é reportado pelo fornecedor mas não verificado de forma independente, e descartamos qualquer afirmação que não conseguimos reproduzir contra uma fonte em direto. Classificamos por pontuações medidas: a coroa de uma categoria muda assim que um modelo supera o detentor nos quadros que definem essa categoria, sem esperar pelos quadros baseados em votos, e um modelo que ainda não está amplamente disponível é assinalado no seu cartão em vez de ficar sem ele. Reverificamos as posições tanto como os números, porque uma pontuação pode continuar correta enquanto o quadro à sua volta se move. Quando um modelo passa por uma atualização importante entre atualizações, reclassificamos a categoria e acrescentamos uma linha «O que mudou este mês» no fundo da análise aprofundada.
Pergunte ao ChatGPT, ao Claude e ao Gemini e fique com a melhor resposta. Sem três faturas.
O Fello AI funciona no Mac, iPhone e iPad, grátis para começar.
Descarregar Fello AI