Nejlepší umělá inteligence 2026: žebříček AI modelů
Žebříček a srovnání AI modelů podle použití, každý měsíc aktualizované, jakmile vyjdou nové modely.
- Nejchytřejší celkově a na programováníClaude Opus 5.5
- Nejnáročnější uvažováníGPT-6 Astra
- ObrázkyChatGPT Images 2.5
- Nejlepší volba zdarmaClaude Sonnet 5.5

Konec přeskakování mezi AI aplikacemi
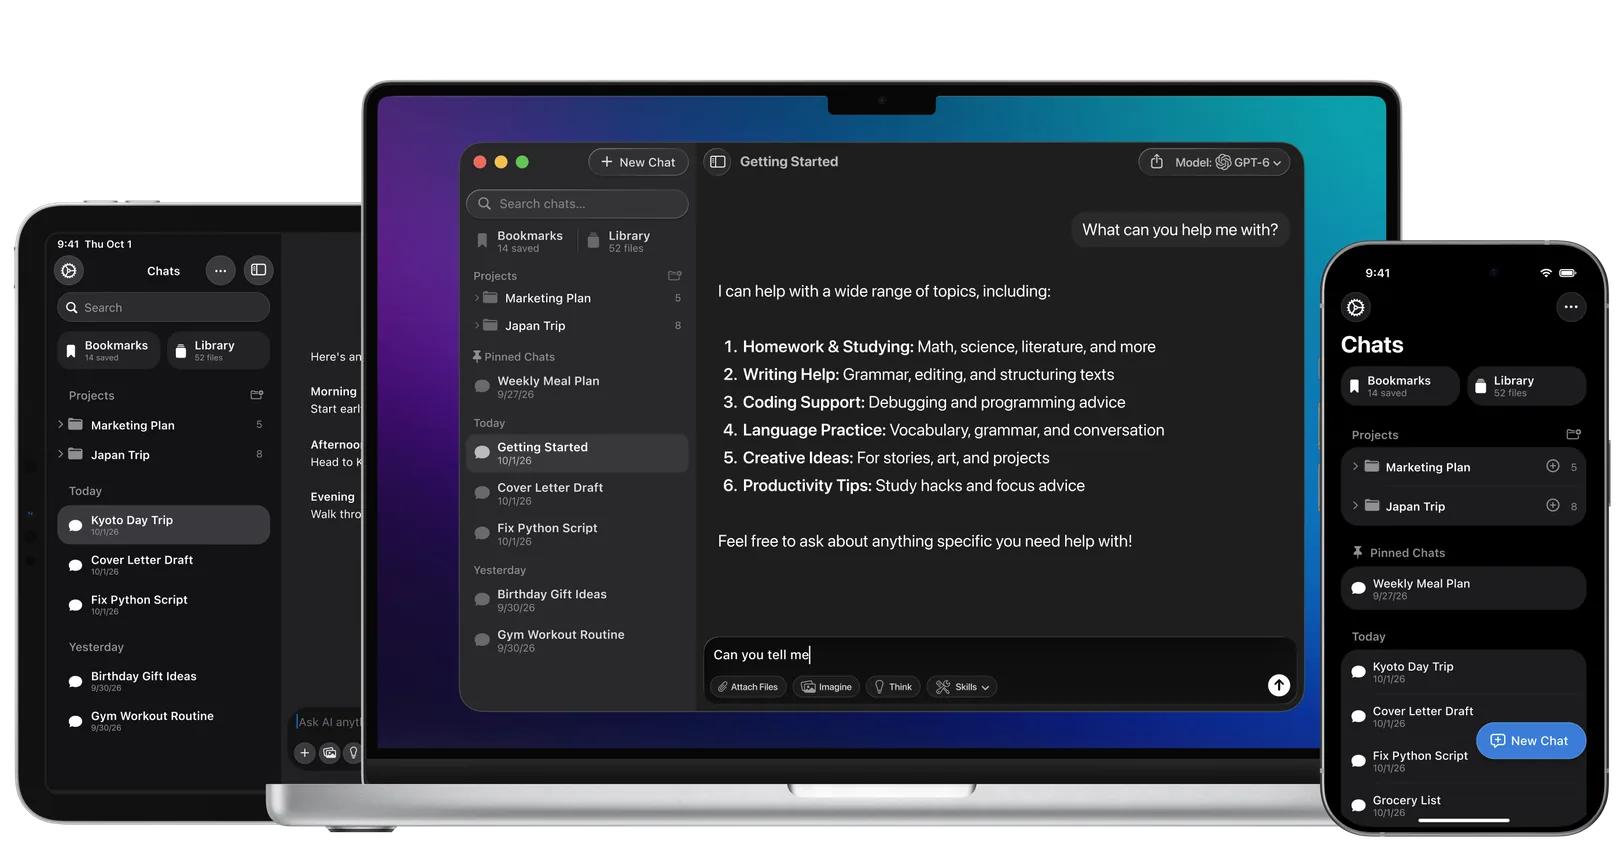
Chat, vyhledávání, PDF i obrázky v jedné aplikaci pro Mac, iPhone a iPad.
Začněte zdarma·4,7★ z 27 000+ recenzí
Žebříčky ukazují, kdo vyhrává v průměru. Váš prompt průměrný není. Zeptejte se ChatGPT, Claude i Gemini v jednom okně a nechte si nejlepší odpověď.
Stáhnout Fello AIDo listopadu vstupuje Anthropic s většinou naměřených korun. Na Intelligence Indexu v5 od Artificial Analysis (27. října) má Claude Opus 5.5 59,1 a vede všechny modely, které můžete skutečně používat, před GPT-6 Astra s 56,9, GPT-6.1 Sol s 54,6 a Claude Sonnet 5.5 s 54,5, který je zdarma na claude.ai. Jak je tento index sestavený, vysvětluje náš průvodce AI benchmarky.
Gemini 4 Carbon od Googlu má ještě víc, 60,0, a během prvních dnů v Areně se dostal rovnou na první místo v textu a na čtvrté ve WebDev. Smějí ho ale používat jen prověření kybernetičtí obránci, takže tu žádnou korunu nezískává, stejně jako ji Gemini 4 Argon nezískal před veřejným vydáním. Argon, otevřený pro Google AI Pro a Ultra od 13. října, je nejvýše postaveným modelem v textovém žebříčku Areny, který můžete používat, a drží druhé místo na stupních vítězů v chatu. U obrázků teď Nano Banana 2.1 od Googlu poráží Grok Imagine Image 2.0 na třech ze čtyř sledovaných žebříčků a bere třetí místo.
Mezi otevřenými modely zveřejnil Moonshot 2. listopadu open weights modelu Kimi K3.1 Pro, který s 46,5 na indexu teď vede o 13,9 bodu. DeepSeek V4.1-Flash-1017 zůstává otevřenou volbou s nejlepším poměrem s 32,6, MiMo-V2.6-Pro od Xiaomi zůstává nejlevnější na úlohu a Mistral Large 4, otevřený od 29. října, je s 26,1 osmý. Video patří MiniMax H3 a obrázky ChatGPT Images 2.5. Pořadí aktualizujeme do 48 hodin od každého velkého vydání.
2. lis. Moonshot Moonshot zveřejnil váhy modelu Kimi K3.1 Pro, teď nejlépe hodnoceného otevřeného modelu o 13,9 bodu Nové
29. říj. Mistral Mistral zveřejnil open weights modelu Mistral Large 4 a snížil jeho cenu na polovinu, mezi otevřenými modely je ale až sedmý Nové
28. říj. Google Gemini 4 Carbon vede Intelligence Index v5 s 59,4, používat ho ale smějí jen kybernetičtí obránci Nové
27. říj. Artificial Analysis Artificial Analysis spouští Intelligence Index v5, který přeškáluje každé skóre na této stránce Nové
26. říj. OpenAI GPT-6.1 Terra má 51,0 za poloviční cenu GPT-6.1 Sol, v ChatGPT Work a Codexu Nové
23. říj. Moonshot Kimi K3.1 Pro je čtvrtý na Intelligence Indexu a první na Terminal-Bench 4.0, za $2 / $10 Nové
17. říj. DeepSeek DeepSeek V4.1-Flash-1017 má 45,1 za nezměněné ceny a bere volbu nejlepšího poměru ceny a výkonu mezi otevřenými modely Nové
15. říj. Meta zveřejnila váhy Muse Spark Open, modelu s 816 mld. parametrů pod vlastní licencí Nové
15. říj. fal FLUX 3 Max od fal, rychlejší dotrénovaný FLUX 3 Video, vstupuje na video žebříčky Artificial Analysis na čtvrté a druhé místo Nové
Čeká se Google Gemini 3.5 Pro, stále nevydaný, a Gemini 4 Argon ho předběhl Zpožděno
Nejlepší AI na psaní
Nejlepší AI pro psaní je Claude Fable 5.1 a argumentem pro něj je konzistence, ne jedno první místo.
Je v první desítce všech tří žebříčků psaní: třetí na EQ-Bench Creative Writing v3 s 2155,3 za GPT-6 Astra a novým Kimi K3.1 Pro od Moonshotu, třetí na LiveBench Language s 89,5 a osmý na žebříčku tvůrčího psaní v Areně, což je nejlepší souhrnné umístění ze všech modelů. Gemini 4 Argon je druhý v textovém žebříčku Areny s 1520, hned za Gemini 4 Carbon, který smějí používat jen kybernetičtí obránci, a druhý na jejím žebříčku tvůrčího psaní s 1517 a předplatitelé Google AI Pro ho mohou používat od 13. října, EQ-Bench ho ale řadí až na 32. místo s 1757,8 a LiveBench ho zatím neohodnotil.
Claude Opus 5.5 obsadil první místo na žebříčku tvůrčího psaní v Areně s 1520, na EQ-Bench je ale osmý a na LiveBench Language desátý; GPT-6 Astra vede EQ-Bench s 2176,9, na žebříčku tvůrčího psaní v Areně je ale až 40.; Kimi K3.1 Pro je na EQ-Bench druhý s 2172,6, LiveBench ho ale zatím neohodnotil; Claude Fable 5 vede LiveBench Language s 90,7 a je čtvrtý na žebříčku tvůrčího psaní v Areně, na EQ-Bench je ale 13. Pokud je vaše psaní pracovní výstup, a ne próza, jde o jinou otázku, kterou řeší žebříček profesních výstupů GDPval-AA v2.1, a ten vede Claude Opus 5.5 s 1866 před Kimi K3.1 Pro od Moonshotu s 1858, Muse Wonder Full od Mety s 1857, Claude Sonnet 5.5 s 1838 a Claude Fable 5.1 s 1763.
Claude Sonnet 5.5 je volbou s nejlepším poměrem v bezplatném tarifu, protože ho na claude.ai může používat kdokoli, na LiveBench Language má ale 83,4, na žebříčku kreativního psaní Areny je teprve 22. a EQ-Bench ho zatím nehodnotil. Claude Fable 5 je volbou, pokud dáváte lidským hlasům Areny přednost před skóre z harnessů; stojí $10 / $50 za 1M tokenů a je trvale součástí Claude Max, Ultra a Team Premium zhruba v 50 % běžných limitů. Překlad je samostatná otázka se samostatným vítězem, kterou rozebíráme v našem průvodci nejlepší AI pro překlad.
| Model | Nejlepší pro | Silná stránka | Slabina | Cena (za 1M tokenů) |
|---|---|---|---|---|
| Claude Fable 5.1 | Nejlepší psaní celkově | #3 EQ-Bench Creative Writing (2155,3), #3 LiveBench Language (89,5) a #8 tvůrčí psaní v Areně, nejlepší souhrnné umístění ze všech modelů | Ani jeden ze tří žebříčků nevede; žebříček tvůrčího psaní v Areně vede Claude Opus 5.5 a EQ-Bench GPT-6 Astra | $10 / $50 |
| Claude Fable 5 | Silný na žebříčcích s lidským hlasováním | #1 LiveBench Language (90,7), #4 tvůrčí psaní v Areně (1501), #6 text v Areně (1504) | #13 na EQ-Bench; nejdražší možnost zde | $10 / $50 |
| Kimi K3.1 Pro | Tvůrčí beletrie a hlas | #2 EQ-Bench Creative Writing (2172,6), 4,3 bodu za GPT-6 Astra; #2 GDPval-AA v2.1 (1858) | LiveBench ho zatím neohodnotil; open weights od 2. listopadu | $2 / $10 |
| Claude Sonnet 5.5 | Bezplatné psaní na každý den | Zdarma na claude.ai, 1M kontext; #4 GDPval-AA v2.1 (1838), za Opus 5.5, Kimi K3.1 Pro a Muse Wonder Full | 83,4 LiveBench Language; #23 kreativní psaní Areny; na EQ-Bench zatím nehodnocen | $2 / $10 |
| Claude Opus 5.5 | Nejlepší tvůrčí pisatel v Areně | #1 tvůrčí psaní v Areně (1520) a #3 text v Areně (1509); #1 GDPval-AA v2.1 (1866) | #8 na EQ-Bench a #10 na LiveBench Language | $4 / $20 |
| Gemini 4 Argon | Nejvýše hodnocený použitelný model v Areně | #2 text v Areně (1520) a #2 tvůrčí psaní v Areně (1517) | #32 na EQ-Bench (1757,8); na LiveBench bez hodnocení | $19,99/měs. Google AI Pro; API $2 / $10 v úvodní ceně do 30. 11. |
| GPT-5.5 | Faktograficky ukotvené obchodní psaní | Doložené zlepšení faktografické spolehlivosti oproti GPT-5.4 | Úrovně uvažování nyní označeny jako zastaralé | $5 / $30 |
| Gemini 3.8 Flash | Hromadné koncepty ve velkém | Intelligence Index 30,8 (v5), výstup 308,4 tok/s, kontext 1M | Laděný na agenty, ne na prózu; úvodní cena se 1. ledna 2027 zdvojnásobí | $0,75 / $3,75 |
Koruna za psaní zůstává modelu Claude Fable 5.1, který má dál nejlepší souhrnné umístění na třech žebříčcích psaní. Od minulé aktualizace Arena přeřadila svůj žebříček tvůrčího psaní: Fable 5.1 se posunul na osmé místo, Gemini 4 Carbon od Googlu, který smějí používat jen kybernetičtí obránci, vstoupil na třetí místo a Claude Fable 5 klesl na čtvrté, zatímco Kimi K3.1 Pro od Moonshotu předběhl Muse Wonder Full a je druhý na GDPval-AA v2.1 s 1858. V říjnu Kimi K3.1 Pro nahradil na stupních vítězů Kimi K3 poté, co ho EQ-Bench zařadil na druhé místo, Claude Opus 5.5 získal první místo na žebříčku tvůrčího psaní v Areně a EQ-Bench zařadil Gemini 4 Argon na 32. místo.
Nejlepší AI chatbot a každodenní asistent
Nejlepší AI pro každodenní chat je GPT-6 a upřímným důvodem je dosah, ne pozice na žebříčku. Od 7. října s ním ChatGPT ve výchozím nastavení odpovídá: GPT-6 Sol na tarifech Plus, Pro, Business a Enterprise a GPT-6 Luna na Free a Go, kam se zavádí od 8. října. Díky tomu je to asistent, kterého většina lidí skutečně otevře.
V čistě lidských preferencích má k vedení daleko. GPT-6 Sol je v textovém žebříčku Areny na 64. místě s 1458, pod svým předchůdcem GPT-5.6 Sol na 22. místě, zatímco Gemini 4 Carbon od Googlu vede s 1528, Gemini 4 Argon je druhý s 1520, nejvýš ze všech modelů, které můžete používat, Claude Opus 5.5 třetí s 1509 a Muse Wonder od Mety čtvrtý s 1507. Artificial Analysis GPT-6 Sol na novém Intelligence Indexu v5 neohodnotila, GPT-6 Luna tam má 27,9; na v4.3.2 měl Sol 47,6. V API stojí Sol $2 / $10 a Luna $0,10 / $0,50 za 1M tokenů.
| Model | Nejlepší pro | Silná stránka | Slabina | Cena |
|---|---|---|---|---|
| GPT-6 | Každodenní chat, výchozí model ChatGPT | Asistent, kterého většina otevře: Sol na placených tarifech, Luna na Free a Go | GPT-6 Sol jen #64 na Arena text | Zdarma / $20/měs. Plus; API $0.10 / $0.50 (Luna) až $2 / $10 (Sol) |
| Gemini 4 Argon | Nejvýše hodnocená konverzace | #2 v textu v Areně (1520); míra halucinací 4 % na AA-Omniscience, nejnižší mezi předními modely | Hodnocení v Areně je stále předběžné; v aplikaci Gemini od Google AI Pro výše | $19,99/měs. Google AI Pro; API $2 / $10 v úvodní ceně do 30. 11. |
| Claude Opus 5.5 | Nejvýše hodnocená konverzace, kterou můžete používat | 59,1 na Intelligence Indexu v5, nejvíc ze všech modelů, které můžete používat, a #3 v textu v Areně (1509) | Není v bezplatném tarifu; v Pro omezené využití; Gemini 4 Carbon má o bod víc, ale smějí ho používat jen kybernetičtí obránci | $20/měs. Pro, API $4 / $20 |
| Claude Sonnet 5.5 | Claude chat zdarma | Zdarma na claude.ai; 54,5 na Intelligence Indexu v5 při maximálním úsilí, páté místo mezi odlišnými modely | V textu v Areně až #31; aplikace ho spouštějí se středním úsilím, při kterém má 30,8 | Zdarma / $20/měs. Pro, API $2 / $10 |
| GPT-5.5 Instant | Každodenní práce citlivá na halucinace | O 52,5 % méně halucinovaných tvrzení vs. 5.3 Instant | Úrovně uvažování nyní označeny jako zastaralé | $20/měs. Plus; API $5 / $30 |
| Gemini 3.6 Flash | Rychlý, levný, multimodální | 1M kontext, #23 na Arena text | V aplikaci Gemini od 9. října jen s Google AI Plus; 3.8 Flash jej předčí za stejnou cenu | AI Plus / $0.75 / $3.75 API |
| Fello AI | Mnoho předních modelů, jedna aplikace | ChatGPT + Claude + Gemini + Grok + DeepSeek a další na Macu, iPhonu a iPadu | Směrováno přes aplikaci, ne přímo | Od $11.99/měs. |
GPT-6 si drží volbu pro chat, protože právě jím ChatGPT ve výchozím stavu odpovídá: GPT-6 Sol na placených tarifech a GPT-6 Luna na Free a Go. Od minulé aktualizace vstoupil Gemini 4 Carbon od Googlu do textového žebříčku Areny na první místo s 1528, smějí ho ale používat jen kybernetičtí obránci, takže Gemini 4 Argon, druhý s 1520, je teď nejvýše postaveným modelem tohoto žebříčku, který můžete používat, a drží tu druhé místo. OpenAI navíc 29. října upravil GPT-6 v chatu pro uživatele Free a Go, aby odpovídal stručněji a méně podlézavě. V říjnu přešla volba 7. října z GPT-5.6 na GPT-6 a Argon získal druhé místo, když se 13. října dostal do Google AI Pro a Ultra.
Nejlepší AI na obrázky
Nejlepší AI pro generování obrázků je ChatGPT Images 2.5, které OpenAI 8. září nastavila jako výchozí ve všech tarifech ChatGPT a které vede všechny čtyři sledované obrazové žebříčky.
GPT-Image-2.5 Sunburst, stavěný na přesnost, vede všechny čtyři: Arena text-to-image s 1427, úpravy obrázků Areny s 1517, AA-Image-T2I v2.1 od Artificial Analysis s 1222 a AA-Image-Editing v2.1 s 1199. Rychlejší GPT-Image-2.5 Flare je na třech z nich druhý a na žebříčku úprav od Artificial Analysis třetí, protože mezi ně se tam s 1193 dostal MAI-Image-2.7-Preview od Microsoftu, vydaný v říjnu. Rozdíl mezi Sunburst a Flare na Arena text-to-image berte jako předběžný, protože každý stojí asi na 40 000 hlasech proti 103 000 u GPT Image 2. Na druhém místě je MAI-Image-2.6, čtvrtý na žebříčku úprav od Artificial Analysis s 1151 v trojité remíze s Krea 3 (Ultra) a Nano Banana 2.1 a čtvrtý na Arena text-to-image s 1329, ve statistické remíze s Nano Banana 2.1 těsně pod ním.
Třetí je Nano Banana 2.1 od Googlu, vydaný 6. října a nyní nejvýše postavený model Googlu: čtvrtý na žebříčku text-to-image od Artificial Analysis s 1176, na jejím žebříčku úprav na úrovni MAI-Image-2.6 s 1151 a pátý na Arena text-to-image s 1325, takže na třech ze čtyř žebříčků předstihuje Grok Imagine Image 2.0. Grok Imagine Image 2.0 od SpaceXAI, vydaný v srpnu a dostupný v Grok Imagine a v API xAI, klesá na čtvrté místo: na žebříčku úprav v Areně je stále před Nano Banana 2.1, pátý s 1439 proti sedmému místu s 1427, na Arena text-to-image je ale šestý s 1317 a na žebříčku úprav od Artificial Analysis až 17., a zůstává volbou pro nejméně omezení.
Nejlepší obrazový model, který si můžete stáhnout, je Qwen-Image-2.1 od Alibaby, vydaný 20. září a nyní nejvýše postavený model s otevřenými vahami na obou žebříčcích Areny, 20. v úpravách a 19. v text-to-image, a na každém žebříčku Artificial Analysis o jedno místo za novějším otevřeným modelem, v text-to-image za FLUX 3 Image Klein od Black Forest Labs a v úpravách za nekomerčním Fibo 2.0 od Bria. Jeho licence ale povoluje jen výzkum a hodnocení, takže to není bezplatná komerční volba. Náš úplný přehled toho, co vyšlo, najdete v článku ChatGPT Images 2.5.
| Model | Nejlepší pro | Silná stránka | Slabina | Cena |
|---|---|---|---|---|
| ChatGPT Images 2.5 | Obrázky s čitelným textem | Sunburst #1 na všech čtyřech žebříčcích a Flare #2 na třech: Arena text-to-image (1427 / 1401), Arena úpravy (1517 / 1482), text-to-image od Artificial Analysis (1222 / 1207) a úpravy (1199, Flare třetí s 1182) | Jeho vedení na Arena text-to-image stojí asi na 40 000 hlasech na model | Výchozí ve všech tarifech ChatGPT |
| MAI-Image-2.6 | Úprava obrázku, který už máte | #4 na úpravách obrázků od Artificial Analysis (1151, trojitá remíza) a #4 na Arena text-to-image (1329) | Veřejná ukázka, zatím ne v Copilotu ani Bingu; jeho nástupce MAI-Image-2.7-Preview, zatím jen pro úpravy, je na tomto žebříčku nově druhý | MAI Playground / Microsoft Foundry |
| Nano Banana 2.1 | Každodenní obrazový model Googlu | #4 text-to-image od Artificial Analysis (1176), #5 Arena text-to-image (1325) a na úrovni MAI-Image-2.6 v úpravách od Artificial Analysis (1151), nejvýše ze všech modelů Googlu; v API za polovinu ceny obrázku oproti Nano Banana 2 | #7 v úpravách obrázků Areny (1427), za Grok Imagine Image 2.0; vstupní tokeny stojí trojnásobek oproti Nano Banana 2 | Aplikace Gemini / AI Studio; $0,0336 za obrázek 1K |
| Grok Imagine Image 2.0 | Nejméně omezení, režim Spicy | #5 v úpravách obrázků Areny (1439) a #6 v text-to-image od Artificial Analysis (1166) | #6 v Arena text-to-image (1317) a v úpravách obrázků od Artificial Analysis až #17 | $30/měs. Premium (X Subscription); API xAI |
| Seedream 5.0 Pro | Vícejazyčný text + úpravy oblastí | 10+ jazyků včetně arabštiny RTL, laso a vrstvové úpravy | Kolem desátého místa na nezávislých žebříčcích; nejistota kolem autorských práv | BytePlus / Magnific |
| Midjourney v8 | Stylizované umění, ilustrace | Estetický základ, který většina umělců preferuje | Slabší v textu v obrázku | $10-$120/měs. |
| Qwen-Image-2.1 | Nejlepší obrazový model ke stažení | Nejvýše postavený model s otevřenými vahami na obou žebříčcích Areny: #20 úpravy obrázků (1362) a #19 text-to-image (1225); #22 a #24 na dvou žebříčcích Artificial Analysis, na každém o jedno místo za novějším otevřeným modelem; generátor 7B, průhledná PNG, až 10 referenčních obrázků | Qwen Research License, jen pro výzkum nebo hodnocení, bez komerčního použití | Zdarma ke stažení (Hugging Face) |
| Qwen-Image-3.0-Pro | Husté rozvržení s množstvím textu | #12 Arena text-to-image (1254) a #17 text-to-image od Artificial Analysis (1095); prompty až 4500 tokenů, text ve 12 jazycích | Jen hostovaný, bez vah; v úpravách obrázků Areny nehodnocen | Qwen Chat; v API $0,04-$0,075 za obrázek |
| Muse Image | Úpravy obrázků, ekosystém Meta | #10 v úpravách obrázků od Artificial Analysis (1129) a #8 v jejím text-to-image | Mimo stupně vítězů; #9 v Arena text-to-image a #11 v úpravách v Areně | Aplikace Meta AI |
ChatGPT Images 2.5 si drží korunu za obrázky a GPT-Image-2.5 Sunburst dál vede všechny čtyři sledované žebříčky. Od minulé aktualizace se třetí místo na stupních vítězů přesunulo z Grok Imagine Image 2.0 na Nano Banana 2.1 od Googlu: přeřazený žebříček text-to-image v Areně teď dává Nano Banana 2.1 páté místo s 1325 a Grok Imagine Image 2.0 šesté s 1317, takže Nano Banana 2.1 je vepředu na třech ze čtyř žebříčků a Grok ho předstihuje už jen na žebříčku úprav v Areně, 1439 proti 1427. MAI-Image-2.6 si drží druhé místo: na Arena text-to-image je těsně před Nano Banana 2.1, 1329 proti 1325, na text-to-image od Artificial Analysis za ním zaostává, 1166 proti 1176, a na obou žebříčcích úprav s ním remizuje.
V říjnu Artificial Analysis převedla oba své žebříčky obrázků na v2.1, Google 6. října vydal Nano Banana 2.1, MAI-Image-2.7-Preview od Microsoftu, zatím jen pro úpravy, vstoupil blízko vrcholu obou žebříčků úprav, třetí v Areně s 1471 a druhý u Artificial Analysis s 1193, a Grok Imagine Image 2.0 převzal třetí místo od Muse Image, o které teď přišel ve prospěch Nano Banana 2.1.
Nejlepší AI na video
Nejlepší AI pro generování videa je MiniMax H3, který MiniMax vydal 31. července s otevřenými vahami, a argumentem pro něj je, že se všude drží blízko špičky, místo aby vyhrál jediný žebříček.
Vede žebříček image-to-video v Areně s 1495,4 před Gemini Omni 1.1 Flash s 1488,5 a Wan 3.0 od Alibaby s 1479,8 a na žebříčcích Artificial Analysis se zvukem je třetí na text-to-video s 1161 a čtvrtý na image-to-video s 1128, kde vede Dreamina Seedance 2.5 od ByteDance s 1153 a nový Utopai X je druhý s 1146. Jeho slabým místem je žebříček text-to-video v Areně, kde je osmý s 1460,3.
Vytváří 2K klipy o délce 4 až 15 sekund s nativním stereo zvukem, od $0,13 za sekundu ve 2K, a váhy jsou na Hugging Face pod vlastní komunitní licencí MiniMaxu, bez 2K upscaleru a v USA, EU, Británii a Jižní Koreji jen na žádost. Gemini Omni 1.1 Flash, naše volba do této aktualizace, dál vede Arena text-to-video s 1516,2, ve statistické remíze s Gemini Omni Flash s 1512,9, a je volbou pro dlouhé záběry: prodlužování scény po 10 sekundách až na 40 sekund, ovládání prvního a posledního snímku a výstup ve 4K, zhruba od $0,03 za sekundu v 360p po $0,30 ve 4K.
U Artificial Analysis je ale na text-to-video až desátý s 1128 a na image-to-video 14. s 1046. Wan 3.0 vede žebříček text-to-video od Artificial Analysis s 1175 a je třetí na žebříčku image-to-video v Areně, na jejím žebříčku text-to-video je ale až šestý. Pokud potřebujete delší záběry v nástrojích Googlu, Veo 3.1 dál běží v aplikaci Gemini, AI Studiu a Vertex AI s nativním zvukem a výstupem 1080p.
| Model | Nejlepší pro | Silná stránka | Slabina | Cena |
|---|---|---|---|---|
| MiniMax H3 | Nejlepší AI video celkově | #1 Arena image-to-video (1495,4) a #3 a #4 u Artificial Analysis (1161 text-to-video, 1128 image-to-video); 2K klipy 4-15 s s nativním stereo zvukem | #8 v Arena text-to-video (1460); open weights nezahrnují 2K upscaler a v USA, EU, Spojeném království a Jižní Koreji vyžadují žádost | $0,13/s ve 2K |
| Gemini Omni 1.1 Flash | Dlouhé záběry a 4K | #1 Arena text-to-video (1516), #2 Arena image-to-video (1488,5); 40sekundové prodloužení scény, výstup 4K | V text-to-video od Artificial Analysis až #10 (1128) a v jejím image-to-video #14 (1046) | $0,03-$0,30/s; Gemini API / AI Studio / Flow |
| Gemini Omni Flash | Levnější desetisekundové klipy | #2 Arena text-to-video (1513); konverzační úpravy | Končí u desetisekundových generací | ~$0.10/s; aplikace Gemini / AI Studio |
| Wan 3.0 | Video z dokumentů a slidů | #1 text-to-video od Artificial Analysis (1175), #3 Arena image-to-video (1479,8); 2-30 s, až 1080p, vstup Omni-Reference | Jen přes API, bez zveřejněných vah; #6 v Arena text-to-video | $0,05-$0,20/s |
| Dreamina Seedance 2.5 | Vyzyvatel od ByteDance | #1 image-to-video od Artificial Analysis (1153), #4 text-to-video od Artificial Analysis (1157), #4 Arena image-to-video (1477,4) | #7 v Arena text-to-video (1474); ekosystém ByteDance, omezený přístup na Západě | Dreamina / BytePlus |
| Muse Video | Video v ekosystému Meta | #9 na Arena text-to-video s 1456 | Nejnovější ze skupiny, tenké nástroje | Aplikace Meta AI |
| Veo 3.1 | Delší produkční klipy | Nativní zvuk, 1080p, silná fyzikální konzistence | #12 na Arena video, ne lídr kvality | Google AI Pro / Ultra |
| Kling 3.0 / 3.0 Turbo | Rychlá iterace za nižší cenu | Nativní 4K, 60fps, 15sekundové klipy; Turbo vyšel 17. června | Mimo top 16 na Arena generování videa z textu | Od $10/měs. |
| Luma Ray 3 | Fotorealistické scény | Silný realismus pro krajiny | Menší komunita | Zdarma / od $9.99/měs. |
MiniMax H3 si drží korunu za video, protože se dál drží v první čtyřce na třech ze čtyř sledovaných žebříčků a vede žebříček image-to-video v Areně. Od minulé aktualizace se žebříčky Artificial Analysis znovu pohnuly: H3 je třetí na text-to-video s 1161, na image-to-video ale klesl na čtvrté místo s 1128, kde vede Dreamina Seedance 2.5 s 1153 a Utopai X, který nemá veřejné API, vstoupil na druhé místo s 1146. Arena od 21. září neaktualizovala ani jeden ze svých video žebříčků, takže její pořadí se nemění.
V říjnu přešla koruna z Gemini Omni 1.1 Flash na H3, jakmile Artificial Analysis poprvé ohodnotila Omni 1.1 Flash, Artificial Analysis přidala do svých video žebříčků zvuk a vstoupily do nich HeyGen Video 1 a FLUX 3 Max od falu. Omni 1.1 Flash dál vede žebříček text-to-video v Areně, ve statistické remíze s Gemini Omni Flash, takže zůstává na stupních vítězů jako volba pro text-to-video a Wan 3.0 je třetí.
Nejlepší AI na programování
Nejlepší AI pro programování je Claude Opus 5.5, který Anthropic vydal 22. září, už ale nevede všechny žebříčky a model, který mu dva z nich vzal, je jeho vlastní levnější sourozenec.
Claude Sonnet 5.5, vydaný 28. září, vede LiveBench Coding s 91,4 proti 89,3 u Opus 5.5 a poráží ho i ve vlastním běhu Terminal-Bench 4.0 od Artificial Analysis, 63,6 % proti 59,6 %, i když tento běh od 23. října vede Kimi K3.1 Pro od Moonshotu s 67,2 % a druhý je s 65,2 % Gemini 4 Carbon od Googlu, který smějí používat jen kybernetičtí obránci. Opus 5.5 si korunu drží díky zbytku důkazů. Vede žebříček WebDev v Areně s 1810 před GPT-6 Astra s 1773 a Claude Sonnet 5.5 s 1770 a také FrontierCode 2.0, nový programátorský test v Intelligence Indexu v5, se 46,4 % proti 42,4 % u Astry a 41,7 % u Sonnet 5.5. Na LiveBench Agentic Coding má 71,7, víc má jen DeepSeek V4.1-Flash, zatímco Sonnet 5.5 zvládne 56,3, a na vlastních sadách Anthropicu poráží Sonnet 5.5 ve FrontierCode v1.1, 54,4 % proti 52,1 %, i v CursorBench 4.0, 57,8 % proti 55,5 %. Cenově mají oba modely k sobě blíž než dřív.
Sonnet 5.5 stojí $2 / $10 za 1M tokenů proti $4 / $20 u Opus 5.5, na Intelligence Indexu v5 ale Artificial Analysis oceňuje úlohu při maximálním úsilí na $10,02 proti $10,04 u Opus 5.5 a Opus 5.5 při xhigh, 57,0 za $6,05 na úlohu, má nyní víc než Sonnet 5.5 při maximu, 54,2, za 60 % ceny; Sonnet 5.5 je levnější jen při nižších nastaveních, 41,1 za $1,64 při high. Opus 5.5 obsadil i žebříček image-to-WebDev v Areně s 1753 před Sonnet 5.5 s 1737 a GPT-6 Astra s 1726; Astra se při xhigh vyrovná 59,6 % Opus 5.5 na Terminal-Bench 4.0, za $10 / $50, a Claude Fable 5.1 je šestý na WebDev a čtvrtý na image-to-WebDev.
GPT-6.1 Sol je levnou volbou od OpenAI: pátý na WebDev, 56,1 % na Terminal-Bench 4.0 a 54,6 na Intelligence Indexu v5 za $1,27 na úlohu indexu při maximálním úsilí, LiveBench ho ale v Coding řadí daleko mimo první desítku, s 80,7. GPT-6.1 Terra, vydaný 26. října, tuto cenu za token snižuje na polovinu, na $1 / $5, a má 51,0 za $0,96 na úlohu a 55,6 % na Terminal-Bench 4.0. Gemini 4 Argon vede vlastní tabulku Googlu DeepSWE v1.1 se 77,9 %, Artificial Analysis mu ale na Terminal-Bench 4.0 naměřila 57,1 %, Arena ho na WebDev řadí na jedenácté místo a od 13. října je v placeném API a v Antigravity pro předplatitele Google AI Ultra.
Claude Haiku 5.5, vydaný 7. října za $0,10 / $0,50, je levný Claude pro velkoobjemovou práci subagentů: 33 % v běhu Terminal-Bench 4.0 od Artificial Analysis, na úrovni GLM 5.3 Flash, a 57,2 na LiveBench Agentic Coding, těsně nad Sonnet 5.5, Arena ho ale na WebDev řadí až na 36. místo. Mezi open-weight modely teď vede Kimi K3.1 Pro, jehož váhy Moonshot zveřejnil 2. listopadu, na Intelligence Indexu v5 se 46,5, na Arena WebDev 9. místem a na Terminal-Bench 4.0, kde je jeho 67,2 % první ze všech modelů. DeepSeek V4.1-Flash-1017, vydaný 17. října, je otevřenou volbou s nejlepším poměrem s 32,6 a 16. místem na WebDev, před Kimi K3 na 18. místě; GLM-5.3 dosahuje na Terminal-Bench 4.0 41,9 % a MiMo-V2.6-Pro od Xiaomi tam pod čistou licencí MIT bere 34,8 % za $0,26 na úlohu indexu.
Artificial Analysis zrušila svůj Coding Index i Coding Agent Index, takže dva souhrnné programátorské žebříčky, které tato stránka dřív citovala, už neexistují.
| Model | Nejlepší pro | Silná stránka | Slabina | Cena (za 1M tokenů) |
|---|---|---|---|---|
| Claude Opus 5.5 | Nejlepší programování celkově | #1 Arena WebDev (1810) a #1 FrontierCode 2.0 (46,4 %); 59,1 na Intelligence Indexu v5, nejvíc ze všech modelů, které můžete používat; 71,7 LiveBench Agentic Coding, o 15 bodů víc než Sonnet 5.5 | Za Sonnet 5.5 na Terminal-Bench 4.0 (59,6 % proti 63,6 %) a LiveBench Coding (89,3 proti 91,4) | $4 / $20 |
| Claude Sonnet 5.5 | Programování za nejlepší poměr | #1 LiveBench Coding (91,4), #3 Terminal-Bench 4.0 (63,6 %) a #3 Arena WebDev (1770), za poloviční cenu za token proti Opus 5.5 | 56,3 na LiveBench Agentic Coding, o 15 bodů méně než Opus 5.5; na Intelligence Indexu v5 má Opus 5.5 při xhigh víc než on při maximu a za nižší cenu na úlohu | $2 / $10 |
| GPT-6 Astra | Druhý na WebDev Areny | #2 Arena WebDev (1773) a #3 image-to-WebDev (1726); 59,6 % Terminal-Bench 4.0 při xhigh | 2,5krát cena Opusu 5.5; na Terminal-Bench za Sonnet 5.5 a na LiveBench Coding daleko za oběma modely Claude | $10 / $50 |
| Kimi K3.1 Pro | Nejsilnější programátor v terminálu | #1 Terminal-Bench 4.0 (67,2 %); 46,5 na Intelligence Indexu v5 za $3,68 na úlohu indexu | #9 Arena WebDev (1695); open weights od 2. listopadu, s 2,8 bilionu parametrů ale model pro datová centra | $2 / $10 |
| Claude Fable 5.1 | Nejvyšší souhrnné skóre před Opus 5.5 | #6 Arena WebDev a #4 image-to-WebDev; 50,0 na Intelligence Indexu v5; AA-Briefcase 1670 | 55,1 % na Terminal-Bench 4.0 při xhigh; 2,5krát dražší než Opus 5.5 | $10 / $50 |
| Claude Opus 5 | Nahrazený modelem Opus 5.5 | 49,0 % na Terminal-Bench 4.0, #10 Arena WebDev a #6 image-to-WebDev | Za token stojí víc než Opus 5.5 a na v4.3.2 měl o sedm bodů méně; na Intelligence Indexu v5 nehodnocený | $5 / $25 |
| Claude Fable 5 | Nejtěžší dlouhodobá agentní práce | Intelligence Index 49,6 (v4.3.2); 42,4 % Terminal-Bench 4.0; kontext 1M | Nejdražší na úlohu indexu na v4.3.2, $8,75; #10 v image-to-WebDev v Areně | $10 / $50 |
| Qwen3.8-Max-0902 | Krátkodobý držitel žebříčku WebDev v Areně | #13 Code Arena: WebDev (1676); 33,6 na Intelligence Indexu v5; 2,4 bilionu parametrů, kontext 1M | Jen API QwenCloud bez spotřebitelského rozhraní; vedení na WebDev ztratil během pár dní | $2 / $6 |
| DeepSeek V4.1-Flash-1017 | Otevřená volba s nejlepším poměrem | 32,6 na Intelligence Indexu v5, druhý mezi otevřenými modely po Kimi K3.1 Pro, za $0,60 na úlohu; #16 Arena WebDev (1665) a #18 Agent Arena; MIT | 33,8 % na Terminal-Bench 4.0; 552B/16B aktivních k vlastnímu hostování | $0,15 / $0,60 mimo špičku |
| GPT-5.6 Sol | Levnější vlajková loď OpenAI | Intelligence Index 47,0 (v4.3.2); 39,9 % Terminal-Bench 4.0 | Nahrazený modelem GPT-6 Sol, který má víc za poloviční cenu; METR upozornil na obcházení testů | $4 / $20 |
| GPT-6 Sol | Levné programování v GPT-6 uvnitř Codexu | Intelligence Index 47,6 (v4.3.2) a 43,9 % Terminal-Bench 4.0, obojí nad GPT-5.6 Sol, za poloviční cenu | #12 Arena WebDev (1678) | $2 / $10 |
| GPT-6.1 Sol | Nejlevnější model špičkové třídy na úlohu | 54,6 na Intelligence Indexu v5, #5 Arena WebDev (1751) a 56,1 % Terminal-Bench 4.0 za $1,27 na úlohu indexu, případně 50,3 za $0,59 při vysokém úsilí; cachovaný vstup za $0,10 | 80,7 na LiveBench Coding, daleko mimo první desítku; jen v Codexu a ChatGPT Work, ne v Chatu | $2 / $10 |
| GPT-6.1 Terra | Programátor od OpenAI za poloviční cenu | 51,3 na Intelligence Indexu v5 za $0,96 na úlohu indexu; 55,6 % Terminal-Bench 4.0; třetí mezi odlišnými modely ve FrontierCode 2.0 (42,3 %) | Jen v ChatGPT Work a Codexu, ne v Chatu; LiveBench ho zatím neohodnotil | $1 / $5 |
| Gemini 4 Argon | Dlouhé softwarové úlohy | 77,9 % DeepSWE v1.1 podle vlastních čísel Googlu; 50,4 na Intelligence Indexu v5 | 57,1 % Terminal-Bench 4.0 a #11 Arena WebDev (1679) | $2 / $10 v úvodní ceně do 30. 11., standardně $4 / $20 |
| Gemini 4 Carbon | Zatím nedostupný: dlouhé programování a kybernetická obrana | 60,0 na Intelligence Indexu v5, nejvyšší zveřejněné skóre; #2 Terminal-Bench 4.0 (65,2 %) | Jen pro kybernetické obránce a partnery Fairwind, bez veřejného data; šestý mezi odlišnými modely ve FrontierCode 2.0 (40,6 %) | Úvodní cena $2 / $10, poté $4 / $20 (oznámeno) |
| Muse Spark 1.3 | Levné agentní programování | Intelligence Index 48,1 (v4.3.2) za $1,25 / $4,25 a $1,60 na úlohu indexu | 33,3 % na Terminal-Bench 4.0; programátorské výhry pocházejí z vlastního grafu Mety, změřené na maximální variantě jen pro partnery; na v5 zatím nehodnocený | $1,25 / $4,25 |
| Muse Wonder Full | Nejsilnější model Mety, uvnitř Muse Code | 50,1 na Intelligence Indexu v5, na úrovni Claude Fable 5.1; #3 GDPval-AA v2.1 (1857); 57,1 % Terminal-Bench 4.0 | Jen s předplatným Muse Code (tarify za $50 a $200), bez API; sedmý na Arena WebDev (1725) | Muse Code, od $50/měs. |
| Muse Wonder | Špičkový model Mety v API | 43,6 na Intelligence Indexu v5; 52,0 % Terminal-Bench 4.0; kontext 1M | Stejných $4 / $20 jako Opus 5.5, který má o 15,5 bodu víc; $6,95 na úlohu indexu | $4 / $20 |
| Grok 4.7 | Levný programátor za dobrý poměr | 46,3 % CursorBench 4.0 a 71,0 % DeepSWE v1.1 podle vlastních čísel SpaceXAI; 35,2 na Intelligence Indexu v5 | 24,7 % na Terminal-Bench 4.0; $6,18 na úlohu indexu; prompty od 200K tokenů přeúčtují celý požadavek za dvojnásobek | $2 / $6 |
| Gemini 3.8 Flash | Agentní programování ve velkém | 30,8 na Intelligence Indexu v5; 308,4 výstupních tokenů za sekundu | 19,7 % na Terminal-Bench 4.0; úvodní cena se 1. ledna 2027 zdvojnásobí | $0,75 / $3,75 |
| GLM 5.3 Flash | Nejmenší seriózní programátor k hostování | 27,8 na Intelligence Indexu v5 za $0,58 na úlohu indexu a 32,8 % Terminal-Bench 4.0; MIT, 320B/18B aktivních, proti 552B u DeepSeek V4.1-Flash | GLM-5.3 na stejné sadě dosahuje 41,9 %; žádný spotřebitelský produkt | Open weights (MIT) |
| Claude Haiku 5.5 | Nejlevnější Claude pro subagenty | 36,5 na Intelligence Indexu v5 za $0,41 na úlohu indexu; 32,8 % Terminal-Bench 4.0, na úrovni GLM 5.3 Flash; 57,2 LiveBench Agentic Coding, nad Sonnet 5.5 | #36 Arena WebDev (1589); Anthropic uvádí, že pro složité agentní programování zůstávají lepší Sonnet 5.5 a Opus 5.5; prompty nad 100K tokenů stojí pětkrát víc | $0,10 / $0,50 |
| MiMo-V2.6-Pro | Nejlevnější silný otevřený model na úlohu | 29,9 na Intelligence Indexu v5 a 34,8 % Terminal-Bench 4.0 za $0,26 na úlohu indexu; MIT, 1,02T/42B aktivních | Na Arena WebDev až #25 (1625), za DeepSeek V4.1-Flash-1017 a Kimi K3 | $0,435 / $0,87 |
Claude Opus 5.5 si drží korunu za programování: vede žebříček WebDev v Areně s 1810 před GPT-6 Astra s 1773 a Claude Sonnet 5.5 s 1770 a vede i FrontierCode 2.0 se 46,4 %. Od minulé aktualizace vstoupil Gemini 4 Carbon od Googlu do žebříčku WebDev v Areně na čtvrté místo s 1768, s předběžným hodnocením, smějí ho ale používat jen kybernetičtí obránci, a Mistral 29. října zveřejnil open weights modelu Mistral Large 4, kterého Arena řadí na 48. místo. Moonshot 2. listopadu zveřejnil váhy modelu Kimi K3.1 Pro, který je tím nejsilnějším otevřeným modelem pro programování na Terminal-Bench 4.0, Arena WebDev i na indexu, před DeepSeek V4.1-Flash-1017. Argument nejlepšího poměru u Sonnet 5.5 dál stojí na LiveBench Coding, Terminal-Bench 4.0 a polovičních cenách za token, protože na Intelligence Indexu v5 má Opus 5.5 při xhigh víc než Sonnet 5.5 při maximu a za nižší cenu na úlohu.
V říjnu Kimi K3.1 Pro převzal od Sonnet 5.5 Terminal-Bench 4.0 s 67,2 %, 7. října dorazil Claude Haiku 5.5 za $0,10 / $0,50 jako nejlevnější Claude pro práci subagentů, 26. října dorazil GPT-6.1 Terra za $1 / $5, Artificial Analysis 27. října s Intelligence Indexem v5 přidala FrontierCode 2.0 a DeepSeek V4.1-Flash-1017 se stal nejvýše postaveným otevřeným modelem na WebDev.
Nejlepší AI na kreativitu
Nejlepší AI na necenzurovanou, trendovou tvorbu je Grok 4.7 a chceme být přesní v tom proč. Tahle volba je o produktové řadě, ne o kvalitě prózy.
Grok nese nejméně obsahových omezení ze všech špičkových modelů a jako jediný má nativní napojení na X v reálném čase, což z něj dělá jediný model, který se pustí do odvážných, aktuálních nebo záměrně provokativních zadání, jaká ostatní odmítají. SpaceXAI vydala Grok 4.7 dne 21. září do Grok API, Cursoru a Grok Buildu a od 3. října pohání i režim Expert na grok.com a pro platící předplatitele také režim Fast. Není to nejlepší pisatel, obrázek je ale smíšenější než dřív.
EQ-Bench Grok 4.7 ohodnotil a řadí ho na deváté místo s 2012,2, do své první desítky a daleko nad Grok 4.5 na 57. místě, lidští hlasující v Areně ale dávají 4.7 v tvůrčím psaní až 87. místo, za Grok 4.6 na 57. místě a starší Grok 4.20-beta1 na 27. Pokud vybíráte čistě podle kvality výstupu, žebříček tvůrčího psaní v Areně nově vede Claude Opus 5.5, druhý je Gemini 4 Argon, v Google AI Pro od 13. října, třetí Gemini 4 Carbon, který smějí používat jen kybernetičtí obránci, a čtvrtý Claude Fable 5, zatímco EQ-Bench dává na první místo GPT-6 Astra s 2176,9, na druhé Kimi K3.1 Pro od Moonshotu a na třetí Claude Fable 5.1. Grok si vyberte kvůli tomu, co vám dovolí vytvořit, ne kvůli tomu, jak dobře píše.
| Model | Nejlepší pro | Silná stránka | Slabina | Cena |
|---|---|---|---|---|
| Grok 4.7 | Bez filtrů, s názorem, podle trendů | Nejméně omezení obsahu, nativní ukotvení v X v reálném čase | #87 v tvůrčím psaní v Areně, i když #9 na EQ-Bench (2012,2) | API $2 / $6; aplikace Premium za $30/měs. (X Subscription) |
| Claude Fable 5 | Tvůrčí próza nejvyšší kvality | #4 Arena tvůrčí psaní, #1 LiveBench Language | Opatrné mantinely u odvážných zadání | $10 / $50 API |
| Kimi K3.1 Pro | Beletrie a osobitý hlas | #2 EQ-Bench Creative Writing s 2172,6 | LiveBench ho zatím neohodnotil; open weights od 2. listopadu | $2 / $10 |
| Claude Opus 5 | Dlouhá strukturovaná tvorba | Udrží dlouhá vlákna a sám se opravuje; 50,8 na Intelligence Indexu v4.3.2, na v5 nehodnocený | Nejopatrnější ze skupiny | $20/měs. Pro; API $5 / $25 |
| Gemini 3.1 Pro | Multimodální tvůrčí práce | Silný řetězec textu, obrázku a videa | V aplikaci Gemini od 9. října jen s Google AI Pro | AI Pro / $2.00-$4.00 API vstup |
| Grok Imagine (Spicy Mode) | NSFW / tvůrčí práce pro dospělé | Nejvolnější generování obrázků | Nika | $30/měs. Premium, nejspíš (xAI tarif neuvádí) |
Grok si tuto volbu drží s Grok 4.7 a na jeho benevolenci ani na živém přístupu k X, na kterých volba stojí, se nic nezměnilo. Od minulé aktualizace Arena přeřadila svůj žebříček tvůrčího psaní: Grok 4.7 klesl z 78. na 87. místo, Gemini 4 Carbon od Googlu, který smějí používat jen kybernetičtí obránci, vstoupil na třetí místo a Claude Fable 5 se posunul na čtvrté, a tady si jako volba pro kvalitu drží místo na stupních vítězů. V říjnu Kimi K3.1 Pro nahradil na stupních vítězů Kimi K3 jako volba pro beletrii poté, co ho EQ-Bench zařadil na druhé místo, Claude Opus 5.5 převzal vedení na žebříčku tvůrčího psaní v Areně a 3. října začal Grok 4.7 běžet v režimu Expert na grok.com.
Nejlepší AI na přesnost & výzkum
Nejlepší AI pro přesnost a výzkum je Claude Fable 5.1, který drží nejvyšší faktickou přesnost, jakou Artificial Analysis naměřila, 68 % na AA-Omniscience.
Právě podle tohoto sloupce se kategorie rozhoduje. Claude Opus 5.5 po svém příchodu 22. září porazil Fable 5.1 téměř ve všem ostatním, včetně Humanity's Last Exam, 61,4 % proti 59,1 %, a indexu AA-Omniscience, který penalizuje halucinace, 48,1 proti 46,3, v hrubé faktické přesnosti má ale 66 % proti 68 % u Fable 5.1. Čtěte je společně: Opus 5.5 je lepší sázkou, když je špatná odpověď horší než žádná, Fable 5.1, když chcete mít správně co nejvíc faktů. Tento index nově vede Gemini 4 Carbon od Googlu s 53,5, správně ale odpoví jen na 58 % a používat ho smějí jen kybernetičtí obránci.
Volbou za nejlepší poměr je GPT-6.1 Sol, který správně odpoví na 62 % s indexem AA-Omniscience 42,0 za $2 / $10 za 1M tokenů a $1,27 na úlohu indexu a na ARC-AGI-1 od ARC Prize má 98,5 % za $0,06 na úlohu. Tím poráží Gemini 3.1 Pro, naši volbu za nejlepší poměr do začátku října, ve všech měřítkách přesnosti, které pro něj Artificial Analysis zveřejnila: ten měl hrubou přesnost 55 % a index 31,9.
Gemini 3.1 Pro si drží své místo tam, kde musí být odpověď aktuální, protože odpovědi ukotvuje ve Vyhledávání Google a je v aplikaci Gemini (od 9. října s Google AI Pro a výše), zatímco GPT-6.1 Sol běží v ChatGPT Work, Codexu a API, ne v chatovacím okně ChatGPT. Gemini 4 Argon je model, který stojí za sledování: Artificial Analysis mu naměřila míru halucinací 4 %, nejnižší mezi předními modely, protože raději odmítne, než aby hádal, správně ale odpoví jen na 48 %; od 13. října je v aplikaci Gemini v Google AI Pro a výše.
Specificky u ukotveného vyhledávání vede žebříček vyhledávání Areny OpenAI: první je GPT-5.6 Sol s 1261, stejně jako Qwen3.8-Max, Claude Fable 5.1 je pátý a Gemini 3.1 Pro s ukotvením patnáctý. U nového uvažování je koruna jinde, ARC-AGI-2 i ARC-AGI-3 vede GPT-6 Astra. Claude Opus 5 nedrží žádnou korunu za přesnost, protože mu Artificial Analysis měří míru halucinací 61 %.
| Model | Nejlepší pro | Klíčový benchmark | Slabina | Cena |
|---|---|---|---|---|
| Claude Fable 5.1 | Nejvyšší naměřená faktická přesnost | 68% faktická přesnost na AA-Omniscience, nejvyšší, jakou Artificial Analysis naměřila, o tři body víc než Claude Opus 5.5 | Žádný levný tarif; #5 ve vyhledávacím žebříčku Areny, za GPT-5.6 Sol; Humanity's Last Exam vede Opus 5.5 a index AA-Omniscience Gemini 4 Carbon | $10 / $50 |
| Claude Opus 5.5 | Když je špatná odpověď horší než žádná | #1 Humanity's Last Exam (61,4 %) a #2 index AA-Omniscience (48,1), za Gemini 4 Carbon dostupným jen kybernetickým obráncům; hrubá přesnost 66 % | V hrubé přesnosti o tři body za Fable 5.1 | $4 / $20 |
| GPT-6.1 Sol | Nejlepší poměr | Hrubá přesnost 62 % a index AA-Omniscience 42,0 za $1,27 na úlohu indexu; 98,5 % ARC-AGI-1 za $0,06 na úlohu | Míra halucinací 52 %; v ChatGPT Work a Codexu, ne v Chatu | $2 / $10 |
| Gemini 4 Argon | Nejméně halucinací | Míra halucinací 4 % na AA-Omniscience, nejnižší mezi předními modely | Hrubá přesnost jen 48 % | $19,99/měs. Google AI Pro; API $2 / $10 v úvodní ceně |
| Gemini 4 Carbon | Zatím nedostupný | #1 index AA-Omniscience (53,5), s mírou halucinací 11 % | Hrubá přesnost 58 %; jen pro kybernetické obránce a partnery Fairwind | Oznámená úvodní cena $2 / $10 |
| Gemini 3.1 Pro | Ukotvené vyhledávání; aplikace Gemini od 9. 10. s AI Pro | Nativní ukotvení ve Vyhledávání Google; 98 % ARC-AGI-1 za $0.52/úlohu | 55% čistá přesnost na AA-Omniscience, méně než GPT-6.1 Sol; #15 na Arena vyhledávání | $2.00-$4.00 / $12.00-$18.00 (odstupňováno) |
| Claude Fable 5 | Ukotvené vyhledávání | #10 na žebříčku vyhledávání Areny, za GPT-5.6 Sol | Žádná jediná levná úroveň | $10 / $50 (Fable 5) |
| GPT-5.6 Sol | Nové uvažování | #4 ARC-AGI-2 se skóre 92,5 %, za GPT-6 Astra (95 %), GPT-6.1 Sol (94,2 %) a Claude Opus 5.5 (93,3 %) | Scheming označen METR | $4 / $20 |
| Claude Opus 5 | Nejtěžší neviděné problémy | 30,2 % ARC-AGI-3 na standardním harnessu, druhý za GPT-6 Astra (ARC Prize) | Artificial Analysis měří míru halucinací 61 % | $5 / $25 |
| Qwen 3.7 Max | Frontier přesnost za výhodnou cenu | 92,4 GPQA Diamond, 200 dotazů zdarma/den | Jen API, žádné chatovací rozhraní | $1.25 / $3.75 promo; $2.50 / $7.50 ceníková |
| Claude Opus 4.6 | Poctivost pod tlakem | #1 na žebříčku MASK od Scale SEAL se skóre 96,28; Anthropic drží top 5 | Nahrazen jako vlajkový model | Starší model Anthropicu |
Koruna za přesnost zůstává modelu Claude Fable 5.1 s 68% čistou faktickou přesností proti 66 % u Claude Opus 5.5. Od minulé aktualizace se na vrcholu žádného žebříčku přesnosti nic nepohnulo: AA-Omniscience od Artificial Analysis dál dává Fable 5.1 první místo v čisté přesnosti a Gemini 4 Carbon od Googlu, který smějí používat jen kybernetičtí obránci, první místo v indexu penalizujícím halucinace s 53,5, a Humanity's Last Exam dál vede Opus 5.5 s 61,4 %. Ve vyhledávacím žebříčku Areny, který jsme pro tuto aktualizaci znovu načetli, je Fable 5.1 pátý a GPT-6.1 Sol osmý a první zůstává GPT-5.6 Sol od OpenAI.
V říjnu GPT-6.1 Sol převzal kartu nejlepšího poměru od Gemini 3.1 Pro, protože ho porazil na všech měřítkách přesnosti, která Artificial Analysis zveřejňuje, Google 28. října oznámil Gemini 4 Carbon a Gemini 4 Argon se 13. října dostal do aplikace Gemini s nejnižší mírou halucinací, jakou Artificial Analysis mezi předními modely naměřila.
Nejlepší AI na řešení problémů
Nejlepší AI pro řešení těžkých problémů je GPT-6 Astra, který během pár dní od uvedení sebral žebříčky uvažování GPT-5.6 Sol.
Vede LiveBench Reasoning s 92,65 a ARC-AGI-2 s 95 %, což je nejvyšší výsledek, jakého kdo proti 100% lidskému panelu tohoto žebříčku dosáhl, a na LiveBench Mathematics je čtvrtý s 96,81, za Claude Opus 5.5 s 97,08, Claude Fable 5.1 s 97,01 a GPT-6.1 Sol s 96,83. Uvádí také 97,6 % na FrontierMath Tier 4 v2, číslo, ke kterému patří upozornění Epoch AI, že OpenAI benchmark financovala a má k jeho části exkluzivní přístup. Háček je v ceně a dostupnosti: $10 / $50 za 1M tokenů proti $2 / $10 u GPT-6.1 Sol a potřebujete placený tarif ChatGPT.
GPT-6.1 Sol, vydaný 29. září, je alternativou s nejlepším poměrem a téměř spoluvítězem: 92,63 na LiveBench Reasoning, 0,02 za Astrou, a 94,2 % na ARC-AGI-2, 0,8 bodu za ní, za $0,25 na úlohu proti $1,12 u Astry. Astra si korunu drží, protože stále vede oba žebříčky i ARC-AGI-3, kde má na standardním harnessu 62,7 % proti 52,7 % u GPT-6.1 Sol. Gemini 4 Argon vede matematickou kategorii Areny, ale jen na pár stovkách hlasů, a LiveBench ho zatím nehodnotil; ARC Prize ho řadí na páté místo na ARC-AGI-2 s 91,3 % a na třetí na ARC-AGI-3 s 49,8 %. GPT-5.6 Sol, dřívější volba s nejlepším poměrem, je nyní pátý na LiveBench Reasoning a čtvrtý na ARC-AGI-2 s 92,5 %.
Qwen 3.7 Max je levnou volbou pro soutěžní úlohy s 97,1 na indexu HMMT z února 2026 a 44,5 na Apex a 200 bezplatnými požadavky denně. Claude Opus 5 zůstává alternativou pro dlouhé agentní řetězce uvažování, i když mu Astra vzala i ARC-AGI-3.
| Model | Nejlepší pro | Klíčový benchmark | Slabina | Cena |
|---|---|---|---|---|
| GPT-6 Astra | Nejtěžší matematika, věda a uvažování | #1 LiveBench Reasoning (92,65), #1 ARC-AGI-2 (95 %), #1 ARC-AGI-3 | Vyžaduje placený tarif ChatGPT; 5x cena GPT-6.1 Sol | $10 / $50 |
| Claude Opus 5 | Dlouhé agentické řetězce uvažování | 1656 na AA-Briefcase v1.1 a 1730 na GDPval-AA v2.1; 30,2 % ARC-AGI-3 | ARC-AGI-3 nyní vede Astra; 61% míra halucinací; nyní starší (legacy) model | $5 / $25 |
| GPT-5.6 Sol | Cenově výhodný STEM model | #4 ARC-AGI-2 (92,5 %); #5 LiveBench Reasoning (91,65), Mathematics 96,20 | FrontierMath stále nezveřejněn; METR označil manipulaci | $100/měs. ChatGPT Pro; API $4 / $20 |
| GPT-6.1 Sol | Nejlepší poměr, uvažování blízko Astře | #2 LiveBench Reasoning (92,63), #2 ARC-AGI-2 (94,2 %), #3 LiveBench Mathematics (96,83); 54,6 na Intelligence Indexu v5 za $1,27 na úlohu indexu | 52,7 % na ARC-AGI-3 proti 62,7 % u Astry; v ChatGPT Work a Codexu, ne v Chatu | $2 / $10 |
| Qwen 3.7 Max | Soutěžní matematika na rozpočet | 97,1 HMMT 2026 únor, 44,5 Apex, 200 dotazů zdarma/den | Jen API | $1.25 / $3.75 promo; $2.50 / $7.50 ceníková |
| Claude Fable 5 | Matematika uvnitř programátorského workflow | #3 na matematické podkategorii Areny (1522), za Gemini 4 Argon a Claude Opus 5; 96,0 LiveBench Mathematics | Nejdražší volba zde | $10 / $50 |
| GLM 5.3 Flash | Řešení problémů s open weights | Intelligence Index 41,8 (v4.3.2) pod licencí MIT, téměř o osm bodů víc než GLM-5.2 při méně než poloviční velikosti; 320B/18B aktivních, kontext 1M | Potřebuje server s více GPU, ne pracovní stanici; na v5 má 27,8; GLM 5.3 má podle vlastních čísel Z.ai víc a od 28. srpna je ke stažení, je ale víc než dvakrát větší a pod vlastní licencí | Open weights (MIT) |
GPT-6 Astra si drží korunu za řešení problémů, o méně než bod. Dál vede LiveBench Reasoning s 92,65, o 0,02 před GPT-6.1 Sol, ARC-AGI-2 s 95 % proti 94,2 % u Solu a ARC-AGI-3. Od minulé aktualizace se žádný z těchto žebříčků nepohnul: LiveBench ani ARC Prize nezveřejnily nové výsledky a Gemini 4 Carbon od Googlu, který v Intelligence Indexu v5 vede HLE-Diamond a Terminal-Bench-Science, na obou zůstává neohodnocený a otevřený jen kybernetickým obráncům. V říjnu ARC Prize zařadila GPT-6.1 Sol na druhé místo v ARC-AGI-2 a Gemini 4 Argon na páté s 91,3 % a Argon na několika stech hlasech převzal matematickou kategorii Areny.
Nejlepší AI agent
Nejlepší AI agent je Gemini Spark, pokud chcete agenta v cloudu, a Claude Cowork, pokud ho chcete na svém počítači.
Jde o společné volby, nikoli o první a druhé místo: Spark běží ve virtuálním stroji Google Cloud, takže pracuje dál i se zavřeným notebookem, a je propojený s Gmailem, Dokumenty a od začátku září i s Fotkami Google; Cowork běží na vašem Macu nebo Windows a ovládá vaše místní aplikace i obrazovku. Spark už není jediným agentem, který pracuje dál v cloudu.
Grok Bot od SpaceXAI (11. srpna) dává každému účtu trvalý cloudový počítač, který se přihlašuje do vašich aplikací, od tarifu X Subscription Premium za $30/měsíc; Muse od Mety (8. září) vyřizuje pochůzky z vlastního cloudového virtuálního stroje a je zdarma do 100 milionů tokenů týdně; a OpenAI dots (29. září) běží na GPT-6 Astra s vlastním cloudovým počítačem a prohlížečem, od tarifu Pro za $100/měsíc, který je v EHP, Spojeném království a Švýcarsku nezahrnuje. Žádný nezávislý žebříček tyto produkty proti sobě neměří, takže rozhodující je, kde má práce probíhat, ne kdo má vyšší skóre.
Ani cena už jazýčkem na vahách není: Spark je nyní dostupný na tarifu Google AI Pro za $19.99/měsíc v USA a ve více než 160 dalších zemích a Cowork je bez příplatku součástí každého placeného tarifu Claude od $20/měsíc. ChatGPT Codex Mobile (14. května) je alternativou pro práci s programovacím agentem. Přečtěte si celé srovnání Gemini Spark vs Claude Cowork.
| Agent | Nejlepší pro | Kde běží | Silná stránka | Cena |
|---|---|---|---|---|
| Gemini Spark | 24/7 cloudové úlohy, workflow Workspace | Google Cloud VM (vždy zapnuto) | Běží nepřetržitě, hluboká integrace Workspace | Od $19.99/měs. Google AI Pro |
| Claude Cowork | Desktop, řízení aplikací, design + kód | Váš desktop Mac/Windows | Řídí lokální aplikace, vidí vaši obrazovku | $20/měs. Claude Pro |
| ChatGPT Codex Mobile | Programátorský agent v telefonu | Cloud OpenAI + iOS/Android | Schvalování diffů a přesměrování práce z telefonu | Zahrnuto v plánech ChatGPT |
| Grok Bot | Práce v prohlížeči napříč přihlášenými aplikacemi | Jeden trvalý cloudový počítač SpaceXAI sdílený všemi vašimi Boty | Přihlašuje se do aplikací vašimi údaji a pokračuje i se zavřeným notebookem | Od $30/měs. X Subscription Premium (Cursor Pro za $20 pro stávající předplatitele) |
| OpenAI dots | Průběžné povinnosti, ne jednotlivé úkoly | Cloudový počítač a prohlížeč OpenAI | Běží na GPT-6 Astra; pracuje i s vypnutým počítačem; dostupný v ChatGPT, Slacku i hlasem | Od $100/měs. ChatGPT Pro (mimo EHP/UK/CH); Business Premium |
| Meta Muse | Osobní pochůzky zdarma | Muse Secure VM v cloudu Mety | Zdarma do 100M tokenů týdně; vše, co odesílá, schvaluje samostatný agent Sentinel | Zdarma; Power $20/měs., Maximum $100/měs. |
| Claude Duet | Proaktivní ranní přehledy a pochůzky | Vlastní cloudový VM a prohlížeč, na iOS, Androidu a claude.ai | Každých pár hodin kontroluje připojené aplikace a pracuje i s vypnutými zařízeními; než něco odešle, zaplatí, podepíše nebo smaže, zeptá se | Výzkumné preview, Claude Pro a Max v USA, čekací listina |
Gemini Spark (cloud) a Claude Cowork (desktop) zůstávají společnou volbou, protože tato kategorie korunuje produkty a od minulé aktualizace žádný nový agentní produkt nevyšel. Vrstva modelů se téměř nepohnula: Claude Opus 5.5 dál vede Agent Arena, nyní s 22,3 % potvrzených úspěchů, druhý je s předběžným hodnocením Gemini 4 Carbon od Googlu, který smějí používat jen kybernetičtí obránci, Claude Sonnet 5.5 dál vede AA-Briefcase v1.1 s 1814 a na GDPval-AA v2.1 se Kimi K3.1 Pro od Moonshotu posunul na druhé místo s 1858, za Opus 5.5 s 1866 a o bod před Muse Wonder Full od Mety. V říjnu se Claude Duet od Anthropicu (21. října), výzkumné preview s čekací listinou pro předplatitele Pro a Max v USA, dostal do tabulky, ne na stupně vítězů, a Gemini 4 Argon se 13. října dostal do placeného API a do aplikace Gemini v Google AI Pro.
Mezi otevřenými modely v Agent Arena je teď nejvýš Kimi K3.1 Pro, jehož váhy Moonshot zveřejnil 2. listopadu, na 13. místě, před MiMo-V2.6-Pro od Xiaomi na 17. místě a DeepSeek V4.1-Flash-1017 na 18. místě, zatímco Kimi K3 klesl na 27. místo a nově otevřený Mistral Large 4 je 43. V říjnu začal OpenAI 28. října zavádět textové zprávy s dots přes iMessage nebo RCS pro předplatitele Pro v USA.
Na Macu stiskněte ⌥ Space, zeptejte se a pracujte dál. Také na iPhonu a iPadu.
Začněte zdarma, hodnocení 4,7★ napříč 27 000+ recenzemi.
Stáhnout Fello AINejlepší AI pro studenty
Nejlepší AI pro studenty je GPT-6 Luna uvnitř ChatGPT pro obecnou práci na kurzech a Gemini 3.6 Flash pro STEM a multimodální studium, s Qwen 3.7 Max jako API alternativou pro těžší sady úloh (200 dotazů zdarma denně) a Claude Sonnet 5.5 jako bezplatnou alternativou pro úpravy esejí.
Většina studentů platit nemusí. Od 8. října přecházejí ChatGPT Free a Go z GPT-5.6 Luna na GPT-6 Luna, kterému Artificial Analysis na Intelligence Indexu v4.3.2 dala 38,1 proti 37,3; bezplatný tarif má neomezené textové chaty, nahrávání souborů a obrazové nástroje ale zůstávají omezené. Claude Sonnet 5.5 je zdarma na claude.ai, kde si bezplatné účty mohou vybrat i Claude Haiku 5.5 (7. října), model Claude, který spotřebuje nejméně z vašeho limitu využití.
Gemini se změnil 9. října: bezplatná aplikace Gemini teď běží v režimu Auto, který většinu promptů posílá na Flash-Lite, takže vlastní volba Gemini 3.6 Flash vyžaduje Google AI Plus, v Google AI Studio ale zůstává zdarma. Pro postupné řešení nejtěžší matematiky uvádí GPT-6 Astra 97,6 % na FrontierMath Tier 4 v2, na bezplatné úrovni ChatGPT ale není; Qwen 3.7 Max je výhodnou alternativou s 97,1 na HMMT únor 2026 a cenou API $1,25 / $3,75 v aktuální 50% akci ($2,50 / $7,50 podle ceníku).
| Úloha | Nejlepší model | Proč | Zdarma? | Alternativa |
|---|---|---|---|---|
| Eseje & práce na kurzech | GPT-6 Luna | Model ChatGPT Free a Go, zaváděný od 8. října; neomezené textové chaty | Ano | Claude Sonnet 5.5 (Claude zdarma) |
| Řešení STEM úloh | GPT-6 Sol / Qwen 3.7 Max | Placený výchozí model ChatGPT; Astra uvádí 97,6 % FrontierMath Tier 4 v2 / 97,1 HMMT únor 2026 | Plus placené / Qwen API placené | Gemini 3.6 Flash (AI Plus od 9. 10.) |
| Výzkum & přesnost | Gemini 3.1 Pro | 98 % ARC-AGI-1 za $0.52/úlohu, nativní ukotvení ve vyhledávání Google | AI Pro (aplikace Gemini) od 9. 10. | Claude Opus 5 |
| Úpravy textu | Claude Sonnet 5.5 | Zdarma na claude.ai od 28. září a při maximálním úsilí páté místo mezi odlišnými modely na Intelligence Indexu v5; lídrem kvality je Claude Fable 5.1 | Ano (Claude zdarma) | Claude Fable 5.1 |
| Multimodální studium (PDF, snímky, obrázky) | Gemini 3.6 Flash | 1M kontext přes AI Studio; aplikace Gemini od 9. 10. s AI Plus | Zdarma v AI Studio | NotebookLM (Google) |
Pro studenty se od minulé aktualizace nic nezměnilo. ChatGPT Free a Go běží na GPT-6 Luna, který OpenAI 29. října upravil, aby odpovídal stručněji a méně podlézavě, Claude Sonnet 5.5 je na claude.ai dál zdarma a bezplatná aplikace Gemini dál běží v režimu Auto, takže výběr Gemini 3.6 Flash v aplikaci vyžaduje Google AI Plus.
V říjnu přešel bezplatný model ChatGPT od 8. října z GPT-5.6 Luna na GPT-6 Luna, který tak převzal řádek pro eseje, bezplatná aplikace Gemini přešla 9. října na Auto, Anthropic 7. října vydal Claude Haiku 5.5, který si mohou vybrat i bezplatné účty Claude, a Gemini 4 Argon dorazil 13. října s Google AI Pro, takže ho mají studenti v USA s bezplatným rokem AI Pro od Googlu.
Nejlepší AI pro práci & profesionály
Nejlepší AI pro profesionální práci je GPT-6 (výchozí model ChatGPT od 7. října, na placených tarifech Sol) pro každodenní znalostní práci, Claude Opus 5.5 pro programování a psaní s vysokou mírou odpovědnosti a Gemini Spark pro agentické workflow 24/7.
Většina profesionálů vytěží nejvíc ze dvou placených předplatných (ChatGPT Plus za $20/měsíc plus Claude Pro za $20/měsíc, celkem $40/měsíc). Nebo jedno předplatné: Fello AI pokryje ChatGPT, Claude i Gemini pro každodenní práci. Pro agentickou práci, která běží, i když spíte, je Gemini Spark stále aktivní cloudový agent uvnitř Google Workspace a od 30. července je dostupný na tarifu Google AI Pro za $19,99/měsíc i v Google AI Ultra; alternativami jsou OpenAI dots, Grok Bot a Muse od Mety, popsané v sekci o agentech výše.
| Případ použití | Nejlepší model | Klíčový údaj | Cena | Alternativa |
|---|---|---|---|---|
| Každodenní znalostní práce | GPT-6 | Výchozí model ChatGPT od 7. října; na Plus GPT-6 Sol | $20/měs. ChatGPT Plus | Claude Opus 5.5 |
| Právní, finanční a daňový výzkum | Gemini 4 Argon | #1 HLAB 1.1 (27,1 %), test právních agentů od Harvey ve Vals Indexu; #2 Finance Agent v2.1 (67,7 %); #1 AutomationBench-AA (77,5 %) mezi modely, které můžete používat | $19,99/měs. Google AI Pro | Claude Opus 5.5 |
| ChatGPT Work a Codex | GPT-6.1 Sol | V ChatGPT Work a Codexu pro Plus, Pro, Business, Enterprise a Edu od 29. září, v API za $2 / $10 | $20/měs. ChatGPT Plus | GPT-6 Luna na objemovou práci |
| Programování (proprietární) | Claude Opus 5.5 | #1 Arena WebDev (1810) a #1 FrontierCode 2.0 (46,4 %), za $4 / $20 | $20/měs. Claude Pro | Claude Sonnet 5.5, který vede LiveBench Coding za poloviční cenu za token |
| Programování (úsporné) | Claude Sonnet 5.5 | #1 LiveBench Coding (91,4) a #3 Terminal-Bench 4.0 (63,6 %); $1,64 na úlohu indexu při vysokém úsilí | $2 / $10 | Kimi K3.1 Pro; DeepSeek V4.1-Flash-1017 |
| Výzkum & podklady | Gemini 3.1 Pro | 98 % ARC-AGI-1 za $0.52/úlohu, ukotvení Google | Google AI Pro / Ultra | Claude Opus 5.5 |
| Těžká matematika, fyzika, finanční modelování | GPT-6 Astra | #1 LiveBench Reasoning a ARC-AGI-2 (95 %); uvádí 97,6 % FrontierMath Tier 4 v2 | $100/měs ChatGPT Pro | GPT-6.1 Sol; Qwen 3.7 Max |
| Nepřetržité agentické workflow | Gemini Spark | Nepřetržitý cloudový agent v Google Workspace | Od $19.99/měs. Google AI Pro | Claude Cowork |
| Aktuální zprávy, tvorba v kontextu X | Grok 4.7 | 35,2 na Intelligence Indexu v5 + nativní ukotvení v X; v aplikaci Grok od 3. října | $30/měs. Premium (X Subscription) | Gemini 3.1 Pro |
| Konsolidace vše v jednom | Fello AI | ChatGPT + Claude + Gemini + Grok + DeepSeek | Od $11.99/měs. | Platit každému dodavateli zvlášť |
Řádek každodenní znalostní práce zůstává modelu GPT-6, výchozímu modelu ChatGPT od 7. října, a od minulé aktualizace žádný řádek nezměnil držitele: Gemini 4 Argon si drží řádek pro právo, finance a daně, na AutomationBench-AA je nad ním jen dosud neveřejný Gemini 4 Carbon, a Claude Opus 5.5 si drží řádek proprietárního programování, nyní s 1810 na Arena WebDev. V říjnu Vals 27. října znovu spočítala svůj index s Claude Sonnet 5.5 na prvním a Carbonem na druhém místě, Argon 13. října převzal nový řádek pro právo, finance a daně na základě HLAB 1.1 a Finance Agent v2.1, Kimi K3.1 Pro převzal od Sonnet 5.5 Terminal-Bench 4.0 a řádky programování přešly na FrontierCode 2.0 z Intelligence Indexu v5.
Ceny AI modelů v listopadu 2026
Od bezplatných tarifů za $0 až po Google AI Ultra za $199,99 měsíčně. Nejdůležitější cenou v této tabulce je Claude Opus 5.5 za $4 / $20: model s nejvyšším skóre na Intelligence Indexu v5 od Artificial Analysis, který můžete používat, stojí méně než Claude Opus 5, který nahradil ($5 / $25), a čtení z cache zlevňuje o 60 % na $0,20. Claude Fable 5.1 i GPT-6 Astra mají ceník $10 / $50 a oba mají nižší skóre. Gemini 4 Carbon od Googlu má o bod víc při oznámené úvodní ceně $2 / $10, zatím ho ale smějí používat jen kybernetičtí obránci.
Nejčastější cenou je nyní $2 / $10, kterou sdílejí Claude Sonnet 5.5, GPT-6 Sol, GPT-6.1 Sol a Kimi K3.1 Pro od Moonshotu, který má 46,5 za $3,68 na úlohu indexu. GPT-6.1 Sol je stále nejlevnější cestou přes 50 bodů indexu, za $0,59 na úlohu indexu při 50,3 a vysokém úsilí nebo za $1,27 při 54,6 na maximum, a GPT-6.1 Terra od OpenAI (26. října) cenu za token půlí na $1 / $5 při 51,3 za $0,96. U Sonnet 5.5 rozhoduje o účtu nastavení úsilí: úloha indexu stojí $1,64 při vysokém úsilí a $10,02 na maximum, na úrovni $10,04 u Opus 5.5, a Anthropic 7. října zlevnil čtení z cache na polovinu, na $0,10. Gemini 4 Argon od Googlu také začíná na úvodní ceně $2 / $10 (standardně $4 / $20) do 30. listopadu a od 13. října si ho v placeném API může koupit kdokoli.
Cena za token a cena za úlohu se mohou rozcházet. Grok 4.7 má ceník $2 / $6, úloha indexu ale stojí $6,18 za skóre 35,2, protože píše tolik výstupu. Mistral Large 4, jehož open weights Mistral zveřejnil 29. října, má nově ceník $0,70 / $2,10, polovinu ceny z doby preview, a úloha indexu stojí $2,06 za skóre 26,1. Muse Spark 1.3 od Mety za $1,25 / $4,25 byl na v4.3.2 volbou za nejlepší poměr ve špičkové třídě, za $1,60 na úlohu indexu při 48,1, a Artificial Analysis ho na v5 zatím neohodnotila.
Na levném konci je GPT-6 Luna nejlevnějším modelem na úlohu na celé stránce: $0,10 / $0,50, tedy $0,15 na úlohu indexu při 27,9 a maximálním úsilí. Claude Haiku 5.5 (7. října) má u promptů do 100 000 tokenů stejnou cenu za token a skóre 36,5 proti 27,9 u Luny, píše ale o tolik víc, že úloha indexu při maximálním úsilí stojí $0,41, případně $0,25 za 34,6 při xhigh; nad 100 000 tokenů cena stoupá na $0,50 / $2,50. Mezi otevřenými modely prodávanými po tokenech je volbou DeepSeek V4.1-Flash-1017, verze, kterou API DeepSeeku nabízí od 17. října, za $0,15 / $0,60 mimo špičku a $0,30 / $1,20 ve špičce ($0,60 na úlohu indexu při 32,6, druhém nejvyšším otevřeném skóre na v5 po Kimi K3.1 Pro), zatímco GLM 5.3 Flash za $0,15 / $0,50 má nově na v5 27,8 za $0,58 na úlohu indexu. MiMo-V2.6-Pro od Xiaomi je na úlohu levnější, $0,26 za 29,9, ale jen pokud si jeho 1,02 bilionu parametrů hostujete sami. Podrobnější rozbor najdete v našem úplném srovnání cen AI.
| Model | Vstup (za 1M) | Výstup (za 1M) | Kontext | Přístup zdarma? |
|---|---|---|---|---|
| GPT-6 Astra | $10.00 | $50.00 | 1 050 000 (max. vstup 922 000) | V Chatu na Pro, Business a Enterprise od 4. září; Plus ho má v ChatGPT Work a Codexu, ne v Chatu; bez bezplatného tarifu; v API živě |
| GPT-6 Sol | $2.00 | $10.00 | 1 050 000 (max. vstup 922 000) | Chat ChatGPT na Plus, Pro, Business a Enterprise od 7. října; Work a Codex; API |
| GPT-6.1 Sol | $2.00 | $10.00 | 1 050 000 (max. vstup 922 000) | ChatGPT Work a Codex na Plus, Pro, Business, Enterprise a Edu od 29. září; API; ne v Chatu; čtení z cache $0,10 |
| GPT-6.1 Terra | $1.00 | $5.00 | 1 050 000 (max. vstup 922 000) | ChatGPT Work a Codex na Plus, Pro, Business, Enterprise a Edu od 26. října; API; ne v Chatu; čtení z cache $0,05 |
| GPT-6 Luna | $0.10 | $0.50 | 1 050 000 (max. vstup 922 000) | Chat ChatGPT na Free a Go, zaváděno od 8. října; Work a Codex na placených tarifech; API |
| GPT-5.5 | $5.00 | $30.00 | 1M (400K v Codex) | ChatGPT Free; API placené |
| GPT-5.5 Pro | $30.00 | $180.00 | 1M | ChatGPT Pro od $100/měs. (úrovně s vyšším použitím $200 a $500) |
| GPT-5.6 Sol | $4.00 | $20.00 | Nezveřejněno | Živé v ChatGPT, Codex & API (9. července); promo sazba minimálně do 21. listopadu 2026 |
| GPT-5.6 Terra | $2.00 | $12.00 | Nezveřejněno | Živé v ChatGPT, Codex & API (9. července) |
| GPT-5.6 Luna | $0.20 | $1.20 | Nezveřejněno | Živé v ChatGPT, Codex & API (9. července) |
| Claude Opus 5.5 | $4.00 | $20.00 | 1M | Claude Pro/Max/Team; API placené; čtení z cache $0,20 |
| Claude Opus 5 | $5.00 | $25.00 | 1M | Starší model u Anthropicu; Pro/Max/API |
| Claude Opus 4.8 | $5.00 | $25.00 | 1M | Starší model u Anthropicu; Pro/Max/API |
| Claude Fable 5.1 | $10.00 | $50.00 | 1M | Čtení z cache $0.25; v Max/Team Premium (~50 % limitů použití); Pro/Team Standard přes kredity. Mythos 5.1 se účtuje stejně, jen na pozvání |
| Claude Fable 5 | $10.00 | $50.00 | 1M | Trvale v Max/Team Premium (~50 % limitů použití); Pro/Team Standard přes kredity |
| Claude Sonnet 5.5 | $2.00 | $10.00 | 1M | Zdarma na claude.ai; Pro/Max/Team; API placené; čtení z cache $0,10 od 7. října |
| Claude Sonnet 5 | $2.00 | $10.00 | 1M | Starší model od 28. září; záloha pro označené kyberbezpečnostní požadavky; API placené |
| Claude Sonnet 4.6 | $3.00 | $15.00 | 1M | API placené (nahrazeno Sonnet 5) |
| Claude Haiku 5.5 | $0.10 (≤100K) / $0.50 (>100K) | $0.50 (≤100K) / $2.50 (>100K) | 1M | Free, Pro, Max, Team i Enterprise na Claude.ai (web, iOS, Android); API placené; čtení z cache $0,01 |
| Gemini 3.1 Pro | $2.00 (≤200K) / $4.00 (>200K) | $12.00 (≤200K) / $18.00 (>200K) | 1M | Aplikace Gemini od 9. 10. s Google AI Pro a vyšším; API placené |
| Gemini 4 Argon | $2.00 úvodně do 30. 11. / $4.00 standardně ($0.10 z cache, úvodně) | $10.00 úvodně / $20.00 standardně | 1M, sdílený vstupem a výstupem | Placené API od 13. října; aplikace Gemini v Google AI Pro a Ultra |
| Gemini 4 Carbon | $2.00 úvodní / $4.00 později (oznámeno) | $10.00 úvodní / $20.00 později | Nezveřejněno | Oznámen 28. října; jen pro kybernetické obránce a partnery Fairwind, bez data pro veřejné API nebo aplikaci Gemini |
| Gemini 3.8 Flash | $0.75 úvodní / $1.50 od 1. 1. 2027 | $3.75 úvodní / $7.50 od 1. 1. 2027 | 1M | AI Studio, Antigravity, Gemini Enterprise + placené API; v aplikaci Gemini hlášeno pro AI Pro/Ultra |
| Gemini 3.7 Flash | $0.75 úvodní / $1.50 od 1. 1. 2027 | $3.75 úvodní / $7.50 od 1. 1. 2027 | 1M | AI Studio, Android Studio, Antigravity + placené API; v aplikaci Gemini jen přes Spark (AI Pro/Ultra, mimo EHP/UK/CH/Nigérii) |
| Gemini 3.6 Flash | $0.75 úvodní / $1.50 od 1. 1. 2027 | $3.75 úvodní / $7.50 od 1. 1. 2027 | 1M | Aplikace Gemini od 9. 10. s AI Plus a vyšším; AI Studio; bezplatná úroveň API + placené API |
| Gemini 3.5 Flash-Lite | $0.30 | $2.50 | 1M | AI Studio; bezplatná úroveň API + placené API |
| Qwen3.8-Max-0902 | $2.00 ($0.17 explicitní cache hit, $0.25 implicitní) | $6.00 | 1M (výstup 128K) | Pouze API na QwenCloud; bez spotřebitelského chatu; otevřené váhy jen u textové verze Qwen3.8-2.4T-A95B, na které stojí |
| Qwen 3.7 Max | $1.25 promo / $2.50 ceníková | $3.75 promo / $7.50 ceníková | 1M | 200 dotazů zdarma/den; API placené nad rámec |
| MiniMax M3 | $0.30 (50 % z $0.60) | $1.20 (≤512K) | 1M | Open weights; náklady na hosting |
| LongCat-2.0 | Závisí na poskytovateli | Závisí na poskytovateli | 1M | Open weights (MIT); náklady na hosting |
| NVIDIA Nemotron 3 Ultra | Závisí na poskytovateli | Závisí na poskytovateli | 1M | Open weights (OpenMDW); náklady na hosting |
| Qwen 3.5 (open-weight) | Self-host / Together | Self-host / Together | 1M | Open weights; náklady na hosting |
| Nex-N2-Pro | Self-host / poskytovatelé | Self-host / poskytovatelé | 1M | Open weights (Apache 2.0); náklady na hosting |
| Rio 3.5 Open 397B | Self-host / poskytovatelé | Self-host / poskytovatelé | 1M | Open weights (MIT); náklady na hosting |
| Grok 4.3 | $1.25 | $2.50 | 1M | Bezplatný spotřebitelský plán; API placené |
| Grok 4.6 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | API SpaceXAI, Cursor, Grok Build, OpenRouter, Vercel, Cloudflare |
| Grok 4.7 | $2.00 (<200K) / $4.00 (≥200K) | $6.00 (<200K) / $12.00 (≥200K) | 500K | API SpaceXAI, Cursor, Grok Build, harnessy a cloudové routery; od 3. října i režim Expert aplikace Grok |
| Muse Spark 1.3 | $1.25 ($0.10 úroveň Contributor) | $4.25 ($0.20 úroveň Contributor) | 1M | Placené API; Muse Code, Meta Model API a OpenRouter; úroveň Contributor mění práva k trénování za ~92% slevu |
| Muse Wonder | $4.00 | $20.00 | 1M | Placené API; Meta Model API, Muse Code a OpenRouter; Muse Wonder Full jen v Muse Code, v tarifech $50 a $200 |
| Kimi K3 | $3.00 ($0.30 cache-hit) | $15.00 | 1M | Bezplatná základní úroveň v aplikaci Kimi; open weights na Hugging Face (Kimi K3 License) |
| Kimi K3.1 Pro | $2.00 ($0.20 cache-hit) | $10.00 | 1M | Kimi.com, aplikace Kimi, Kimi Work, Kimi Code a Kimi API od 23. října; open weights na Hugging Face od 2. listopadu (Kimi K3.1-Pro License); varianta Highspeed za dvojnásobnou cenu |
| Mistral Large 4 | $0.70 ($0.07 cache) | $2.10 | 1M | Mistral API, Mistral Studio, OpenRouter a Microsoft Foundry; open weights na Hugging Face od 29. října pod licencí Mistral Ecosystem Open-Weight License (upravená MIT) |
| Gemini Omni Flash (video) | $1.50 | $17.50 (video výstup) | 10sekundové klipy | Aplikace Gemini / Flow; AI Studio + API |
| DeepSeek V4-Pro | $0.66 mimo špičku / $1.32 ve špičce ($0.022 cache-hit mimo špičku) | $1.98 mimo špičku / $3.96 ve špičce | 1M | DeepSeek Chat zdarma; API placené, špičkové a mimošpičkové sazby od 16. srpna |
| DeepSeek V4.1-Flash-1017 | $0.15 mimo špičku / $0.30 ve špičce ($0.003 cache hit mimo špičku) | $0.60 mimo špičku / $1.20 ve špičce | 1M | DeepSeek Chat zdarma; API placené, tarify mimo špičku a ve špičce; verze 1017 od 17. října za stejné ceny |
| Kimi K2.7 Code | Závisí na poskytovateli | Závisí na poskytovateli | 256K | Open weights; náklady na hosting |
| GLM-5.2 | Závisí na poskytovateli | Závisí na poskytovateli | 1M | Open weights; náklady na hosting |
| GLM 5.3 | $1.40 ($0.26 cache-hit) | $4.40 | 1M | Z.ai API, GLM Coding Plan a ZCode; váhy na Hugging Face od 28. srpna pod vlastní licencí GLM 5.3 License |
| GLM 5.3 Flash | $0.15 ($0.03 cache-hit) | $0.50 | 1M | Z.ai API, GLM Coding Plan, OpenRouter; váhy pod MIT na Hugging Face; úvodní akce skončila 9. září |
| Tencent Hy4 Preview | $0.834 ($0.042 cache-hit) | $2.501 | 1M+ | Otevřené váhy (Apache 2.0); Tencent Cloud TokenHub, OpenRouter, WorkBuddy, CodeBuddy |
| Qwen3.8-Flash-Next | Podle poskytovatele | Podle poskytovatele | 262K (do 1M) | Otevřené váhy (Qwen Community License 1.0); náklady na hosting se připočítávají |
| MiMo-V2.6-Pro | $0.435 | $0.87 | 1M | Otevřené váhy (MIT); náklady na hosting se platí |
| ERNIE 5.1 | Ceny pro region Čína | Ceny pro region Čína | 256K | Bezplatná úroveň Baidu |
| Gemini Spark (agent) | Bez ceny API | Bez ceny API | 1M (základ Gemini) | Google AI Pro $19.99, AI Ultra $99.99 nebo $199.99/měs. |
| Fello AI (agregátor) | Směrováno přes aplikaci | Směrováno přes aplikaci | Závisí na modelu | Od $11.99/měs., bezplatná verze dostupná |
Výše uvedené sazby pro GPT-5.5 a GPT-5.5 Pro jsou ceny pro krátký kontext; OpenAI již specifické údaje pro dlouhý kontext nezveřejňuje. Úrovně GPT-5.6 se účtují za 2násobek vstupu a 1,5násobek výstupu, jakmile prompt přesáhne 272K vstupních tokenů, což dává long-context Terra na $4 / $18 a Luna na $0.40 / $1.80. Úrovně GPT-6 nesou nad 272K vstupních tokenů stejnou přirážku, uplatněnou na celý požadavek, a čtení z cache je u nich o 90 % levnější: $1.00 u Astry, $0.20 u GPT-6 Sol a $0.01 u Luny, u GPT-6.1 Sol o 95 %, tedy $0.10.
Grok 4.6 funguje stejně, ale tvrději: od 200 000 tokenů v promptu výše přeúčtuje SpaceXAI celý požadavek vyšší sazbou, nikoli jen to, co limit přesahuje, takže překročení o tisíc tokenů zdvojnásobí cenu celého volání. Druhým ceníkem, který je třeba číst dvakrát, je DeepSeek: od 16. srpna se oba modely V4 účtují špičkovou sazbou od 01:00 do 04:00 a od 06:00 do 10:00 UTC ve všední dny a přesně poloviční v každou jinou hodinu, takže stejná úloha může stát dvojnásobek podle toho, kdy ji spustíte.
Nejlevnější cestou touto tabulkou je často jedno předplatné místo tří. Fello AI spojuje GPT, Claude, Gemini, Grok, Perplexity a další v jediné aplikaci pro Mac, iPhone a iPad, ve většině zemí od $11,99 měsíčně.
Nejlepší open-weight modely v listopadu 2026
Nejlepším open-weight modelem v listopadu 2026 je Kimi K3.1 Pro od Moonshotu, jehož váhy jsou na Hugging Face od 2. listopadu: 2,8 bilionu parametrů, z nichž je 104 miliard aktivních, a kontext 1M tokenů, pod vlastní licencí Moonshotu Kimi K3.1-Pro License. Artificial Analysis mu na novém Intelligence Indexu v5 dává 46,5, o 13,9 bodu víc než dalšímu otevřenému modelu, DeepSeek V4.1-Flash-1017 s 32,6, a na Terminal-Bench 4.0 je se 67,2 % první ze všech modelů. Je i nejvýše postaveným otevřeným modelem na žebříčku WebDev v Areně, 9., a v Agent Areně, 13. V Kimi API stojí $2 / $10 za 1M tokenů, tedy $3,68 na úlohu indexu, a stažení má zhruba 1,56 TB, takže jde o model pro datová centra, ne pro pracovní stanici.
V4.1-Flash-1017 od DeepSeeku, vydaný 17. října pod licencí MIT, držel toto místo do 2. listopadu a dál je nejvýhodnějším otevřeným modelem prodávaným po tokenech: 32,6 na v5 za $0,60 na úlohu indexu, $0,15 / $0,60 za 1M tokenů mimo špičku, 552 miliard parametrů, z nichž je 8 miliard aktivních při prefillu a 16 miliard při dekódování, a 16. místo na Arena WebDev. MiMo-V2.6-Pro od Xiaomi, zveřejněný 21. září pod čistou licencí MIT, je nejlevnějším silným otevřeným modelem na úlohu, za $0,26, a GLM-5.3 dosahuje na Terminal-Bench 4.0 41,9 %, i když pod vlastní licencí Z.ai, a ne pod MIT.
Jedno říjnové vydání stojí těsně mimo tento žebříček. MiniMax-M3.1-Flash, jehož váhy jsou na Hugging Face pod komunitní licencí MiniMaxu, má 29,1 při 428B celkových a 23B aktivních parametrech za $0,49 na úlohu indexu, o něco levněji na úlohu než DeepSeek V4.1-Flash-1017, ale o 3,5 bodu níž.
Pro týmy, které provozují vlastní váhy, je praktickou volbou dál GLM 5.3 Flash (Z.ai, MIT): 27,8 na v5, případně 41,8 na v4.3.2, při 320B celkových a 18B aktivních parametrech. Jde o samostatný model na nově natrénovaném základu, ne o zmenšený GLM 5.3, a proto vychází pod licencí MIT. Model s 1,02 bilionu parametrů na pracovní stanici nepatří a samotné stažení K3 má asi 1,56 TB. DeepSeek-V4.1-Flash-1017 nahradil 17. října zářijovou verzi V4.1-Flash za nezměněné ceny: MIT, nativně multimodální, $0,15 / $0,60 mimo špičku.
Další čtyři stojí za sledování. Mistral Large 4, jehož open weights Mistral zveřejnil 29. října pod vlastní upravenou licencí MIT, je nejvýše hodnoceným otevřeným modelem z USA nebo Evropy, s 26,1 na v5 za $2,06 na úlohu indexu, mezi otevřenými modely je to ale až osmé místo a firma, která ho prodává jako hostovanou službu, potřebuje od Mistralu samostatnou komerční licenci. Qwen3.8-Flash-Next od Alibaby, 125B a jen 6B aktivních, předznamenává architekturu Qwen4 a na v4.3.2 měl 39,8. Hy4 Preview od Tencentu, 770B celkem a 49B aktivních pod Apache 2.0, hodnocení od Artificial Analysis nemá, na Arena WebDev je ale 23. Muse Spark Open od Mety, vydaný 15. října s 816B celkem a 42B aktivních, má na v5 24,9 pod vlastní licencí Muse Model License od Mety, a ne pod licencí open source.
| Model | Nejlepší pro | Klíčový benchmark | Kontext / Licence | Kde spustit |
|---|---|---|---|---|
| Kimi K3.1 Pro | Nejlepší otevřený model | II 46,5 (v5.0), nejvyšší otevřené skóre o 13,9 bodu, za $3,68 na úlohu indexu; #1 Terminal-Bench 4.0 (67,2 %); nejvýše postavený otevřený model na Arena WebDev (#9) i v Agent Areně (#13); 2.8T/104B aktivních | 1M / Kimi K3.1-Pro License | Hugging Face (96 shardů, 1.56 TB), Kimi API ($2/$10) |
| DeepSeek V4.1-Flash-1017 | Nejvýhodnější otevřený model prodávaný po tokenech | II 32,6 (v5.0), druhý mezi otevřenými modely, za $0,60 na úlohu indexu; #16 Arena WebDev, #18 v Agent Areně; 552B, 8B aktivních při prefillu a 16B při dekódování | 1M / MIT | DeepSeek API ($0.15/$0.60 mimo špičku, $0.30/$1.20 ve špičce), lokálně |
| Kimi K3 | Předchůdce Kimi K3.1 Pro, stejná velikost 2,8 bilionu | II 43,6 (v4.3.2); #18 Arena WebDev a #27 Agent Arena; 2.8T/104B aktivních | 1M / Kimi K3 License | Hugging Face (96 shardů, 1.56 TB), Moonshot API, poskytovatelé |
| GLM 5.3 Flash | Nejlepší otevřený model, který si většina týmů skutečně dokáže provozovat | II 27,8 (v5.0) za $0.58 za úlohu indexu, 41,8 na v4.3.2, nejmenší z předních otevřených modelů; 320B/18B aktivních, nativně multimodální | 1M / MIT | Hugging Face, Z.ai API ($0.15/$0.50), OpenRouter |
| GLM-5.2 | Záložní volba s nezávislým záznamem | II 33,7 (v4.3.2); #33 Arena WebDev (1606), #25 Agent Arena; 744B/40B aktivních | 1M / MIT | Z.ai, Hugging Face, OpenRouter |
| GLM 5.3 | Otevřený od 28. srpna, ale pod vlastní licencí | II 31,7 (v5.0), třetí mezi otevřenými modely; stejný základ 744B jako GLM-5.2, jen dotrénovaný, zveřejněný checkpoint počítán na 753B; CyberGym 84,5 % a Terminal-Bench 3.0 28,3 (údaje dodavatele) | 1M / GLM 5.3 License (model-as-a-service nad 10 mld. USD tržeb potřebuje bezpečnostní revizi Z.ai) | Hugging Face, Z.ai API ($1.40/$4.40), GLM Coding Plan, ZCode |
| MiMo-V2.6-Pro | Nejlevnější silný otevřený model na úlohu | II 29,9 (v5.0), čtvrtý mezi otevřenými modely, za $0,26 na úlohu indexu; 34,8 % Terminal-Bench 4.0; GDPval-AA v2.1 1689; #17 Agent Arena, druhý mezi otevřenými modely po Kimi K3.1 Pro; 1,02 bilionu/42 mld. aktivních | 1M / MIT | Hugging Face (XiaomiMiMo), poskytovatelé, vlastní hosting |
| MiniMax-M3.1-Flash | Levný otevřený model pro kód a agenty | II 29,1 (v5.0) za $0,49 na úlohu indexu; 428B/23B aktivních, vstup text, obrázky a video; #38 Arena WebDev (1582) | 1M / MiniMax Community License | Hugging Face, MiniMax, vlastní hosting |
| Mistral Large 4 | Nejvýše hodnocený otevřený model z USA nebo Evropy | II 26,1 (v5.0) za $2,06 na úlohu indexu, osmý mezi otevřenými modely; přibližně 1T celkem a 49B aktivních, nativně multimodální; #48 Arena WebDev (1544) | 1M / Mistral Ecosystem Open-Weight License (upravená MIT) | Hugging Face, Mistral API ($0.70/$2.10), OpenRouter, Microsoft Foundry |
| Tencent Hy4 Preview | Zatím největší permisivně licencovaný model | 770B/49B aktivních; 2,99/4,00 na vlastním panelu Tencentu se 203 úlohami proti 2,94 u Kimi K3 a 2,92 u GLM 5.3 (dodavatel); bez hodnocení Artificial Analysis; #23 Arena WebDev (1631), #26 Agent Arena | 1M+ / Apache 2.0 | Hugging Face (BF16 a FP8), Tencent Cloud TokenHub, OpenRouter |
| Qwen3.8-Flash-Next | Ukázka architektury Qwen4 | 125B celkem plus N-gramové embedding s 51B, 6B aktivních; 91,7 GPQA Diamond a 62,5 SWE-Bench Pro (dodavatel); II 39,8 (v4.3.2); #24 Arena WebDev (1628) | 262K až 1M / Qwen Community License 1.0 | Hugging Face, poskytovatelé, self-host |
| LongCat-2.0 | Frontier otevřený kodér trénovaný na čínských čipech | II 33 (v4.1); 59,5 % SWE-Bench Pro (dodavatel), 1.6T/~48B aktivních | 1M / MIT | Hugging Face, GitHub, OpenRouter |
| MiniMax M3 | Levný multimodální model s dlouhým kontextem | II 18,9 (v5.0; 29,2 na v4.3.2), 59 % SWE-Bench Pro, multimodální | 1M / MiniMax Community License | Hugging Face, API $0.30/1M (50 % sleva) |
| Nex-N2-Pro | Nejsilnější otevřené programátorské skóre | II 41 (v4.1); 80,8 SWE-Bench Verified, 397B/17B aktivních | Založeno na Qwen / Apache 2.0 | Hugging Face, poskytovatelé, self-host |
| Kimi K2.7 Code | Nejsilnější komerčně licencovaný otevřený kodér | +21,8 % na Kimi Code Bench v2 vs. K2.6 (dodavatel); 1T/32B aktivních | 256K / Modified MIT | Hugging Face, DeepInfra, poskytovatelé |
| DeepSeek V4-Pro | Agentická práce v reálném světě | II 44 (v4.1), 1.6T/49B aktivních | 1M / MIT | DeepSeek API ($0.66/$1.98 mimo špičku, $1.32/$3.96 ve špičce od 16. srpna), lokálně |
| Hy3 | Nejnovější účastník s permisivní licencí | II 41 (v4.1); #64 na Arena WebDev (1505) | Apache 2.0 | Hugging Face, poskytovatelé, self-host |
| Inkling | První open-weight model Thinking Machines | II 41 (v4.1), agentický 32,3, vydán 15. července | Open weights | Hugging Face, poskytovatelé, self-host |
| Inkling Small | Stejná rodina při čtvrtině velikosti | II 40 (v4.1), agentický 30,8; 276B/12B aktivních, vstup text, obrázek a zvuk | Apache 2.0 | Hugging Face (BF16 a NVFP4), poskytovatelé, self-host |
| NVIDIA Nemotron 3 Ultra | Laděno NVIDIA, plně permisivní licence | II 38 (v4.1), 65-70,4 SWE-Bench Verified, 550B/55B aktivních | 1M / OpenMDW | OpenRouter, Hugging Face, AWS (8x B200 self-host) |
| Qwen 3.5 (397B / 17B aktivních) | Multimodální, rychlé dekódování | 88,4 GPQA, 91,3 AIME 2026, 83,6 LiveCodeBench v6 | 1M / otevřené | Together, OpenRouter, lokálně |
| Qwen3.6-35B-A3B | Efektivní otevřený agentický kodér (3B aktivních) | 86,0 GPQA Diamond, 92,7 AIME 2026, 35B/3B aktivních | 262K (do 1M YaRN) / Apache 2.0 | Hugging Face, OpenRouter, lokálně |
| Qwen3.6-27B | Hustý kodér spustitelný na laptopu | 87,8 GPQA Diamond, hustý 27B, multimodální | 256K / Apache 2.0 | Lokálně Mac/PC, Hugging Face, OpenRouter |
| Rio 3.5 Open 397B | Fine-tune Qwen 3.5, vícejazyčné uvažování | 70,8 Terminal-Bench 2.1 (first-party), poráží Qwen 3.7 Plus na 4/5 | 397B/17B aktivních / MIT | Hugging Face, poskytovatelé, self-host |
| Llama 4 Maverick | Vlajkový model řady Meta | 17B aktivních / 400B celkových parametrů | Llama 4 license | Cloud Meta, Hugging Face, lokálně |
| NVIDIA Nemotron 3 Nano Omni | Edge / nízký výkon | Multimodální, velmi malá stopa | Kompaktní / otevřené | Lokálně, nástroj NVIDIA |
Licencování zde záleží stejně jako holé skóre a srpen rozdíl mezi oběma skupinami ještě prohloubil. Kimi K2.7 (Modified MIT), DeepSeek V4 (MIT), GLM 5.3 Flash (MIT), MiMo-V2.6-Pro (MIT), GLM-5.2 (MIT), LongCat-2.0 (MIT), Hy3 (Apache 2.0), Hy4 Preview (Apache 2.0), Nex-N2-Pro (Apache 2.0) a Nemotron 3 Ultra (OpenMDW) všechny jasně umožňují komerční použití bez zkoumání tržeb.
Zbytek nese podmínky, které je vhodné si přečíst dřív, než na nich začnete stavět: MiniMax M3, MiniMax-M3.1-Flash a MiniMax H3 vycházejí pod vlastními komunitními licencemi, přičemž H3 navíc vyžaduje žádost z USA, EU, Spojeného království a Jižní Koreje; upravená licence MIT u Mistral Large 4 vyžaduje od každého, kdo ho prodává jako hostovanou službu, samostatnou komerční licenci od Mistralu, interní použití je ale vyňato; Kimi K3 a Kimi K3.1 Pro sedí na vlastních licencích Moonshotu, které vyžadují samostatnou smlouvu od každé firmy s tržbami nad 20 milionů dolarů, která je přeprodává jako službu; GLM 5.3 vyžaduje bezpečnostní revizi Z.ai u každého provozovatele model-as-a-service s tržbami nad 10 miliard dolarů; a Qwen Community License 1.0 u Qwen3.8-Flash-Next vyžaduje samostatnou licenci od Qwenu pro provozování model-as-a-service nebo produktu typu AI pracovní asistent, byť interní použití je vyňato. Žádný open-weight model už není první na žádném žebříčku Areny, který sledujeme: Claude Opus 5 vzal žebříček Agent v červenci, poslední, který open-weight model vedl.
Benchmarky, ceny a praktické používání
Každé hodnocení na této stránce kombinuje tři vstupy: veřejné benchmarky od sedmi nezávislých firem (Artificial Analysis, Arena dříve LMArena, Scale SEAL, LiveBench, EQ-Bench, ARC Prize a oficiální žebříček Terminal-Bench 4.0, pokrývající Intelligence Index, GPQA Diamond, ARC-AGI-1 až 3, Humanity's Last Exam, GDPval-AA, FrontierMath, HMMT, MCP Atlas, SWE Atlas a Remote Labor Index), zveřejněné ceny API a předplatného z oficiální cenové stránky každého dodavatele a praktické používání redakčním týmem FelloAI, který spouští reálné prompty na téže úloze na každém modelu. Oficiální zdroje cen a benchmarků znovu načítáme před každou měsíční aktualizací.
Benchmarky jsou váženy podle případu použití: SWE-bench a Terminal-Bench pohánějí programování, GPQA Diamond a ARC-AGI-2 pohánějí přesnost, GDPval-AA (benchmark profesionálních výstupů od Artificial Analysis) informuje kvalitu profesionálních úloh, zatímco styl psaní se posuzuje primárně praktickým testováním, FrontierMath a HMMT pohánějí řešení problémů. Zveřejňujeme, když je benchmark hlášen dodavatelem, ale nezávisle neověřen, a vyřazujeme každé tvrzení, které nedokážeme reprodukovat proti živému zdroji. Řadíme podle naměřených skóre: koruna kategorie se posune, jakmile model překoná držitele na žebříčcích, které danou kategorii definují, aniž bychom čekali na žebříčky založené na hlasování, a model, který zatím není široce dostupný, je na kartě označen, nikoli o kartu připraven. Znovu ověřujeme pořadí, nejen čísla, protože skóre může zůstat správné, zatímco se žebříček kolem něj pohne. Když model mezi aktualizacemi projde velkým upgradem, kategorii přehodnotíme a přidáme řádek „Co se tento měsíc změnilo“ na konec podrobné analýzy.
Zeptejte se ChatGPT, Claude i Gemini a nechte si nejlepší odpověď. Bez tří předplatných.
Fello AI běží na Macu, iPhonu a iPadu a začít můžete zdarma.
Stáhnout Fello AI