Mise à jour, 25 septembre 2026 : GLM 5.2 est désormais un checkpoint hérité. Le GLM Coding Plan ne le sert plus et redirige vers GLM 5.3 les requêtes du forfait qui le visent. Dans l'Artificial Analysis Intelligence Index v4.3.2, il obtient 33,7, derrière le GLM 5.3 maison de Z.ai à 44,8, derrière Kimi K3 à 43,6 et derrière GLM 5.3 Flash sous licence MIT à 41,8. Les poids MIT et la grille tarifaire de l'API autonome n'ont pas changé, et les sections benchmarks et tarifs ci-dessous ont été réévaluées.
GLM 5.2 est arrivé le 13 juin 2026 avec trois chiffres marquants. Il s'agit d'une architecture Mixture-of-Experts à 744 milliards de paramètres dotée d'une fenêtre de contexte d'un million de tokens, sous licence MIT, ce qui rend les poids libres de téléchargement et d'utilisation pour tous. Le laboratoire chinois d'IA Zhipu AI (qui opère sous le nom de Z.ai) l'a présenté comme un modèle de pointe pensé d'abord pour le code, et le timing n'avait rien de discret. Il a été rendu public deux jours seulement après que les États-Unis ont ordonné à Anthropic de couper l'accès étranger à ses modèles Fable 5 et Mythos 5. Pour une vue d'ensemble, consultez notre comparatif sur la façon dont GLM se positionne face aux autres modèles de référence comme Claude, GPT et Gemini.
GLM 5.2 n'est plus le GLM vers lequel se tourner, et le signal le plus clair vient de Z.ai elle-même, qui a cessé de le servir dans son propre abonnement. Il reste le plus grand GLM publié sous une simple licence MIT, et les poids sont toujours là, prêts à être téléchargés. Notre comparatif des meilleurs modèles d'IA open source suit qui domine la catégorie aujourd'hui. Si la catégorie elle-même vous est nouvelle, notre explication sur ce qu'est l'IA open source détaille le fonctionnement réel des poids ouverts et des licences de modèles. Vous trouverez ci-dessous les caractéristiques techniques, ce qui le différencie de GLM 5.1, les benchmarks face à des rivaux comme le Seed 2.1 Pro de ByteDance, et ce que coûte réellement le GLM Coding Plan.
Les points essentiels
- GLM 5.2 a été lancé le 13 juin 2026 en tant que modèle Mixture-of-Experts à 744B de paramètres avec 40B de paramètres actifs par token.
- La fenêtre de contexte d'un million de tokens est environ 5 fois plus grande que la limite de ~200K de GLM 5.1, avec une sortie allant jusqu'à 131 072 tokens.
- Il est distribué sous licence MIT, avec des poids ouverts, une API autonome, et le chatbot Z.ai arrivé la semaine suivant le lancement.
- Le GLM Coding Plan se mesure désormais en crédits et commence à $18/mois (Lite), avec Pro à $80/mois et Max à $168/mois, et la facturation annuelle offre 30 % de réduction. Il ne fait plus tourner GLM 5.2.
- GLM 5.2 obtenait au lancement 62,1 sur SWE-bench Pro et 81,0 sur Terminal-Bench 2.1, devant GPT-5.5 et derrière Claude Opus 4.8. Dans l'Intelligence Index v4.3.2, il se situe aujourd'hui à 33,7, derrière GLM 5.3, Kimi K3 et GLM 5.3 Flash.
Qu'est-ce que GLM 5.2 ?
GLM 5.2 a été le grand modèle de langage phare de Zhipu AI, un laboratoire basé à Pékin devenu l'un des éditeurs de modèles à poids ouverts les plus offensifs de Chine, jusqu'à ce que GLM 5.3 le remplace en août 2026. Il appartient à la famille complète de modèles GLM de Zhipu. Il repose sur la base GLM-5 et utilise une architecture Mixture-of-Experts à 744 milliards de paramètres au total, dont seulement 40 milliards s'activent pour chaque token. Cette conception rapproche le coût d'exécution de celui d'un modèle à 40 milliards de paramètres tout en s'appuyant sur les connaissances d'un modèle bien plus vaste.
Cette sortie vise clairement les développeurs. Zhipu a positionné GLM 5.2 autour du code sur des horizons longs et du travail agentique, le genre de tâches en plusieurs étapes où un modèle écrit, exécute et révise du code sur l'ensemble d'un projet. Il se connecte aux clients de code populaires via un point d'accès compatible Anthropic, si bien que des outils comme Claude Code, Cline, OpenCode et OpenClaw peuvent s'y connecter sans SDK propriétaire.
Une chose a changé rapidement après le lancement. Zhipu a livré GLM 5.2 sans scores de benchmark publiés, comme le note la couverture du lancement par MarkTechPost, ce qui a laissé les premières affirmations « bat GPT-5 » comme de simples déclarations du vendeur. En quelques jours, des testeurs indépendants et la fiche technique de l'entreprise ont comblé ce vide, et les chiffres se sont révélés bien supérieurs à ceux du précédent GLM 5.1, qui avait obtenu 58,4 sur SWE-bench Pro. Les résultats complets figurent dans la section benchmarks ci-dessous.
GLM 5.2 face à GLM 5.1 : ce qui a changé
Le saut de GLM 5.1 (sorti le 7 avril 2026) à GLM 5.2 est incrémental sur le papier, mais significatif sur une dimension : le contexte. Le nouveau modèle traite cinq fois plus d'entrée, ce qui change ce que vous pouvez lui fournir en un seul prompt. Voici la comparaison côte à côte.
| Caractéristique | GLM 5.2 | GLM 5.1 | Ce qui a changé | Pourquoi c'est important |
|---|---|---|---|---|
| Date de sortie | 13 juin 2026 | 7 avril 2026 | ~2 mois d'écart | Cycle d'itération rapide |
| Paramètres | 744B (40B actifs) | 744B (40B actifs) | Inchangé | Même calcul par token |
| Fenêtre de contexte | 1 000 000 tokens | ~200 000 tokens | 5 fois plus grande | Des dépôts entiers en un seul prompt |
| Sortie maximale | 131 072 tokens | ~128K tokens | À peu près égal | Longues générations de code |
| Modes de raisonnement | High et Max | Mode unique | Deux niveaux d'effort | Ajuster profondeur et coût |
| Licence | MIT (poids publiés) | MIT | Inchangé | Poids entièrement ouverts |
| SWE-bench Pro | 62,1 | 58,4 | +3,7 points | Code plus solide |
Les deux modes de raisonnement sont nouveaux et pratiques. High gère la génération courante, tandis que Max est le réglage que Zhipu recommande pour le code complexe en plusieurs étapes, sacrifiant la vitesse pour un raisonnement plus approfondi. Le nombre de paramètres n'a pas bougé entre les deux versions. Les deux comptent 744B au total avec 40B actifs, si bien que le coût d'inférence par token reste inchangé. Ce que Zhipu a changé, c'est l'architecture autour. La fiche du modèle cite IndexShare, qui réutilise un seul indexeur toutes les quatre couches d'attention parcimonieuse et réduit les FLOPs par token de 2,9 fois à un contexte d'un million de tokens. Elle mentionne aussi une couche MTP améliorée pour le décodage spéculatif qui augmente la longueur d'acceptation jusqu'à 20 %.
Benchmarks de GLM 5.2 : ses performances réelles
Le lancement a laissé un vide, mais les données l'ont comblé rapidement. La propre fiche technique de Zhipu et des testeurs indépendants plaçaient GLM 5.2 près de la frontière des modèles fermés sur le code à horizon long. Sur certains tests, l'écart avec Claude Opus 4.8 se réduisait à environ un seul point, comme le détaille la couverture de The Decoder. Ce cadrage a depuis évolué à plusieurs reprises. Opus 4.8 a cédé la place à Claude Opus 5 le 24 juillet 2026, puis à Claude Fable 5.1 le 1er septembre 2026, et Claude Opus 5.5 a pris la place de modèle phare le 22 septembre 2026. Dans l'Artificial Analysis Intelligence Index v4.3.2, relevé le 25 septembre 2026, Opus 5.5 domine avec 57,6 et Fable 5.1 se situe à 53,4, tandis que GLM 5.2 obtient 33,7, derrière Kimi K3 à 43,6 et derrière le GLM 5.3 maison de Z.ai à 44,8. Le tableau ci-dessous conserve la comparaison réellement effectuée par Zhipu en juin 2026, face à Opus 4.8 et GPT-5.5.
| Benchmark | GLM 5.2 | Claude Opus 4.8 | GPT-5.5 | GLM 5.1 |
|---|---|---|---|---|
| SWE-bench Pro (code) | 62,1 | 69,2 | 58,6 | 58,4 |
| Terminal-Bench 2.1, Terminus-2 (agentique) | 81,0 | 85 | 84 | 63,5 |
| FrontierSWE (horizon long) | 74,4 % | 75,1 % | 72,6 % | n/a |
Le résultat marquant est SWE-bench Pro, où le 62,1 de GLM 5.2 dépasse GPT-5.5 à 58,6 et son propre prédécesseur à 58,4, tout en restant derrière Claude Opus 4.8 à 69,2. Sur Terminal-Bench 2.1, il a bondi à 81,0 depuis le 63,5 de GLM 5.1 sur le harnais Terminus-2, et sur FrontierSWE, il se situe à moins d'un point derrière Opus 4.8 tout en devançant GPT-5.5. Le choix du harnais compte plus qu'il n'y paraît. Artificial Analysis, qui exécutait lui-même Terminal-Bench 2.1 cet été-là, attribuait à GLM 5.2 un score de 77,9 contre 85,0 pour Kimi K3 et 84,6 pour Opus 4.8, il faut donc lire tout chiffre isolé en gardant le harnais à l'esprit. Il affiche aussi 99,2 % au test de mathématiques AIME 2026. Pour donner une idée de ce que l'orchestration peut apporter à ces chiffres, le Fugu de Sakana AI atteint 73,7 sur SWE-Bench Pro en répartissant les tâches sur un ensemble de modèles plutôt qu'en s'exécutant seul.
Le véritable titre, en juin 2026, c'était l'économie. GLM 5.2 égalait ou battait GPT-5.5 sur ces marathons de code pour environ un sixième du coût, ce qui le faisait passer du statut d'alternative bon marché à celui de concurrent sérieux. Le seul bémol venait de la plateforme indépendante Artificial Analysis, qui a constaté que le modèle consomme bien plus de tokens que ses rivaux pour atteindre ces scores, ce qui en fait l'une des options les moins efficaces en tokens de sa catégorie. C'est ce bémol qui tranche aujourd'hui la question. Artificial Analysis chiffre le coût d'un passage de son index avec GLM 5.2 à $0.96 par tâche contre $0.25 avec GLM 5.3 Flash, qui marque huit points de plus. Sur des tests de raisonnement en un seul coup difficiles comme Humanity's Last Exam, il reste derrière Opus 4.8 et Gemini 3.1 Pro de plusieurs points, ce qui en fait avant tout un spécialiste du code et des agents.
Pourquoi la fenêtre de contexte d'un million de tokens compte
Une fenêtre de contexte d'un million de tokens signifie que GLM 5.2 peut contenir environ 750 000 mots d'entrée en une seule fois. En pratique, vous pouvez y coller une base de code entière de taille moyenne, un jeu complet de documentation d'API, ou un long corpus de recherche, et demander au modèle de raisonner sur l'ensemble sans découpage. Le modèle est étiqueté glm-5.2[1m] pour signaler la fenêtre étendue, et Z.ai décrit cette capacité comme « utilisable » plutôt que comme un plafond marketing.
Pour le code en particulier, c'est la différence entre donner au modèle un seul fichier et lui donner tout le dépôt. Les outils agentiques qui devaient auparavant résumer ou récupérer des fragments d'un projet peuvent désormais garder bien plus en mémoire de travail. Cela réduit les erreurs qui apparaissent quand un modèle perd la trace de code qu'il ne peut pas voir. Cette force en contexte long est la même raison pour laquelle les modèles ouverts conçus pour tourner sur un Mac ont gagné en popularité auprès des développeurs qui veulent garder le contrôle en local.
GLM 5.2 et le contexte du contrôle des exportations
La date de lancement compte. Dans les jours précédant l'annonce de GLM 5.2, le secrétaire au Commerce des États-Unis a ordonné à Anthropic de bloquer l'accès étranger à Fable 5 et Mythos 5 sous 48 heures, en vertu d'une nouvelle directive de contrôle des exportations. Anthropic a désactivé les deux modèles dans le monde entier en quelques heures, et vous pouvez lire le déroulé complet dans notre couverture de l'arrêt de Fable 5.
Zhipu a présenté GLM 5.2 comme un contrepoids direct. En publiant un modèle de pointe sous licence MIT sans restriction régionale, l'entreprise a vendu les poids ouverts comme une assurance contre le contrôle de l'IA fondamentale par une seule nation ou un seul fournisseur. Les investisseurs ont réagi vite, et l'action de Zhipu a grimpé après l'annonce open source, selon le South China Morning Post. Cela s'inscrit dans une vague plus large de sorties ouvertes chinoises qui inclut la famille Qwen et DeepSeek V4.
Tarifs et disponibilité de GLM 5.2
GLM 5.2 a été déployé immédiatement sur tous les niveaux du GLM Coding Plan, avec l'API autonome, le chatbot Z.ai et les poids MIT téléchargeables, tous publiés dans la semaine suivant le lancement. Cela a changé deux fois depuis. Le forfait est passé à un système de crédits le 30 juillet 2026, qui a remplacé les anciens quotas de prompts, et il ne sert plus du tout GLM 5.2 : Z.ai redirige vers GLM 5.3 les requêtes du forfait visant GLM 5.2 et GLM 5.1. Il reste le même point d'accès compatible Anthropic, une fenêtre glissante de 5 heures et un plafond hebdomadaire, avec une réduction de 30 % sur chaque niveau en facturation annuelle. Les crédits sont décomptés selon des multiplicateurs de tokens qui varient par modèle, et l'usage en heures creuses coûte la moitié du tarif standard, les heures de pointe allant du lundi au vendredi de 14:00 à 18:00, heure de Singapour.
GLM Coding Plan Lite ($18/mois)
Le niveau d'entrée coûte $18/mois, soit $151.20 par an, ce qui revient à $12.60/mois. Il couvre 2 000 crédits toutes les 5 heures et 10 000 par semaine, ce qui convient aux développeurs individuels ayant une assistance de code modérée. C'est le moyen le moins cher de faire tourner GLM 5.3 dans un outil comme Claude Code.
GLM Coding Plan Pro ($80/mois)
Pro coûte $80/mois, soit $672 par an à $56/mois, et relève le plafond à 12 000 crédits toutes les 5 heures et 60 000 par semaine. Il vise les utilisateurs avancés qui font des refontes multi-fichiers et des tâches agentiques au quotidien.
GLM Coding Plan Max ($168/mois)
Max coûte $168/mois, soit $1,411.20 par an à $117.60/mois, et permet 28 000 crédits toutes les 5 heures et 140 000 par semaine, pour les développeurs qui font tourner un agent toute la journée de travail. La tarification par équipe se fait au poste pour les organisations. Pour voir comment cela se compare aux modèles ouverts rivaux, notre analyse de Rio 3.5 Open couvre une autre sortie chinoise à poids ouverts qui mérite la comparaison.
Faut-il utiliser GLM 5.2 ?
Si vous écrivez du code et voulez un modèle à contexte long que vous pouvez exécuter vous-même, GLM 5.2 reste le plus grand GLM sous une simple licence MIT, ce qui supprime les restrictions habituelles sur l'usage commercial. Ce qui a changé, c'est qu'il n'est plus ni le seul GLM auto-hébergeable, ni le meilleur. Son successeur, GLM 5.3, a publié ses poids en août 2026, mais sous la licence maison de Z.ai plutôt que sous MIT, et GLM 5.3 Flash est un modèle multimodal plus petit de 320B, sous MIT, qui devance GLM 5.2 de huit points dans l'Intelligence Index et coûte quatre fois moins cher à faire tourner. Kimi K3 obtient lui aussi un meilleur score, mais il est distribué sous une licence Moonshot personnalisée et pèse 1,56 To à télécharger contre 1,51 To pour GLM 5.2. Le contexte d'1M de tokens reste un vrai avantage pour le travail à l'échelle d'un dépôt, et le point d'accès compatible Anthropic signifie que vous pouvez l'intégrer aux outils existants avec un minimum de friction.
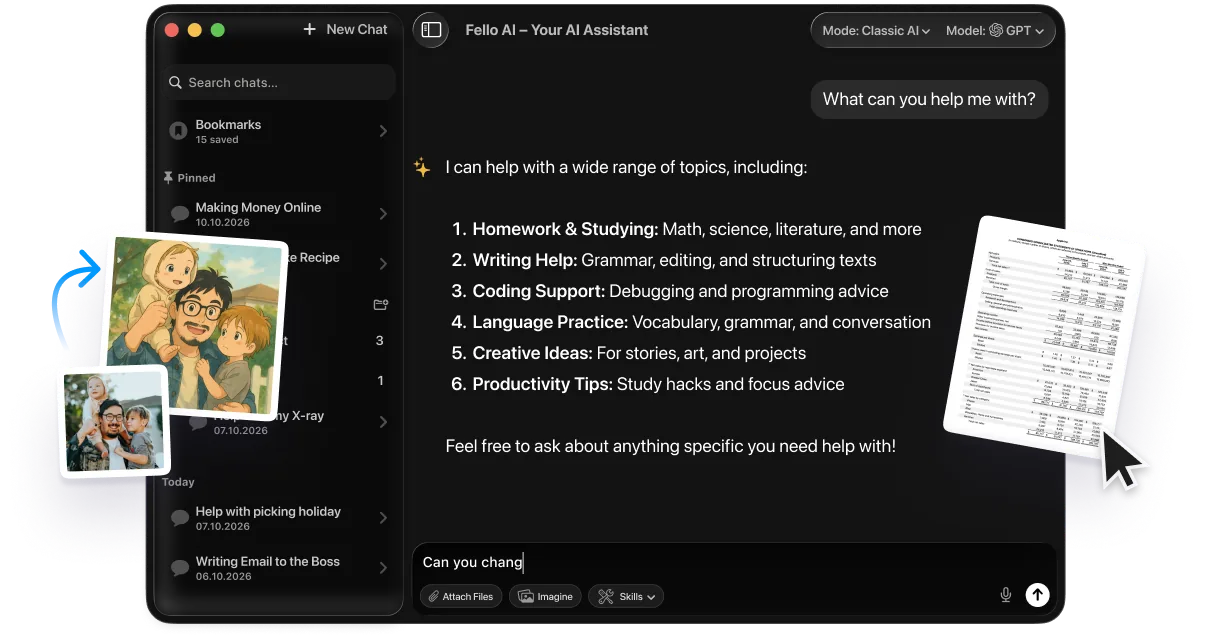
Les benchmarks ont tranché la question des performances, si bien que les vraies considérations sont désormais la structure des coûts et la juridiction des données. GLM 5.2 est gourmand en tokens, ce qui signifie qu'un usage agentique intensif peut faire grimper la facture plus vite que ne le suggère le prix affiché. Et si les poids ouverts vous permettent de l'auto-héberger en toute confidentialité, passer par l'API hébergée de Z.ai envoie votre code vers des serveurs soumis aux règles chinoises sur les données. C'est un compromis qui mérite réflexion pour un travail sensible ou propriétaire. Si vous préférez ne gérer aucun modèle, des applications comme Fello AI vous donnent accès à Claude, ChatGPT, Gemini, Grok et DeepSeek via un seul abonnement à $9.99/mois. Vous pouvez comparer les résultats sans jongler entre plusieurs comptes ou clés API. GLM 5.2 a lui-même rejoint cette offre dans la mise à jour Fello AI 6.7.0. Sur Mac, il tourne en tant que client de bureau GLM natif, donc sans onglet de navigateur ni clé API à gérer.
Conclusion
GLM 5.2 a été une déclaration claire : un modèle de pointe, à contexte d'1M, sous licence MIT, livré quelques jours après un durcissement majeur des exportations américaines. Et contrairement au lancement, les chiffres ont fini par soutenir ce cadrage. Il a battu GPT-5.5 sur SWE-bench Pro et s'est rapproché à moins d'un point de Claude Opus 4.8 sur les tâches à horizon long, le tout pour environ un sixième du coût. Ce qui a changé, c'est la compagnie qu'il fréquente : Kimi K3 et le GLM 5.3 maison de Z.ai sont désormais tous deux devant lui, et Claude Opus 5.5 est le modèle phare du côté fermé, deux générations après Opus 4.8. Les réserves restantes sont son fort appétit en tokens et la question de la juridiction des données autour de l'API hébergée. Si vous voulez précisément GLM 5.2, il reste l'API autonome et les poids ouverts, car le GLM Coding Plan Lite à $18/mois répond désormais avec GLM 5.3. La prochaine sortie de Zhipu, GLM 5.5, est déjà attendue plus tard en 2026.
FAQ
GLM 5.2 est-il gratuit ?
Les poids sont publiés sous licence MIT, donc l'auto-hébergement est gratuit et sans restriction pour un usage commercial. Le GLM Coding Plan ne sert plus GLM 5.2, la voie payante est donc l'API autonome, qui revient à $1.40 par million de tokens en entrée, $0.26 en cas de succès du cache, et $4.40 par million en sortie.
Quelle est la taille de la fenêtre de contexte de GLM 5.2 ?
Il traite jusqu'à 1 000 000 tokens en entrée, soit environ cinq fois la limite de ~200 000 tokens de GLM 5.1, avec une sortie allant jusqu'à 131 072 tokens.
Qui a créé GLM 5.2 ?
Zhipu AI, un laboratoire basé à Pékin qui opère sous le nom de Z.ai, l'un des principaux éditeurs de modèles à poids ouverts en Chine.
GLM 5.2 bat-il GPT-5 ou Claude ?
Sur le code, en partie oui. Les benchmarks publiés après le lancement montrent GLM 5.2 à 62,1 sur SWE-bench Pro, devant GPT-5.5 à 58,6 mais derrière Claude Opus 4.8 à 69,2. Il a été le modèle à poids ouverts le plus puissant disponible pendant environ un mois. Kimi K3 l'a dépassé en juillet 2026, le GLM 5.3 maison de Z.ai l'a dépassé en août, et les leaders fermés, dont Claude Opus 5.5, conservent une nette avance sur les tâches à horizon long les plus difficiles.
Puis-je utiliser GLM 5.2 avec Claude Code ?
Oui, via l'API autonome. GLM 5.2 expose un point d'accès compatible Anthropic, donc Claude Code, Cline, OpenCode et des outils similaires peuvent s'y connecter directement. Le GLM Coding Plan est une voie distincte, et il répond désormais à ces requêtes avec GLM 5.3.