A OpenAI está novamente sob pressão real. No final de 2025, o Gemini 3 da Google e o Claude Opus 4.5 da Anthropic reduziram o que costumava ser uma folga confortável de desempenho. Os benchmarks aproximaram-se. O sentimento dos utilizadores mudou. Pela primeira vez em anos, a OpenAI deixou de ser a líder incontestada em raciocínio, programação e usabilidade do dia a dia ao mesmo tempo.
Apenas semanas depois do GPT-5.1 (e apenas um par de meses depois do GPT-5.0), a OpenAI lançou o GPT-5.2. Internamente, isto seguiu-se ao que vários relatos descrevem como um momento de «Code Red»: um esforço a nível de toda a empresa para melhorar a competitividade do ChatGPT depois de o Gemini 3 ter começado a superar os modelos da OpenAI em várias avaliações internas e externas.
No papel, o GPT-5.2 parece uma grande vitória. Domina ou iguala resultados de ponta em vários benchmarks de grande visibilidade. Introduz ganhos significativos na recuperação de contexto longo, na autonomia de programação, na geração de folhas de cálculo e apresentações, e em fluxos de trabalho agênticos. A OpenAI posiciona-o como "a série de modelos mais capaz até hoje para trabalho de conhecimento profissional".
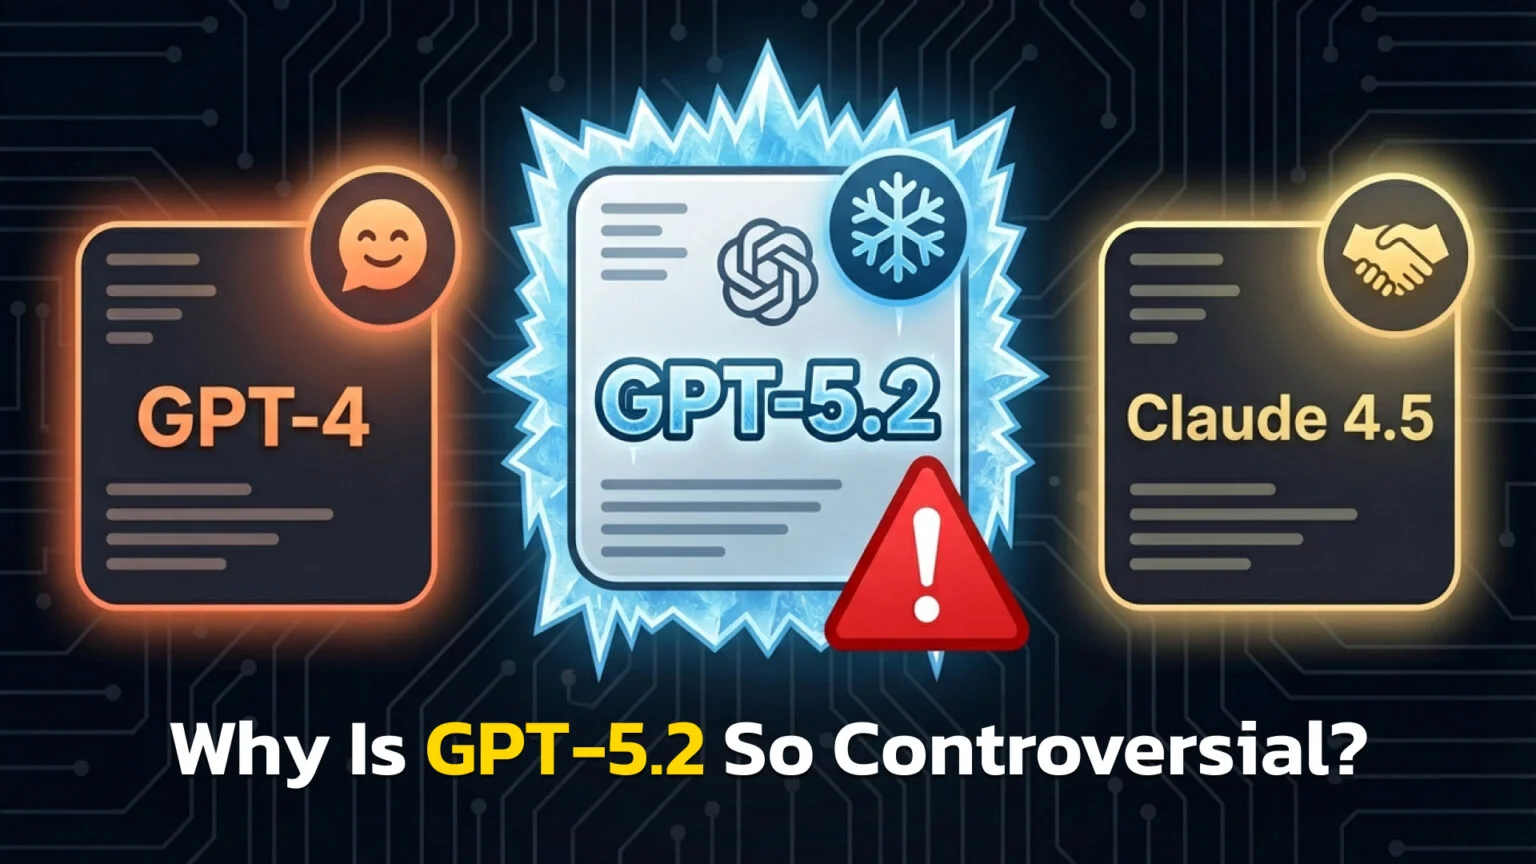
E, no entanto, a reação dos utilizadores tem sido excecionalmente negativa. No Reddit, no X, em fóruns de programadores e em avaliações independentes, surge um padrão consistente: o GPT-5.2 é poderoso, lento, rígido e profundamente desagradável de usar. Muitos utilizadores descrevem-o como mais frio, mais censório e menos fiável no uso diário do que o GPT-5.1, apesar de ser objetivamente mais forte em tarefas estreitas e mensuráveis.
A promessa: «o maior lançamento desde o GPT-5»
O posicionamento da OpenAI para o GPT-5.2 é inequívoco. Dizem que é um motor de produtividade para o trabalho profissional: folhas de cálculo, apresentações, bases de código, documentos longos, chamadas de ferramentas e projetos com várias etapas.
A métrica principal é o GDPval, um benchmark concebido pela OpenAI para medir a frequência com que os resultados da IA são preferidos aos de profissionais humanos em tarefas de trabalho de conhecimento bem especificadas.

Segundo a OpenAI, o GPT-5.2 Thinking supera ou iguala especialistas humanos 70,9% das vezes em 44 profissões, a cerca de 1% do custo e 11× a velocidade dos humanos. Isto representa um salto drástico em relação aos 38,8% reportados pelo GPT-5.1.
A gama de modelos também se expandiu:
- GPT-5.2 Instant – rápido, leve, otimizado de forma agressiva
- GPT-5.2 Thinking – maior esforço de raciocínio, mais lento, análise mais profunda
- GPT-5.2 Pro – raciocínio máximo, com preço pensado para empresas
- GPT-5.2 Pro (Extended) – profundidade de raciocínio extrema, latência e custo muito elevados
Esta segmentação importa. Muitas queixas não resultam da família de modelos como um todo, mas da forma como o encaminhamento automático e a troca de modo afetam o uso real dentro do ChatGPT. Muitas vezes, os utilizadores não sabem qual o submodelo que respondeu à sua pergunta, nem porque é que o comportamento mudou a meio da conversa.
Tanto o Gemini 3 como o Claude Opus 4.5 obtiveram ganhos significativos no final de 2025. O Gemini disparou no raciocínio multimodal e na geração de interfaces. O Claude manteve a liderança em velocidade, tom e usabilidade no dia a dia. O GPT-5.2 foi a tentativa da OpenAI de recuperar rapidamente o domínio técnico.
Os benchmarks não correspondem à realidade
A principal crítica ao GPT-5.2 não é que seja fraco. É que parece estar sobreajustado ao sucesso em benchmarks. Testadores independentes e utilizadores relatam um fosso crescente entre o desempenho do GPT-5.2 em avaliações limpas e bem especificadas e o seu comportamento em fluxos de trabalho reais e confusos. Isto manifesta-se de várias formas.

Um grande volume de feedback descreve o GPT-5.2 como:
- Frio
- Excessivamente formal
- Argumentativo
- Orientado para a conformidade
- Emocionalmente neutro
Muitos utilizadores afirmam explicitamente que não pediram uma mudança de personalidade. O GPT-5.1 tinha-se aproximado ligeiramente de um tom conversacional, semelhante ao do Claude. O GPT-5.2 inverteu essa evolução. O resultado parece abrupto, especialmente para utilizadores que não programam.
O próprio system card da OpenAI reconhece quedas de qualidade no modo Instant em comparação com o GPT-5.1. Os utilizadores relatam de forma consistente que o GPT-5.2 Instant parece «mais burro» do que o modelo que substituiu, sobretudo em nuance de escrita, tradução, tarefas criativas, consistência em respostas de seguimento,… Isto alimenta a perceção de que o GPT-5.2 é pior, mesmo quando os modos Thinking ou Pro superam os modelos anteriores.
O GPT-5.2 depende fortemente do encaminhamento automático de modelos. Na prática, isto significa:
- Uma pergunta complexa pode ser respondida por um submodelo mais fraco
- Uma pergunta de seguimento simples pode desencadear subitamente um raciocínio pesado
- O comportamento pode mudar a meio de uma conversa sem explicação
Para fluxos de trabalho em produção, esta imprevisibilidade é prejudicial. Como resumiu um programador: «Não são os benchmarks que lançam produtos. É a fiabilidade.»
Censura, recusas e o «clima de conformidade»
Outro eixo importante de controvérsia é a censura. Vários testadores independentes relatam que o GPT-5.2 é o modelo de fronteira mais censurado atualmente disponível. No benchmark Sansa, o GPT-5.2 Thinking surge como o modelo mais restritivo testado, superando o Claude e o Gemini em frequência de recusas.
As queixas dos utilizadores seguem um padrão:
- Recusas em pedidos claramente não sensíveis
- Longos preâmbulos de segurança em vez de respostas diretas
- Um tom descrito como «formação de conformidade empresarial»
A OpenAI está numa posição difícil. Aliviar as salvaguardas arrisca abuso, pressão regulatória e danos à marca. Reforçá-las arrisca afastar os utilizadores.
O problema não é o GPT-5.2 ser mais seguro. É que as suas regras muitas vezes parecem inconsistentes e sem explicação. Quando o mesmo pedido funciona num dia e falha no seguinte, a confiança desgasta-se rapidamente.
Como resumiu um crítico: interagir com o GPT-5.2 não é agradável. Parece constrangido, tenso e infeliz, e os utilizadores sentem essa tensão.
Para tarefas em que a criatividade, a exploração ou o tom importam, isto é decisivo. Para trabalho estritamente factual ou técnico, muitos utilizadores toleram-no.
O panorama mais amplo da IA
O GPT-5.2 existe num panorama de IA muito diferente do do GPT-4, e esse contexto explica porque «ganhar nos benchmarks» já não significa automaticamente «ganhar os utilizadores».
Em 2025, o desenvolvimento da IA de fronteira acelerou em várias frentes ao mesmo tempo.
Primeiro, a indústria domina agora a produção de modelos de fronteira. Segundo o Stanford AI Index 2025, quase 90% dos modelos de IA relevantes lançados em 2024 vieram da indústria, um salto acentuado em relação a cerca de 60% apenas um ano antes. A OpenAI já não compete principalmente com laboratórios de investigação: compete com hiperescalas, fabricantes de chips e empresas bem financiadas, focadas em IA, que lançam produtos a alta velocidade.
Em segundo lugar, a curva de escala não estagnou. O mesmo relatório mostra que a computação de treino continua a duplicar aproximadamente a cada cinco meses, a par de um crescimento rápido no tamanho dos conjuntos de dados e no consumo de energia. Isto explica porque modelos como o Gemini 3, o Claude Opus 4.5 e o GPT-5.2 conseguem todos registar ganhos significativos com poucas semanas de diferença entre si, mas também porque esses ganhos são cada vez mais incrementais e não transformadores.
Em terceiro lugar, o fosso de desempenho entre os modelos de fronteira reduziu-se drasticamente. O AI Index observa que a diferença entre o modelo nº 1 e o nº 10 em muitos benchmarks é agora de cerca de 5,4%, e que o fosso entre os dois melhores modelos pode ser de apenas 0,7%. A esse nível, o ruído estatístico, a variação de prompts e o desenho da avaliação pesam quase tanto como a capacidade bruta. A UX, as configurações predefinidas, a velocidade e a fiabilidade começam a dominar a perceção dos utilizadores.
Geograficamente, os Estados Unidos continuam a liderar no total de modelos de fronteira, com 40 modelos relevantes lançados em 2024, face a 15 provenientes da China e apenas um punhado da Europa. Mas os laboratórios chineses alcançaram uma quase paridade em benchmarks como o MMLU e o HumanEval, e a tendência geral é de convergência, não de domínio. A fronteira está sobrecarregada, em rápida evolução e implacável.
É por isso que a receção ao GPT-5.2 é paradoxal.
A OpenAI pode legitimamente reivindicar a liderança em recuperação de contexto longo, programação agêntica, geração de folhas de cálculo e apresentações e tarefas profissionais estruturadas, exatamente as áreas destacadas no anúncio do GPT-5.2. No papel, entrega aquilo que as empresas querem.
Mas num mercado onde os principais modelos estão muito próximos entre si, as pessoas já não escolhem «o modelo mais inteligente». Escolhem:
- o assistente diário mais rápido
- o assistente mais previsível
- o que tem menos fricção
- aquele com o qual gostam de trabalhar
É por isso que muitos utilizadores continuam a recorrer, por defeito, ao Claude Opus 4.5 para escrita e trabalho do dia a dia, ou ao Gemini 3 para tarefas multimodais e intensivas em interface, mesmo quando o GPT-5.2 os supera em benchmarks selecionados.
A realidade estratégica: o GPT-5.2 vence certas avaliações de forma decisiva, mas perde o lugar de assistente predefinido para muitos utilizadores. Em 2025, essa distinção importa mais do que nunca.
A OpenAI parece estar consciente desta tensão. Declarações públicas e várias notícias sugerem que o GPT-5.3 já está planeado, com foco explícito em velocidade, personalidade e regressões de usabilidade. O «Code Red» não foi apenas sobre lançar o GPT-5.2: foi sobre manter-se relevante numa fronteira onde a inteligência bruta, por si só, já não é suficiente. Desde então, a OpenAI avançou bastante além deste período, lançando o GPT-5.6 como uma família de três modelos, Sol, Terra e Luna, em junho de 2026.
Conclusão
O GPT-5.2 não é um modelo mau. É um modelo altamente especializado. No papel, entrega progresso real: melhor gestão de contexto longo, melhor programação agêntica, resultados estruturados aprimorados e um desempenho sólido em benchmarks. Para tarefas profissionais exigentes em que a profundidade e a correção importam mais do que a velocidade ou o tom, o GPT-5.2 pode ser a ferramenta certa.
Mas os benchmarks já não são suficientes. No uso diário, muitos utilizadores sentem o GPT-5.2 como lento, rígido, excessivamente censurado e imprevisível, devido ao encaminhamento e à troca de modo. A sua personalidade e os padrões de recusa interferem ativamente na escrita, no brainstorming e na assistência geral. Numa fronteira sobrecarregada onde os melhores modelos diferem por apenas alguns pontos percentuais, esses detalhes de UX decidem a adoção.
O GPT-5.2 vence certas avaliações de forma decisiva, mas perde o papel de assistente predefinido para muitos utilizadores. A OpenAI parece reconhecer isto. O GPT-5.2 parece menos uma resposta final e mais uma solução temporária sob pressão competitiva. Se a OpenAI vai recuperar o impulso dependerá de o próximo lançamento conseguir manter a inteligência e corrigir a experiência.