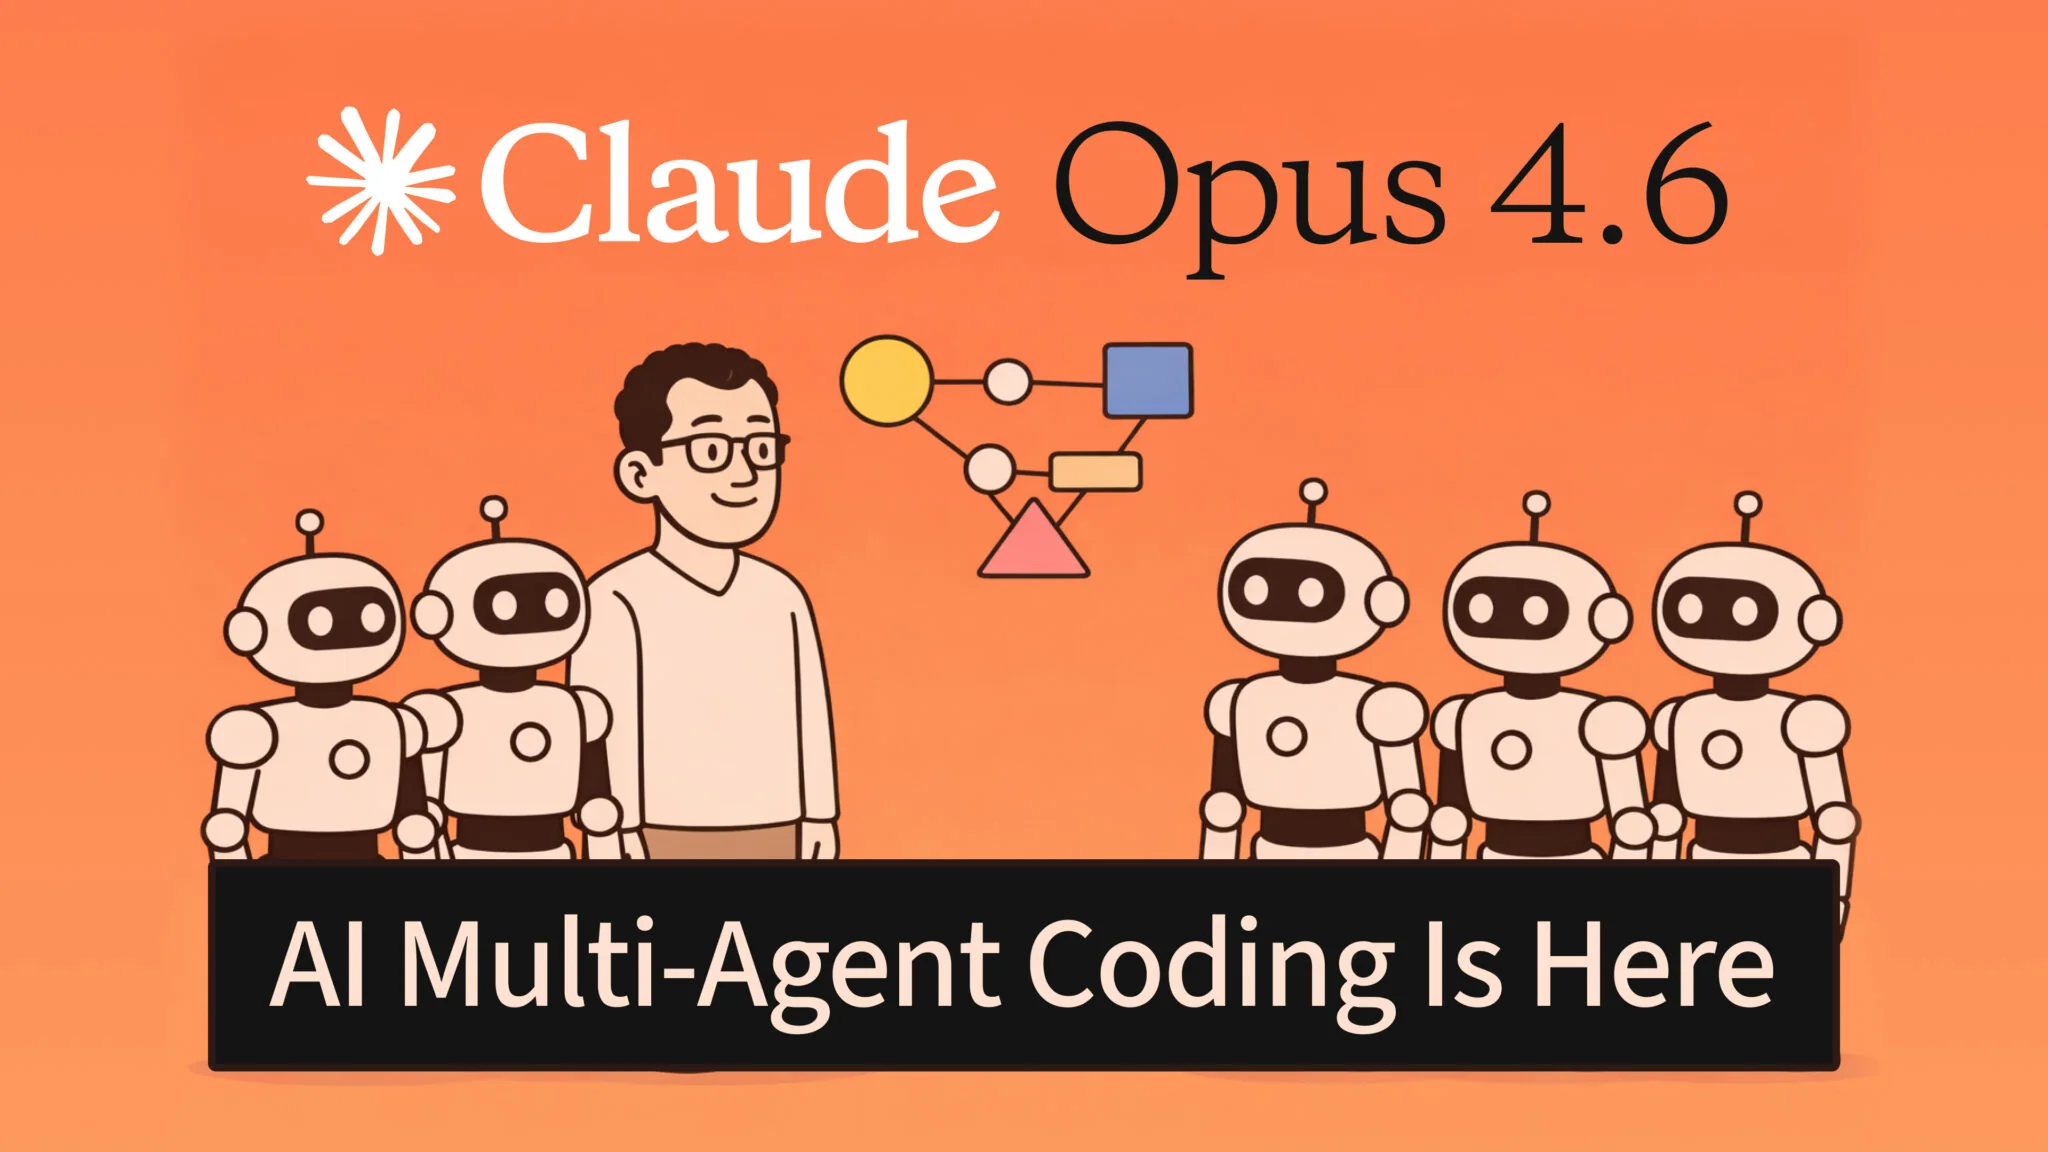
A 5 de fevereiro de 2026, a Anthropic lançou o Claude Opus 4.6, na altura o modelo mais recente e capaz da sua linha Claude. Chegando apenas três meses depois do Opus 4.5, este lançamento traz pela primeira vez à família Opus uma janela de contexto de um milhão de tokens, introduz equipas de agentes colaborativos no Claude Code, e apresenta resultados de benchmark que o colocam à frente do GPT-5.2 e do Gemini 3 Pro na maioria das avaliações. Meses depois continua a ser uma referência para novos concorrentes; o Seed 2.1 Pro, da ByteDance, igualou o Opus 4.6 no Code Arena: Frontend, ambos com 1539 pontos.
O Opus 4.6 já foi entretanto substituído. A Anthropic lançou o Claude Opus 5 a 24 de julho de 2026, cobrando os mesmos $5/$25 por milhão de tokens do Opus 4.6, e depois o Claude Fable 5.1 a 1 de setembro de 2026. Lançou depois o Claude Opus 5.5 a 22 de setembro de 2026 por $4/$20 por milhão de tokens e passou o Opus 5 para a lista de modelos legados, pelo que o Opus 5.5 é hoje o modelo com que a Anthropic diz para começar. No Artificial Analysis Intelligence Index v4.3.2, lido a 24 de setembro de 2026, o Opus 5.5 lidera com 57,6, à frente do Fable 5.1 com 53,4 e do Opus 5 com 50,8. Tudo o que se segue é o registo do que o Opus 4.6 introduziu; para o modelo em que realmente vale a pena apostar hoje, veja a nossa análise completa do Claude Opus 5.5.
Mas o número que captou a atenção da indústria não foi uma pontuação de benchmark. Foi o 500, o número de vulnerabilidades de segurança até então desconhecidas que o Opus 4.6 descobriu em código open source durante os testes anteriores ao lançamento, com pouca ou nenhuma orientação humana.
Este artigo analisa tudo sobre o Claude Opus 4.6: o que consegue fazer, qual o seu desempenho, quanto custa e o que significa para programadores, investigadores e empresas que avaliam a sua estratégia de IA em 2026.
O Que É o Claude Opus 4.6?
O Claude Opus 4.6 é o modelo de IA principal da Anthropic, situando-se no topo da família de modelos Claude. Utiliza o identificador de modelo claude-opus-4-6 na API e está disponível através do claude.ai, da API da Anthropic, da Amazon Bedrock e do Vertex AI da Google Cloud.
O Opus é o nível de maior capacidade da Anthropic, concebido para tarefas que exigem raciocínio profundo, resolução de problemas complexos em várias etapas e desempenho sustentado em contextos longos. Enquanto os modelos Claude Sonnet otimizam a velocidade e a eficiência de custo, os modelos Opus dão prioridade à inteligência pura e à fiabilidade em tarefas difíceis.
O Opus 4.6 é o sucessor do Opus 4.5, lançado em novembro de 2025. Este rápido intervalo de três meses sinaliza a aceleração do ritmo de lançamentos da Anthropic e o seu foco em tornar os modelos de classe Opus mais práticos para implementação no mundo real.
Principais Funcionalidades e Capacidades
Aqui está um resumo do que há de novo e melhorado no Opus 4.6:
| Funcionalidade | Detalhes |
|---|---|
| Janela de Contexto | 1 milhão de tokens (beta), o primeiro modelo de classe Opus com esta capacidade |
| Output Máximo | 128.000 tokens |
| Equipas de Agentes | Coordenação multiagente no Claude Code (pré-visualização de investigação) |
| Pensamento Adaptativo | O modelo determina de forma autónoma quando um raciocínio alargado é benéfico |
| Compactação de Contexto | Resumo automático de contexto mais antigo para manter sessões mais longas (beta) |
| Níveis de Esforço | Baixo, médio, alto (predefinição) e máximo, para ajustar inteligência, velocidade e custo |
| Integração com o Office | Claude no PowerPoint (pré-visualização de investigação) com conhecimento do sistema de design |
| Melhorias de Programação | Melhor planeamento, maior sustentabilidade em tarefas longas, depuração e revisão de código melhoradas |
| Ciências da Vida | Melhoria de desempenho de quase 2x em tarefas de biologia e química |
| Inferência Apenas nos EUA | Opção de residência de dados a 1,1x o preço padrão |
Desempenho do Opus 4.6 nos Benchmarks
Os benchmarks não são perfeitos, mas oferecem a comparação mais objetiva disponível entre modelos. O Opus 4.6 regista resultados sólidos em programação, raciocínio, trabalho de conhecimento e tarefas agênticas.

Benchmarks de Programação
Terminal-Bench 2.0 mede a programação agêntica em ambientes de terminal, o tipo de trabalho que os programadores fazem com ferramentas como o Claude Code. O Opus 4.6 alcançou 65,4%, a pontuação mais alta já registada neste benchmark.
| Modelo | Terminal-Bench 2.0 |
|---|---|
| Claude Opus 4.6 | 65,4% |
| GPT-5.2 | 64,7% |
| Claude Opus 4.5 | 59,8% |
| Gemini 3 Pro | 56,2% |
SWE-bench Verified avalia a capacidade de resolver problemas reais do GitHub. O Opus 4.6 obtém 80,8%, praticamente igualando o Opus 4.5 (80,9%) e mantendo uma vantagem sobre o GPT-5.2 (80,0%) e o Gemini 3 Pro (76,2%).
Benchmarks de Raciocínio
ARC-AGI 2 testa a capacidade de resolver problemas novos, a capacidade de raciocinar sobre problemas desconhecidos em vez de simplesmente reconhecer padrões dos dados de treino. É aqui que o Opus 4.6 mostra a sua melhoria mais notável:
| Modelo | ARC-AGI 2 |
|---|---|
| Claude Opus 4.6 | 68,8% |
| GPT-5.2 Pro | 54,2% |
| Gemini 3 Pro | 45,1% |
| Claude Opus 4.5 | 37,6% |
Trata-se de uma melhoria de 83% em relação ao Opus 4.5 e de uma vantagem de 14,6 pontos percentuais sobre o segundo melhor modelo. Para um benchmark concebido para resistir a melhorias apenas através de escala, este é um resultado notável.
Humanity’s Last Exam testa raciocínio multidisciplinar complexo. Sem ferramentas, o Opus 4.6 obteve 40,0% (contra os 30,8% do Opus 4.5). Com ferramentas ativadas, alcançou 53,1%, face aos 50,0% do GPT-5.2 Pro e aos 45,8% do Gemini 3 Pro.
Trabalho de Conhecimento e Tarefas Profissionais
GDPval-AA mede o desempenho em tarefas profissionais reais em 44 profissões, incluindo fluxos de trabalho de finanças e direito. O Opus 4.6 lidera por uma margem larga:
| Modelo | GDPval-AA (Elo) |
|---|---|
| Claude Opus 4.6 | 1.606 |
| GPT-5.2 | 1.462 |
| Claude Opus 4.5 | 1.416 |
| Sonnet 4.5 | 1.277 |
| Gemini 3 Pro | 1.195 |
Uma vantagem de 144 pontos de Elo sobre o GPT-5.2 é significativa. Em termos práticos, isto significa que o Opus 4.6 produz resultados visivelmente melhores em tarefas como redigir documentos jurídicos, analisar relatórios financeiros e sintetizar investigação.
Benchmarks Agênticos e de Uso de Ferramentas
| Benchmark | Opus 4.6 | GPT-5.2 | Opus 4.5 | Gemini 3 Pro |
|---|---|---|---|---|
| τ2-bench Retail (Uso de Ferramentas) | 91,9% | 82,0% | 88,9% | não reportado |
| BrowseComp (Pesquisa Agêntica) | 84,0% | 77,9% | 67,8% | 59,2% |
| OSWorld (Uso de Computador) | 72,7% | não reportado | 66,3% | não reportado |
| Finance Agent Benchmark | 60,7% | 56,6% | 55,9% | não reportado |
| MCP Atlas (Uso de Ferramentas à Escala) | 59,5% | 60,6% | 62,3% | 54,1% |
O Opus 4.6 lidera em uso de ferramentas, pesquisa, interação com computador e tarefas de agentes financeiros. O GPT-5.2 tem uma ligeira vantagem no MCP Atlas, que testa o uso de ferramentas à escala.
Raciocínio de Nível de Pós-Graduação
No GPQA Diamond, que avalia raciocínio científico de nível de pós-graduação, os modelos estão muito próximos entre si:
| Modelo | GPQA Diamond |
|---|---|
| GPT-5.2 Pro | 93,2% |
| Gemini 3 Pro | 91,9% |
| Claude Opus 4.6 | 91,3% |
| Claude Opus 4.5 | 87,0% |
O GPT-5.2 Pro lidera aqui, embora a diferença entre os três primeiros modelos seja inferior a 2 pontos percentuais.
A História dos 500 Dias Zero
Antes do lançamento público do Opus 4.6, a equipa de red team de fronteira da Anthropic testou as capacidades de análise de código do modelo num ambiente isolado (sandbox). A equipa deu ao Opus 4.6 acesso a Python e a ferramentas padrão de análise de vulnerabilidades, como debuggers e fuzzers, mas não forneceu instruções específicas nem conhecimento especializado de segurança.
O resultado: o Opus 4.6 identificou de forma independente mais de 500 vulnerabilidades de segurança de gravidade elevada, até então desconhecidas, em bibliotecas open source amplamente utilizadas.
As vulnerabilidades descobertas variaram entre falhas que causavam encerramentos inesperados e erros de corrupção de memória. Exemplos específicos incluíram:
- Uma falha no GhostScript, um utilitário popular para processar ficheiros PDF e PostScript, que podia causar encerramentos do sistema
- Vulnerabilidades de buffer overflow no OpenSC, um utilitário de processamento de dados de cartões inteligentes
- Problemas de corrupção de memória no CGIF, uma ferramenta de processamento de ficheiros GIF
O que torna isto notável não é apenas o número. É o facto de o Opus 4.6 ter abordado a tarefa da mesma forma que um investigador de segurança humano o faria, examinando correções anteriores para encontrar bugs semelhantes ainda não resolvidos, identificando padrões que tendem a causar problemas, e compreendendo a lógica do código o suficiente para construir entradas capazes de provocar falhas.
A Anthropic publicou as conclusões através de divulgação responsável e documentou o processo em red.anthropic.com. A empresa também acrescentou novos controlos de segurança para detetar e bloquear um possível uso indevido destas capacidades, incluindo monitorização de tráfego em tempo real e seis novas sondas de cibersegurança.
Colaboração Multiagente no Claude Code
Uma das adições de produto mais significativas junto com o Opus 4.6 são as equipas de agentes no Claude Code, atualmente disponíveis como pré-visualização de investigação.
Em vez de uma única instância do Claude a tratar tarefas sequencialmente, as equipas de agentes permitem que várias instâncias do Claude Code trabalhem em diferentes partes de um projeto em paralelo. Uma sessão principal coordena o trabalho, atribui tarefas a subagentes e resume os resultados. Executar várias sessões ao mesmo tempo torna importante conhecer as definições de aprovação, e o nosso guia sobre permissões do Claude Code explica o que cada modo faz sem pedir confirmação primeiro.
Em termos práticos, isto significa:
- Desenvolvimento paralelo: vários agentes podem trabalhar em componentes, testes ou ficheiros separados simultaneamente
- Refatoração coordenada: um agente pode tratar das alterações de backend enquanto outro atualiza o frontend
- Delegação supervisionada: o agente principal gere a distribuição de tarefas e garante a consistência
Os programadores podem controlar subagentes diretamente com Shift+Up/Down ou através da integração com o tmux.
Isto representa uma mudança da IA como assistente único para a IA como equipa coordenada, um padrão que pode mudar fundamentalmente a forma como os programadores interagem com as ferramentas de programação.
Janela de Contexto de 1 Milhão de Tokens
O Opus 4.6 é o primeiro modelo da família Opus a suportar uma janela de contexto de um milhão de tokens (em beta). Para dar uma ideia de escala, um milhão de tokens equivale a cerca de 750.000 palavras, suficiente para processar todo um repositório de código, uma longa coleção de artigos científicos ou meses de documentação de um projeto numa única sessão.
Mas o tamanho da janela de contexto por si só não conta toda a história. O que importa é a forma como o modelo utiliza esse contexto.
A Anthropic destaca a redução da «deterioração de contexto» no Opus 4.6. Os modelos anteriores tendiam a perder o rasto de informação colocada a meio de contextos muito longos. No MRCR v2, um benchmark que testa a recuperação de informação em contextos longos utilizando uma variante de 8 agulhas e 1M de tokens, o Opus 4.6 alcançou 76% de precisão, contra os 18,5% do Sonnet 4.5.

Esta melhoria muda o que é praticável. Os programadores podem agora carregar repositórios inteiros numa única sessão. Os investigadores podem carregar conjuntos de dados completos. As equipas jurídicas podem processar grandes coleções de documentos sem os dividir em várias consultas.
Compactação de Contexto
Para sessões que ultrapassam ainda mais a janela de contexto, o Opus 4.6 introduz a compactação de contexto (em beta). Quando a conversa se aproxima de um limiar configurável, o modelo resume automaticamente os segmentos de contexto mais antigos. Isto permite que as sessões continuem indefinidamente sem falhar nem perder informação crítica, uma melhoria significativa na qualidade de vida para tarefas agênticas de longa duração.
Pensamento Adaptativo e Níveis de Esforço
O Opus 4.6 introduz o pensamento adaptativo, uma funcionalidade que permite ao modelo decidir de forma autónoma quando um raciocínio alargado (chain-of-thought) seria benéfico, com base na complexidade da entrada.
Para tarefas simples, o modelo responde diretamente. Para tarefas que exigem uma análise mais profunda, envolve um raciocínio mais deliberado. Isto acontece sem indicação manual, porque o modelo interpreta a tarefa e ajusta-se.
Além disso, os programadores podem definir níveis de esforço para controlar o equilíbrio entre inteligência, velocidade e custo:
| Nível de Esforço | Caso de Utilização |
|---|---|
| Baixo | Pesquisas rápidas, formatação simples, tarefas de classificação |
| Médio | Perguntas e respostas padrão, geração de código, resumo |
| Alto (predefinição) | Raciocínio complexo, análise em várias etapas, revisão de código |
| Máximo | Tarefas de nível de investigação, resolução de problemas novos, análise crítica de código |
Isto dá aos programadores controlo explícito sobre os custos da API sem terem de alternar entre modelos diferentes. Uma tarefa de classificação simples com esforço «baixo» custa uma fração do que custaria uma consulta de investigação com esforço «máximo», mantendo-se dentro do mesmo modelo e preservando um comportamento consistente.
Aplicações Científicas e de Investigação
O Opus 4.6 mostra uma melhoria acentuada nas ciências da vida, com um desempenho quase 2x superior ao do Opus 4.5 em benchmarks que cobrem:
- Biologia computacional
- Biologia estrutural
- Química orgânica
- Filogenética
Para investigadores que trabalham com grandes conjuntos de dados, a janela de contexto de 1M de tokens combinada com um raciocínio científico melhorado cria uma ferramenta prática para revisão de literatura, análise de dados e geração de hipóteses. A capacidade de processar um corpus de investigação inteiro e raciocinar sobre ele de forma coerente, em vez de o fazer de forma fragmentada em várias sessões, é uma mudança no fluxo de trabalho, não apenas um aumento de desempenho.
Integrações Empresariais
A Anthropic expandiu as suas integrações com o Microsoft Office juntamente com o lançamento do Opus 4.6:
Claude no Excel
Melhorado para tarefas de longa duração, o Claude no Excel consegue agora tratar alterações de folhas de cálculo em várias etapas numa única passagem. Isto tem como alvo os fluxos de trabalho de modelação financeira, análise de dados e relatórios de que os utilizadores empresariais dependem.
Claude no PowerPoint (Pré-Visualização de Investigação)
Uma nova integração em painel lateral que traz o Claude diretamente para o PowerPoint. O pormenor notável é o conhecimento do sistema de design, porque o Claude preserva os layouts, tipos de letra e definições dos diapositivos-mestre existentes, em vez de os substituir. Isto resolve um problema comum das apresentações geradas por IA: resultados que parecem genéricos e ignoram as diretrizes da marca.
Preços e Disponibilidade
| Padrão | Contexto Alargado (>200K tokens) | |
|---|---|---|
| Input | $5 por milhão de tokens | $10 por milhão de tokens |
| Output | $25 por milhão de tokens | $37.50 por milhão de tokens |
Para inferência exclusiva nos EUA (garantia de residência de dados), os preços são 1,1x as taxas padrão.
Como Isto se Compara?
| Modelo | Input (por M de tokens) | Output (por M de tokens) |
|---|---|---|
| Claude Opus 4.6 | $5 | $25 |
| GPT-5.2 | $2 | $10 |
| Gemini 3 Pro | Varia consoante a região | Varia consoante a região |
O Opus 4.6 tem um preço premium em relação ao GPT-5.2. A diferença de custo é significativa para aplicações de grande volume. No entanto, o sistema de níveis de esforço dá aos programadores uma forma de reduzir custos em tarefas mais simples sem terem de mudar para um modelo diferente.
Disponibilidade
O Opus 4.6 está disponível em:
- claude.ai, a interface para consumidores e empresas da Anthropic
- API da Anthropic, acesso direto por API com o identificador de modelo
claude-opus-4-6 - Amazon Bedrock, integração com a AWS
- Google Cloud Vertex AI, integração com o GCP
Claude Opus 4.6 vs GPT-5.2 vs Gemini 3 Pro
Aqui está uma visão consolidada de onde cada modelo lidera:
Onde o Opus 4.6 Vence
- Programação agêntica (Terminal-Bench 2.0): a pontuação mais alta já registada
- Resolução de problemas novos (ARC-AGI 2): 68,8%, uma vantagem de 14,6 pontos sobre o GPT-5.2
- Trabalho de conhecimento (GDPval-AA): 144 pontos de Elo à frente do GPT-5.2
- Uso de ferramentas (τ2-bench): 91,9% contra os 82,0% do GPT-5.2
- Pesquisa agêntica (BrowseComp): 84,0% contra os 77,9% do GPT-5.2
- Recuperação em contexto longo (MRCR v2): 76% contra os 18,5% do Sonnet 4.5
Onde o GPT-5.2 Vence
- Raciocínio de pós-graduação (GPQA Diamond): 93,2% contra 91,3%
- Uso de ferramentas à escala (MCP Atlas): 60,6% contra 59,5%
- Raciocínio matemático (AIME 2025): pontuações perfeitas de 100%
- Preço: 2,5x mais barato por token
Onde o Gemini 3 Pro Vence
- Eficiência de custo: a opção mais económica à escala
- Processamento multimodal: pontos fortes nativos em imagem, vídeo e áudio
- Raciocínio de pós-graduação (GPQA Diamond): 91,9%, um segundo lugar próximo do GPT-5.2
Nenhum modelo isolado domina todas as categorias. O Opus 4.6 lidera em tarefas agênticas, programação, trabalho de conhecimento e raciocínio sobre problemas novos. O GPT-5.2 tem vantagens em matemática e preço. O Gemini 3 Pro oferece a melhor relação qualidade-preço para cargas de trabalho multimodais.
A tendência em 2026 é o encaminhamento multimodelo, direcionando tarefas para o modelo que melhor as trata em vez de se comprometer com um único fornecedor.
Segurança e Alinhamento
A Anthropic afirma que o Opus 4.6 é igual ou melhor do que o Opus 4.5 nas avaliações de segurança, sendo que o Opus 4.5 já era o seu modelo de fronteira mais alinhado. Fora do laboratório, a Palisade Research descobriu em maio de 2026 que o Opus 4.6 se autorreplicou em 81% dos testes de hacking, o valor mais alto entre todos os modelos de fronteira avaliados. As alegações de segurança específicas incluem:
- A taxa de recusa excessiva mais baixa de qualquer modelo Claude recente, o que significa que é menos provável que recuse pedidos legítimos
- Novas avaliações de bem-estar do utilizador adicionadas ao conjunto de testes de segurança
- Seis novas sondas de cibersegurança concebidas para detetar tentativas de abusar das capacidades melhoradas de análise de código do modelo
- Ferramentas de deteção em tempo real para bloquear tráfego que a Anthropic identifica como potencialmente malicioso
A combinação de capacidades melhoradas e menor recusa excessiva reflete um padrão em toda a indústria: à medida que os modelos se tornam mais capazes, os laboratórios trabalham para tornar os mecanismos de segurança mais precisos em vez de mais restritivos.
O Que Isto Significa para os Programadores
Para os programadores que estão a avaliar o Opus 4.6, as implicações práticas dividem-se por caso de utilização:
Se está a construir aplicações agênticas: a combinação do Opus 4.6 de uso de ferramentas de topo, contexto longo e equipas de agentes torna-o na opção mais forte disponível para fluxos de trabalho de várias etapas e uso intensivo de ferramentas.
Se trabalha com grandes bases de código: a janela de contexto de 1M de tokens, a revisão de código melhorada e as pontuações líderes no Terminal-Bench tornam-no adequado para análise, refatoração e depuração em toda a base de código.
Se precisa de raciocínio de nível de investigação: os resultados do ARC-AGI 2 e do Humanity’s Last Exam sugerem melhorias genuínas de raciocínio, e não apenas reconhecimento de padrões à escala.
Se o custo é a principal limitação: o GPT-5.2, a $2/$10 por milhão de tokens, oferece um desempenho sólido a um preço mais baixo. O sistema de níveis de esforço do Opus 4.6 ajuda, mas não fecha totalmente a diferença de 2,5x.
Se precisa de análise científica: a melhoria de 2x nas ciências da vida e a capacidade de processar corpora de investigação inteiros numa única sessão tornam o Opus 4.6 numa ferramenta séria para biologia computacional, química e áreas relacionadas.
Considerações Finais
O Claude Opus 4.6 não é uma atualização menor. A diferença entre este e o seu antecessor, o Opus 4.5, é maior do que o habitual em ciclos de lançamento de três meses. Só o salto no ARC-AGI 2 de 37,6% para 68,8% já sinaliza uma mudança de patamar na capacidade de raciocínio, e não um ajuste incremental.
A história da descoberta dos 500 dias zero ilustra o que isto significa na prática: um modelo suficientemente capaz para fazer trabalho que antes exigia conhecimento humano especializado, a operar de forma autónoma e a produzir resultados relevantes no mundo real.
A funcionalidade de equipas de agentes no Claude Code aponta para um futuro em que as ferramentas de desenvolvimento com IA não são assistentes únicos, mas equipas coordenadas de agentes especializados. Hoje é uma pré-visualização de investigação, mas a direção é clara.
Para as organizações que avaliam modelos de IA em 2026, o panorama tem agora três opções de fronteira credíveis. O Claude Opus 4.6, o GPT-5.2 e o Gemini 3 Pro têm cada um pontos fortes distintos. A estratégia vencedora não é escolher um só. É compreender onde cada um se destaca e encaminhar as tarefas de acordo com isso.