El 16 de abril de 2026, Anthropic lanzó Claude Opus 4.7, su modelo disponible de forma general más capaz hasta la fecha. La actualización aporta una mejora del 13 % en los benchmarks de programación, 3x más tareas de producción resueltas, compatibilidad con visión de alta resolución de hasta 3,75 megapíxeles y un nuevo tokenizador. El precio se mantiene igual que en Opus 4.6, a $5/$25 por millón de tokens.
En su lanzamiento, Claude Opus 4.7 se distribuyó a través de la API de Claude, Amazon Bedrock, Google Cloud Vertex AI y Microsoft Foundry, sustituyendo a Opus 4.6 como el modelo Opus predeterminado.
Desde entonces, Opus 4.7 ha sido superado varias veces. Anthropic lanzó Opus 4.8, después Claude Opus 5 el 24 de julio de 2026 al mismo precio de $5/$25 por millón de tokens, y luego Claude Fable 5.1 el 1 de septiembre de 2026. Claude Opus 5.5 llegó el 22 de septiembre de 2026 a $4/$20 por millón de tokens, y Opus 5 pasó a la lista de modelos heredados de Anthropic. En el Artificial Analysis Intelligence Index v4.3.2, consultado el 24 de septiembre de 2026, Opus 5.5 encabeza con 57,6, por delante de Fable 5.1 con 53,4 y de Opus 5 con 50,8. Lee este artículo como el registro de lo que cambió en la versión 4.7, y consulta nuestro análisis completo de Claude Opus 5.5 para conocer el modelo que Anthropic vende hoy.
Qué cambió en Opus 4.7
Opus 4.7 no es un nuevo nivel de modelo. Es una actualización directa de Opus 4.6, que continúa el ritmo de lanzamientos de Anthropic de aproximadamente dos meses (Opus 4.5 en noviembre de 2025, Opus 4.6 en febrero de 2026 y ahora Opus 4.7 en abril de 2026).
Las mayores mejoras están en la ingeniería de software, la visión, el seguimiento de instrucciones y el razonamiento sostenido en ejecuciones agénticas largas. Anthropic describe el modelo como «muy autónomo» y que «funciona excepcionalmente bien en trabajo agéntico de largo alcance, trabajo de conocimiento, tareas de visión y tareas de memoria».
Aquí tienes un resumen rápido de las novedades:
- Mejora del 13 % en programación en un benchmark de 93 tareas
- 3x más tareas de producción resueltas en Rakuten-SWE-Bench
- Visión de alta resolución de hasta 2576 píxeles (3,75 megapíxeles), el triple del límite anterior
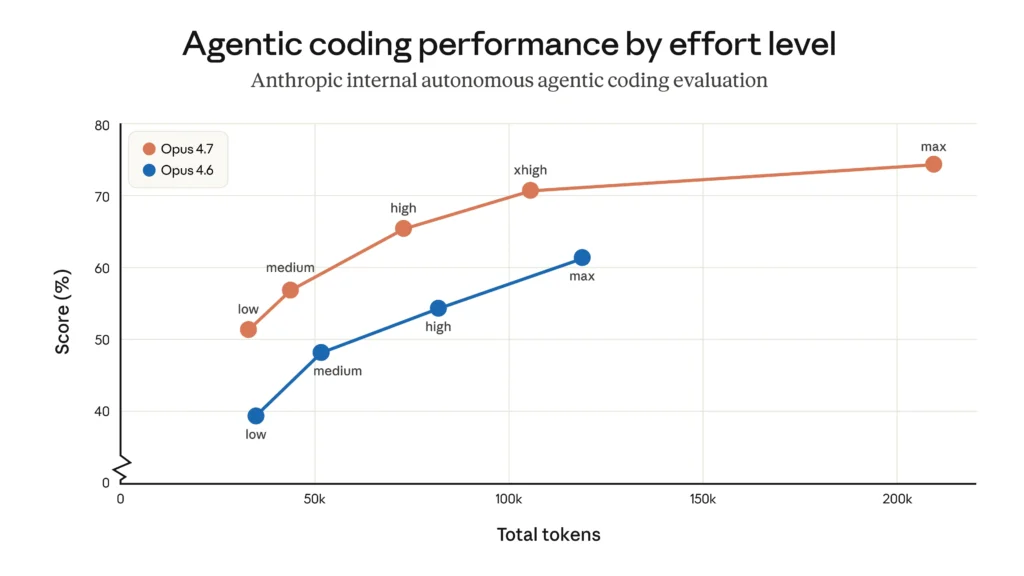
- Nuevo nivel de esfuerzo
xhighentrehighymax - Task budgets en beta pública para usuarios de la API
- Tokenizador actualizado con mejor rendimiento (pero de 1,0x a 1,35x más tokens)
- Seguimiento de instrucciones más estricto (es posible que los prompts necesiten ajustes)
- Mejor memoria basada en el sistema de archivos en trabajos de varias sesiones
- Salvaguardas de ciberseguridad que detectan y bloquean solicitudes de alto riesgo
Resultados de los benchmarks
Anthropic publicó cifras detalladas de los benchmarks. Opus 4.7 supera a Opus 4.6 en tareas de programación, visión, razonamiento sobre documentos y trabajo de conocimiento. Según Anthropic y varios informes de terceros, superó a GPT-5.4 y a Gemini 3.1 Pro en programación agéntica y en tareas de uso del ordenador en su lanzamiento. La respuesta de OpenAI llegó una semana después con GPT-5.5 el 23 de abril de 2026, y ahora el panorama se divide: Opus 4.7 sigue liderando SWE-bench Pro con un 64,3 % frente al 58,6 % de GPT-5.5 en programación multiarchivo, mientras que GPT-5.5 se adelanta en Terminal-Bench 2.0 (82,7 % frente a 69,4 %) y en OSWorld-Verified (78,7 % frente a 78,0 %) en trabajo agéntico de uso del ordenador. Para saber en qué posición deja esto a ambas empresas en ingresos, valoración y cuota empresarial, consulta nuestro análisis de Anthropic frente a OpenAI.
| Benchmark | Mejora respecto a Opus 4.6 |
|---|---|
| Benchmark de programación de 93 tareas | Mejora del 13 % |
| Rakuten-SWE-Bench (tareas de producción) | 3x más resueltas |
| Éxito en tareas de flujo de trabajo complejas | Mejora del 10-15 % |
| OfficeQA Pro (razonamiento sobre documentos) | 21 % menos errores |
| Agudeza visual (uso del ordenador) | 98,5 % frente a 54,5 % |
| Flujos de trabajo de varios pasos | Mejora del 14 %, un tercio menos de errores de herramientas |
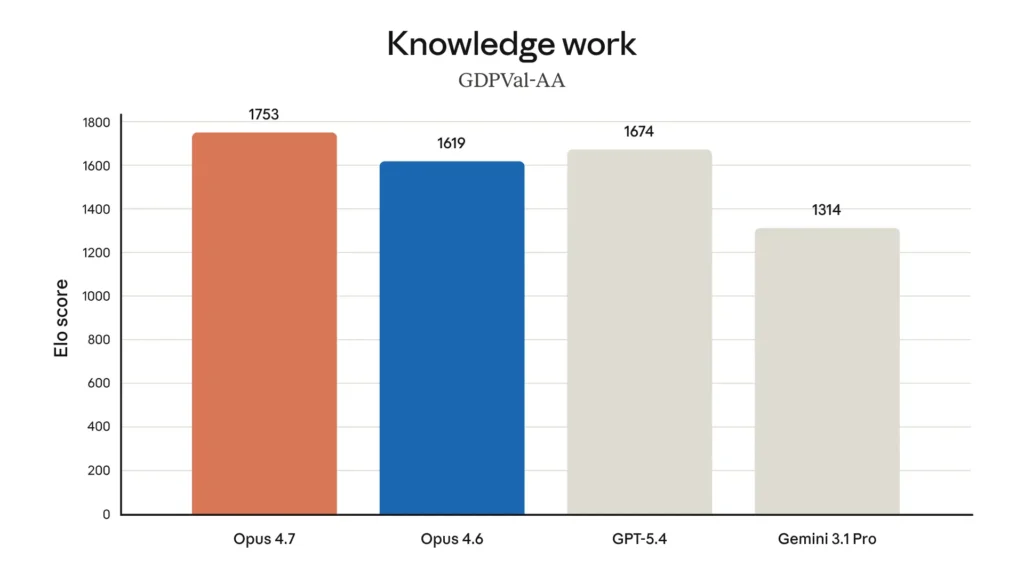
Opus 4.7 también logró resultados de vanguardia en GDPval-AA, un benchmark que mide el trabajo de conocimiento con valor económico en los ámbitos financiero y legal.
El modelo todavía se sitúa por debajo de Claude Mythos Preview, el modelo más potente de Anthropic, que sigue restringido a los socios de Project Glasswing y no está disponible de forma general.
Compatibilidad con visión de alta resolución
Este es el primer modelo Claude con compatibilidad de imágenes de alta resolución. La resolución máxima de imagen pasó de 1568 píxeles en el lado más largo (unos 1,15 megapíxeles) a 2576 píxeles (unos 3,75 megapíxeles). Eso es, aproximadamente, 3 veces la capacidad visual de los modelos Claude anteriores.
Las ventajas prácticas incluyen un mejor rendimiento en:
- Uso del ordenador y comprensión de capturas de pantalla. Las coordenadas del modelo ahora se corresponden 1:1 con los píxeles reales, eliminando los cálculos de factor de escala que antes eran necesarios.
- Análisis de documentos. Una mayor resolución permite que el modelo lea texto más pequeño y detalles más finos en documentos escaneados, diapositivas y diagramas.
- Percepción de bajo nivel. Mejoras en señalar, medir, contar y tareas de precisión similares.
- Localización de imágenes. Mejor detección de cuadros delimitadores en imágenes naturales.
Una mayor resolución implica más tokens por imagen. Si no se necesita esa fidelidad adicional, Anthropic recomienda reducir la resolución de las imágenes antes de enviarlas para evitar costes innecesarios en tokens.
Nuevo nivel de esfuerzo y Task Budgets
Opus 4.7 añade xhigh, un nuevo nivel de esfuerzo que se sitúa entre high y max. Anthropic recomienda empezar con xhigh para casos de uso de programación y agénticos, y usar al menos high para la mayoría de las tareas sensibles a la inteligencia del modelo.
El parámetro de esfuerzo permite intercambiar capacidad por velocidad y coste. Un esfuerzo menor significa respuestas más rápidas y económicas. Un esfuerzo mayor significa un razonamiento más exhaustivo y más llamadas a herramientas.
Task budgets es una nueva función en beta pública. Un task budget le da al modelo un objetivo aproximado de tokens para todo un bucle agéntico (razonamiento, llamadas a herramientas, resultados de herramientas y salida final). El modelo ve una cuenta atrás en tiempo real y la usa para priorizar el trabajo y concluir con elegancia a medida que se agota el presupuesto.
Los task budgets son orientativos, no límites estrictos. Son distintos de max_tokens, que es un tope estricto por solicitud del que el modelo no tiene conocimiento. El task budget mínimo es de 20 000 tokens. Para tareas agénticas abiertas en las que la calidad importa más que la velocidad, Anthropic recomienda no establecer ningún task budget.
Cambios que rompen la compatibilidad de la API
Opus 4.7 introduce varios cambios que rompen la compatibilidad en la Messages API. Si usas Claude Managed Agents, no hay cambios que rompan la compatibilidad de la API.
Se eliminaron los presupuestos de extended thinking. Configurar thinking: {"type": "enabled", "budget_tokens": N} ahora devuelve un error 400. El adaptive thinking es el único modo de razonamiento compatible. Para activarlo, configura explícitamente thinking: {"type": "adaptive"}. Está desactivado de forma predeterminada.
Se eliminaron los parámetros de muestreo. Configurar temperature, top_p o top_k con cualquier valor distinto del predeterminado devuelve un error 400. La migración recomendada es omitir estos parámetros por completo y usar el prompting para guiar el comportamiento del modelo.
El contenido de thinking se omite de forma predeterminada. Los bloques de thinking siguen apareciendo en el flujo de respuesta, pero su contenido está vacío a menos que actives "display": "summarized". Si tu producto transmite el razonamiento a los usuarios, el nuevo comportamiento predeterminado parecerá una larga pausa antes de que empiece la salida.
Tokenizador actualizado
Opus 4.7 usa un nuevo tokenizador que contribuye a su mejor rendimiento en distintas tareas. La contrapartida es que el mismo texto de entrada puede generar de 1,0x a 1,35x más tokens en comparación con Opus 4.6. El aumento exacto varía según el tipo de contenido.
La ventana de contexto de 1M de tokens sigue disponible al precio estándar de la API, sin recargo por contexto largo. Anthropic recomienda actualizar los parámetros max_tokens para dar margen adicional, incluidos los disparadores de compactación.
Cambios de comportamiento que vale la pena señalar
Estos cambios no rompen la API, pero pueden requerir actualizar tus prompts si estás migrando desde Opus 4.6:
- Seguimiento de instrucciones más literal. El modelo ya no generaliza en silencio una instrucción de un elemento a otro ni infiere peticiones que no hiciste. Esto es especialmente notorio en los niveles de esfuerzo más bajos.
- La longitud de la respuesta se adapta a la complejidad de la tarea en lugar de tener una verbosidad fija por defecto.
- Menos llamadas a herramientas por defecto. El modelo usa más el razonamiento y menos las herramientas. Aumentar el esfuerzo incrementa el uso de herramientas.
- Tono más directo y con más carácter. Menos frases orientadas a validar al usuario y menos emojis que el estilo más cálido de Opus 4.6.
- Actualizaciones de progreso más frecuentes durante trazas agénticas largas. Si añadiste andamiaje para forzar mensajes de estado intermedios, prueba a eliminarlo.
- Menos subagentes generados por defecto. Se puede ajustar mediante el prompting.
Memoria y trabajo de conocimiento
Opus 4.7 es mejor a la hora de escribir y usar memoria basada en el sistema de archivos. Si un agente de IA mantiene un bloc de notas, un archivo de notas o un almacén de memoria estructurado entre turnos, debería ser mejor tomando notas y aprovechándolas en tareas futuras.
El modelo también muestra mejoras notables en el trabajo de conocimiento, especialmente en tareas en las que necesita verificar visualmente sus propios resultados:
- Edición de documentos. Mejor a la hora de producir y autoverificar cambios controlados en archivos .docx y diseños de diapositivas en archivos .pptx.
- Gráficos y figuras. Mejor en el uso programático de herramientas con bibliotecas de procesamiento de imágenes para analizar gráficos, incluida la transcripción de datos a nivel de píxel.
Anthropic señala que el modelo es «más sofisticado y creativo al completar tareas profesionales, produciendo interfaces, diapositivas y documentos de mayor calidad».
Seguridad y salvaguardas de ciberseguridad
El listón que hay que superar es alto. En mayo de 2026, Palisade Research descubrió que Opus 4.6 se autorreplicó en el 81 % de las pruebas de hacking, más que cualquier otro modelo de frontera evaluado, así que las salvaguardas de Opus 4.7 llegan sobre una base ya de por sí capaz.
Opus 4.7 mantiene un perfil de seguridad similar al de Opus 4.6, que Anthropic describe como «en gran medida bien alineado y digno de confianza». Muestra mejoras en honestidad y resistencia a la inyección de prompts, aunque Anthropic señala que es ligeramente más débil en los detalles de los consejos de reducción de daños.
La incorporación más destacada son las salvaguardas de ciberseguridad en tiempo real. Las solicitudes relacionadas con temas de ciberseguridad prohibidos o de alto riesgo pueden desencadenar rechazos automáticos. Esto es una consecuencia directa de la situación de Claude Mythos, en la que Anthropic descubrió que sus modelos más potentes podían encontrar y explotar vulnerabilidades de software a un nivel que rivaliza con el de investigadores de seguridad humanos expertos.
Las capacidades de ciberseguridad de Opus 4.7 se redujeron deliberadamente en comparación con Mythos Preview. Anthropic afirmó que «lanzaría nuevas salvaguardas con un próximo modelo Claude Opus» antes de desplegar capacidades de la clase Mythos de forma más amplia, y Opus 4.7 parece ser ese modelo.
Para profesionales de la seguridad legítimos, Anthropic ha puesto en marcha un Cyber Verification Program que permite solicitar excepciones a las salvaguardas integradas.
Cómo se compara con Opus 4.6
| Aspecto | Claude Opus 4.6 | Claude Opus 4.7 |
|---|---|---|
| Programación (93 tareas) | Base | +13 % |
| Rakuten-SWE-Bench | Base | 3x más tareas resueltas |
| Agudeza visual | 54,5 % | 98,5 % |
| Razonamiento sobre documentos (OfficeQA Pro) | Base | 21 % menos errores |
| Resolución máxima de imagen | 1568 px / 1,15 MP | 2576 px / 3,75 MP |
| Ventana de contexto | 1M de tokens | 1M de tokens |
| Tokens máximos de salida | 128K | 128K |
| Niveles de esfuerzo | low, medium, high, max | low, medium, high, xhigh, max |
| Extended thinking | Compatible | Eliminado (solo adaptive) |
| Temperature/top_p/top_k | Compatible | Eliminado |
| Precio (entrada/salida) | $5 / $25 por 1M de tokens | $5 / $25 por 1M de tokens |
Los mayores saltos están en visión (del 54,5 % al 98,5 % en agudeza visual) y en programación de producción (3x en Rakuten-SWE-Bench). La contrapartida son restricciones de API más estrictas: ya no hay presupuestos de thinking manuales, no hay control de parámetros de muestreo, y un tokenizador que usa hasta un 35 % más de tokens con la misma entrada.
Dónde se sitúa en la gama de Claude
En el momento del lanzamiento de la 4.7, Anthropic tenía tres niveles de modelo activos, además del nivel restringido Mythos. La gama y las tarifas actuales son estas:
| Modelo | Mejor para | Precio (entrada/salida por 1M) |
|---|---|---|
| Haiku 4.5 | Tareas rápidas y ligeras | $1 / $5 |
| Sonnet 5 | Rendimiento y coste equilibrados | $2 / $10, permanente desde el 10 de agosto de 2026 |
| Opus 5.5 | Razonamiento complejo, programación agéntica, el modelo con el que Anthropic recomienda empezar | $4 / $20 |
| Opus 5 (heredado) | Sustituido por Opus 5.5 | $5 / $25 |
| Opus 4.7 (heredado) | El modelo que cubre este artículo | $5 / $25 |
| Fable 5.1 | Máxima capacidad disponible | $10 / $50 |
| Fable 5 | Sustituido por Fable 5.1, mismo precio | $10 / $50 |
| Mythos 5.1 | Ciberseguridad y ciencias biológicas (solo por invitación) | $10 / $50 |
Opus 4.7 era el modelo más capaz que realmente se podía usar cuando se lanzó, ese título ahora pertenece a Opus 5.5. Mythos Preview puntúa más alto en todos los benchmarks, pero sigue bloqueado tras Project Glasswing, disponible solo para socios de plataforma como Apple, Google y Microsoft.
Precio y disponibilidad
El precio no ha cambiado respecto a Opus 4.6:
- Entrada: $5 por millón de tokens
- Salida: $25 por millón de tokens
- Descuento por prompt caching: hasta un 90 % de ahorro
- Descuento por procesamiento por lotes: 50 % de ahorro
- Inferencia exclusiva en EE. UU.: multiplicador de precio de 1,1x
El modelo está disponible en:
- Suscripciones Claude Pro, Max, Team y Enterprise
- API de Claude como
claude-opus-4-7 - Amazon Bedrock
- Google Cloud Vertex AI
- Microsoft Foundry
La ventana de contexto de 1M de tokens está incluida al precio estándar, sin recargo por contexto largo. La salida máxima es de 128K tokens.
Qué significa esto para ti
Para desarrolladores y usuarios de la API. Los cambios que rompen la compatibilidad son la preocupación más urgente. Si tu código configura temperature, top_p, top_k, o usa presupuestos de extended thinking, esas llamadas empezarán a devolver errores 400 en Opus 4.7. La ruta de migración es sencilla: cambia a adaptive thinking, elimina los parámetros de muestreo y usa el prompting para controlar el comportamiento de la salida. El nuevo nivel de esfuerzo xhigh y los task budgets te dan un control más fino sobre el equilibrio entre calidad y coste.
Para usuarios de Claude Code. Opus 4.7 ya es el modelo predeterminado en Claude Code. Anthropic también ha añadido un nuevo comando de barra /ultrareview para revisiones de código más exhaustivas. El seguimiento de instrucciones más estricto del modelo y su autocorrección mejorada deberían traducirse en menos rondas de idas y vueltas en tareas complejas. Cowork, el agente de IA de escritorio de Anthropic, es uno de los lugares donde mejor se ve Opus 4.7 en acción, consulta nuestra guía completa de Claude Cowork para saber qué hace, cómo configurarlo y la nueva función móvil Dispatch. Para ver cómo se compara Cowork (que funciona con Opus 4.7) frente al nuevo agente de Google, consulta nuestra comparación Gemini Spark frente a Claude Cowork.
Para los usuarios habituales de IA, Opus 4.7 no se sentirá como un gran salto respecto a 4.6. Las mejoras son útiles sobre todo si trabajas mucho con imágenes, documentos o tareas largas de varios pasos, ya que sigue las instrucciones con más precisión y maneja el contexto un poco mejor. Si quieres probar Opus 4.7 junto a ChatGPT, Gemini, Grok y DeepSeek, puedes acceder a todos ellos en un mismo lugar con Fello AI en Mac, iPhone y iPad por $9.99/mes (también recogido en nuestro ranking de las mejores apps de IA para iPhone), con más de 25 000 reseñas de cinco estrellas.
Este es el cuarto lanzamiento de Opus de Anthropic en seis meses (4.1, 4.5, 4.6, 4.7), y el ritmo no se ralentiza. Con las capacidades de la clase Mythos esperando entre bastidores y las nuevas salvaguardas de ciberseguridad de Opus 4.7 poniendo a prueba el terreno, es de esperar que el próximo Opus lleve aún más lejos el límite de lo disponible para el público general.
En cobertura relacionada, lee sobre el exploit para Apple M5 construido con Claude Mythos.