A 16 de abril de 2026, a Anthropic lançou o Claude Opus 4.7, o seu modelo de disponibilidade geral mais capaz até à data. A atualização traz um aumento de 13% nos benchmarks de programação, 3x mais tarefas de produção resolvidas, suporte de visão de alta resolução até 3,75 megapixels, e um novo tokenizador. Os preços mantêm-se iguais aos do Opus 4.6, a $5/$25 por milhão de tokens.
No lançamento, o Claude Opus 4.7 ficou disponível na API Claude, na Amazon Bedrock, no Google Cloud Vertex AI e no Microsoft Foundry, substituindo o Opus 4.6 como o modelo Opus predefinido.
O Opus 4.7 já foi entretanto substituído várias vezes. A Anthropic lançou o Opus 4.8, depois o Claude Opus 5 a 24 de julho de 2026 aos mesmos $5/$25 por milhão de tokens, e depois o Claude Fable 5.1 a 1 de setembro de 2026. O Claude Opus 5.5 chegou a 22 de setembro de 2026 por $4/$20 por milhão de tokens, e o Opus 5 passou para a lista de modelos legados da Anthropic. No Artificial Analysis Intelligence Index v4.3.2, lido a 24 de setembro de 2026, o Opus 5.5 lidera com 57,6, à frente do Fable 5.1 com 53,4 e do Opus 5 com 50,8. Leia isto como o registo do que o 4.7 mudou, e veja a nossa análise completa do Claude Opus 5.5 para conhecer o modelo que a Anthropic vende hoje.
O Que Mudou no Opus 4.7
O Opus 4.7 não é um novo nível de modelo. É uma atualização direta ao Opus 4.6, continuando o ritmo de lançamentos da Anthropic de aproximadamente dois meses (Opus 4.5 em novembro de 2025, Opus 4.6 em fevereiro de 2026, agora Opus 4.7 em abril de 2026).
As maiores melhorias estão na engenharia de software, visão, seguimento de instruções e raciocínio sustentado ao longo de execuções agênticas longas. A Anthropic descreve o modelo como «altamente autónomo» e com um «desempenho excecional em trabalho agêntico de longo horizonte, trabalho de conhecimento, tarefas de visão e tarefas de memória».
Eis um resumo rápido do que há de novo:
- Aumento de 13% em programação num benchmark de 93 tarefas
- 3x mais tarefas de produção resolvidas no Rakuten-SWE-Bench
- Visão de alta resolução até 2.576 pixels (3,75 megapixels), o triplo do limite anterior
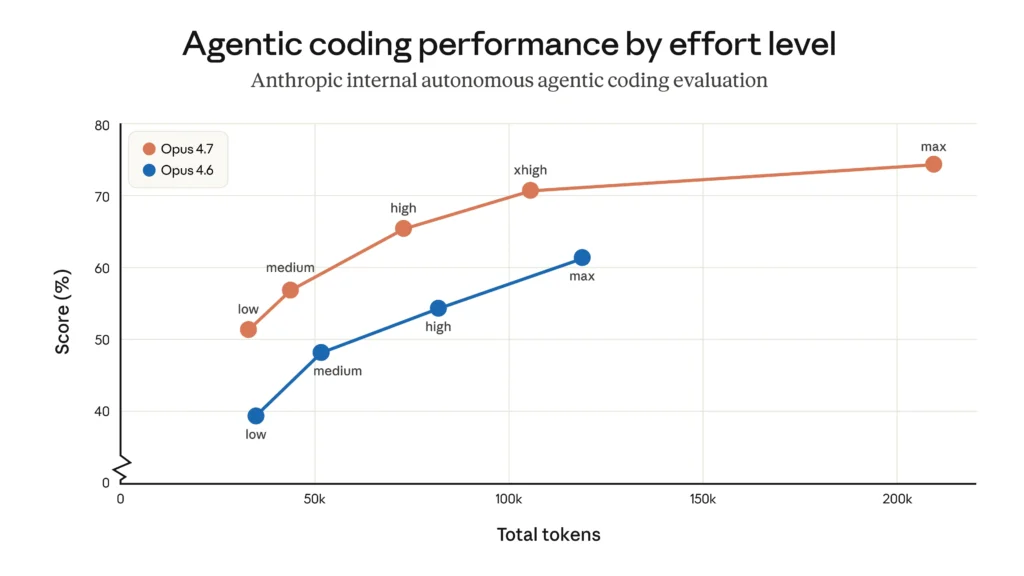
- Novo nível de esforço
xhighentrehighemax - Orçamentos de tarefa em beta público para utilizadores da API
- Tokenizador atualizado com desempenho melhorado (mas 1,0 a 1,35x mais tokens)
- Seguimento de instruções mais rigoroso (pode ser necessário reajustar os prompts)
- Melhor memória baseada no sistema de ficheiros em trabalho de várias sessões
- Salvaguardas de cibersegurança que detetam e bloqueiam pedidos de alto risco
Resultados dos Benchmarks
A Anthropic publicou números detalhados de benchmarks. O Opus 4.7 supera o Opus 4.6 em programação, visão, raciocínio sobre documentos e tarefas de trabalho de conhecimento. Segundo a Anthropic e relatórios de terceiros, superou o GPT-5.4 e o Gemini 3.1 Pro em programação agêntica e em tarefas de uso de computador no lançamento. A resposta da OpenAI chegou uma semana depois, com o GPT-5.5 a 23 de abril de 2026, e o panorama divide-se agora: o Opus 4.7 continua a liderar o SWE-bench Pro com 64,3% contra os 58,6% do GPT-5.5 para programação em vários ficheiros, enquanto o GPT-5.5 se destaca no Terminal-Bench 2.0 (82,7% contra 69,4%) e no OSWorld-Verified (78,7% contra 78,0%) para trabalho agêntico de uso de computador. Para saber onde isto deixa as duas empresas em termos de receita, avaliação e quota empresarial, veja a nossa análise Anthropic vs OpenAI.
| Benchmark | Melhoria em Relação ao Opus 4.6 |
|---|---|
| Benchmark de programação de 93 tarefas | Aumento de 13% |
| Rakuten-SWE-Bench (tarefas de produção) | 3x mais resolvidas |
| Sucesso em tarefas de fluxo de trabalho complexas | Melhoria de 10-15% |
| OfficeQA Pro (raciocínio sobre documentos) | 21% menos erros |
| Acuidade visual (uso de computador) | 98,5% contra 54,5% |
| Fluxos de trabalho de várias etapas | Melhoria de 14%, um terço menos erros de ferramentas |
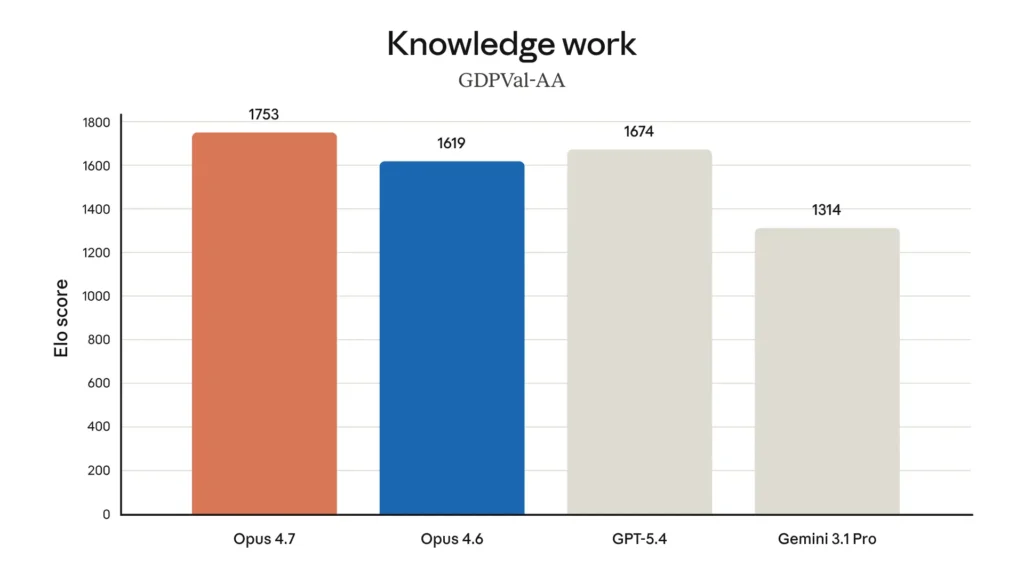
O Opus 4.7 também alcançou resultados de ponta no GDPval-AA, um benchmark que mede trabalho de conhecimento economicamente valioso nas áreas de finanças e direito.
O modelo ainda fica abaixo do Claude Mythos Preview, o modelo mais poderoso da Anthropic, que continua restrito a parceiros do Project Glasswing e não tem disponibilidade geral.
Suporte de Visão de Alta Resolução
Este é o primeiro modelo Claude com suporte de imagem de alta resolução. A resolução máxima de imagem passou de 1.568 pixels no lado maior (cerca de 1,15 megapixels) para 2.576 pixels (cerca de 3,75 megapixels). Isto é aproximadamente 3x a capacidade visual dos modelos Claude anteriores.
Os benefícios práticos incluem um melhor desempenho em:
- Uso de computador e compreensão de capturas de ecrã. As coordenadas do modelo agora correspondem 1:1 aos pixels reais, eliminando os cálculos de fator de escala que antes eram necessários.
- Análise de documentos. Uma resolução mais alta significa que o modelo consegue ler texto mais pequeno e detalhes mais finos em documentos digitalizados, diapositivos e diagramas.
- Perceção de baixo nível. Melhoria em apontar, medir, contar e tarefas de precisão semelhantes.
- Localização em imagens. Melhor deteção de caixas delimitadoras em imagens naturais.
Uma resolução mais alta significa mais tokens por imagem. Se a fidelidade extra não for necessária, a Anthropic recomenda reduzir a resolução das imagens antes de as enviar, para evitar custos de tokens desnecessários.
Novo Nível de Esforço e Orçamentos de Tarefa
O Opus 4.7 acrescenta o xhigh, um novo nível de esforço que se situa entre high e max. A Anthropic recomenda começar com xhigh para casos de uso de programação e agênticos, e usar pelo menos high para a maioria das tarefas sensíveis à inteligência.
O parâmetro de esforço permite trocar capacidade por velocidade e custo. Um esforço mais baixo significa respostas mais rápidas e económicas. Um esforço mais alto significa raciocínio mais aprofundado e mais chamadas a ferramentas.
Os orçamentos de tarefa são uma nova funcionalidade em beta público. Um orçamento de tarefa dá ao modelo um alvo aproximado de tokens para todo um ciclo agêntico (pensamento, chamadas a ferramentas, resultados de ferramentas e output final). O modelo vê uma contagem decrescente em curso e usa-a para priorizar o trabalho e concluir de forma controlada à medida que o orçamento se esgota.
Os orçamentos de tarefa são indicativos, não limites rígidos. São diferentes de max_tokens, que é um teto rígido por pedido de que o modelo não tem conhecimento. O orçamento de tarefa mínimo é de 20.000 tokens. Para tarefas agênticas abertas em que a qualidade importa mais do que a velocidade, a Anthropic recomenda não definir nenhum orçamento de tarefa.
Alterações Disruptivas na API
O Opus 4.7 introduz várias alterações disruptivas na Messages API. Se utiliza o Claude Managed Agents, não há alterações disruptivas na API.
Orçamentos de pensamento alargado removidos. Definir thinking: {"type": "enabled", "budget_tokens": N} agora devolve um erro 400. O pensamento adaptativo é o único modo de pensamento suportado. Para o ativar, defina explicitamente thinking: {"type": "adaptive"}. Está desativado por predefinição.
Parâmetros de amostragem removidos. Definir temperature, top_p ou top_k para qualquer valor não predefinido devolve um erro 400. A migração recomendada é omitir estes parâmetros por completo e usar o prompting para orientar o comportamento do modelo.
Conteúdo de pensamento omitido por predefinição. Os blocos de pensamento continuam a aparecer no stream de resposta, mas o seu conteúdo fica vazio a menos que ative explicitamente com "display": "summarized". Se o seu produto transmite o raciocínio aos utilizadores em stream, a nova predefinição vai parecer uma longa pausa antes de o output começar.
Tokenizador Atualizado
O Opus 4.7 usa um novo tokenizador que contribui para o seu desempenho melhorado em várias tarefas. A contrapartida é que o mesmo texto de entrada pode produzir de 1,0x a 1,35x mais tokens em comparação com o Opus 4.6. O aumento exato varia consoante o tipo de conteúdo.
A janela de contexto de 1M de tokens continua disponível ao preço padrão da API, sem sobretaxa para contexto longo. A Anthropic recomenda atualizar os parâmetros max_tokens para dar margem adicional, incluindo os gatilhos de compactação.
Alterações de Comportamento a Ter em Conta
Estas não são disruptivas na API, mas podem exigir atualizações aos prompts se estiver a migrar do Opus 4.6:
- Seguimento de instruções mais literal. O modelo não generaliza silenciosamente uma instrução de um item para outro nem infere pedidos que não fez. Isto é especialmente percetível em níveis de esforço mais baixos.
- O comprimento da resposta adapta-se à complexidade da tarefa, em vez de assumir por predefinição uma verbosidade fixa.
- Menos chamadas a ferramentas por predefinição. O modelo usa mais raciocínio e menos ferramentas. Aumentar o esforço aumenta o uso de ferramentas.
- Tom mais direto e assertivo. Menos linguagem orientada para a validação e menos emojis do que o estilo mais caloroso do Opus 4.6.
- Atualizações de progresso mais regulares durante execuções agênticas longas. Se acrescentou estruturas para forçar mensagens de estado intermédias, tente removê-las.
- Menos subagentes gerados por predefinição. Pode ser orientado através do prompting.
Memória e Trabalho de Conhecimento
O Opus 4.7 é melhor a escrever e a usar memória baseada no sistema de ficheiros. Se um agente de IA mantém um bloco de notas, um ficheiro de notas ou um armazenamento de memória estruturado ao longo das interações, deverá ser melhor a registar notas e a aproveitá-las em tarefas futuras.
O modelo também mostra ganhos significativos em trabalho de conhecimento, particularmente em tarefas em que precisa de verificar visualmente os seus próprios outputs:
- Edição de documentos. Melhor a produzir e a autoverificar alterações registadas em ficheiros .docx e layouts de diapositivos em ficheiros .pptx.
- Gráficos e figuras. Melhor a chamar ferramentas de forma programática com bibliotecas de processamento de imagem para analisar gráficos, incluindo a transcrição de dados ao nível do pixel.
A Anthropic nota que o modelo é «mais criterioso e criativo ao concluir tarefas profissionais, produzindo interfaces, diapositivos e documentos de maior qualidade».
Segurança e Salvaguardas de Cibersegurança
A fasquia a superar é alta. Em maio de 2026, a Palisade Research descobriu que o Opus 4.6 se autorreplicou em 81% dos testes de hacking, mais do que qualquer outro modelo de fronteira avaliado, pelo que as salvaguardas do Opus 4.7 chegam sobre uma base já capaz.
O Opus 4.7 mantém um perfil de segurança semelhante ao do Opus 4.6, que a Anthropic descreve como «amplamente bem alinhado e fiável». Mostra melhorias na honestidade e na resistência a injeção de prompts, embora a Anthropic note que é ligeiramente mais fraco nos detalhes de aconselhamento sobre redução de danos.
A adição notável são as salvaguardas de cibersegurança em tempo real. Pedidos que envolvam tópicos de cibersegurança proibidos ou de alto risco podem desencadear recusas automáticas. Isto é uma consequência direta da situação do Claude Mythos, em que a Anthropic descobriu que os seus modelos mais poderosos conseguiam encontrar e explorar vulnerabilidades de software a um nível que rivaliza com investigadores de segurança humanos experientes.
As capacidades de cibersegurança do Opus 4.7 foram deliberadamente reduzidas em comparação com o Mythos Preview. A Anthropic afirmou que iria «lançar novas salvaguardas com um futuro modelo Claude Opus» antes de disponibilizar mais amplamente capacidades de classe Mythos, e o Opus 4.7 parece ser esse modelo.
Para profissionais de segurança legítimos, a Anthropic lançou um Cyber Verification Program que permite candidatar-se a exceções às salvaguardas incorporadas.
Como se Compara ao Opus 4.6
| Aspeto | Claude Opus 4.6 | Claude Opus 4.7 |
|---|---|---|
| Programação (93 tarefas) | Base | +13% |
| Rakuten-SWE-Bench | Base | 3x mais tarefas resolvidas |
| Acuidade visual | 54,5% | 98,5% |
| Raciocínio sobre documentos (OfficeQA Pro) | Base | 21% menos erros |
| Resolução máxima de imagem | 1.568px / 1,15MP | 2.576px / 3,75MP |
| Janela de contexto | 1M tokens | 1M tokens |
| Tokens de output máximos | 128K | 128K |
| Níveis de esforço | low, medium, high, max | low, medium, high, xhigh, max |
| Pensamento alargado | Suportado | Removido (apenas adaptativo) |
| Temperature/top_p/top_k | Suportado | Removido |
| Preços (input/output) | $5 / $25 por 1M de tokens | $5 / $25 por 1M de tokens |
Os maiores saltos são em visão (de 54,5% para 98,5% em acuidade visual) e em programação de produção (3x no Rakuten-SWE-Bench). A contrapartida são restrições mais apertadas na API: já não há orçamentos de pensamento manuais, não há controlo dos parâmetros de amostragem, e um tokenizador que usa até 35% mais tokens para a mesma entrada.
Onde se Situa na Linha Claude
Na altura do lançamento do 4.7, a Anthropic tinha três níveis de modelo ativos, além do nível restrito Mythos. A linha e as tarifas atuais são as seguintes:
| Modelo | Melhor Para | Preços (input/output por 1M) |
|---|---|---|
| Haiku 4.5 | Tarefas rápidas e leves | $1 / $5 |
| Sonnet 5 | Desempenho e custo equilibrados | $2 / $10, permanente desde 10 de agosto de 2026 |
| Opus 5.5 | Raciocínio complexo, programação agêntica, o modelo com que a Anthropic diz para começar | $4 / $20 |
| Opus 5 (legado) | Substituído pelo Opus 5.5 | $5 / $25 |
| Opus 4.7 (legado) | O modelo que este artigo cobre | $5 / $25 |
| Fable 5.1 | Maior capacidade disponível | $10 / $50 |
| Fable 5 | Substituído pelo Fable 5.1, mesmo preço | $10 / $50 |
| Mythos 5.1 | Cibersegurança e ciências da vida (apenas por convite) | $10 / $50 |
O Opus 4.7 era o modelo mais capaz que se podia realmente usar quando foi lançado; esse título pertence agora ao Opus 5.5. O Mythos Preview pontua mais alto em todos os benchmarks, mas continua trancado atrás do Project Glasswing, disponível apenas para parceiros de plataforma como a Apple, a Google e a Microsoft.
Preços e Disponibilidade
Os preços mantêm-se inalterados em relação ao Opus 4.6:
- Input: $5 por milhão de tokens
- Output: $25 por milhão de tokens
- Desconto de prompt caching: até 90% de poupança
- Desconto de processamento em lote: 50% de poupança
- Inferência apenas nos EUA: multiplicador de preço de 1,1x
O modelo está disponível em:
- Subscrições Claude Pro, Max, Team e Enterprise
- API Claude, como
claude-opus-4-7 - Amazon Bedrock
- Google Cloud Vertex AI
- Microsoft Foundry
A janela de contexto de 1M de tokens está incluída ao preço padrão, sem sobretaxa para contexto longo. O output máximo é de 128K tokens.
O Que Isto Significa Para Si
Para programadores e utilizadores da API. As alterações disruptivas são a preocupação mais urgente. Se o seu código define temperature, top_p, top_k, ou usa orçamentos de pensamento alargado, essas chamadas vão começar a devolver erros 400 no Opus 4.7. O caminho de migração é simples: mude para pensamento adaptativo, remova os parâmetros de amostragem e use o prompting para controlar o comportamento do output. O novo nível de esforço xhigh e os orçamentos de tarefa dão-lhe um controlo mais fino sobre o equilíbrio entre qualidade e custo.
Para utilizadores do Claude Code. O Opus 4.7 já é o modelo predefinido no Claude Code. A Anthropic também acrescentou um novo comando de barra /ultrareview para revisões de código mais aprofundadas. O seguimento de instruções mais rigoroso e a autocorreção melhorada do modelo devem traduzir-se em menos idas e voltas em tarefas complexas. O Cowork, o agente de IA de computador da Anthropic, é um dos locais mais claros para ver o Opus 4.7 em ação; veja o nosso guia completo do Claude Cowork para saber o que faz, como configurá-lo e a nova funcionalidade móvel Dispatch. Para saber como o Cowork (a funcionar com o Opus 4.7) se compara ao novo agente da Google, veja a nossa comparação Gemini Spark vs Claude Cowork.
Para utilizadores comuns de IA, o Opus 4.7 não vai parecer um grande salto em relação ao 4.6. As melhorias são úteis principalmente se trabalha muito com imagens, documentos ou tarefas mais longas de várias etapas; segue instruções com mais rigor e lida com o contexto um pouco melhor. Se quiser experimentar o Opus 4.7 juntamente com o ChatGPT, Gemini, Grok e DeepSeek, pode aceder a todos num só lugar com o Fello AI no Mac, iPhone e iPad por $9.99/mês (também abordado na nossa lista dos melhores aplicações de IA para iPhone), com mais de 25.000 avaliações de cinco estrelas.
Este é o quarto lançamento Opus da Anthropic em seis meses (4.1, 4.5, 4.6, 4.7), e o ritmo não está a abrandar. Com as capacidades de classe Mythos à espera nos bastidores e as novas salvaguardas de cibersegurança do Opus 4.7 a testar o terreno, é de esperar que o próximo Opus empurre ainda mais a fronteira do que está disponível ao público em geral.
Em cobertura relacionada, leia sobre o exploit do Apple M5 construído com o Claude Mythos.