El 8 de julio de 2026, xAI lanzó Grok 4.5, su primer modelo diseñado específicamente para programación y trabajo agéntico. No es una mejora de capacidades generales, sino un giro deliberado hacia los desarrolladores, con entrenamiento basado en datos reales de sesiones de Cursor y benchmarks creados para medir lo que una IA puede hacer dentro de una base de código real durante una sesión larga. El 12 de agosto de 2026 fue superado por Grok 4.6, una mejora de post-entrenamiento sobre la misma base. Grok 4.6, a su vez, dejó paso a Grok 4.7 el 21 de septiembre de 2026, y Artificial Analysis ya lista Grok 4.5 como obsoleto.
El resultado es un modelo que obtiene 38,8 en el Artificial Analysis Intelligence Index v4.3.2, a una fracción del coste que tiene hoy la frontera de Anthropic. Artificial Analysis gasta $1.04 para ejecutar Grok 4.5 en el índice, frente a $5.98 para el Claude Opus 5.5 actual de Anthropic con razonamiento máximo. OpenAI, en cambio, ha cerrado esa brecha: GPT-6.1 Sol ejecuta el mismo índice por $0.72 con razonamiento máximo y obtiene 51,8. Nuestra guía de los benchmarks de IA explica qué miden realmente esas cifras.
Elon Musk lo posicionó directamente: «Es un modelo de clase Opus, pero más rápido, más eficiente en tokens y de menor coste.» En un mensaje posterior fue más preciso: «Grok 4.5 es aproximadamente comparable a Opus 4.7, pero mucho más rápido.»
Musk también indicó que las velocidades actuales no son el techo. xAI aún no ha desplegado su stack de inferencia interno en C/C++ que se mapea directamente al hardware GB300, y cuando lo haga espera que la velocidad se duplique o supere eso. Señaló una mejora importante para el mes siguiente, y llegó por partida doble: Grok 4.6 el 12 de agosto de 2026 y después Grok 4.7 el 21 de septiembre de 2026. grok-4.5-latest ya no encabeza la lista de modelos de xAI.
Lo más importante
- Grok 4.5 se lanzó el 8 de julio de 2026 y obtiene 38,8 en el Artificial Analysis Intelligence Index v4.3.2. En el lanzamiento quedó 4.º de 168 entradas y ahora está en el puesto 56 de 664.
- Construido sobre el modelo base V9 de 1,5 billones de parámetros y entrenado con datos reales de sesiones de Cursor para tareas de programación y trabajo agéntico.
- Con un precio de $2 / $6 por millón de tokens y entradas en caché a $0.30, frente a $4 / $20 del Claude Opus 5.5, el modelo que Anthropic vende ahora como su caballo de batalla. Artificial Analysis gasta $1.04 por tarea del Intelligence Index con este modelo, frente a $5.98 con Opus 5.5.
- Muy eficiente en tokens: usa unos 14 000 tokens de salida por tarea del Intelligence Index frente a los 67 020 de Opus 4.8 según la comparación de xAI el día del lanzamiento.
- Musk lo llama «de clase Opus, pero más rápido», con un stack de inferencia personalizado que se espera duplique los actuales ~80 tokens/seg.
Qué es realmente Grok 4.5
Grok 4.5 es el primer modelo de xAI entrenado desde cero para tareas de programación y trabajo agéntico, no para inteligencia general. Construido sobre el modelo base V9 de 1,5 billones de parámetros, se entrenó en colaboración con Cursor para gestionar trabajos de larga duración en múltiples repositorios y operar con mínima intervención humana a lo largo de cientos de llamadas a herramientas. Esa colaboración produjo después el producto de agente de SpaceXAI, que aplica el mismo enfoque en una aplicación de escritorio.
Las especificaciones principales son directas.
| Especificación | Detalle |
|---|---|
| Nombre del modelo en API | grok-4.5 |
| Arquitectura | Modelo base V9, 1,5 billones de parámetros (3 veces mayor que el V8 de Grok 4.3) |
| Ventana de contexto | 500 000 tokens |
| Velocidad | aproximadamente 80 tokens por segundo en el lanzamiento; Artificial Analysis mide ahora una mediana de 58 t/s |
| Modalidades de entrada | texto e imágenes (visión) |
| Razonamiento | configurable en esfuerzo bajo, medio, alto o xhigh (por defecto alto) |
| APIs compatibles | Responses API y Chat Completions |
| Capacidades integradas | llamada a funciones, búsqueda web, búsqueda en X, ejecución de código |
El nombre V9 marca un cambio generacional completo respecto a la serie V8 que impulsaba Grok 4.3, triplicando la escala y desplazando el foco de entrenamiento por completo hacia la programación y las tareas agénticas. La ventana de contexto se redujo del millón de tokens de Grok 4.3 a 500 000, lo que es un compromiso real para quienes necesitaban el millón completo.
La conexión con Cursor
El «entrenado con Cursor» del anuncio no es solo una colaboración de marketing. A mediados de junio de 2026, SpaceX adquirió Cursor por aproximadamente $60 000 millones, incorporando uno de los editores de IA para programación más utilizados directamente al ecosistema de xAI. Esa adquisición explica por qué el entrenamiento de Grok 4.5 incorporó datos reales de sesiones de desarrolladores de Cursor, dando a xAI acceso directo a los flujos de trabajo reales, los patrones de contexto y las estructuras de tareas de largo alcance que los desarrolladores usan en producción.
A diferencia del entrenamiento con repositorios de código público, los datos de sesiones reales capturan cómo los desarrolladores iteran sobre un problema, cambian de contexto entre archivos y toman decisiones de varios pasos dentro de proyectos reales. Grok 4.5 es el primer modelo que refleja eso.
xAI también introdujo junto a este modelo una nueva metodología de entrenamiento, el aprendizaje asíncrono, que permite que las ejecuciones de entrenamiento agéntico de varias horas avancen en paralelo con el entrenamiento del modelo en curso, en lugar de hacerlo de forma secuencial. El efecto práctico es que los bucles de retroalimentación entre el comportamiento del modelo y sus actualizaciones de entrenamiento son mucho más ajustados, lo que permite al modelo manejar el tipo de sesiones autónomas de larga duración en las que la mayoría de los agentes se atascan.
Resultados en benchmarks
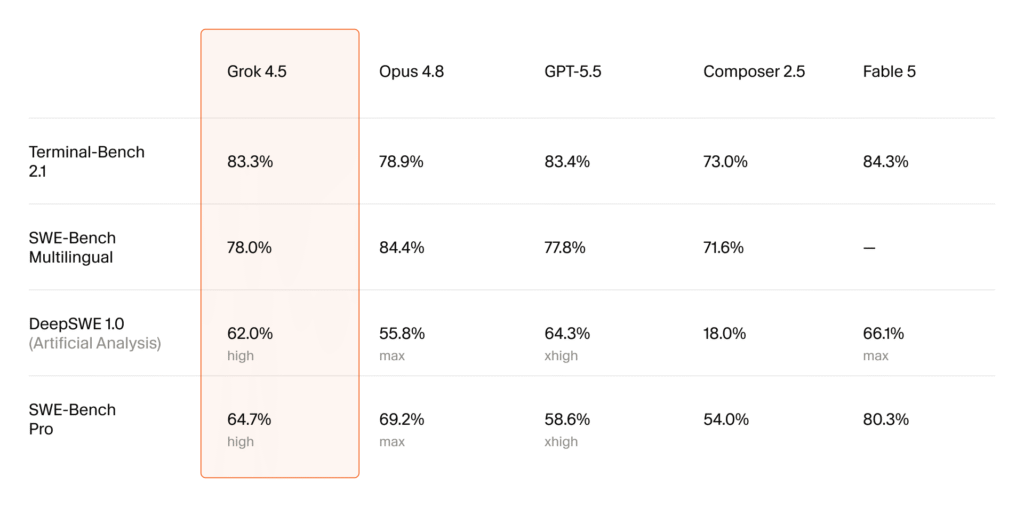
Benchmarks publicados por xAI en el lanzamiento
| Benchmark | Fable 5 | GPT-5.5 | Grok 4.5 | Opus 4.8 | GLM-5.2 |
|---|---|---|---|---|---|
| DeepSWE 1.0 | 66,1% | 64,3% | 62,0% | 55,8% | n/a |
| DeepSWE 1.1 | 70,0% | 67,0% | 53,0% | 59,0% | 44,0% |
| Terminal-Bench 2.1 | 84,3% | 83,4% | 83,3% | 78,9% | n/a |
| SWE-Bench Pro | 80,4% | n/a | 64,7% | 69,2% | 62,1% |
Estas son las cifras que xAI publicó el 8 de julio de 2026, medidas frente a los modelos vigentes ese día. Leídas directamente: Grok 4.5 supera a Opus 4.8 en dos de los cuatro benchmarks (DeepSWE 1.0 y Terminal-Bench 2.1) y queda por detrás en los otros dos (DeepSWE 1.1 y SWE-Bench Pro). Claude Fable 5 lidera los cuatro y, en Terminal-Bench 2.1, el margen entre Grok 4.5 (83,3%) y GPT-5.5 (83,4%) es de una décima. Opus 4.8 y GPT-5.5 han sido superados dos veces cada uno desde entonces: primero por Claude Opus 5 y GPT-5.6 Sol, después por Claude Opus 5.5 y GPT-6 Astra. xAI no ha publicado datos directos frente a ninguno de los cuatro, por lo que la sección de clasificaciones actuales es la que debes consultar para tomar decisiones de compra.
Benchmarks independientes de Artificial Analysis
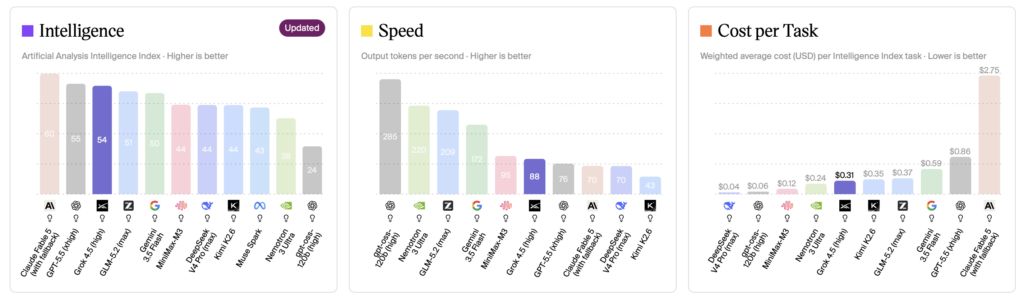
En el Artificial Analysis Intelligence Index, ahora en la versión v4.3.2, Grok 4.5 con razonamiento alto obtiene 38,8. Grok 4.3 obtiene 24,9 en el mismo tablero, así que este sigue siendo el mayor salto generacional que xAI ha registrado en este índice. Todas las cifras de Artificial Analysis que siguen llevan la versión del índice de la que proceden, porque las versiones no son comparables entre sí. El mismo modelo marcaba 56 en v4.1.1: Artificial Analysis reescaló todo el tablero entre ambas versiones y la cifra bajó sin que el modelo cambiara. Una afirmación del lanzamiento no ha sobrevivido a ese cambio. Grok 4.5 ya no supera a todos los modelos de Gemini, porque Gemini 3.8 Flash obtiene 40,9 con esfuerzo alto. Gemini 3.6 Flash, el Gemini más fuerte del tablero cuando salió Grok 4.5, está ahora en 34,0.
Su posición sí ha cambiado, y vale la pena decirlo con claridad. Grok 4.5 fue cuarto de 168 entradas en el lanzamiento del 8 de julio. En el tablero v4.3.2, a 25 de septiembre de 2026, ocupa el puesto 56 de 664 entradas, con 27 modelos distintos por encima, entre ellos Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, Claude Opus 5, Muse Spark 1.3, GPT-6 Sol, Grok 4.7, Qwen3.8 Max, GLM-5.3, Grok 4.6 y Kimi K3. Claude Opus 4.8, contra el que se midió Grok 4.5 en el lanzamiento, sigue en el tablero y con 41,8 queda por delante. El reescalado movió la puntuación, el campo movió el puesto.
Otra afirmación del lanzamiento ha quedado superada por completo. Grok 4.5 ya no supera a todos los modelos de pesos abiertos, porque Kimi K3 publicó sus pesos abiertos el 27 de julio de 2026 y obtiene 43,6 en v4.3.2. GLM-5.3 con 44,8 y MiMo-V2.6-Pro con 46,3, también de pesos abiertos, quedan igualmente por delante.
En GDPval-AA, el benchmark que mide el trabajo agéntico de conocimiento sostenido y que ya va por la v2.1, Grok 4.5 obtiene un Elo de 1 370, por delante de GLM-5.2 con 1 358 y por detrás de Claude Opus 4.8 con 1 438. En el lanzamiento quedó cuarto. Claude Opus 5 ha publicado desde entonces 1 708, y el Claude Opus 5.5 lidera el tablero con 1 846. En la subtarea de razonamiento financiero más difícil, tau3-Banking, Grok 4.5 alcanza el 42,1%, todavía cómodamente por delante de GPT-5.5 (xhigh) con el 39,0%. Ya no es la puntuación más alta, eso sí. Ese tablero lo lidera Qwen3.8 Max con el 51,3%.
En el Artificial Analysis Coding Agent Index (DeepSWE, Terminal-Bench v2 y SWE-Atlas QnA combinados), Grok 4.5 en el harness Grok Build obtiene 76, cifra que en julio de 2026 le valió el tercer puesto. Estaba al nivel de GPT-5.5 (xhigh) en Codex y justo por debajo de Fable 5 (max) en Claude Code. Artificial Analysis ha retirado ese índice desde entonces, y ni DeepSWE ni SWE-Atlas QnA figuran en su lista actual de evaluaciones, así que esta cifra no se puede actualizar frente a los modelos de hoy.
xAI también reporta el Harvey Legal Agent Benchmark, en el que Grok 4.5 queda primero. Combinado con la primera posición en tau3-Banking, esto apunta al trabajo jurídico y financiero como fortalezas específicas más allá de lo que capturan los benchmarks de programación solos.
Eficiencia en tokens
El precio por token es el titular, pero la eficiencia en tokens es el dato más relevante. En SWE-Bench Pro, Grok 4.5 usó aproximadamente 15 954 tokens de salida por tarea frente a los 67 020 de Opus 4.8, una diferencia de 4,2x. En el Artificial Analysis Intelligence Index usa aproximadamente 14 000 tokens de salida por tarea, más del 60% menos que Opus 4.8. En el Coding Agent Index promedia 1,9 millones de tokens totales por tarea, frente a 7,2 millones de Fable 5 en Claude Code y 6,2 millones de GPT-5.5 en Codex.
Un modelo que usa 4 veces menos tokens no es solo más barato por tarea. También es más rápido y genera menos ruido en los pipelines agénticos, algo que importa en el trabajo autónomo de múltiples pasos.
Precios y coste por tarea
Grok 4.5 tiene un precio de $2.00 por millón de tokens de entrada y $6.00 por millón de tokens de salida. Los aciertos de caché tienen un descuento del 85%, lo que deja los tokens de entrada en caché en $0.30 por millón. Un aviso importante: el precio se duplica para entradas superiores a 200 000 tokens. Para un desglose completo de los precios de suscripción y API de Grok, incluyendo los niveles de consumidor, esa guía cubre todas las opciones.
Frente a la frontera actual, eso supone la mitad de lo que cobra el Claude Opus 5.5 por la entrada y menos de un tercio de lo que cobra por la salida, a $4 / $20. El Opus 5 con el que se midió Grok 4.5 durante casi toda su vida estaba a $5 / $25 y hoy figura en la lista de modelos heredados de Anthropic. Pero el coste por tarea es el dato más relevante, ya que tiene en cuenta cuántos tokens gasta realmente cada modelo. La tabla siguiente recoge las cifras de xAI y Artificial Analysis publicadas en el lanzamiento en julio de 2026.
| Modelo | Entrada (por 1M) | Salida (por 1M) | Coste por tarea del Intelligence Index | Coste por tarea del Coding Agent |
|---|---|---|---|---|
| Grok 4.5 | $2.00 | $6.00 | $0.31 | $2.49 |
| GPT-5.5 (Codex) | $5.00 | $30.00 | superior | $5.07 |
| Fable 5 (Claude Code) | $10.00 | $50.00 | superior | $11.80 |
| Opus 4.8 | $5.00 | $25.00 | superior | n/a |
Las cifras por tarea son las que realmente importan a escala de producción. Grok 4.5 logró un rendimiento casi equivalente como agente de programación a aproximadamente la mitad del coste de GPT-5.5 y menos de una cuarta parte del coste de Fable 5 por trabajo completado. Esa ventaja se ha mantenido frente a Anthropic a medida que el campo avanza, pero no frente a OpenAI. En el Intelligence Index v4.3.2, Artificial Analysis sitúa el coste de ejecutar Grok 4.5 en $1.04 frente a $5.98 de Claude Opus 5.5 con razonamiento máximo, mientras que GPT-6.1 Sol con razonamiento alto lo ejecuta por $0.32 y puntúa más alto.
Dónde está disponible Grok 4.5
Grok 4.5 se activó en un amplio conjunto de plataformas el día del lanzamiento. Está disponible en la API de xAI bajo el nombre de modelo grok-4.5, en Grok Build (el harness propio de xAI para agentes de programación) y en Cursor en todos los planes. El acceso de terceros incluye OpenRouter, Vercel, Cloudflare, Snowflake y Databricks Mosaic. También está disponible en Fello AI para Mac, iPhone y iPad.
El lanzamiento del plugin para Office es destacable. xAI posiciona Grok 4.5 no solo como modelo de programación, sino como modelo para trabajo de conocimiento capaz de construir modelos complejos de Excel con investigación web integrada y generar contenido sofisticado de PowerPoint. Eso amplía el caso de uso potencial mucho más allá del desarrollo de software.
La brecha con la UE se ha cerrado. Grok 4.5 se lanzó en 47 países, pero estaba bloqueado en los 27 estados miembros de la UE, un retraso atribuido al trabajo de cumplimiento bajo la Ley de IA de la UE, que trata a los modelos entrenados por encima de 1025 FLOPs como portadores de riesgo sistémico. xAI abrió el acceso a la UE a finales de julio de 2026 y su documentación para desarrolladores ya no incluye la restricción regional que mostraba en el lanzamiento.
El modelo es compatible tanto con la Responses API como con el formato Chat Completions, lo que significa que encaja en bases de código ya construidas sobre APIs compatibles con OpenAI sin necesidad de modificación.
Qué dijo Elon Musk
Musk hizo varias declaraciones alrededor del día del lanzamiento que indican dónde encaja este modelo y hacia dónde va.
Sobre el posicionamiento de capacidades: «Es un modelo de clase Opus, pero más rápido, más eficiente en tokens y de menor coste», con una aclaración posterior de que es «aproximadamente comparable a Opus 4.7, pero mucho más rápido.» Ese último detalle importa: Musk compara con Opus 4.7, no con 4.8, algo que los datos independientes respaldan en términos generales.
Sobre el techo de velocidad: «Grok 4.5 aún no usa nuestro software de inferencia interno en C/C++ que se mapea exactamente al hardware GB300. Probablemente se pueda duplicar o superar la velocidad actual.» El rendimiento actual de unos 80 tokens por segundo no es la cifra definitiva. El stack de inferencia personalizado está en desarrollo y añadirá más velocidad sin cambiar los pesos del modelo.
Sobre lo que viene: «La versión del próximo mes supondrá otra mejora significativa, a medida que cerremos el bucle resolviendo problemas de ingeniería reales en Tesla, SpaceX, Neuralink y Boring Company.» Ese bucle de retroalimentación del trabajo de ingeniería real en las empresas hermanas de xAI es una fuente de datos de entrenamiento que ningún otro laboratorio tiene a la misma escala.
Sobre las futuras capacidades multimodales: Grok ganará la capacidad de llamar a Grok Imagine como herramienta en modo agéntico, invocando la generación de imágenes y vídeo como parte de un flujo de trabajo autónomo más largo en lugar de como una función separada. Musk señaló que esto es especialmente valioso para los desarrolladores de videojuegos.
Primeras reacciones de los usuarios
Las opiniones de los desarrolladores con acceso anticipado a través de Cursor fueron positivas. Danny Limanseta lo describió como «Opus 4.8 al doble de velocidad y a un precio mucho menor» tras usarlo para hacer brainstorming, planificar e implementar una función compleja de un juego a lo largo de una sesión completa sin necesidad de corregirlo manualmente en cada paso.
Artificial Analysis resumió el cambio competitivo de forma directa el día del lanzamiento, escribiendo que Grok 4.5 «lleva a SpaceXAI a la frontera de la inteligencia por detrás solo de OpenAI y Anthropic, superando a todos los modelos de pesos abiertos y notablemente a los modelos Gemini de Google». Las dos partes de esa frase han quedado superadas desde entonces, como se indica arriba.
Cómo se compara Grok 4.5 con la competencia
Frente a la frontera actual, Grok 4.5 rara vez ocupa el primer puesto en capacidad bruta. Frente a Anthropic sigue ganando en coste y eficiencia de tokens; frente a GPT-6.1 Sol de OpenAI, ya no. A continuación se compara modelo por modelo, usando el tablero Artificial Analysis v4.3.2 para lo actual y las cifras del lanzamiento de xAI donde son los únicos datos publicados.
Frente a Grok 4.3
38,8 frente a los 24,9 de Grok 4.3 en v4.3.2 es el mayor salto generacional en el linaje de Grok. La ventana de contexto se redujo a la mitad, de 1M a 500 000 tokens, y las modalidades de entrada se limitaron a texto e imágenes, que son los dos compromisos reales. Si has estado usando Grok 4.3 para programación, Grok 4.5 es una mejora significativa en todas las demás dimensiones.
Frente a Claude Opus 5.5
El Claude Opus 5.5 relevó al Claude Opus 5 el 22 de septiembre de 2026 y ahora lidera el Intelligence Index v4.3.2 con 57,6, por delante de Claude Fable 5.1 con 53,4 y de GPT-6 Astra de OpenAI con 52,7. Son casi diecinueve puntos por encima de Grok 4.5, donde Opus 5 sacaba doce. También tiene una ventana de contexto de 1M de tokens frente a los 500 000 de Grok 4.5. La comparación de costes sigue yendo en sentido contrario, aunque por menos que antes. Opus 5.5 tiene un precio de $4 / $20 por millón de tokens frente a $2 / $6, mientras que el Opus 5 al que sustituyó estaba a $5 / $25, y Artificial Analysis gasta $5.98 ejecutando Opus 5.5 en el índice frente a $1.04 para Grok 4.5. Para el trabajo de programación más difícil y abierto, Opus 5.5 tiene ventaja; para pipelines agénticos donde el coste por tarea se acumula a lo largo de cientos de llamadas a herramientas, Grok 4.5 ofrece mejor economía.
Frente a Claude Fable 5.1
Fable 5 lideraba los cuatro benchmarks de xAI en el lanzamiento, y la brecha de costes era la mayor de cualquier comparación: $2.49 frente a $11.80 por tarea del Coding Agent, casi 5x. Desde entonces lo ha sustituido Claude Fable 5.1, y Artificial Analysis ya lista Fable 5 como obsoleto. En v4.3.2 Fable 5.1 obtiene 53,4 con esfuerzo máximo frente a los 38,8 de Grok 4.5, y Artificial Analysis gasta $7.63 en ejecutarlo en el índice frente a $1.04, más de 7x. Para cargas de trabajo donde el rendimiento absoluto de programación es obligatorio, Fable 5.1 va por delante. Por un coste por tarea mucho menor, gana Grok 4.5.
Frente a GPT-6.1 Sol
GPT-6 Astra es el modelo estrella de OpenAI, pero GPT-6.1 Sol es la comparación más cercana en el tablero, y es el que desmonta el argumento de coste de Grok 4.5. En v4.3.2 GPT-6.1 Sol obtiene 51,8 con razonamiento máximo y 50,2 con razonamiento alto, frente a los 38,8 de Grok 4.5 con razonamiento alto. Artificial Analysis gasta $0.72 en ejecutarlo en el índice al máximo, menos que los $1.04 de Grok 4.5, y $0.32 en alto. Con el mismo razonamiento alto, GPT-6.1 Sol es once puntos más fuerte por menos de un tercio del coste. Su precio de lista es más alto en salida, $2 / $10 por millón de tokens frente a $2 / $6, pero gasta muchos menos tokens por tarea. OpenAI lo lanzó el 29 de septiembre de 2026 como sucesor de GPT-6 Sol, con el que comparaba esta sección hasta entonces y que obtiene 47,5 al máximo y 42,8 en alto. GPT-5.6 Sol, la comparación anterior, sigue disponible en la API de OpenAI, y Artificial Analysis ya lo lista como obsoleto.
Frente al par del día del lanzamiento, Opus 4.8 y GPT-5.5
Ambos modelos contra los que se midió Grok 4.5 en julio han pasado a ser legado, pero los datos merecen conservarse porque son los únicos head-to-head que xAI publicó. Frente a Opus 4.8, Grok 4.5 ganó en DeepSWE 1.0 y Terminal-Bench 2.1 y perdió en DeepSWE 1.1 y SWE-Bench Pro. Frente a GPT-5.5, el margen en Terminal-Bench 2.1 fue de una décima (83,3% frente a 83,4%), el Coding Agent Index quedó en empate y Grok 4.5 lideró tau3-Banking por 2 puntos a aproximadamente la mitad del coste por tarea ($2.49 frente a $5.07).
Frente a GLM-5.2
Grok 4.5 se sitúa ligeramente por delante de GLM-5.2 en GDPval-AA v2.1 (Elo 1 370 frente a 1 358). Grok 4.5 lidera también en el Intelligence Index general, 38,8 frente a 33,7 en v4.3.2, y en tau3-Banking, 42,1% frente a 34,6%.
Por qué importa este lanzamiento
Hay tres aspectos del lanzamiento de Grok 4.5 que vale la pena seguir más allá de los números de los benchmarks.
xAI ha alcanzado la frontera de la inteligencia. Grok 4.3 no competía con Anthropic y OpenAI en lo alto de los rankings de capacidades, con un 24,9 en el Intelligence Index v4.3.2. Grok 4.5 sí lo hizo, con 38,8 en el mismo tablero, y xAI se ha mantenido ahí desde entonces: Grok 4.6 obtiene 44,3 y Grok 4.7, 46,3. Eso cambió la estructura competitiva del mercado de una carrera entre dos a una entre tres.
La eficiencia en costes es real, no solo un descuento de precio. Grok 4.5 es más barato por token, pero también es drásticamente más eficiente en tokens por tarea. Un modelo que produce el mismo resultado en 14 000 tokens cuando un competidor necesita 67 000 no solo es más barato de ejecutar, también es más rápido y genera menos ruido en los flujos de trabajo agénticos. Ambas cosas importan a escala de producción.
El techo de velocidad no se alcanzó en el lanzamiento. xAI habló de unos 80 tokens por segundo el día del lanzamiento, y Artificial Analysis mide ahora una mediana de 58 tokens de salida por segundo. Musk esperaba que el stack de inferencia personalizado en C/C++ mapeado al hardware GB300 duplicara la cifra de lanzamiento, lo que habría hecho significativamente más rápido a un modelo ya competitivo en coste y calidad sin ninguna actualización del modelo.
Grok 4.5 está disponible en Fello AI, donde puedes usarlo junto a Claude, ChatGPT, Gemini, DeepSeek y Perplexity en una sola aplicación nativa para Mac, iPhone y iPad, comparando la misma tarea en todos los modelos de frontera con una sola suscripción en lugar de gestionar cuentas separadas. Para contexto sobre lo que viene después de Grok 4.5, el artículo sobre Grok 5 cubre lo que xAI ha señalado sobre la próxima versión principal.
FAQ
¿Cuándo se lanzó Grok 4.5?
xAI lanzó Grok 4.5 el 8 de julio de 2026. Es el primer modelo de xAI diseñado específicamente para programación y trabajo agéntico, entrenado con datos reales de sesiones de desarrolladores de Cursor.
¿Cuánto cuesta Grok 4.5?
El precio de la API es $2.00 por millón de tokens de entrada y $6.00 por millón de tokens de salida. Los aciertos de caché tienen un descuento del 85%, reduciendo la entrada en caché a $0.30 por millón. El precio se duplica para entradas superiores a 200 000 tokens.
¿Es Grok 4.5 mejor que Claude Opus 5.5?
No en capacidad bruta. El Claude Opus 5.5, el modelo actual de Anthropic, obtiene 57,6 en el Artificial Analysis Intelligence Index v4.3.2 frente a los 38,8 de Grok 4.5, y tiene una ventana de contexto de 1M tokens frente a 500 000. Grok 4.5 gana de forma clara en coste, a $2 / $6 por millón de tokens frente a $4 / $20, y en eficiencia de tokens por tarea completada.
¿Cuál es la ventana de contexto de Grok 4.5?
Grok 4.5 tiene una ventana de contexto de 500 000 tokens, frente al millón de tokens de Grok 4.3. Es el único compromiso claro en una actualización que mejora en todas las demás dimensiones.
¿Puedo usar Grok 4.5 en Fello AI?
Sí. Grok 4.5 está disponible en Fello AI, así que puedes usarlo junto a Claude, ChatGPT, Gemini, DeepSeek y Perplexity en una sola aplicación nativa para Mac, iPhone y iPad, y comparar la misma tarea en todos los modelos de frontera con una sola suscripción.