Em 8 de julho de 2026, a xAI lançou o Grok 4.5, o seu primeiro modelo criado especificamente para programação e trabalho agêntico. Não se trata de uma melhoria geral de capacidades. É um pivô deliberado para os programadores, com treino realizado com dados reais de sessões de programadores no Cursor e benchmarks concebidos para medir o que uma IA consegue realmente fazer dentro de uma base de código real ao longo de uma sessão longa. Foi substituído em 12 de agosto de 2026 pelo Grok 4.6, uma atualização pós-treino sobre a mesma base. O Grok 4.6, por sua vez, deu lugar ao Grok 4.7 a 21 de setembro de 2026, e a Artificial Analysis lista agora o Grok 4.5 como descontinuado.
O resultado é um modelo que obtém 38,8 pontos no Artificial Analysis Intelligence Index v4.3.2, a uma fração do custo de operação da fronteira da Anthropic. A Artificial Analysis gasta $1.04 para avaliar o Grok 4.5 no índice, contra $5.98 para o Claude Opus 5.5 atual da Anthropic em raciocínio máximo. A OpenAI, porém, fechou essa diferença: o GPT-6 Sol passa pelo mesmo índice por $1.06 em raciocínio máximo e obtém 47,5 pontos. O nosso guia dos benchmarks de IA explica o que estes números medem de facto.
Elon Musk posicionou-o diretamente: «É um modelo da classe Opus, mas mais rápido, mais eficiente em tokens e mais barato.» Numa publicação seguinte, foi mais preciso: «O Grok 4.5 é aproximadamente comparável ao Opus 4.7, mas muito mais rápido.»
Musk também assinalou que as velocidades atuais não são o limite. A xAI ainda não implementou a sua stack de inferência em C/C++ desenvolvida internamente, que mapeia diretamente para o hardware GB300, e quando o fizer, espera que as velocidades dupliquem ou mais. Sinalizou um novo lançamento com uma mudança significativa para o mês seguinte, e chegou duas vezes: o Grok 4.6 a 12 de agosto de 2026 e depois o Grok 4.7 a 21 de setembro de 2026. O grok-4.5-latest já não encabeça a lista de modelos da xAI.
Os Principais Pontos a Reter
- O Grok 4.5 foi lançado em 8 de julho de 2026 e obtém 38,8 pontos no Artificial Analysis Intelligence Index v4.3.2. Ficou em 4.º lugar de 168 entradas no lançamento e agora ocupa a 56.ª posição de 664.
- Construído sobre a base V9 de 1,5 biliões de parâmetros e treinado com dados reais de sessões do Cursor para tarefas de programação e agênticas.
- Com um preço de $2 / $6 por milhão de tokens, com a entrada em cache a $0.30, contra $4 / $20 do Claude Opus 5.5, o modelo que a Anthropic vende agora como o seu cavalo de batalha. A Artificial Analysis gasta $1.04 por tarefa do Intelligence Index com este modelo, contra $5.98 com o Opus 5.5.
- Altamente eficiente em tokens, utilizando cerca de 14.000 tokens de saída por tarefa do Intelligence Index, contra 67.020 do Opus 4.8 na comparação da xAI no dia do lançamento.
- Musk chama-lhe «classe Opus, mas mais rápido», com uma stack de inferência personalizada que se espera que duplique os atuais ~80 tokens/seg.
O Que É Realmente o Grok 4.5
O Grok 4.5 é o primeiro modelo da xAI treinado de raiz para tarefas de programação e agênticas, em vez de inteligência geral. Construído sobre o modelo de base V9 de 1,5 biliões de parâmetros, foi treinado em parceria com a Cursor para lidar com tarefas de longa duração em múltiplos repositórios e para funcionar com intervenção humana mínima ao longo de centenas de chamadas a ferramentas. Essa parceria produziu mais tarde o produto de agente da SpaceXAI, que aplica a mesma abordagem numa aplicação de computador.
As especificações principais são diretas.
| Especificação | Detalhe |
|---|---|
| Nome do modelo na API | grok-4.5 |
| Arquitetura | Modelo de base V9, 1,5 biliões de parâmetros (3x maior do que o V8 do Grok 4.3) |
| Janela de contexto | 500k tokens |
| Velocidade | aproximadamente 80 tokens por segundo no lançamento; a Artificial Analysis mede agora uma mediana de 58 t/s |
| Modalidades de entrada | texto e imagens (visão) |
| Raciocínio | configurável com esforço baixo, médio, alto ou xhigh (predefinição: alto) |
| APIs suportadas | Responses API e Chat Completions |
| Capacidades incorporadas | chamada de funções, pesquisa na web, pesquisa no X, execução de código |
O nome V9 marca uma mudança completa de geração em relação à série V8 que impulsionava o Grok 4.3, triplicando a escala e deslocando totalmente o foco do treino para tarefas de programação e agênticas. A janela de contexto desceu do 1 milhão de tokens do Grok 4.3 para 500k, o que é um verdadeiro compromisso para quem precisava do milhão completo.
A Ligação ao Cursor
A ideia de «treinado com o Cursor» no anúncio não é apenas uma parceria de marketing. Em meados de junho de 2026, a SpaceX adquiriu o Cursor por aproximadamente $60 mil milhões, trazendo um dos editores de código com IA mais utilizados diretamente para o ecossistema da xAI. Foi essa aquisição que permitiu que o treino do Grok 4.5 incorporasse dados reais de sessões de programadores no Cursor, dando à xAI acesso direto aos fluxos de trabalho reais, aos padrões de contexto e às estruturas de tarefas de longo prazo que os programadores utilizam em produção.
Ao contrário do treino com repositórios de código públicos, os dados de sessões reais captam a forma como os programadores iteram sobre um problema, alternam o contexto entre ficheiros e tomam decisões em várias etapas dentro de projetos reais. O Grok 4.5 é o primeiro modelo a refletir isso.
A xAI também introduziu uma nova metodologia de treino juntamente com este modelo, a aprendizagem assíncrona, que permite que execuções de treino agêntico de várias horas decorram em paralelo com o treino contínuo do modelo, em vez de sequencialmente. O efeito prático é que os ciclos de feedback entre o comportamento do modelo e as suas atualizações de treino se tornam muito mais rápidos, o que é o que permite ao modelo lidar com o tipo de sessões autónomas de longa duração em que a maioria dos agentes atualmente encalha.
Resultados de Benchmarks
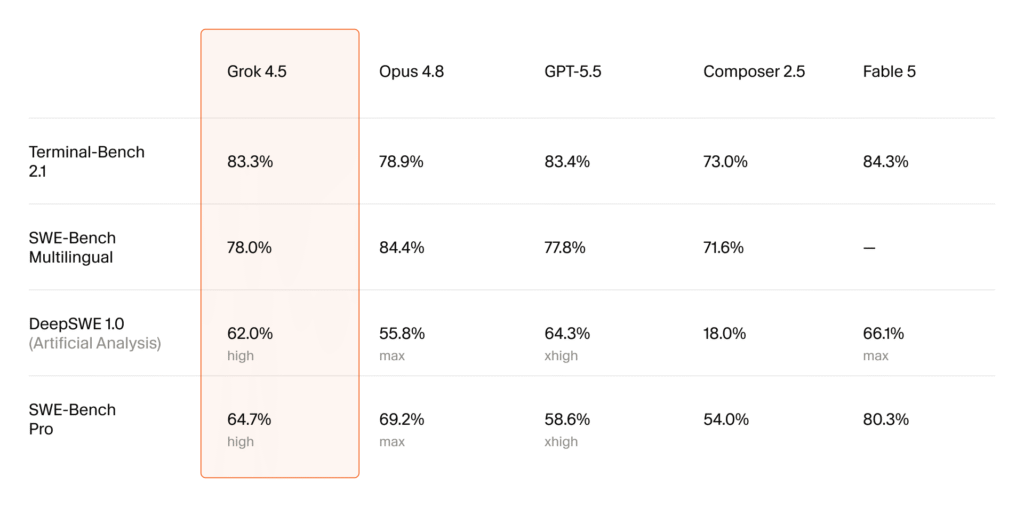
Benchmarks Publicados pela xAI no Lançamento
| Benchmark | Fable 5 | GPT-5.5 | Grok 4.5 | Opus 4.8 | GLM-5.2 |
|---|---|---|---|---|---|
| DeepSWE 1.0 | 66,1% | 64,3% | 62,0% | 55,8% | n/d |
| DeepSWE 1.1 | 70,0% | 67,0% | 53,0% | 59,0% | 44,0% |
| Terminal-Bench 2.1 | 84,3% | 83,4% | 83,3% | 78,9% | n/d |
| SWE-Bench Pro | 80,4% | n/d | 64,7% | 69,2% | 62,1% |
Estes são os valores que a xAI publicou em 8 de julho de 2026, medidos em relação aos modelos que eram atuais nesse dia. Lendo-os diretamente: o Grok 4.5 supera o Opus 4.8 em dois dos quatro benchmarks (DeepSWE 1.0 e Terminal-Bench 2.1) e fica atrás em dois outros (DeepSWE 1.1 e SWE-Bench Pro). O Claude Fable 5 lidera nos quatro, e no Terminal-Bench 2.1 a margem entre o Grok 4.5 (83,3%) e o GPT-5.5 (83,4%) é de apenas uma décima de ponto. O Opus 4.8 e o GPT-5.5 foram entretanto substituídos duas vezes cada um: primeiro pelo Claude Opus 5 e pelo GPT-5.6 Sol, depois pelo Claude Opus 5.5 e pelo GPT-6 Astra. A xAI não publicou números diretos contra nenhum dos quatro, pelo que a secção de classificações atuais abaixo é a que deve ser consultada para decisões de compra.
Benchmarks Independentes da Artificial Analysis
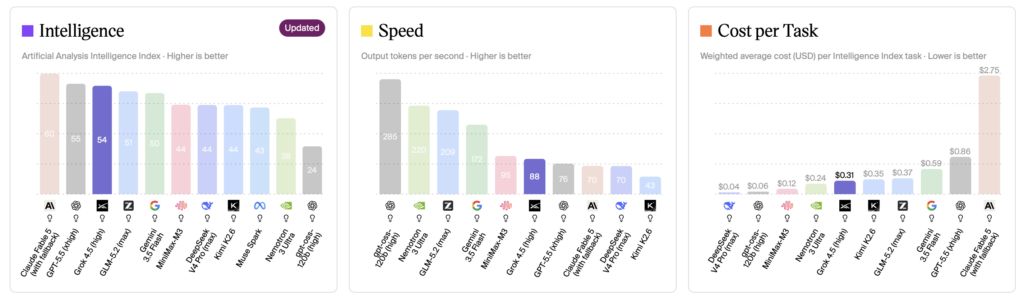
No Artificial Analysis Intelligence Index, agora na versão v4.3.2, o Grok 4.5 com raciocínio alto obtém 38,8 pontos. O Grok 4.3 obtém 24,9 pontos no mesmo ranking, pelo que continua a ser o maior salto de geração para geração que a xAI já registou neste índice. Todos os valores da Artificial Analysis apresentados abaixo indicam a versão do índice de onde vêm, porque as versões não são comparáveis entre si. O mesmo modelo marcava 56 na v4.1.1: a Artificial Analysis reescalou todo o ranking entre as duas versões, e o número desceu sem que o modelo mudasse. Uma afirmação do lançamento não sobreviveu a essa mudança. O Grok 4.5 já não supera todos os modelos Gemini, porque o Gemini 3.8 Flash obtém 40,9 pontos com esforço alto. O Gemini 3.6 Flash, o Gemini mais forte do ranking quando o Grok 4.5 saiu, situa-se agora nos 34,0.
A sua posição, no entanto, mudou, e vale a pena dizê-lo com clareza. O Grok 4.5 ficou em quarto lugar de 168 entradas no lançamento, a 8 de julho. No ranking v4.3.2, a 25 de setembro de 2026, está em 56.º lugar de 664 entradas, com 27 modelos distintos acima dele, entre eles o Claude Opus 5.5, o Claude Fable 5.1, o GPT-6 Astra, o Claude Opus 5, o Muse Spark 1.3, o GPT-6 Sol, o Grok 4.7, o Qwen3.8 Max, o GLM-5.3, o Grok 4.6 e o Kimi K3. O Claude Opus 4.8, contra o qual o Grok 4.5 foi comparado no lançamento, continua no ranking e fica à frente com 41,8. A reescala mexeu na pontuação, o panorama mexeu na posição.
Outra das afirmações do lançamento inverteu-se por completo. O Grok 4.5 já não supera todos os modelos de pesos abertos, porque o Kimi K3 lançou os seus pesos abertos a 27 de julho de 2026 e obtém 43,6 pontos na v4.3.2. O GLM-5.3, com 44,8, e o MiMo-V2.6-Pro, com 46,3, também de pesos abertos, ficam igualmente à frente.
No GDPval-AA, o benchmark que mede o trabalho de conhecimento agêntico sustentado, agora na v2.1, o Grok 4.5 obtém um Elo de 1.370, à frente do GLM-5.2 com 1.358 e atrás do Claude Opus 4.8 com 1.438. Ficou em quarto lugar no lançamento. O Claude Opus 5 já registou 1.708 pontos, e o Claude Opus 5.5 lidera o ranking com 1.846. Na sub-tarefa de raciocínio financeiro mais difícil, tau3-Banking, o Grok 4.5 atinge 42,1%, ainda confortavelmente à frente do GPT-5.5 (xhigh) com 39,0%. Já não é, porém, a pontuação mais alta. Esse ranking é liderado pelo Qwen3.8 Max com 51,3%.
No Artificial Analysis Coding Agent Index (que combina DeepSWE, Terminal-Bench v2 e SWE-Atlas QnA), o Grok 4.5 no harness Grok Build obtém 76 pontos, o que em julho de 2026 lhe valeu o terceiro lugar. Estava ao nível do GPT-5.5 (xhigh) no Codex e ficava logo abaixo do Fable 5 (max) no Claude Code. A Artificial Analysis retirou entretanto esse índice, e nem o DeepSWE nem o SWE-Atlas QnA constam da sua lista atual de avaliações, pelo que este número já não pode ser atualizado face aos modelos de hoje.
A xAI reporta ainda o Harvey Legal Agent Benchmark, onde o Grok 4.5 fica em primeiro lugar. Combinado com a pontuação máxima no tau3-Banking, isto aponta para o trabalho de conhecimento jurídico e financeiro como pontos fortes específicos, para além do que os benchmarks de programação por si só captam.
Eficiência de Tokens
O preço por token é o destaque, mas a eficiência de tokens é o número mais relevante. No SWE-Bench Pro, o Grok 4.5 utilizou aproximadamente 15.954 tokens de saída por tarefa, contra os 67.020 do Opus 4.8, uma diferença de 4,2x. No Artificial Analysis Intelligence Index utiliza cerca de 14.000 tokens de saída por tarefa, mais de 60% menos do que o Opus 4.8. No Coding Agent Index tem uma média de 1,9 milhões de tokens totais por tarefa, contra 7,2 milhões do Fable 5 no Claude Code e 6,2 milhões do GPT-5.5 no Codex.
Um modelo que utiliza 4x menos tokens não é apenas mais barato por tarefa. É mais rápido e produz menos ruído em pipelines agênticos, o que é importante para trabalho autónomo em várias etapas.
Preços e Custo por Tarefa
O Grok 4.5 tem um preço de $2.00 por milhão de tokens de entrada e $6.00 por milhão de tokens de saída. Os acertos de cache têm um desconto de 85%, o que reduz os tokens de entrada em cache para $0.30 por milhão. Um aviso importante: o preço duplica para entradas com mais de 200k tokens. Para uma análise completa dos preços de subscrição e de API do Grok, incluindo os planos de consumidor, esse guia cobre todas as opções.
Face à fronteira atual, isto é metade do que o Claude Opus 5.5 cobra à entrada e menos de um terço do que cobra à saída, a $4 / $20. O Opus 5, com o qual o Grok 4.5 foi comparado durante quase toda a sua vida, custava $5 / $25 e está hoje na lista de modelos legados da Anthropic. Mas o custo por tarefa é o número mais relevante, uma vez que tem em conta quantos tokens cada modelo realmente gasta. A tabela abaixo apresenta os valores da xAI e da Artificial Analysis conforme publicados no lançamento, em julho de 2026.
| Modelo | Entrada (por 1M) | Saída (por 1M) | Custo por tarefa no Intelligence Index | Custo por tarefa no Coding Agent |
|---|---|---|---|---|
| Grok 4.5 | $2.00 | $6.00 | $0.31 | $2.49 |
| GPT-5.5 (Codex) | $5.00 | $30.00 | mais alto | $5.07 |
| Fable 5 (Claude Code) | $10.00 | $50.00 | mais alto | $11.80 |
| Opus 4.8 | $5.00 | $25.00 | mais alto | n/d |
Os valores por tarefa é que realmente importam à escala de produção. O Grok 4.5 alcançou um desempenho de agente de programação quase equivalente a cerca de metade do custo do GPT-5.5 e a menos de um quarto do custo do Fable 5 por tarefa concluída. Face à Anthropic, essa vantagem manteve-se à medida que o panorama evoluiu; face à OpenAI, não. No Intelligence Index v4.3.2, a Artificial Analysis situa o custo de executar o Grok 4.5 em $1.04, contra $5.98 para o Claude Opus 5.5 com raciocínio máximo, enquanto o GPT-6 Sol com raciocínio alto o executa por $0.37 e com pontuação mais alta.
Onde o Grok 4.5 Está Disponível
O Grok 4.5 ficou disponível numa ampla gama de plataformas logo no dia do lançamento. Está disponível na API da xAI sob o nome de modelo grok-4.5, no Grok Build (o harness de agente de programação da própria xAI) e no Cursor em todos os planos. O acesso de terceiros abrange OpenRouter, Vercel, Cloudflare, Snowflake e Databricks Mosaic. Também está disponível no Fello AI, no Mac, no iPhone e no iPad.
O lançamento do plugin para Office é digno de nota. A xAI está a posicionar o Grok 4.5 não apenas como um modelo de programação, mas como um modelo de trabalho de conhecimento capaz de construir modelos complexos do Excel com investigação na web integrada e gerar conteúdo sofisticado do PowerPoint. Isso alarga bastante o âmbito de utilização, para além do desenvolvimento de software.
O atraso na UE já foi resolvido. O Grok 4.5 foi lançado em 47 países, mas ficou bloqueado em todos os 27 estados-membros da UE, um atraso atribuído ao trabalho de conformidade ao abrigo da Lei de IA da UE, que trata os modelos treinados acima de 1025 FLOPs como portadores de risco sistémico. A xAI abriu o acesso na UE mais tarde em julho de 2026, e a sua documentação para programadores já não apresenta a restrição regional que mostrava no lançamento.
O modelo suporta tanto o formato Responses API como o Chat Completions, o que significa que se integra em bases de código já construídas sobre APIs compatíveis com a OpenAI sem qualquer modificação.
O Que Disse Elon Musk
Musk fez várias declarações em torno do dia do lançamento que indicam onde este modelo se encaixa e para onde está a caminhar.
Sobre o posicionamento de capacidades: «É um modelo da classe Opus, mas mais rápido, mais eficiente em tokens e mais barato», com um esclarecimento posterior de que é «aproximadamente comparável ao Opus 4.7, mas muito mais rápido». Esse último detalhe é importante. Musk está a comparar com o Opus 4.7, não com o 4.8, o que os dados independentes apoiam em grande medida.
Sobre o limite de velocidade: «O Grok 4.5 ainda não está a utilizar o nosso software de inferência em C/C++ desenvolvido internamente, que mapeia exatamente para o hardware GB300. É provavelmente possível duplicar ou mais a velocidade atual.» O débito atual, de cerca de 80 tokens por segundo, não é o número final. A stack de inferência personalizada está em desenvolvimento e irá acrescentar mais velocidade sem alterar os pesos do modelo.
Sobre o que vem a seguir: «O lançamento do próximo mês será outra melhoria com uma mudança significativa, à medida que fechamos o ciclo de resolução de problemas reais de engenharia na Tesla, na SpaceX, na Neuralink e na Boring Company.» Esse ciclo de feedback vindo de trabalho real de engenharia nas empresas irmãs da xAI é uma fonte de dados de treino que nenhum outro laboratório tem à mesma escala.
Sobre futuras capacidades multimodais: o Grok vai ganhar a capacidade de chamar o Grok Imagine como ferramenta em modo agêntico, invocando a geração de imagem e vídeo como parte de um fluxo de trabalho autónomo mais longo, em vez de como uma funcionalidade separada. Musk assinalou isto como especialmente valioso para programadores de jogos.
Reações Iniciais dos Utilizadores
O feedback dos programadores com acesso antecipado no Cursor foi positivo. Danny Limanseta descreveu-o como «o Opus 4.8 ao dobro da velocidade e a um preço muito mais barato», depois de o utilizar para fazer brainstorming, planear e implementar uma funcionalidade complexa de um jogo ao longo de uma sessão completa, sem precisar de o corrigir manualmente em cada etapa.
A Artificial Analysis resumiu a mudança competitiva sem rodeios no dia do lançamento, escrevendo que o Grok 4.5 «coloca a SpaceXAI na fronteira da inteligência, atrás apenas da OpenAI e da Anthropic, e supera todos os modelos de pesos abertos e, em particular, os modelos Gemini da Google». As duas partes dessa frase já foram ultrapassadas, como referido acima.
Como o Grok 4.5 Se Compara à Concorrência
Face à fronteira atual, o Grok 4.5 raramente ocupa o primeiro lugar absoluto em capacidade bruta. Face à Anthropic continua a vencer em custo e eficiência de tokens; face ao GPT-6 Sol da OpenAI, já não. Eis como se compara modelo a modelo, utilizando o ranking v4.3.2 da Artificial Analysis para tudo o que é atual e os valores de lançamento da xAI onde estes são os únicos números publicados.
Comparação com o Grok 4.3
38,8 pontos contra os 24,9 do Grok 4.3 na v4.3.2 é o maior salto geracional na linhagem Grok. A janela de contexto foi reduzida a metade, de 1M para 500k tokens, e as modalidades de entrada ficaram limitadas a texto e imagens, que são os dois verdadeiros compromissos. Se tem estado a utilizar o Grok 4.3 para programação, o Grok 4.5 é uma melhoria significativa em todas as outras dimensões.
Comparação com o Claude Opus 5.5
O Claude Opus 5.5 sucedeu ao Claude Opus 5 a 22 de setembro de 2026 e lidera agora o Intelligence Index v4.3.2, com 57,6 pontos, à frente do Claude Fable 5.1, com 53,4, e do GPT-6 Astra da OpenAI, com 52,7. São quase dezanove pontos à frente do Grok 4.5, onde o Opus 5 tinha doze. Também tem uma janela de contexto de 1M tokens, contra os 500k do Grok 4.5. A comparação de custos continua a ir no sentido inverso, ainda que por menos do que antes. O Opus 5.5 tem um preço de $4 / $20 por milhão de tokens, contra $2 / $6, ao passo que o Opus 5 que substituiu custava $5 / $25, e a Artificial Analysis gasta $5.98 para avaliar o Opus 5.5 no índice, contra $1.04 para o Grok 4.5. Para o trabalho de programação aberto mais difícil, o Opus 5.5 tem vantagem; para pipelines agênticos em que o custo por tarefa se acumula ao longo de centenas de chamadas a ferramentas, o Grok 4.5 tem a melhor economia.
Comparação com o Claude Fable 5.1
No lançamento, o Fable 5 liderava nos quatro benchmarks da xAI, e a diferença de custo era a maior de todas as comparações: $2.49 contra $11.80 por tarefa no Coding Agent, quase 5x. Entretanto foi substituído pelo Claude Fable 5.1, e a Artificial Analysis lista agora o Fable 5 como descontinuado. Na v4.3.2, o Fable 5.1 obtém 53,4 pontos com esforço máximo, contra os 38,8 do Grok 4.5, e a Artificial Analysis gasta $7.63 para o avaliar no índice, contra $1.04, mais de 7x. Para cargas de trabalho em que o desempenho de programação absolutamente máximo é obrigatório, o Fable 5.1 está à frente. Para um custo por tarefa muito mais baixo, o Grok 4.5 vence.
Comparação com o GPT-6 Sol
O GPT-6 Astra é o modelo de topo da OpenAI, mas o GPT-6 Sol é a comparação mais próxima no ranking, e é ele que derruba o argumento de custo do Grok 4.5. Na v4.3.2, o GPT-6 Sol obtém 47,5 pontos com raciocínio máximo e 42,8 com raciocínio alto, contra os 38,8 do Grok 4.5 com raciocínio alto. A Artificial Analysis gasta $1.06 com o Sol no máximo, praticamente o mesmo que os $1.04 do Grok 4.5, e $0.37 no nível alto. Com o mesmo raciocínio alto, o Sol é quatro pontos mais forte por cerca de um terço do custo. O preço de tabela é mais alto na saída, $2 / $10 por milhão de tokens contra $2 / $6, mas gasta muito menos tokens por tarefa. O GPT-5.6 Sol, com que esta secção comparava até à chegada do GPT-6 Sol, continua disponível na API da OpenAI, e a Artificial Analysis lista-o agora como descontinuado.
Comparação com o Par do Dia do Lançamento, Opus 4.8 e GPT-5.5
Ambos os modelos com que o Grok 4.5 foi comparado em julho passaram entretanto a estatuto de legado, mas os números continuam a valer a pena reter porque são os únicos dados diretos que a xAI publicou. Contra o Opus 4.8, o Grok 4.5 venceu no DeepSWE 1.0 e no Terminal-Bench 2.1 e perdeu no DeepSWE 1.1 e no SWE-Bench Pro. Contra o GPT-5.5, a margem no Terminal-Bench 2.1 foi de uma décima de ponto (83,3% vs 83,4%), o Coding Agent Index terminou empatado, e o Grok 4.5 liderou o tau3-Banking por 2 pontos a cerca de metade do custo por tarefa ($2.49 vs $5.07).
Comparação com o GLM-5.2
O Grok 4.5 fica ligeiramente à frente do GLM-5.2 no GDPval-AA v2.1 (Elo 1.370 vs 1.358). O Grok 4.5 lidera também no Intelligence Index geral, 38,8 contra 33,7 na v4.3.2, e no tau3-Banking, 42,1% contra 34,6%.
Porque É Que Este Lançamento É Importante
Três aspetos destacam-se no lançamento do Grok 4.5 e valem a pena acompanhar para além dos números dos benchmarks.
A xAI chegou à fronteira da inteligência. O Grok 4.3 não competia com a Anthropic e a OpenAI no topo das classificações de capacidade, com 24,9 pontos no Intelligence Index v4.3.2. O Grok 4.5 competia, com 38,8 pontos no mesmo ranking, e a xAI manteve-se aí desde então: o Grok 4.6 obtém 44,3 e o Grok 4.7 46,3. Isso mudou a estrutura competitiva do mercado, de uma corrida entre dois para uma disputa a três.
A eficiência de custos é real, não é apenas um desconto de preço. O Grok 4.5 é mais barato por token, mas também é dramaticamente mais eficiente em tokens por tarefa. Um modelo que produz o mesmo resultado em 14.000 tokens quando um concorrente usa 67.000 não é apenas mais barato de executar, é mais rápido e gera menos ruído em fluxos de trabalho agênticos. Ambos os fatores importam à escala de produção.
O limite de velocidade não foi atingido no lançamento. A xAI indicou cerca de 80 tokens por segundo no dia do lançamento, e a Artificial Analysis mede agora uma mediana de 58 tokens de saída por segundo. Musk esperava que a stack de inferência personalizada em C/C++, mapeada para o hardware GB300, duplicasse o valor de lançamento, o que teria tornado significativamente mais rápido um modelo já competitivo em custo e qualidade, sem qualquer atualização do modelo.
O Grok 4.5 está disponível no Fello AI, onde pode utilizá-lo ao lado do Claude, do ChatGPT, do Gemini, do DeepSeek e do Perplexity numa única aplicação nativa para Mac, iPhone e iPad, comparando a mesma tarefa em todos os modelos de fronteira com uma única subscrição, em vez de gerir contas separadas. Para contexto sobre o que vem depois do Grok 4.5, o artigo Grok 5 cobre o que a xAI já sinalizou sobre a próxima versão principal.
FAQ
Quando foi lançado o Grok 4.5?
A xAI lançou o Grok 4.5 em 8 de julho de 2026. É o primeiro modelo da xAI criado especificamente para programação e trabalho agêntico, treinado com dados reais de sessões de programadores no Cursor.
Quanto custa o Grok 4.5?
O preço na API é de $2.00 por milhão de tokens de entrada e $6.00 por milhão de tokens de saída. Os acertos de cache têm um desconto de 85%, o que reduz a entrada em cache para $0.30 por milhão. O preço duplica para entradas com mais de 200k tokens.
O Grok 4.5 é melhor do que o Claude Opus 5.5?
Não em capacidade bruta. O Claude Opus 5.5, o modelo atual da Anthropic, obtém 57,6 pontos no Artificial Analysis Intelligence Index v4.3.2, contra os 38,8 do Grok 4.5, e tem uma janela de contexto de 1M tokens, contra 500k. O Grok 4.5 vence claramente em custo, com $2 / $6 por milhão de tokens, contra $4 / $20, e em eficiência de tokens por tarefa concluída.
Qual é a janela de contexto do Grok 4.5?
O Grok 4.5 tem uma janela de contexto de 500k tokens, uma redução face ao 1 milhão de tokens do Grok 4.3. É o único compromisso claro numa atualização que, de resto, é generalizada.
Posso utilizar o Grok 4.5 no Fello AI?
Sim. O Grok 4.5 está disponível no Fello AI, pelo que pode utilizá-lo ao lado do Claude, do ChatGPT, do Gemini, do DeepSeek e do Perplexity numa única aplicação nativa para Mac, iPhone e iPad, e comparar a mesma tarefa em todos os modelos de fronteira com uma única subscrição.