Am 8. Juli 2026 veröffentlichte xAI Grok 4.5, sein erstes Modell, das speziell für Coding und agentische Arbeit entwickelt wurde. Das ist kein allgemeines Fähigkeits-Upgrade. Es ist eine bewusste Hinwendung zu Entwicklern, mit Training anhand echter Cursor-Entwicklersitzungsdaten und Benchmarks, die messen, was eine KI tatsächlich in einer echten Codebasis über eine lange Sitzung hinweg leisten kann. Es wurde am 12. August 2026 von Grok 4.6, einem Post-Training-Upgrade auf derselben Grundlage, abgelöst. Grok 4.6 wiederum wich am 21. September 2026 Grok 4.7, und Artificial Analysis führt Grok 4.5 inzwischen als veraltet.
Das Ergebnis ist ein Modell, das 38,8 auf dem Artificial Analysis Intelligence Index v4.3.2 erreicht, zu einem Bruchteil der Kosten von Anthropics Frontier. Artificial Analysis gibt $1.04 aus, um Grok 4.5 durch den Index zu führen, gegenüber $5.98 für Anthropics aktuelles Claude Opus 5.5 bei maximalem Reasoning. OpenAI hat diesen Abstand allerdings geschlossen: GPT-6.1 Sol durchläuft denselben Index bei maximalem Reasoning für $0.72 und erreicht 51,8. Unser Leitfaden zu KI-Benchmarks erklärt, was diese Werte tatsächlich messen.
Elon Musk positionierte es direkt: „Es ist ein Opus-Klasse-Modell, aber schneller, tokeneffizienter und kostengünstiger." In einer Folgeanmerkung war er präziser: „Grok 4.5 ist ungefähr vergleichbar mit Opus 4.7, aber viel schneller."
Musk hat auch signalisiert, dass die aktuellen Geschwindigkeiten nicht die Obergrenze sind. xAI hat seinen intern entwickelten C/C++-Inferenz-Stack, der direkt auf die GB300-Hardware abbildet, noch nicht eingesetzt, und wenn das passiert, erwartet er, dass sich die Geschwindigkeiten verdoppeln oder mehr. Er deutete eine weitere Verbesserung für den folgenden Monat an, und sie kam gleich zweimal: Grok 4.6 am 12. August 2026, dann Grok 4.7 am 21. September 2026. grok-4.5-latest steht nicht mehr an der Spitze von xAIs Modellliste.
Das Wichtigste in Kürze
- Grok 4.5 erschien am 8. Juli 2026 und erreicht 38,8 auf dem Artificial Analysis Intelligence Index v4.3.2. Es rangierte beim Start auf Platz 4 von 168 Einträgen und steht jetzt auf Platz 56 von 664.
- Aufgebaut auf dem 1,5-Billionen-Parameter-V9-Fundamentmodell und trainiert auf echten Cursor-Sitzungsdaten für Coding und agentische Aufgaben.
- Preis bei $2 / $6 pro Million Token mit gecachter Eingabe bei $0.30, gegenüber $4 / $20 für Claude Opus 5.5, das Anthropic jetzt als sein Arbeitspferd verkauft. Artificial Analysis gibt pro Intelligence-Index-Aufgabe $1.04 dafür aus, gegenüber $5.98 für Opus 5.5.
- Hochgradig tokeneffizient, verwendet etwa 14.000 Ausgabe-Token pro Intelligence-Index-Aufgabe gegenüber 67.020 für Opus 4.8 in xAIs Launch-Vergleich.
- Musk nennt es „Opus-Klasse, aber schneller," mit einem benutzerdefinierten Inferenz-Stack, der die aktuellen ~80 Token/Sek. verdoppeln soll.
Was Grok 4.5 tatsächlich ist
Grok 4.5 ist xAIs erstes Modell, das von Grund auf für Coding und agentische Aufgaben statt für allgemeine Intelligenz trainiert wurde. Aufgebaut auf dem 1,5-Billionen-Parameter-V9-Fundamentmodell, wurde es in Partnerschaft mit Cursor trainiert, um langwierige Jobs über mehrere Repositories hinweg zu bewältigen und mit minimaler menschlicher Intervention über Hunderte von Tool-Aufrufen zu arbeiten. Diese Partnerschaft brachte später SpaceXAIs Agenten-Produkt hervor, das denselben Ansatz in eine Desktop-App bringt.
Die Hauptspezifikationen sind unkompliziert.
| Spezifikation | Detail |
|---|---|
| API-Modellname | grok-4.5 |
| Architektur | V9-Fundamentmodell, 1,5 Billionen Parameter (3x größer als Grok 4.3s V8) |
| Kontextfenster | 500k Token |
| Geschwindigkeit | ungefähr 80 Token pro Sekunde beim Start; Artificial Analysis misst inzwischen einen Median von 58 T/s |
| Eingabemodalitäten | Text und Bilder (Vision) |
| Reasoning | konfigurierbar bei niedrigem, mittlerem, hohem oder xhigh Aufwand (Standard hoch) |
| Unterstützte APIs | Responses API und Chat Completions |
| Integrierte Fähigkeiten | Funktionsaufrufe, Web-Suche, X-Suche, Code-Ausführung |
Der V9-Name markiert einen vollständigen Generationswechsel gegenüber der V8-Serie, die Grok 4.3 betrieb, und verdreifacht den Maßstab, während der Trainingsfokus vollständig auf Coding und agentische Aufgaben verlagert wird. Das Kontextfenster verkleinerte sich von Grok 4.3s 1 Million Token auf 500k, was ein echter Kompromiss für alle ist, die das volle Millon benötigten.
Die Cursor-Verbindung
Die Formulierung „trained with Cursor" in der Ankündigung ist nicht nur eine Marketing-Partnerschaft. Mitte Juni 2026 erwarb SpaceX Cursor für ungefähr 60 Milliarden $, was einen der am weitesten verbreiteten KI-Coding-Editoren direkt in das xAI-Ökosystem brachte. Deshalb bezog Grok 4.5s Training echte Cursor-Entwicklersitzungsdaten ein und gab xAI direkten Zugang zu den tatsächlichen Workflows, Kontextmustern und langfristigen Aufgabenstrukturen, die Entwickler in der Produktion nutzen.
Anders als das Training an öffentlichen Code-Repositories erfassen echte Sitzungsdaten, wie Entwickler ein Problem iterieren, zwischen Dateien hin- und herwechseln und mehrstufige Entscheidungen in echten Projekten treffen. Grok 4.5 ist das erste Modell, das das widerspiegelt.
xAI führte neben diesem Modell auch eine neue Trainingsmethodik ein: asynchrones Lernen, das mehrstündige agentische Trainingsläufe parallel zum laufenden Modelltraining statt sequenziell ermöglicht. Der praktische Effekt ist, dass Feedback-Schleifen zwischen dem Verhalten des Modells und seinen Trainings-Updates viel enger sind, was es dem Modell ermöglicht, die Art von langwierigen autonomen Sitzungen zu bewältigen, bei denen die meisten Agenten derzeit ins Stocken geraten.
Benchmark-Ergebnisse
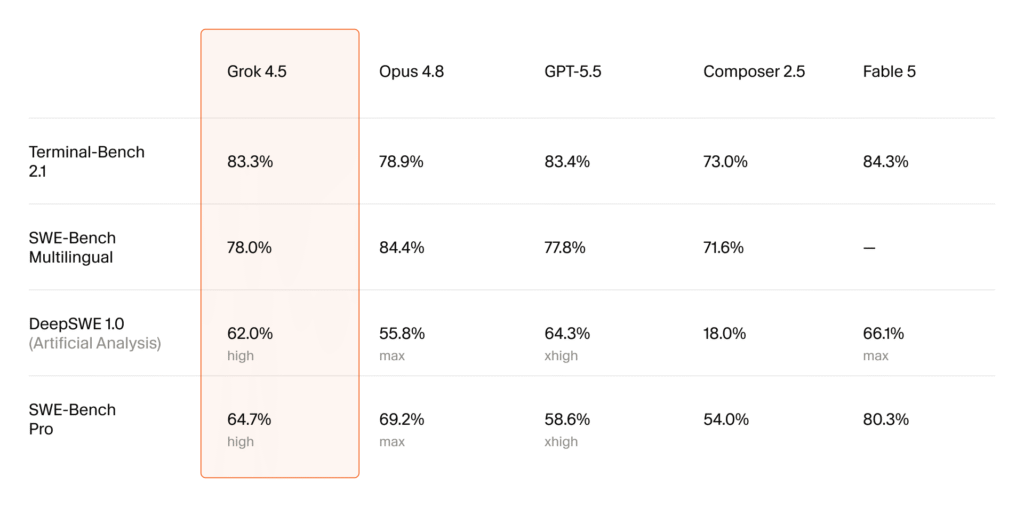
xAIs veröffentlichte Benchmarks beim Launch
| Benchmark | Fable 5 | GPT-5.5 | Grok 4.5 | Opus 4.8 | GLM-5.2 |
|---|---|---|---|---|---|
| DeepSWE 1.0 | 66,1 % | 64,3 % | 62,0 % | 55,8 % | n/a |
| DeepSWE 1.1 | 70,0 % | 67,0 % | 53,0 % | 59,0 % | 44,0 % |
| Terminal-Bench 2.1 | 84,3 % | 83,4 % | 83,3 % | 78,9 % | n/a |
| SWE-Bench Pro | 80,4 % | n/a | 64,7 % | 69,2 % | 62,1 % |
Das sind die Zahlen, die xAI am 8. Juli 2026 veröffentlichte, gemessen an den Modellen, die an jenem Tag aktuell waren. Direkt gelesen: Grok 4.5 schlägt Opus 4.8 bei zwei der vier Benchmarks (DeepSWE 1.0 und Terminal-Bench 2.1) und liegt bei zwei anderen dahinter (DeepSWE 1.1 und SWE-Bench Pro). Claude Fable 5 führt alle vier an, und bei Terminal-Bench 2.1 beträgt der Abstand zwischen Grok 4.5 (83,3 %) und GPT-5.5 (83,4 %) einen Zehntelpunkt. Opus 4.8 und GPT-5.5 wurden seitdem jeweils zweimal abgelöst: erst von Claude Opus 5 und GPT-5.6 Sol, dann von Claude Opus 5.5 und GPT-6 Astra. Gegen keines dieser vier Modelle hat xAI direkte Zahlen veröffentlicht, sodass der aktuelle Standings-Abschnitt unten der relevante für Kaufentscheidungen ist.
Unabhängige Benchmarks von Artificial Analysis
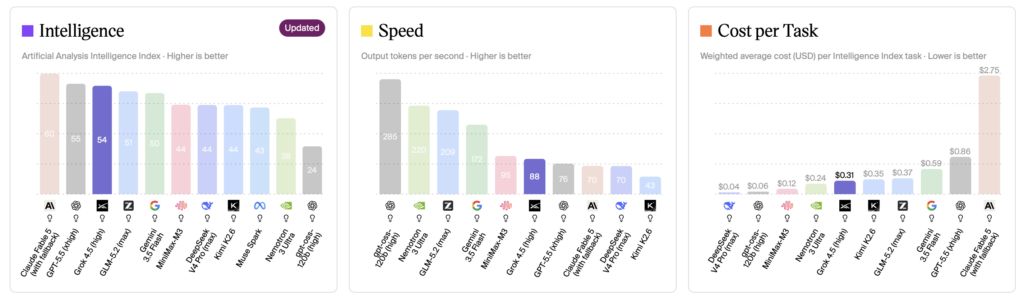
Auf dem Artificial Analysis Intelligence Index, jetzt in Version v4.3.2, erreicht Grok 4.5 beim hohen Reasoning 38,8. Grok 4.3 erreicht 24,9 auf demselben Board, womit dies weiterhin der größte generationsübergreifende Sprung von xAI auf diesem Index ist. Jede Artificial-Analysis-Zahl weiter unten trägt die Indexversion, aus der sie stammt, denn die Versionen sind nicht vergleichbar. Dasselbe Modell stand auf v4.1.1 bei 56: Artificial Analysis hat das gesamte Board zwischen den beiden Releases neu skaliert, und die Zahl fiel, ohne dass sich das Modell geändert hätte. Eine Launch-Behauptung hat diesen Wechsel allerdings nicht überstanden. Grok 4.5 schlägt nicht mehr jedes Gemini-Modell, denn Gemini 3.8 Flash erreicht bei hohem Aufwand 40,9. Gemini 3.6 Flash, das stärkste Gemini auf dem Board zum Erscheinen von Grok 4.5, liegt jetzt bei 34,0.
Seine Position hat sich jedoch verändert, und das ist klar zu sagen. Grok 4.5 rangierte bei 168 Einträgen am Launch am 8. Juli auf Platz vier. Auf dem v4.3.2-Board liegt es am 25. September 2026 auf Platz 56 von 664 Einträgen, mit 27 eigenständigen Modellen darüber, darunter Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, Claude Opus 5, Muse Spark 1.3, GPT-6 Sol, Grok 4.7, Qwen3.8 Max, GLM-5.3, Grok 4.6 und Kimi K3. Claude Opus 4.8, gegen das Grok 4.5 beim Launch benchmarkt wurde, ist weiterhin gelistet und liegt mit 41,8 davor. Die Neuskalierung hat die Punktzahl bewegt, das Feld den Platz.
Eine weitere Launch-Behauptung hat sich direkt umgekehrt. Grok 4.5 übertrifft nicht mehr jedes Open-Weight-Modell, weil Kimi K3 seine Open Weights am 27. Juli 2026 veröffentlichte und auf v4.3.2 43,6 erreicht. Auch die Open-Weight-Modelle GLM-5.3 mit 44,8 und MiMo-V2.6-Pro mit 46,3 liegen davor.
Auf GDPval-AA, dem Benchmark für nachhaltige agentische Wissensarbeit, jetzt in v2.1, erreicht Grok 4.5 ein Elo von 1.370, vor GLM-5.2 bei 1.358 und hinter Claude Opus 4.8 bei 1.438. Es rangierte beim Launch auf Platz vier. Claude Opus 5 hat seitdem 1.708 erreicht, und Claude Opus 5.5 führt das Board mit 1.846 an. Bei der schwierigsten Sub-Aufgabe finanziellen Reasonings, tau3-Banking, erreicht Grok 4.5 42,1 % und liegt damit weiterhin deutlich vor GPT-5.5 (xhigh) bei 39,0 %. Die höchste Punktzahl ist das allerdings nicht mehr. Dieses Board führt Qwen3.8 Max mit 51,3 %.
Auf dem Artificial Analysis Coding Agent Index (DeepSWE, Terminal-Bench v2 und SWE-Atlas QnA kombiniert) erreicht Grok 4.5 im Grok-Build-Harness 76, was im Juli 2026 für Platz drei reichte. Es war auf Augenhöhe mit GPT-5.5 (xhigh) in Codex und lag knapp unter Fable 5 (max) in Claude Code. Artificial Analysis hat diesen Index inzwischen eingestellt, und weder DeepSWE noch SWE-Atlas QnA stehen auf seiner aktuellen Evaluationsliste, sodass sich diese Zahl nicht gegen die heutigen Modelle auffrischen lässt.
xAI berichtet auch den Harvey Legal Agent Benchmark, bei dem Grok 4.5 auf Platz eins rangiert. Zusammen mit dem tau3-Banking-Topergebnis deutet das auf Rechts- und Finanz-Wissensarbeit als spezifische Stärken hin, die über das hinausgehen, was die Coding-Benchmarks allein erfassen.
Token-Effizienz
Der Token-Preis ist die Schlagzeile, aber die Token-Effizienz ist die aussagekräftigere Zahl. Auf SWE-Bench Pro verwendete Grok 4.5 ungefähr 15.954 Ausgabe-Token pro Aufgabe gegenüber Opus 4.8s 67.020, ein 4,2-facher Abstand. Auf dem Artificial Analysis Intelligence Index verwendet es ungefähr 14.000 Ausgabe-Token pro Aufgabe, über 60 % weniger als Opus 4.8. Auf dem Coding Agent Index durchschnittlich 1,9 Millionen Gesamttoken pro Aufgabe gegenüber 7,2 Millionen für Fable 5 in Claude Code und 6,2 Millionen für GPT-5.5 in Codex.
Ein Modell, das 4x weniger Token verwendet, ist nicht nur pro Aufgabe günstiger. Es ist schneller und erzeugt weniger Rauschen in agentischen Pipelines, was bei mehrstufiger autonomer Arbeit wichtig ist.
Preise und Kosten pro Aufgabe
Grok 4.5 wird zu $2.00 pro Million Eingabe-Token und $6.00 pro Million Ausgabe-Token berechnet. Cache-Treffer erhalten einen Rabatt von 85 %, was gecachte Eingabe-Token auf $0.30 pro Million senkt. Ein wichtiger Vorbehalt: Der Preis verdoppelt sich für Eingaben länger als 200k Token. Für eine vollständige Übersicht der Grok-Abonnement- und API-Preise, einschließlich der Verbraucherstufen, deckt dieser Leitfaden alle Optionen ab.
Gegenüber dem aktuellen Frontier ist das die Hälfte dessen, was Claude Opus 5.5 für Eingaben berechnet, und weniger als ein Drittel dessen, was es für Ausgaben berechnet, nämlich $4 / $20. Das Opus 5, an dem Grok 4.5 den Großteil seiner Laufzeit gemessen wurde, lag bei $5 / $25 und steht jetzt auf Anthropics Legacy-Liste. Aber die Kosten pro Aufgabe sind die aussagekräftigere Zahl, da sie berücksichtigt, wie viele Token jedes Modell tatsächlich ausgibt. Die untenstehende Tabelle enthält xAI- und Artificial-Analysis-Zahlen, wie sie beim Launch im Juli 2026 veröffentlicht wurden.
| Modell | Eingabe (pro 1M) | Ausgabe (pro 1M) | Kosten pro Intelligence-Index-Aufgabe | Kosten pro Coding-Agent-Aufgabe |
|---|---|---|---|---|
| Grok 4.5 | $2.00 | $6.00 | $0.31 | $2.49 |
| GPT-5.5 (Codex) | $5.00 | $30.00 | höher | $5.07 |
| Fable 5 (Claude Code) | $10.00 | $50.00 | höher | $11.80 |
| Opus 4.8 | $5.00 | $25.00 | höher | n/a |
Die Pro-Aufgabe-Zahlen sind das, was wirklich im Produktionsmaßstab zählt. Grok 4.5 erreichte nahezu gleichwertige Coding-Agent-Performance zu ungefähr der Hälfte der Kosten von GPT-5.5 und weniger als einem Viertel der Kosten von Fable 5 pro abgeschlossenem Job. Gegenüber Anthropic hat sich dieser Vorteil gehalten, während das Feld sich bewegt hat, gegenüber OpenAI nicht. Auf dem Intelligence Index v4.3.2 setzt Artificial Analysis die Kosten für das Ausführen von Grok 4.5 bei $1.04 an gegenüber $5.98 für Claude Opus 5.5 bei maximalem Reasoning, während GPT-6.1 Sol bei hohem Reasoning den Index für $0.32 durchläuft und dabei höher punktet.
Wo Grok 4.5 verfügbar ist
Grok 4.5 ging am Launch-Tag auf einer breiten Auswahl von Plattformen live. Es ist in der xAI-API unter dem Modellnamen grok-4.5 verfügbar, in Grok Build (xAIs eigenem Coding-Agent-Harness) und in Cursor über alle Pläne hinweg. Der Zugang über Dritte umfasst OpenRouter, Vercel, Cloudflare, Snowflake und Databricks Mosaic. Es ist auch live in Fello AI auf Mac, iPhone und iPad.
Der Office-Plugin-Launch ist bemerkenswert. xAI positioniert Grok 4.5 nicht nur als Coding-Modell, sondern als Wissensarbeits-Modell, das komplexe Excel-Modelle mit integrierter Web-Recherche erstellen und ausgefeilten PowerPoint-Inhalt generieren kann. Das erweitert den adressierbaren Anwendungsfall weit über die Softwareentwicklung hinaus.
Die EU-Lücke wurde geschlossen. Grok 4.5 startete in 47 Ländern, war aber in allen 27 EU-Mitgliedstaaten gesperrt, eine Verzögerung, die auf Compliance-Arbeit unter dem EU AI Act zurückgeführt wurde, der Modelle, die über 1025 FLOPs trainiert wurden, als systemisches Risiko einstuft. xAI öffnete den EU-Zugang später im Juli 2026, und seine Entwicklerdokumentation trägt nicht mehr die regionale Einschränkung, die sie beim Launch zeigte.
Das Modell unterstützt sowohl die Responses-API- als auch die Chat-Completions-Formate, was bedeutet, dass es in Codebasen, die bereits auf OpenAI-kompatiblen APIs aufgebaut sind, ohne Änderungen passt.
Was Elon Musk gesagt hat
Musk machte rund um den Launch-Tag mehrere Aussagen, die darauf hinweisen, wo dieses Modell hingehört und wohin es sich entwickelt.
Zur Fähigkeitspositionierung: „Es ist ein Opus-Klasse-Modell, aber schneller, tokeneffizienter und kostengünstiger", mit einer Folgepräzisierung, dass es „ungefähr vergleichbar mit Opus 4.7, aber viel schneller" ist. Dieses letzte Detail ist wichtig. Musk benchmarkt gegen Opus 4.7, nicht 4.8, was die unabhängigen Daten weitgehend stützen.
Zur Geschwindigkeitsobergrenze: „Grok 4.5 nutzt noch nicht unsere intern entwickelte C/C++-Inferenzsoftware, die direkt auf die GB300-Hardware abbildet. Eine Verdoppelung oder mehr der aktuellen Geschwindigkeit ist wahrscheinlich erreichbar." Der aktuelle Durchsatz von etwa 80 Token pro Sekunde ist nicht die endgültige Zahl. Der benutzerdefinierte Inferenz-Stack ist in Entwicklung und wird weitere Geschwindigkeit ohne Änderung der Modellgewichte hinzufügen.
Zum nächsten Schritt: „Die nächste Veröffentlichung des Monats wird eine weitere sprunghafte Verbesserung sein, wenn wir den Kreis des Lösens realer Ingenieurprobleme bei Tesla, SpaceX, Neuralink und Boring Company schließen." Diese Feedback-Schleife aus echter Ingenieurarbeit an xAIs Schwesterfirmen ist eine Trainingsdatenquelle, die kein anderes Lab im gleichen Umfang hat.
Zu zukünftigen multimodalen Fähigkeiten: Grok wird die Fähigkeit erwerben, Grok Imagine als Werkzeug im agentischen Modus aufzurufen und Bild- und Videogenerierung als Teil eines längeren autonomen Workflows statt als separate Funktion einzulösen. Musk bezeichnete das als besonders wertvoll für Spielentwickler.
Erste Nutzerreaktionen
Das Entwickler-Feedback aus dem frühen Cursor-Zugang war positiv. Danny Limanseta beschrieb es als „Opus 4.8 bei 2x der Geschwindigkeit zu einem viel günstigeren Preis", nachdem er es genutzt hatte, um eine komplexe Spielfunktion über eine vollständige Sitzung hinweg zu brainstormen, zu planen und zu implementieren, ohne es bei jedem Schritt manuell korrigieren zu müssen.
Artificial Analysis fasste die Wettbewerbsverschiebung beim Launch-Tag direkt zusammen und schrieb, dass Grok 4.5 „SpaceXAI an die Intelligenz-Frontier bringt, nur hinter OpenAI und Anthropic, und alle Open-Weights-Modelle und insbesondere Googles Gemini-Modelle übertrifft." Beide Hälften dieses Satzes wurden seitdem überholt, wie oben angemerkt.
Wie Grok 4.5 im Vergleich zur Konkurrenz abschneidet
Gegenüber dem aktuellen Frontier nimmt Grok 4.5 selten den direkten Spitzenplatz bei rohen Fähigkeiten ein. Gegenüber Anthropic gewinnt es weiterhin bei Kosten und Token-Effizienz, gegenüber OpenAIs GPT-6.1 Sol nicht mehr. Hier ist der Modell-für-Modell-Vergleich, mit dem Artificial-Analysis-v4.3.2-Board für alles Aktuelle und xAIs Launch-Zahlen, wo diese die einzigen veröffentlichten sind.
Versus Grok 4.3
38,8 gegen Grok 4.3s 24,9 auf v4.3.2 ist der größte Generationssprung in der Grok-Linie. Das Kontextfenster halbierte sich von 1M auf 500k, und die Eingabemodalitäten verengten sich auf Text und Bilder, das sind die zwei echten Kompromisse. Wenn du Grok 4.3 für Coding genutzt hast, ist Grok 4.5 in jeder anderen Dimension ein bedeutendes Upgrade.
Versus Claude Opus 5.5
Claude Opus 5.5 hat Claude Opus 5 am 22. September 2026 abgelöst und führt den Intelligence Index v4.3.2 jetzt mit 57,6 an, vor Claude Fable 5.1 mit 53,4 und OpenAIs GPT-6 Astra mit 52,7. Das sind fast neunzehn Punkte Vorsprung auf Grok 4.5, wo es bei Opus 5 zwölf waren. Es trägt auch ein Kontextfenster von 1M Token gegenüber Grok 4.5s 500k. Der Kostenvergleich läuft weiterhin andersherum, wenn auch weniger deutlich als zuvor. Opus 5.5 kostet $4 / $20 pro Million Token gegenüber $2 / $6, während das abgelöste Opus 5 bei $5 / $25 lag, und Artificial Analysis gibt $5.98 aus, um Opus 5.5 durch den Index zu führen, gegenüber $1.04 für Grok 4.5. Für die härteste offene Coding-Arbeit hat Opus 5.5 den Vorteil; für agentische Pipelines, wo sich die Pro-Aufgabe-Kosten über Hunderte von Tool-Aufrufen hinweg aufaddieren, sind die Ökonomien von Grok 4.5 besser.
Versus Claude Fable 5.1
Fable 5 führte beim Launch über alle vier xAI-Benchmarks, und der Kostenabstand war der größte aller Vergleiche: $2.49 gegenüber $11.80 pro Coding-Agent-Aufgabe, fast 5-fach. Inzwischen hat Claude Fable 5.1 es abgelöst, und Artificial Analysis führt Fable 5 als veraltet. Auf v4.3.2 erreicht Fable 5.1 bei maximalem Aufwand 53,4 gegenüber Grok 4.5s 38,8, und Artificial Analysis gibt $7.63 aus, um es durch den Index zu führen, gegenüber $1.04, mehr als 7-fach. Für Workloads, bei denen die absolut höchste Coding-Performance Pflicht ist, liegt Fable 5.1 vorne. Für deutlich niedrigere Kosten pro Aufgabe gewinnt Grok 4.5.
Versus GPT-6.1 Sol
GPT-6 Astra ist OpenAIs Flaggschiff, aber GPT-6.1 Sol ist der nähere Vergleich auf dem Board, und genau dieses Modell bricht das Kostenargument für Grok 4.5. Auf v4.3.2 erreicht GPT-6.1 Sol 51,8 bei maximalem Reasoning und 50,2 bei hoch, gegenüber Grok 4.5s 38,8 bei hoch. Artificial Analysis gibt dafür bei max $0.72 aus, weniger als Grok 4.5s $1.04, und bei hoch $0.32. Bei gleich hohem Reasoning ist GPT-6.1 Sol also elf Punkte stärker, zu weniger als einem Drittel der Kosten. Sein Listenpreis ist beim Output höher, $2 / $10 pro Million Token gegenüber $2 / $6, doch es verbraucht pro Aufgabe weit weniger Token. OpenAI hat es am 29. September 2026 als Nachfolger von GPT-6 Sol veröffentlicht, mit dem dieser Abschnitt bis dahin verglich und das 47,5 bei max und 42,8 bei hoch erreicht. GPT-5.6 Sol, der Vergleich davor, ist weiterhin über OpenAIs API verfügbar, und Artificial Analysis führt es inzwischen als veraltet.
Versus das Launch-Tag-Paar Opus 4.8 und GPT-5.5
Beide Modelle, gegen die Grok 4.5 im Juli benchmarkt wurde, haben seitdem Legacy-Status erreicht, aber die Zahlen sind es wert zu behalten, weil sie die einzigen direkten Vergleichsdaten sind, die xAI veröffentlicht hat. Gegen Opus 4.8 gewann Grok 4.5 DeepSWE 1.0 und Terminal-Bench 2.1 und verlor DeepSWE 1.1 und SWE-Bench Pro. Gegen GPT-5.5 betrug der Abstand bei Terminal-Bench 2.1 einen Zehntelpunkt (83,3 % vs. 83,4 %), der Coding Agent Index war ein Unentschieden, und Grok 4.5 führte tau3-Banking um 2 Punkte bei ungefähr der Hälfte der Pro-Aufgabe-Kosten ($2.49 vs. $5.07).
Versus GLM-5.2
Grok 4.5 liegt knapp vor GLM-5.2 auf GDPval-AA v2.1 (Elo 1.370 vs. 1.358). Grok 4.5 führt auch auf dem gesamten Intelligence Index, 38,8 gegenüber 33,7 auf v4.3.2, und bei tau3-Banking, 42,1 % gegenüber 34,6 %.
Warum diese Veröffentlichung wichtig ist
Drei Dinge stechen beim Grok-4.5-Launch heraus, die über die Benchmark-Zahlen hinaus zu verfolgen sind.
xAI hat die Intelligenz-Frontier erreicht. Grok 4.3 konkurrierte nicht mit Anthropic und OpenAI an der Spitze der Fähigkeitsbewertungen, mit 24,9 auf dem Intelligence Index v4.3.2. Grok 4.5 tat es, mit 38,8 auf demselben Board, und xAI ist seitdem dort geblieben: Grok 4.6 erreicht 44,3 und Grok 4.7 46,3. Das veränderte die Wettbewerbsstruktur des Marktes von einem Zwei-Spieler-Rennen zu einem Drei-Wege-Rennen.
Das Kosteneffizienz-Argument ist real, nicht nur ein Preisrabatt. Grok 4.5 ist günstiger pro Token, aber es ist auch dramatisch tokeneffizienter pro Aufgabe. Ein Modell, das dieselbe Ausgabe in 14.000 Token produziert, wenn ein Mitbewerber 67.000 verwendet, ist nicht nur günstiger zu betreiben, es ist schneller und erzeugt weniger Rauschen in agentischen Workflows. Beides zählt im Produktionsmaßstab.
Die Geschwindigkeitsobergrenze wurde beim Start nicht erreicht. xAI nannte am Launch-Tag ungefähr 80 Token pro Sekunde, und Artificial Analysis misst inzwischen einen Median von 58 Ausgabe-Token pro Sekunde. Musk erwartete, dass der benutzerdefinierte C/C++-Inferenz-Stack, der auf die GB300-Hardware abbildet, die Startzahl verdoppeln würde, was ein bei Kosten und Qualität bereits wettbewerbsfähiges Modell ohne Modell-Update erheblich schneller gemacht hätte.
Grok 4.5 ist live in Fello AI, wo du es neben Claude, ChatGPT, Gemini, DeepSeek und Perplexity in einer nativen App für Mac, iPhone und iPad ausführen kannst und dieselbe Aufgabe über jedes Frontier-Modell in einem Abonnement vergleichen kannst, statt separate Konten zu verwalten. Für den Kontext, was nach Grok 4.5 kommt, deckt der Grok 5-Artikel ab, was xAI zur nächsten Hauptversion signalisiert hat.
FAQ
Wann wurde Grok 4.5 veröffentlicht?
xAI veröffentlichte Grok 4.5 am 8. Juli 2026. Es ist xAIs erstes Modell, das speziell für Coding und agentische Arbeit entwickelt wurde und auf echten Cursor-Entwicklersitzungsdaten trainiert wurde.
Was kostet Grok 4.5?
Die API-Preise betragen $2.00 pro Million Eingabe-Token und $6.00 pro Million Ausgabe-Token. Cache-Treffer erhalten einen Rabatt von 85 %, was gecachte Eingabe auf $0.30 pro Million senkt. Der Preis verdoppelt sich für Eingaben länger als 200k Token.
Ist Grok 4.5 besser als Claude Opus 5.5?
Nicht bei den rohen Fähigkeiten. Claude Opus 5.5, Anthropics aktuelles Modell, erreicht 57,6 auf dem Artificial Analysis Intelligence Index v4.3.2 gegenüber Grok 4.5s 38,8 und trägt ein Kontextfenster von 1M Token gegenüber 500k. Grok 4.5 gewinnt entschieden bei den Kosten, zu $2 / $6 pro Million Token gegenüber $4 / $20, und bei der Token-Effizienz pro abgeschlossener Aufgabe.
Wie groß ist das Kontextfenster von Grok 4.5?
Grok 4.5 hat ein Kontextfenster von 500k Token, weniger als Grok 4.3s 1 Million Token. Das ist der eine klare Kompromiss in einem sonst allseitigen Upgrade.
Kann ich Grok 4.5 in Fello AI nutzen?
Ja. Grok 4.5 ist live in Fello AI, sodass du es neben Claude, ChatGPT, Gemini, DeepSeek und Perplexity in einer nativen Mac-, iPhone- und iPad-App ausführen und dieselbe Aufgabe über jedes Frontier-Modell in einem einzigen Abonnement vergleichen kannst.