8. července 2026 vydal xAI Grok 4.5, první model určený specificky pro kódování a agentní práci. Nejde o obecné zlepšení schopností. Jde o záměrný obrat směrem k vývojářům, přičemž trénování probíhalo na reálných datech z vývojářských relací v Cursor a benchmarky jsou navrženy tak, aby měřily, co AI dokáže skutečně dělat v reálném kódu v průběhu dlouhé relace. 12. srpna 2026 jej nahradil Grok 4.6, vylepšení po tréninku na stejném základu. Grok 4.6 pak 21. září 2026 vystřídal Grok 4.7 a Artificial Analysis nyní vede Grok 4.5 jako vyřazený.
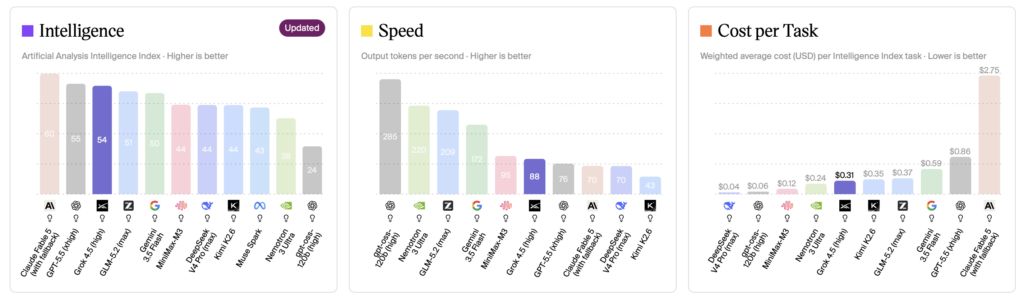
Výsledkem je model, který dosahuje skóre 38,8 na Artificial Analysis Intelligence Index v4.3.2, a to za zlomek ceny, za kterou dnes funguje špička od Anthropicu. Artificial Analysis stojí prohnání Grok 4.5 přes index 1,04 $, zatímco na 5,98 $ přijde s maximálním uvažováním aktuální Claude Opus 5.5 od Anthropicu. OpenAI tento náskok ale smazal: GPT-6.1 Sol projde stejným indexem s maximálním uvažováním za 0,72 $ a dosáhne skóre 51,8. Náš průvodce AI benchmarky vysvětluje, co tato čísla ve skutečnosti měří.
Elon Musk ho zařadil přímo: „Je to model třídy Opus, ale rychlejší, efektivnější co do tokenů a levnější.“ V navazujícím příspěvku byl přesnější: „Grok 4.5 je zhruba srovnatelný s Opus 4.7, ale mnohem rychlejší.“
Musk také naznačil, že aktuální rychlosti nejsou stropem. xAI zatím nenasadil interně vyvinutý inferenční zásobník v C/C++, který přímo mapuje na hardware GB300, a jakmile to udělá, očekává zdvojnásobení rychlosti nebo více. Signalizoval další výrazné vydání na následující měsíc a přišlo hned dvakrát: Grok 4.6 12. srpna 2026 a poté Grok 4.7 21. září 2026. grok-4.5-latest už není v čele seznamu modelů xAI.
Klíčové poznatky
- Grok 4.5 byl spuštěn 8. července 2026 a dosahuje skóre 38,8 na Artificial Analysis Intelligence Index v4.3.2. Při spuštění se umístil na 4. místě ze 168 záznamů a nyní je 56. ze 664.
- Postaven na základním modelu V9 s 1,5 biliony parametrů a trénovaný na reálných datech relací v Cursor pro kódování a agentní úlohy.
- Cena je 2 $ / 6 $ za milion tokenů, přičemž mezipaměťový vstup je za 0,30 $, zatímco Claude Opus 5.5, který dnes Anthropic nabízí jako svůj hlavní pracovní model, stojí 4 $ / 20 $. Artificial Analysis stojí jedna úloha Intelligence Indexu na tomto modelu 1,04 $, u Opusu 5.5 je to 5,98 $.
- Velmi efektivní co do tokenů: na každou úlohu Intelligence Index využívá přibližně 14 000 výstupních tokenů oproti 67 020 u Opus 4.8 v porovnání xAI ke dni spuštění.
- Musk ho nazývá „modelem třídy Opus, ale rychlejším“ a očekává, že vlastní inferenční zásobník zdvojnásobí současných přibližně 80 tokenů/s.
Co Grok 4.5 ve skutečnosti je
Grok 4.5 je první model xAI trénovaný od základu pro kódování a agentní úlohy místo pro obecnou inteligenci. Postaven na základním modelu V9 s 1,5 biliony parametrů byl trénován ve spolupráci s Cursor, aby zvládal dlouhotrvající práci napříč více repozitáři a fungoval s minimálním lidským zásahem po stovkách volání nástrojů. Toto partnerství později vyústilo v agentní produkt SpaceXAI, který stejný přístup přenáší do desktopové aplikace.
Hlavní specifikace jsou přímočaré.
| Specifikace | Detail |
|---|---|
| Název modelu v API | grok-4.5 |
| Architektura | Základní model V9, 1,5 bilionu parametrů (3× větší než V8 modelu Grok 4.3) |
| Kontextové okno | 500 000 tokenů |
| Rychlost | přibližně 80 tokenů za sekundu při spuštění; Artificial Analysis nyní měří medián 58 t/s |
| Vstupní modality | text a obrázky (vision) |
| Uvažování | konfigurovatelné na nízké, střední, vysoké nebo xhigh úsilí (výchozí: vysoké) |
| Podporovaná API | Responses API a Chat Completions |
| Vestavěné schopnosti | volání funkcí, vyhledávání na webu, vyhledávání na X, spouštění kódu |
Označení V9 signalizuje úplnou generační změnu oproti sérii V8, která pohání Grok 4.3: měřítko se ztrojnásobilo a zaměření trénování se zcela přesunulo na kódování a agentní úlohy. Kontextové okno se zkrátilo z 1 milionu tokenů u Grok 4.3 na 500 000, což je skutečný kompromis pro každého, kdo potřeboval celý milion.
Spojení s Cursor
Formulace „trénovaný s Cursor“ v oznámení není jen marketingovým partnerstvím. V polovině června 2026 SpaceX získal Cursor přibližně za 60 miliard dolarů, čímž dostal jeden z nejrozšířenějších AI editorů kódu přímo do ekosystému xAI. Právě tato akvizice je důvodem, proč trénování Grok 4.5 zahrnovalo reálná data z vývojářských relací v Cursor, čímž xAI získal přímý přístup ke skutečným pracovním postupům, vzorcům kontextu a strukturám dlouhodobých úloh, které vývojáři v praxi používají.
Na rozdíl od trénování na veřejných repozitářích kódu reálná data relací zachycují, jak vývojáři iterují nad problémem, přepínají kontext napříč soubory a dělají vícekroková rozhodnutí v rámci skutečných projektů. Grok 4.5 je první model, který toto odráží.
xAI zároveň s tímto modelem zavedl novou metodologii trénování, asynchronní učení, která umožňuje vícahodinové agentní tréninkové běhy probíhat souběžně s průběžným trénováním modelu, nikoli sekvenčně. Praktickým výsledkem je, že zpětnovazební smyčky mezi chováním modelu a jeho tréninkovými aktualizacemi jsou mnohem kratší, což modelu umožňuje zvládat druh dlouhotrvajících autonomních relací, na kterých většina agentů aktuálně uvízne.
Výsledky benchmarků
Benchmarky xAI zveřejněné při spuštění
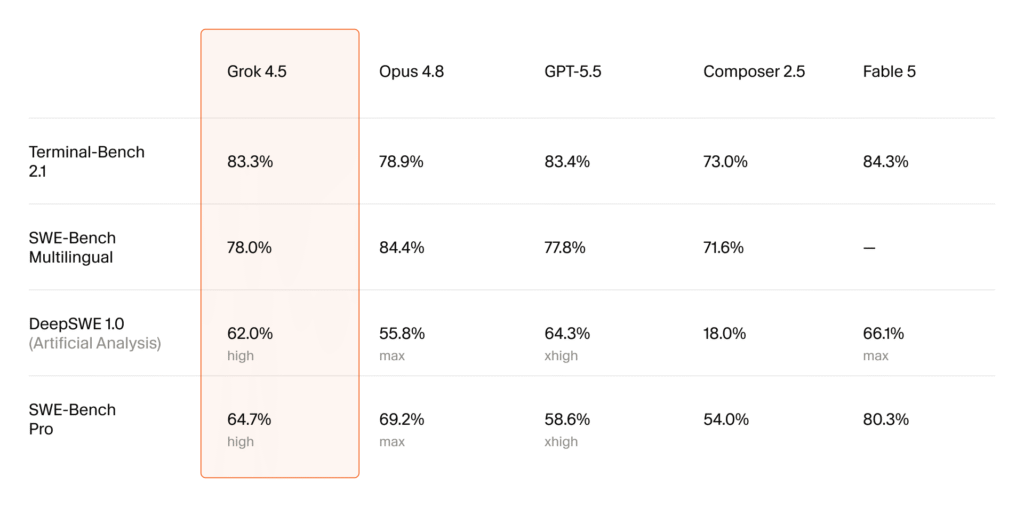
| Benchmark | Fable 5 | GPT-5.5 | Grok 4.5 | Opus 4.8 | GLM-5.2 |
|---|---|---|---|---|---|
| DeepSWE 1.0 | 66,1 % | 64,3 % | 62,0 % | 55,8 % | n/a |
| DeepSWE 1.1 | 70,0 % | 67,0 % | 53,0 % | 59,0 % | 44,0 % |
| Terminal-Bench 2.1 | 84,3 % | 83,4 % | 83,3 % | 78,9 % | n/a |
| SWE-Bench Pro | 80,4 % | n/a | 64,7 % | 69,2 % | 62,1 % |
Toto jsou čísla, která xAI zveřejnil 8. července 2026, měřená oproti modelům aktuálním v ten den. Přímé čtení: Grok 4.5 poráží Opus 4.8 ve dvou ze čtyř benchmarků (DeepSWE 1.0 a Terminal-Bench 2.1) a zaostává ve dvou dalších (DeepSWE 1.1 a SWE-Bench Pro). Claude Fable 5 vede ve všech čtyřech a na Terminal-Bench 2.1 je rozdíl mezi Grok 4.5 (83,3 %) a GPT-5.5 (83,4 %) pouhá desetina procenta. Opus 4.8 i GPT-5.5 byly od té doby překonány dvakrát: nejprve modely Claude Opus 5 a GPT-5.6 Sol, poté Claude Opus 5.5 a GPT-6 Astra. xAI nezveřejnil přímá čísla ani proti jednomu z těch čtyř, takže pro nákupní rozhodnutí je relevantní níže uvedená část o aktuálním stavu.
Nezávislé benchmarky od Artificial Analysis
Na Artificial Analysis Intelligence Index, nyní ve verzi v4.3.2, dosahuje Grok 4.5 s vysokým uvažováním skóre 38,8. Grok 4.3 dosahuje na stejném žebříčku skóre 24,9, takže jde stále o největší mezigenerační skok, který xAI na tomto indexu zaznamenal. Každé číslo z Artificial Analysis níže je opatřeno verzí indexu, ze které pochází, protože verze nejsou vzájemně porovnatelné. Stejný model měl na v4.1.1 skóre 56: Artificial Analysis mezi oběma vydáními přeškáloval celý žebříček a číslo kleslo, aniž by se model změnil. Jedno tvrzení ze dne spuštění ale tento přesun nepřežilo. Grok 4.5 už nepřekonává každý model Gemini, protože Gemini 3.8 Flash dosahuje s vysokým úsilím skóre 40,9. Gemini 3.6 Flash, nejsilnější Gemini na žebříčku v době vydání Grok 4.5, je nyní na 34,0.
Jeho pozice se však posunula a to stojí za jasné vyjádření. Grok 4.5 se při spuštění 8. července umístil čtvrtý ze 168 záznamů. Na žebříčku v4.3.2 k 25. září 2026 je 56. ze 664 záznamů a nad ním je 27 samostatných modelů, mezi nimi Claude Opus 5.5, Claude Fable 5.1, GPT-6 Astra, Claude Opus 5, Muse Spark 1.3, GPT-6 Sol, Grok 4.7, Qwen3.8 Max, GLM-5.3, Grok 4.6 a Kimi K3. Claude Opus 4.8, oproti kterému byl Grok 4.5 benchmarkován při spuštění, je na žebříčku stále a se skóre 41,8 je před ním. Za posun skóre může přeškálování, za posun v pořadí celé pole.
Další tvrzení ze dne spuštění se obrátilo. Grok 4.5 již nepřekonává každý open-weight model, protože Kimi K3 zveřejnil open weights 27. července 2026 a na v4.3.2 dosahuje skóre 43,6. Nad ním jsou i open-weight modely GLM-5.3 se skóre 44,8 a MiMo-V2.6-Pro se skóre 46,3.
Na GDPval-AA, benchmarku měřícím trvalou agentní znalostní práci, nyní ve verzi v2.1, dosahuje Grok 4.5 Elo skóre 1 370, čímž předstihuje GLM-5.2 na 1 358 a zaostává za Claude Opus 4.8 na 1 438. Při spuštění se umístil čtvrtý. Claude Opus 5 od té doby dosáhl 1 708 a Claude Opus 5.5 celému žebříčku vévodí se skóre 1 846. V nejtěžší dílčí úloze finančního uvažování, tau3-Banking, dosahuje Grok 4.5 42,1 %, stále pohodlně před GPT-5.5 (xhigh) s 39,0 %. Už to ale není nejvyšší skóre. Tento žebříček vede Qwen3.8 Max s 51,3 %.
Na Artificial Analysis Coding Agent Index (kombinace DeepSWE, Terminal-Bench v2 a SWE-Atlas QnA) dosahuje Grok 4.5 v harnessu Grok Build skóre 76, což v červenci 2026 stačilo na třetí místo. Byl srovnatelný s GPT-5.5 (xhigh) v Codex a nacházel se těsně pod Fable 5 (max) v Claude Code. Artificial Analysis tento index mezitím zrušil a ani DeepSWE, ani SWE-Atlas QnA už nejsou na jeho aktuálním seznamu evaluací, takže toto číslo proti dnešním modelům obnovit nelze.
xAI také uvádí Harvey Legal Agent Benchmark, kde Grok 4.5 obsadil první místo. V kombinaci s nejvyšším skóre tau3-Banking to ukazuje na právní a finanční znalostní práci jako na specifické silné stránky nad rámec toho, co samotné benchmarky kódování zachytí.
Efektivita tokenů
Cena za token je to, co zaujme, ale efektivita tokenů je smysluplnější číslo. Na SWE-Bench Pro použil Grok 4.5 přibližně 15 954 výstupních tokenů na úlohu oproti 67 020 u Opus 4.8, tedy 4,2× méně. Na Artificial Analysis Intelligence Index využívá přibližně 14 000 výstupních tokenů na úlohu, o více než 60 % méně než Opus 4.8. Na Coding Agent Index průměrně spotřebuje 1,9 milionu tokenů celkem na úlohu, oproti 7,2 milionu u Fable 5 v Claude Code a 6,2 milionu u GPT-5.5 v Codex.
Model, který použije 4× méně tokenů, není jen levnější na úlohu. Je rychlejší a generuje méně šumu v agentních pipelinách, což má význam při vícekrokové autonomní práci.
Ceny a náklady na úlohu
Grok 4.5 je oceněn na 2,00 $ za milion vstupních tokenů a 6,00 $ za milion výstupních tokenů. Zásahy do mezipaměti jsou zlevněny o 85 %, čímž se mezipaměťové vstupní tokeny dostanou na 0,30 $ za milion. Důležitá výhrada: cena se zdvojnásobuje pro vstupy delší než 200 000 tokenů. Úplný přehled cen předplatného a API Grok, včetně spotřebitelských úrovní, obsahuje tento průvodce se všemi možnostmi.
Ve srovnání s aktuální frontou je to polovina toho, co si Claude Opus 5.5 účtuje za vstup, a necelá třetina toho, co si účtuje za výstup, tedy 4 $ / 20 $. Opus 5, se kterým se Grok 4.5 poměřoval většinu své životnosti, stál 5 $ / 25 $ a Anthropic ho dnes vede mezi staršími modely. Ale náklady na úlohu jsou smysluplnějším číslem, protože zohledňují, kolik tokenů každý model skutečně spotřebuje. Tabulka níže uvádí čísla xAI a Artificial Analysis zveřejněná ke dni spuštění v červenci 2026.
| Model | Vstup (za 1M) | Výstup (za 1M) | Cena za úlohu Intelligence Index | Cena za úlohu Coding Agent |
|---|---|---|---|---|
| Grok 4.5 | $2.00 | $6.00 | $0.31 | $2.49 |
| GPT-5.5 (Codex) | $5.00 | $30.00 | vyšší | $5.07 |
| Fable 5 (Claude Code) | $10.00 | $50.00 | vyšší | $11.80 |
| Opus 4.8 | $5.00 | $25.00 | vyšší | n/a |
Čísla za úlohu jsou ta, na kterých záleží v produkčním měřítku. Grok 4.5 dosáhl téměř rovnocenného výkonu coding agenta za zhruba polovinu ceny GPT-5.5 a méně než čtvrtinu ceny Fable 5 za dokončenou práci. Vůči Anthropicu tato výhoda přetrvala i poté, co se pole posunulo, vůči OpenAI ale ne. Na Intelligence Index v4.3.2 uvádí Artificial Analysis náklady na prohnání Grok 4.5 ve výši 1,04 $ oproti 5,98 $ u Claude Opus 5.5 s maximálním uvažováním, zatímco GPT-6.1 Sol s vysokým uvažováním jím projde za 0,32 $ a s vyšším skóre.
Kde je Grok 4.5 dostupný
Grok 4.5 byl v den spuštění zpřístupněn napříč širokou sadou platforem. Je dostupný v API xAI pod názvem modelu grok-4.5, v Grok Build (vlastním harnessu kódovacího agenta xAI) a v Cursor napříč všemi plány. Přístup třetích stran zahrnuje OpenRouter, Vercel, Cloudflare, Snowflake a Databricks Mosaic. Je také dostupný v Fello AI na Macu, iPhonu a iPadu.
Spuštění pluginu pro Office stojí za zmínku. xAI se snaží Grok 4.5 umístit nejen jako model pro kódování, ale jako model pro znalostní práci schopný sestavovat složité excelové modely s integrovaným webovým výzkumem a generovat sofistikovaný obsah pro PowerPoint. To výrazně rozšiřuje adresovatelné použití daleko za hranice vývoje softwaru.
Mezera v EU se uzavřela. Grok 4.5 byl spuštěn ve 47 zemích, ale byl zablokován ve všech 27 členských státech EU, přičemž zpoždění bylo přičítáno compliance práci v rámci zákona EU o AI, který zachází s modely trénovanými nad 1025 FLOPs jako s těmi, které nesou systémové riziko. xAI otevřel přístup pro EU v průběhu července 2026 a jeho vývojářská dokumentace již nenese regionální omezení, které zobrazovala při spuštění.
Model podporuje formáty Responses API i Chat Completions, což znamená, že se bez úprav zapojí do kódových základen již postavených na API kompatibilních s OpenAI.
Co řekl Elon Musk
Musk kolem dne spuštění učinil několik prohlášení, která naznačují, kam tento model patří a kam směřuje.
O umístění z hlediska schopností: „Je to model třídy Opus, ale rychlejší, efektivnější co do tokenů a levnější,“ s navazujícím upřesněním, že je „zhruba srovnatelný s Opus 4.7, ale mnohem rychlejší.“ Tento poslední detail je důležitý. Musk porovnává s Opus 4.7, nikoli s 4.8, což nezávislá data v zásadě potvrzují.
O stropu rychlosti: „Grok 4.5 zatím nepoužívá náš interně vyvinutý inferenční software v C/C++, který přesně mapuje na hardware GB300. Zdvojnásobení nebo více oproti aktuální rychlosti je pravděpodobně dosažitelné.“ Aktuální propustnost kolem 80 tokenů za sekundu není konečným číslem. Vlastní inferenční zásobník je ve vývoji a přidá další rychlost bez změny vah modelu.
O tom, co bude dál: „Vydání příštího měsíce bude dalším výrazným skokem vpřed, jak uzavíráme smyčku řešení skutečných technických problémů v Tesla, SpaceX, Neuralink a Boring Company.“ Tato zpětnovazební smyčka z reálné inženýrské práce v sesterských společnostech xAI je zdroj tréninkových dat, který žádná jiná laboratoř nemá ve stejném měřítku.
O budoucích multimodálních schopnostech: Grok získá schopnost volat Grok Imagine jako nástroj v agentním režimu, přičemž generování obrázků a videí bude součástí delšího autonomního pracovního postupu, nikoli samostatnou funkcí. Musk označil tuto funkci za obzvláště hodnotnou pro vývojáře her.
Reakce prvních uživatelů
Zpětná vazba vývojářů z časného přístupu přes Cursor byla pozitivní. Danny Limanseta ho popsal jako „Opus 4.8 při dvojnásobné rychlosti a za výrazně nižší cenu“ poté, co ho použil k brainstormingu, plánování a implementaci komplexní herní funkce v průběhu celé relace, aniž by ho musel v každém kroku ručně opravovat.
Artificial Analysis shrnul konkurenční posun v den spuštění úderně: Grok 4.5 „přivádí SpaceXAI na frontier inteligence těsně za OpenAI a Anthropic a překonává všechny open-weight modely a výrazně modely Google Gemini.“ Obě části té věty od té doby zastaraly, jak je uvedeno výše.
Jak Grok 4.5 obstojí v porovnání s konkurencí
Oproti aktuální frontě Grok 4.5 jen zřídka obsadí první místo v absolutních schopnostech. Proti Anthropicu stále vítězí v ceně a efektivitě tokenů, proti GPT-6.1 Sol od OpenAI už ne. Zde je srovnání model po modelu s použitím žebříčku Artificial Analysis v4.3.2 pro vše aktuální a čísel xAI ze dne spuštění tam, kde jsou jedinými zveřejněnými čísly.
Versus Grok 4.3
38,8 oproti 24,9 u Grok 4.3 na v4.3.2 je největším mezigeneračním skokem v linii Grok. Kontextové okno se zkrátilo na polovinu z 1M na 500k a vstupní modality se zúžily na text a obrázky, což jsou dva skutečné kompromisy. Pokud jste používali Grok 4.3 pro kódování, Grok 4.5 je ve všech ostatních dimenzích výrazným vylepšením.
Versus Claude Opus 5.5
Claude Opus 5.5 vystřídal Claude Opus 5 22. září 2026 a Intelligence Indexu v4.3.2 nyní vévodí se skóre 57,6, před Claude Fable 5.1 se skóre 53,4 a před GPT-6 Astra od OpenAI se skóre 52,7. To je téměř devatenáct bodů před Grok 4.5, zatímco u Opusu 5 to bylo dvanáct. Nabízí také kontextové okno 1M tokenů oproti 500k u Grok 4.5. Cenové srovnání vychází stále opačně, i když už ne tak výrazně. Opus 5.5 je ceněn na 4 $ / 20 $ za milion tokenů oproti 2 $ / 6 $, zatímco Opus 5, kterého nahradil, stál 5 $ / 25 $. Artificial Analysis stojí prohnání Opusu 5.5 přes index 5,98 $ oproti 1,04 $ u Grok 4.5. Pro nejtěžší otevřené kódovací práce má Opus 5.5 navrch; pro agentní pipeline, kde se cena na úlohu sčítá přes stovky volání nástrojů, vychází ekonomika lépe u Grok 4.5.
Versus Claude Fable 5.1
Fable 5 při uvedení vedl ve všech čtyřech benchmarcích xAI a cenový rozdíl byl největší ze všech srovnání: 2,49 $ oproti 11,80 $ za úlohu Coding Agent, tedy téměř 5×. Mezitím ho nahradil Claude Fable 5.1 a Artificial Analysis dnes Fable 5 vede jako vyřazený. Na v4.3.2 dosahuje Fable 5.1 s maximálním úsilím skóre 53,4 oproti 38,8 u Grok 4.5 a jeho prohnání indexem stojí Artificial Analysis 7,63 $ oproti 1,04 $, tedy víc než 7×. Pro pracovní zátěže, kde je nezbytný absolutně nejvyšší výkon kódování, je Fable 5.1 napřed. Pokud jde o výrazně nižší cenu za úlohu, vítězí Grok 4.5.
Versus GPT-6.1 Sol
GPT-6 Astra je vlajkovým modelem OpenAI, ale bližším srovnáním na žebříčku je GPT-6.1 Sol a právě ten boří cenový argument Grok 4.5. Na v4.3.2 dosahuje GPT-6.1 Sol s maximálním uvažováním skóre 51,8 a s vysokým 50,2, oproti 38,8 u Grok 4.5 s vysokým uvažováním. Prohnání indexem ho u Artificial Analysis s maximálním uvažováním stojí 0,72 $, tedy méně než 1,04 $ u Grok 4.5, a s vysokým 0,32 $. Při stejném, vysokém uvažování je tak GPT-6.1 Sol o jedenáct bodů silnější za méně než třetinu ceny. Ceník má u výstupu vyšší, 2 $ / 10 $ za milion tokenů oproti 2 $ / 6 $, na úlohu ale spotřebuje mnohem méně tokenů. OpenAI ho vydala 29. září 2026 jako nástupce GPT-6 Sol, se kterým tato sekce do té doby srovnávala a který má 47,5 s maximálním a 42,8 s vysokým uvažováním. GPT-5.6 Sol, srovnání ještě předtím, je v API OpenAI stále k dispozici a Artificial Analysis ho dnes vede jako vyřazený.
Versus dvojice z dne spuštění: Opus 4.8 a GPT-5.5
Oba modely, oproti kterým byl Grok 4.5 benchmarkován v červenci, mají od té doby status legacy, ale čísla stojí za zachování, protože jde o jediná přímá srovnání zveřejněná xAI. Oproti Opus 4.8 Grok 4.5 vyhrál DeepSWE 1.0 a Terminal-Bench 2.1 a prohrál DeepSWE 1.1 a SWE-Bench Pro. Oproti GPT-5.5 byl rozdíl na Terminal-Bench 2.1 desetina procenta (83,3 % vs 83,4 %), Coding Agent Index skončil remízou a Grok 4.5 vedl na tau3-Banking o 2 body za přibližně poloviční cenu za úlohu (2,49 $ vs 5,07 $).
Versus GLM-5.2
Grok 4.5 je těsně před GLM-5.2 na GDPval-AA v2.1 (Elo 1 370 vs 1 358). Grok 4.5 vede i na celkovém Intelligence Index, 38,8 oproti 33,7 na v4.3.2, a na tau3-Banking, 42,1 % oproti 34,6 %.
Proč toto vydání má váhu
Ze spuštění Grok 4.5 vynikají tři věci, které stojí za sledování nad rámec čísel benchmarků.
xAI dosáhl frontier inteligence. Grok 4.3 nesoutěžil s Anthropic a OpenAI na vrcholu žebříčků schopností se skóre 24,9 na Intelligence Index v4.3.2. Grok 4.5 ano, se skóre 38,8 na stejném žebříčku, a xAI tam od té doby zůstal: Grok 4.6 má 44,3 a Grok 4.7 46,3. To změnilo konkurenční strukturu trhu ze závodu dvou hráčů na trojstranný.
Případ cenové efektivity je reálný, nejde jen o cenový rabat. Grok 4.5 je levnější za token, ale je také dramaticky efektivnější co do tokenů na úlohu. Model, který produkuje stejný výstup za 14 000 tokenů, zatímco konkurent spotřebuje 67 000, není jen levnější na provoz, ale je rychlejší a generuje méně šumu v agentních pracovních postupech. Obojí má váhu v produkčním měřítku.
Strop rychlosti nebyl při spuštění dosažen. xAI v den spuštění uváděl zhruba 80 tokenů za sekundu a Artificial Analysis nyní měří medián 58 výstupních tokenů za sekundu. Musk očekával, že vlastní inferenční zásobník v C/C++ namapovaný na hardware GB300 číslo ze dne spuštění zdvojnásobí, což by model již konkurenceschopný v ceně a kvalitě výrazně zrychlilo bez nutnosti aktualizace modelu.
Grok 4.5 je dostupný ve Fello AI, kde ho můžete spustit vedle Claude, ChatGPT, Gemini, DeepSeek a Perplexity v jedné nativní aplikaci pro Mac, iPhone a iPad a porovnat stejnou úlohu napříč každým frontier modelem na jednom předplatném místo správy samostatných účtů. Pro kontext o tom, co přijde po Grok 4.5, článek o Grok 5 pokrývá, co xAI naznačil o příští hlavní verzi.
Často kladené otázky
Kdy byl Grok 4.5 vydán?
xAI vydal Grok 4.5 8. července 2026. Je to první model xAI vytvořený specificky pro kódování a agentní práci, trénovaný na reálných datech z vývojářských relací v Cursor.
Kolik stojí Grok 4.5?
Cena API je 2,00 $ za milion vstupních tokenů a 6,00 $ za milion výstupních tokenů. Zásahy do mezipaměti dostávají slevu 85 %, čímž se mezipaměťový vstup sníží na 0,30 $ za milion. Cena se zdvojnásobuje pro vstupy delší než 200 000 tokenů.
Je Grok 4.5 lepší než Claude Opus 5.5?
Ne co do hrubých schopností. Claude Opus 5.5, aktuální model Anthropicu, dosahuje skóre 57,6 na Artificial Analysis Intelligence Index v4.3.2 oproti 38,8 u Grok 4.5 a nabízí kontextové okno 1M tokenů oproti 500k. Grok 4.5 přesvědčivě vítězí v ceně, za 2 $ / 6 $ za milion tokenů oproti 4 $ / 20 $, a v efektivitě tokenů na dokončenou úlohu.
Jaké je kontextové okno Grok 4.5?
Grok 4.5 má kontextové okno 500 000 tokenů, tedy méně než 1 milion tokenů u Grok 4.3. Je to jediný zřejmý kompromis jinak celkového vylepšení.
Mohu Grok 4.5 použít ve Fello AI?
Ano. Grok 4.5 je dostupný ve Fello AI, takže ho můžete spustit vedle Claude, ChatGPT, Gemini, DeepSeek a Perplexity v jedné nativní aplikaci pro Mac, iPhone a iPad a porovnat stejnou úlohu napříč každým frontier modelem na jediném předplatném.